
VLAとE2Eが支配する「臭いものに蓋」の時代
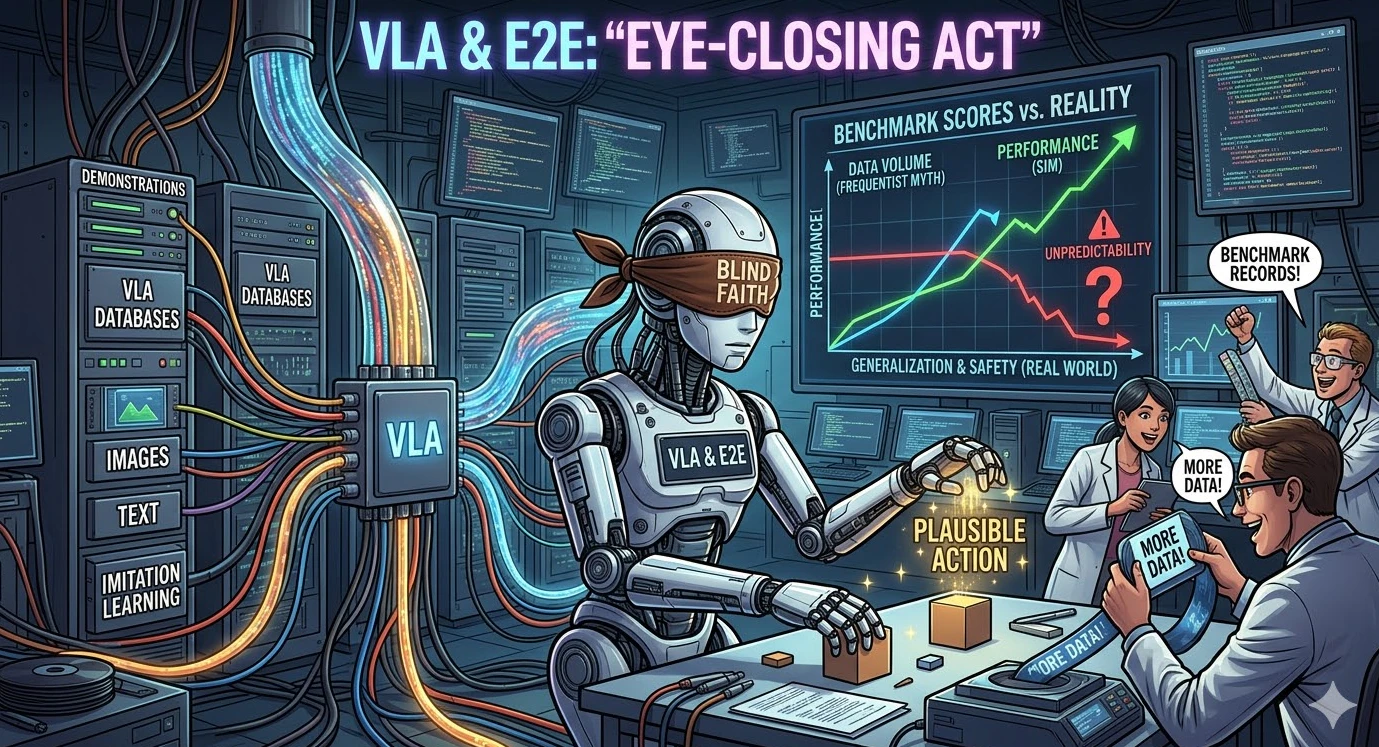
最近のロボティクス分野は、VLA(Vision-Language-Action)とIL(Imitation Learning)を組み合わせたE2E(End-to-End)モデルの熱風の中にあります。数万個のデータを学習させ、「それらしい」動作を作り出す姿は一見すると期待が持てますが、ここには危険な盲信が潜んでいます。それは、「データさえ多ければ正解に収束する」という頻度主義的な錯覚です。
コイン投げで見るデータの罠:80%の表は「真実」か?
私たちは常識的に、コインの表が出る確率は 0.5 であることを知っています。しかし、偶然1,000回投げた結果、表が800回出たと仮定してみましょう。
- 頻度主義的な学習: このデータをそのまま学習すると、「表が出る確率は0.8である」と結論付けます。
- データ増強の悪循環: ここでデータ不足を補うために、この「800:200」の分布をベースにデータを1万個に増強(Augmentation)したらどうなるでしょうか? モデルは「表0.8」という誤答をより強力に確信してしまうだけです。根本的な偏り(Bias)は解決されないまま、ただ声だけが大きくなる形です。

ベイズの哲学:「事前分布」という物理的な常識
ベイズ推定の本質は、事後確率($P(\theta|D)$)がデータ($D$)だけでなく、事前知識($P(\theta)$)によって決定されるという点にあります。$$P(\theta|D) \propto P(D|\theta)P(\theta)$$データが800:200に偏っていたとしても、「コインは本来0.5である」という強力な事前分布を加味すれば、結果は補正されます。フィジカルAIにおいても同様です。物理法則や制御原理という「常識」が排除されたデータ増強は、結局OOD(Out-of-Distribution)状況で崩れ去るしかない砂上の楼閣です。
現実的な代替案:ルールベースこそが最も洗練された「事前分布」である
もちろん、ディープラーニング体系において全てのパラメータをベイズ的に演算することは、演算量の爆発により不可能です。しかし、私たちはその「哲学」を移植することができます。それが、学習とルールベースのハイブリッド・アプローチです。
- 判断(Learning)は柔軟に: 「どの物体を掴むか?」といった高レベルの意思決定は学習に任せます。
- 行動(Rule-base)は堅牢に: 実際に動いて掴む物理的な行動は、ルールベースで制御します。
ここでの核心はエッジケース(Edge-case)です。ルールベースで物理的な限界線を明確に引いておけば、モデルは学習過程で不可能な状況を回避するようになります。つまり、ルールベースでフィルタリングされた安全領域こそが、ベイズの事前分布の役割を現場で遂行することになるのです。
結論:「単純暗記」を超え「原理理解」のアーキテクチャへ
データは万能ではありません。特に物理法則が支配する世界ではなおさらです。単にデータをかき集めて増強する「力技(Brute-force)」的な手法は、いずれ限界にぶつかるでしょう。これからは「どれだけ多くのデータを詰め込んだか」ではなく、「どれだけ知的に構造化したか」を論じるべきです。ルールベースという事前分布の上に築かれた学習モデル、それこそがフィジカルAIが進むべき真のハイブリッド・ウェイです。
本記事で取り上げたアプローチのさらに具体的な背景や、関連する別の視点については、以下の記事でも詳しく解説しています。ご興味のある方は、ぜひ併せてご覧ください。