
ぼき「Qiitaに記事書くんだけどいいタイトルが思いつかん。
【ぼくがかんがえたさいきょうのclaude code】
とかになる。出来るだけAI臭くないタイトルで頼む。」
(*)「経路が権限を決める — Cluade Code で 30 エージェントを運用するオーケストレーション設計」
「AIくせえ~まあしゃあなしな。…ん?誤字っとるやんけ!!!そういう事ちゃうわ!!」
という事でエージェント設計のスケールが落ち着いて来たので記事にしようと思う。
初回コミットが6月9日の為大体1か月程でベクトルDBの設計含め一人で作ったことになる。
とんでもない時代になってしまった。
この記事では
- どういった経緯でこの構成になったか
- システムの仕様をAIと共に把握するにあたっての障壁
について書いていく。
gitでこのエージェント群の管理をどのようにしているか、この設計を実現する為のハーネス、ガードレールを思想から原理に落とし込める前提で話を進める為万人受けの記事ではないかもしれない。多分。
はじめに
以下に現在のエージェント群の一覧を用意した。
大まかな流れは解説するので「おーいっぱいいる」くらいの認識で問題無い。
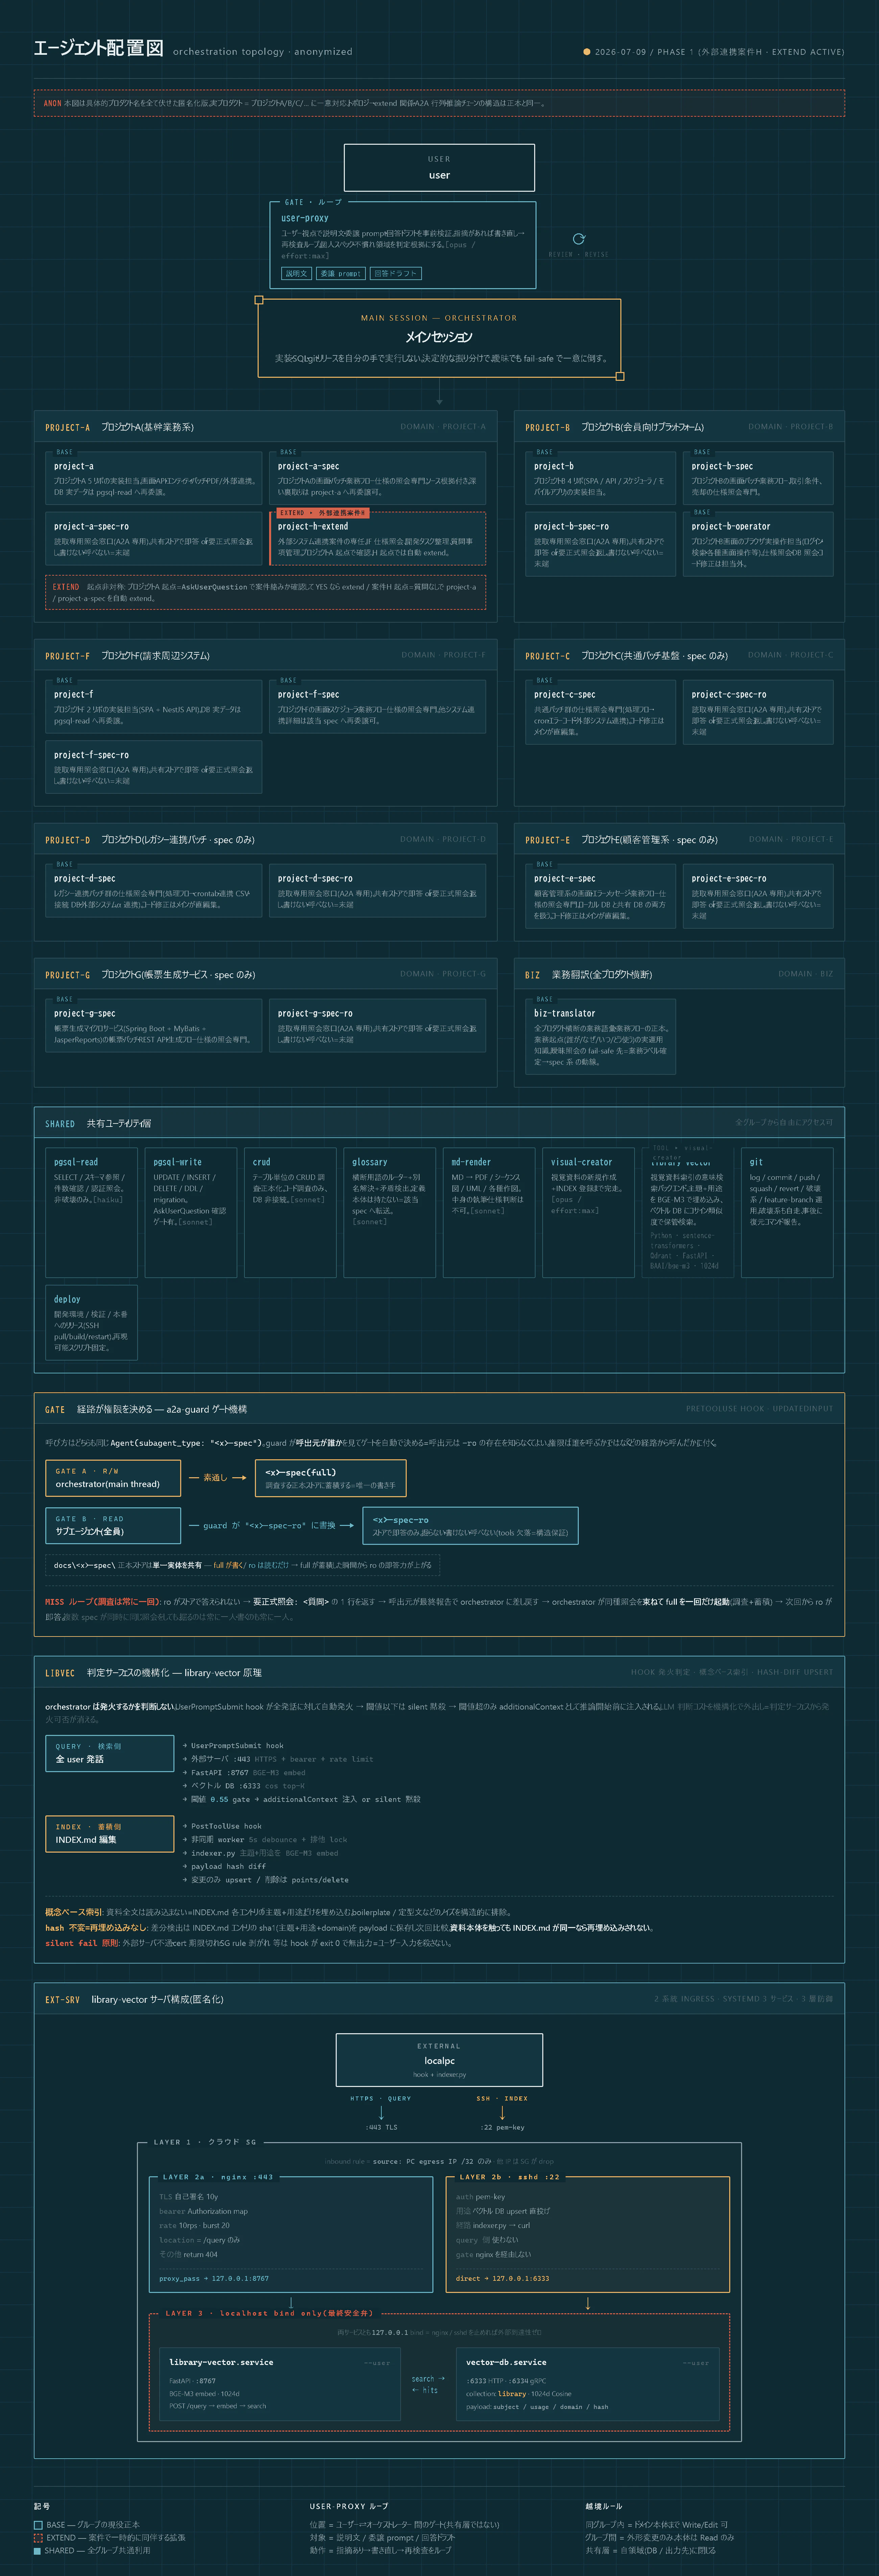
library vectorが見切れてるけど許して
エージェントのスケール
エージェントのスケールをどのように行ったかをこのセクションでは書いていく
オーケストレーション方式の採用経緯
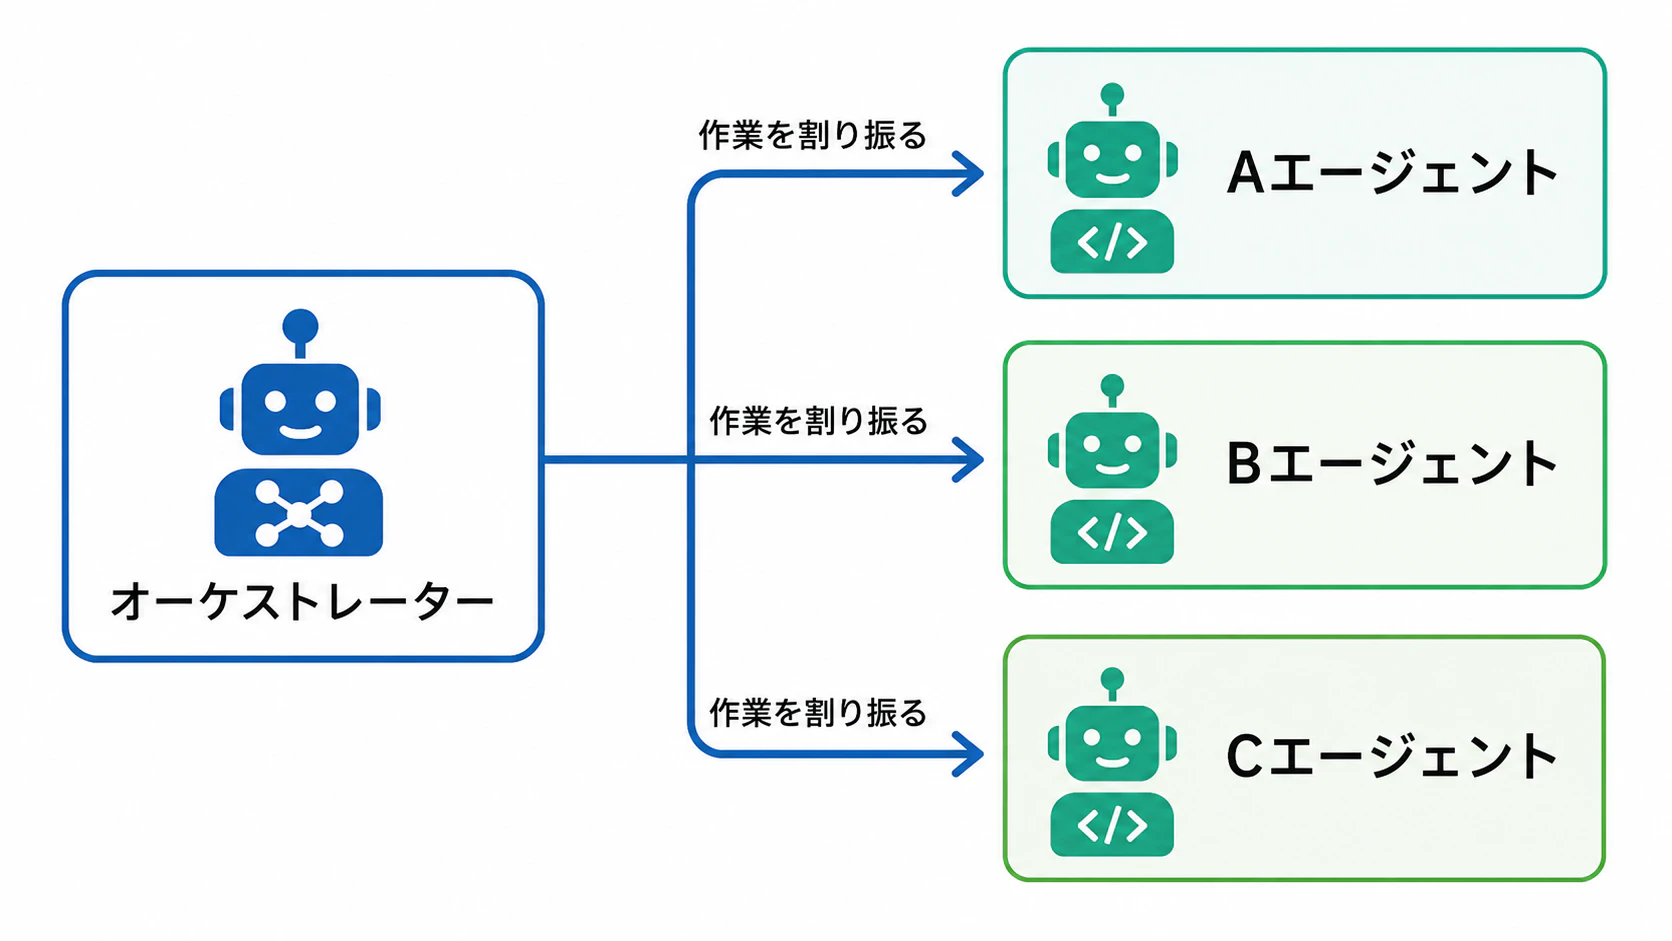
不要なContextが混ざると出力が濁るという経験則からオーケストレーション方式を考えた。
そのため各システムに1体文脈を与えたエージェントを配置し、実装を各エージェントにメインのClaudeが振り分ける方式を考えた。
specエージェントとcrudエージェントの設立
まず試しに一つのシステムにエージェントを建て軽い修正を行わせてみた。
知っている人間が行えば数分程度の修正だった。
結果としては修正自体は問題なく行えたが10分近くかかった上にコードを確認してみると前段で担保されているバリデーションをエンティティクラスからDBにあり得る可能性のあるデータ形式としてチェックを行うなど冗長なコードになっていた。
と言っても現在の文脈から取れる情報でコードを生成するとそりゃそうなるかといった所感だった。
となるとコードの全体像、対象のデータはどのシステムから流れてどういった扱いを行うべきかを判断する対象が必要になる。
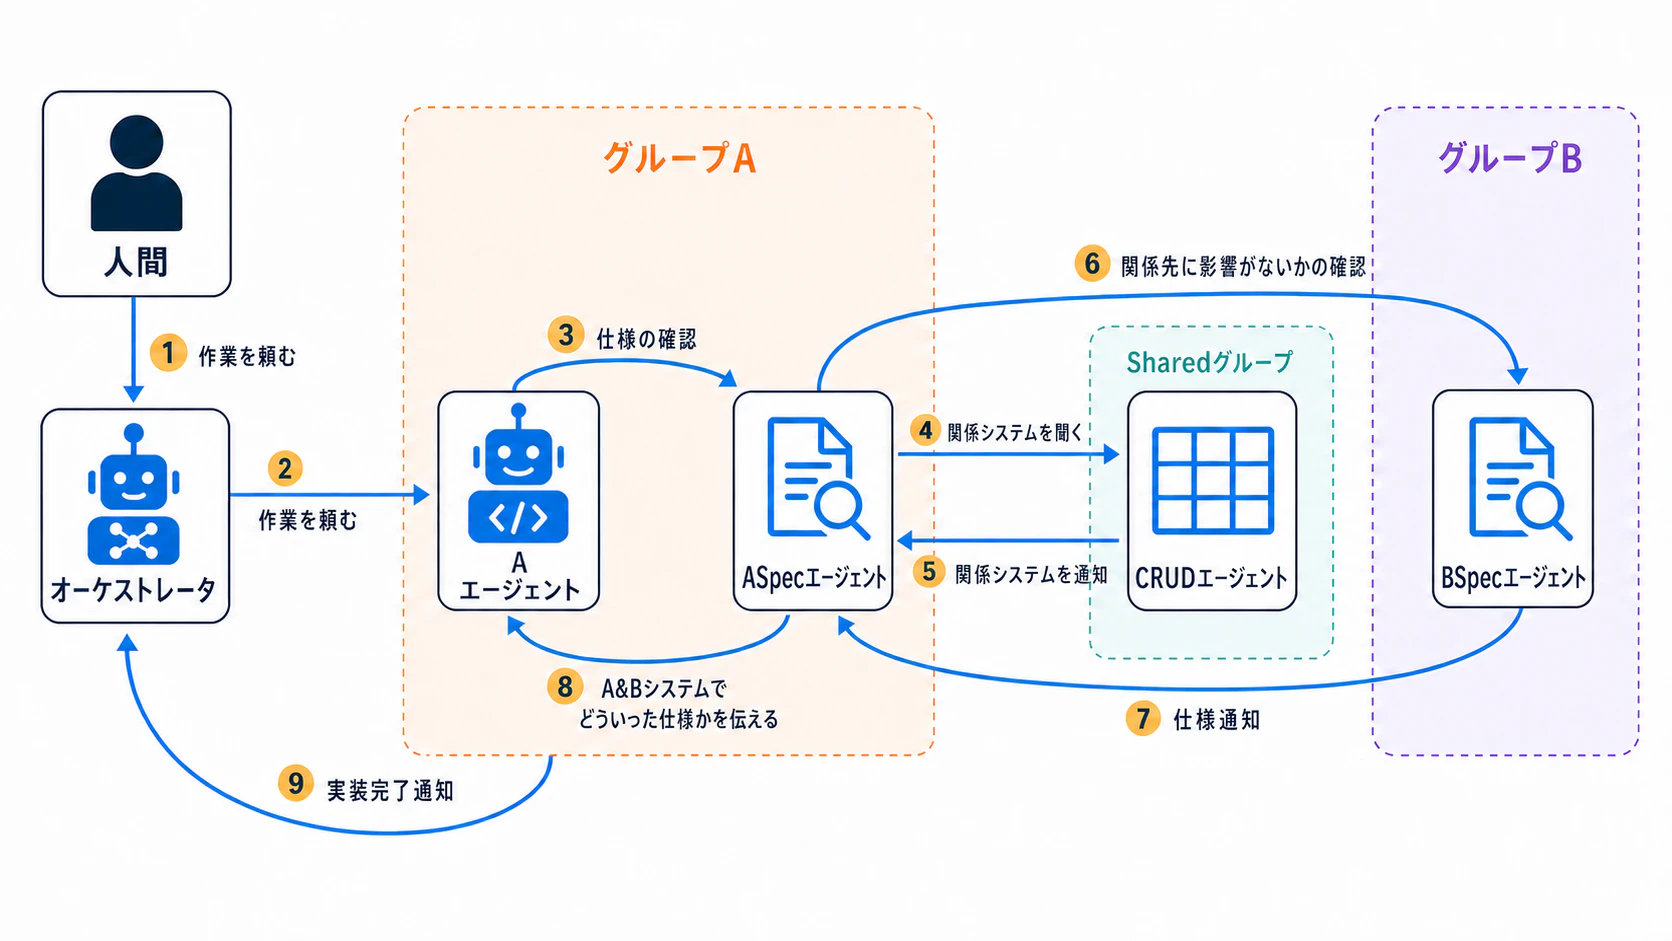
そこで実装エージェントとは別にspecエージェントを建てた。
仕組みとしてはspecエージェント内部に索引を持ち、対象の画面がどのテーブルのどのカラムを更新しているか等の処理概要を持つ。
複数システムで同一のテーブルを触る為正本を特定のシステムのエージェントに持たせるのは文脈の汚染につながる。
その為テーブルを更新、読み取りしている箇所を取りまとめるCRUDエージェントを建てた。
CRUDエージェントはDB情報をDumpしテーブル情報をストア化しておく。
specエージェントはテーブルに対する仕様の更新を行う際にCRUDエージェントの対象テーブルMDにシステムと画面名を書き込む。
これにより各Specエージェントが他システムに跨る改修を行う際どのSpecエージェントに対して相談するかの導線を作成した。
グループエージェント
エージェントが増えるにあたって他のエージェントの正本を書き換える行為が起きた。
全てのエージェントに自己のエージェントの正本にあるもの以外書き換えるなと加えた。
だがここで何故駄目なのかを考えた。
エージェントが越権し、別エージェントのファイルを書き換える事により何が起きるか?
仕様に関する”あえてそうなっている”物を文脈を知らない他エージェントにより書き換えられる事だ。だが連携処理など越権するに値するものもある為一概に禁止するとエージェントの成長が阻害される。
叩き台としてエージェントのグループ化を行った。
同一グループに属している物は書き換えが可能というルールだ。
各エージェントの所属、グループ構成をCLAUD.mdに記述した。
だが上記のCRUDエージェント等A2Aを行ってこそ真価を発揮するものもある。
そういったエージェント群をSharedエージェントと名付けてグループ分けし、Sharedエージェントに限り正本の書き換えを各エージェント間で行えるようにした。
これにより担当エージェントが文脈を持って再委譲を行う判断が出来るようになり、越権が無くなった。
spec-ro (read only spec agent)
ログインに関しての調査を行う際、同じテーブルに関するプロジェクトCのcrud調査依頼が走った。
自己とshared以外の正本を更新することは許可していないが仕様照会の為に別エージェントとの対話は許可していた。
その為
AエージェントとBエージェントがcrudエージェントに照会
↓
crud:Aが未調査領域の為Cエージェントに調査委譲
crud:Bが未調査領域の為Cエージェントに調査委譲
と言った流れで同じ調査を別インスタンスで行った。
動作的に大きな問題は無いが、全く同じ推論が並列で走るかつ自分が記入していない正本がいきなり現れそれに対しての推論を行う為tokenは100%以上の増になる。
この問題を解決するためにPOP(Protocol Oriented Programming)のような設計に落とし込めないかと考えた。
構想としては以下になる。
①ゲートを委譲の前段に置く。
②オーケストレーターから呼び出されたspecエージェントは正本の書き換え能力を持つ
③エージェントから呼び出された場合はストアの参照能力のみ持つ。
という事が可能かとclaudeに聞いた所、公式にそういったエージェントのRead、Writeを切り替える機能は提供されていないとの事。
その為ストアのみを参照可能なspec-roエージェントを作成した。
hooksでエージェントを呼び出す際にスクリプトを呼び出し、オーケストレーターであればspecエージェント、それ以外であればspec-roエージェントへとルーティングを行う様にした。
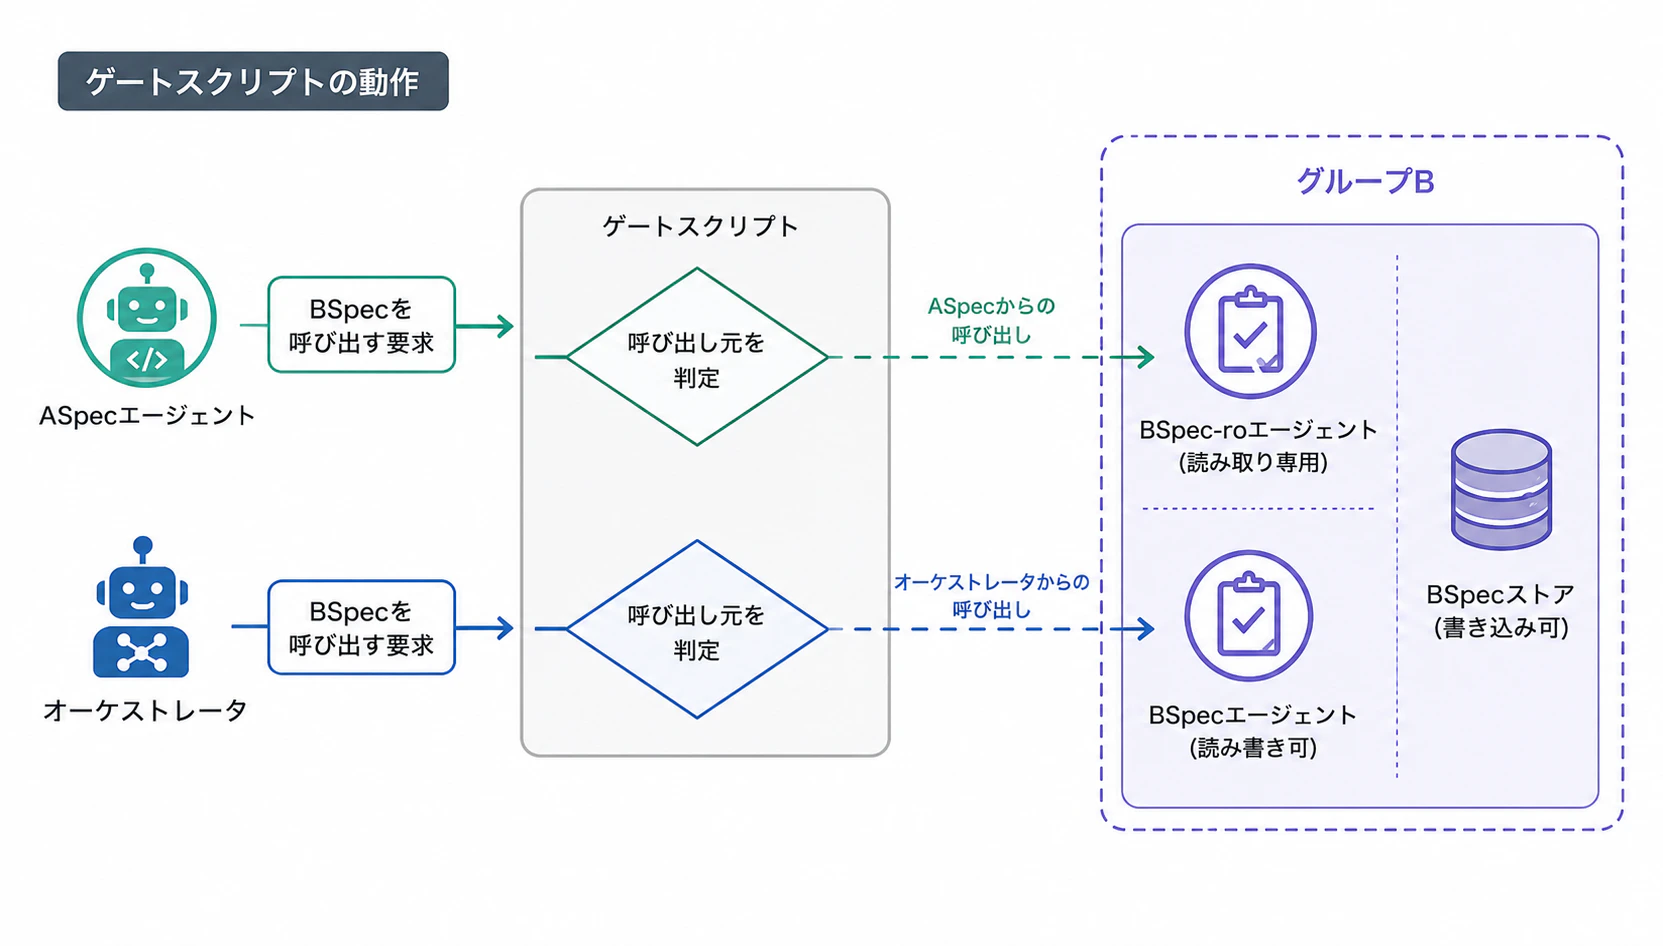
これによりストアに存在しない情報を取得する場合はオーケストレーターを経由する為重複調査が無くなった。
模擬メタ認知(proxy)の実装
いつものように調査をSpecエージェントに調査を頼んだ。
対象のテーブルは基幹システムからのデータ連携、別システムからのデータ連携、こちら側の会社が担当しているシステムからの更新、トリガー発火のUPDATEなど一つのテーブルに対してかなり複雑な経路でデータが更新されているテーブルの調査を行った。
因みに地獄なので設計書は存在しない。
調査が完了しオーケストレーターからの出力を受け取った所、読ませる気のない文章が返ってきた。
・全てがテーブルとカラムの列挙
・特定のフローを「○○確定処理」等に圧縮せず同じ処理が何度も出る
・今聞きたい事に関して不要な情報が混じる
この現象には見覚えがある。
GPT o3でDeepReserchを行った時の出力と酷似している。
出力対象のcontextが肥大化し人にわかりやすい形式にまとめられていない。
読みやすくしろと言ってもその出力が人間にとってわかりにくいかどうかをエージェントが判断する術を持ち合わせていない。
メタ認知が無くともメタ的な視点を得るには何が必要か?
答えは第三者の目だ。
模擬的なメタ認知の実装を第三者を作成する事により解決した(哲学)(本末転倒)(Uber oneの配達料)
回答出力時、CLAUD.local.mdに基づいて回答を行う。
CLAUD.local.mdにproxyエージェントの参照項目が存在しない場合質問を行うskillが発火する
その質問により想定されるユーザー像をエージェントにより模倣する。
proxyエージェントがユーザーを模倣し、文章内にそぐわない表現があれば差し戻す。
例としては
| レベル | 表現の寄せ方 | 記述例 |
|---|---|---|
| 1 | 業務語彙(運用者の言葉) | 注文が確定すると出荷指示書が生成される |
| 2 | 業務語彙寄り(実装名は注釈) | 注文(order)が確定すると出荷指示書が生成される |
| 3 | 実装名前空間寄り(業務語は補助) |
order の status='confirmed' への遷移で、出荷指示書(shipping_instruction)が INSERT される |
| 4 | 実装名前空間(スキーマ・カラム名) |
order.status='confirmed' への UPDATE を契機に、shipping_instruction が INSERT される |
上記の粒度で
案件、フロントエンド、バックエンドを対象者のスキル感によりどこまで抽象か具体かで伝えるかを判断する。
改修による時間軸(extendエージェント)の実装
既存のシステムに別協力会社の製造するシステムが絡んでくる特大の改修がきた。
会議で決まった内容、何故その画面を作るか等を覚えてられない為秘書のようなエージェントを建てることにした。
秘書エージェントを建てるにあたって一つ懸念があった。
今は既存システムに別システムが絡んでいないが、将来的に絡むことになる。
が、逆に今の画面に対しての質問をした際にはその改修に関する文脈は含まないで欲しい。
これを拡張エージェント方式により解決を行った。
通常のAシステムspecエージェントを起動する文脈の際に、
Z案件に関係する内容か?という問いをユーザーに立てる。
はい、と答えるとAシステムspecエージェントはextend agentとして定義されているZ案件エージェントとブリッジして推論をおこなう。
今のところ期待した通りに動いている。
案件リリース後はAシステムに秘書の正本の吸収を行わせることにより統合を行う想定でいる。
documentの索引
例えばバッチの処理一覧など、どのバッチがいつ回るかを一度資料化しておいて視覚化した方が人間にとって読みやすく、欲しい情報が直ぐに取れる調査がある。
そういったものをユーザーの邪魔にならず提示できないかと考えた。
何度も練り直して今の形になっている
資料の概要を設定する
↓
概要をベクトル変換してベクトルDBに保存する
↓
ユーザーのプロンプトをベクトル変換する
↓
ベクトルのcos類似度をscoreとし、閾値以上のscoreであれば資料名を返却する
この方法により「○○の資料が欲しい」とエージェントに投げて確認する方式に対してtoken9割カット、速度も資料索引に対する処理が10秒から0.3秒となった。
資料が引っかからなかった場合は黙殺され表面上何も行われない。
だが別の問題が出た。
ベクトル変換を行うモデルを読み込むのに10秒かかる。
常駐させるとRAMを2GBほど消費する。
こんな事もあろうかとEC2サーバーを建てていた。
(MCPサーバーとして使う想定で用意していた)
構成として
EC2 に BGE-M3 を常駐させ、ローカルPC上で資料に対するINDEX.mdが更新された時にhooksでEC2上のQdrantに対してupsertをssh経路で発火させる。
これにより資料を生成して正本化した際に自動的にベクトルDBに対しての更新がかかるようになっている。
また、SSH鍵の共有を行っていない場合ベクトルDBの更新は黙殺されるためgit管理外であるベクトルDBの更新が別ユーザーによって更新される心配はない。
[PC]
  indexer.py → BGE-M3 embed (local) → SSH → EC2 Qdrant :6333 直接 upsert
  query.py   → HTTPS + bearer → EC2 nginx :443 → localhost :8767 (FastAPI embed) → Qdrant :6333 検索 → top-K


[EC2]
  library-vector.service (:8767) — text → BGE-M3 → Qdrant search
  qdrant.service         (:6333) — vector DB, HNSW 索引, cos 類似度
補足
AWSのSGでのIP制限、NGINXでのIP制限、sshキー、bearerでの多層防御でセキュリティの担保を行っている。
休憩
ここらでドーパミンが枯渇し始める読者の方もいると思うので話題を変える
AIの使い方が上手い人について
結局、人もAIも変わらず推論という行為をするにあたって与えられた文脈は正解を導くのに十分か、に尽きる。
文脈が不足していたとしても回答は出せるしそれにより出た出力は正解でもある。
未知数>式の状態で出した答えはある意味では正解であり、今いる世界線では許されていないだけに過ぎない。
例えば
x^2+y^2=25
上記の方程式だが解としては
(x,y)=(3,4),(4,3)
と言ったように複数の解が存在する。
そこらのバイブコーダーを見ていると「xに3は使わないでください」「yはxより小さくして下さい」のようなセンスのない制約を課す。
ここで本当に必要なのは解を一意にする為のもう一つの式であり、その場凌ぎの制約ではない。
結果別の式を渡したときに制約が無駄な枷となり無理やり整合性を合わせる為に式を変更するなどの暴挙にでる。
話を戻す
gitエージェントの過剰推論
gitエージェントを建て、gitに関する操作を行わせた。
なれた人間なら1分程度で出来る操作を5分以上かけて行っていた。
gitエージェントの委譲文、操作を確認したところいちいち現在のステータスを取得したり等、手順を解釈で組み立てて操作を行っていた。
gitに置いて正しい状態なのであれば現在の状態を知る必要はない。
操作は他に影響を与えない事が前提であり、他に影響を与える様な操作が必要なのであればgitの運用が悪い。
という事で
git-branch
fetch origin --prune → switch -c origin/master → push -u

git-commit-push
status --porcelain(untracked 検出時のみ stop)→ add -A → commit → push

git-develop-merge
switch develop → fetch → pull → merge --no-ff → push(orchestrator 明示指示のみ)

git-master-merge
同上の master 版
※
※
参画案件ではgit hub flowとgit flowの間のようなブランチ戦略をとっている。
リリースがほぼ毎日あるかつ横入りでの改修もある為Masterから作業ブランチを切りdevelopにマージ、確認が取れたものをMasterにマージする
上記4つのskillを切り出しこのskillをgitエージェントが叩く様にした。
作業ブランチを切り出してdevelopブランチにマージするタスクを3回行い、各呼出し回数平均と合計tokenを比べた。
最適化前:
Aエージェント→Gitエージェントの呼び出し回数平均9回
token:324,037
time:6min 30seconds

最適化後:
Aエージェント→Gitエージェントの呼び出し回数平均3 回(全て3回)
token:107,815
time:3min
トークンは約70%の削減
速度は約50%の短縮
となった。
という事で実装までの大まかな流れ

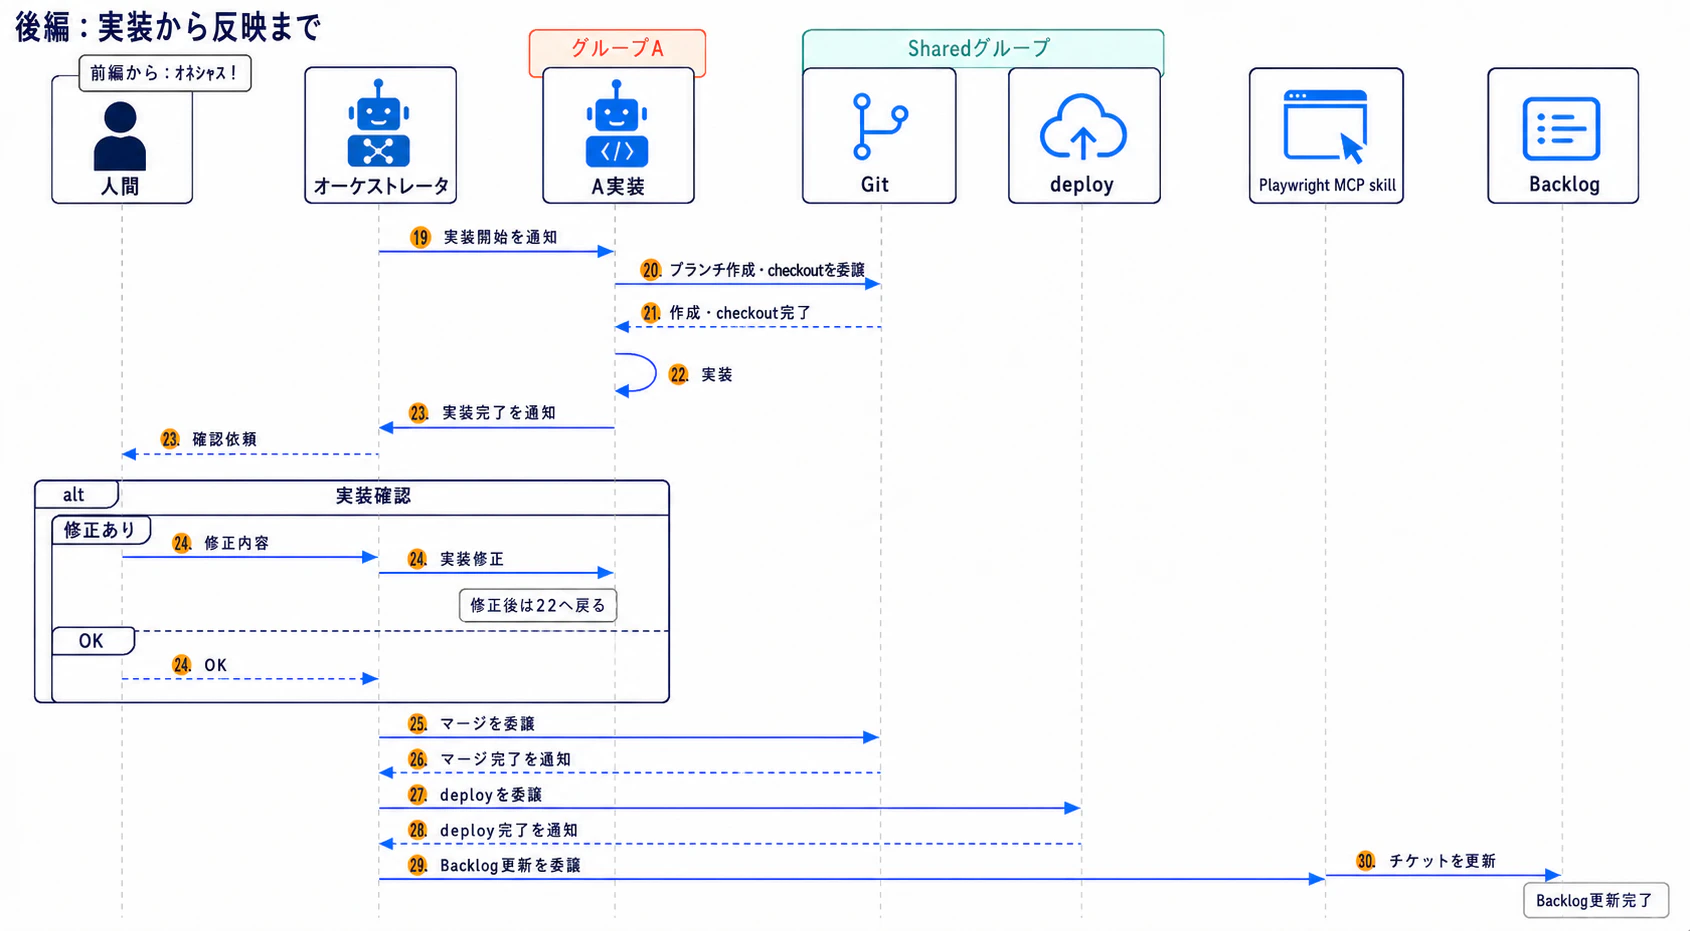
と言った感じになる。
最後に
AIに任せるのと人に任せるのは非常に似通っている。
AIの推論を信じて任せられる環境を作る事が大切なのではないかと思う。
だが最近はAIをどう利用するか?よりもチームに対してAI代替の不安をどう感じさせないかを考える事が多い。
そこに関しても設計済みだが技術とはまた別軸になるのでここでは控える。