
本記事の要点
Orca(複数の AI エージェントを並行して動かす IDE)上で、コーディネータ(Claude Code)からワーカー(Codex CLI)に数時間かかる計算ジョブを任せていたところ、ワーカーの1セッションだけで Codex の週間利用枠(以下、週間枠)の 99% を約20時間で消費する事象が発生しました。
ログから原因を調査したところ、週間枠の消費の8割前後はキャッシュから読み込まれた入力トークン(以下、キャッシュ済み入力)によるものでした。入力トークンの 99.5% はキャッシュにヒットしていましたが、リクエストのたびに長いコンテキストが再入力されることで利用枠の消費が積み上がっていました。さらにリクエストを分類すると、このセッションの週間枠消費の 55〜58% は、ジョブの完了を待つ間のモデルの呼び出し(ポーリングと定期報告)が占めていました。
対策として、ジョブの完了を外部スクリプトで監視し、終了時にのみワーカーへ通知して作業を再開させる方式(以下、完了通知方式)を導入しました。その結果、ワーカーによるポーリングは、導入前の10セッションでは753回だったのに対し、導入後の9セッションでは1回に激減しました。また、導入後に完了通知方式でジョブを待った45回について、実際の待機コストをポーリングで待った場合の見積もりと比較すると、5分ごとにポーリングした場合の約 1/9、1分ごとにポーリングした場合の約 1/43 に抑えられていました。
ただし、99% という値にはトークン量とは別の要因も影響していました。今回の調査で、同じトークン量に対する週間枠の消費量が週によって約2倍異なることが分かりました。事象が発生した週はこの消費量が大きい週に当たり、他の週の水準で換算すると、同じセッションの消費量は約半分の 47% に相当します。
なお、データはすべて筆者の環境で取得したものです。
環境
| 項目 | 内容 |
|---|---|
| エージェント | Codex CLI 0.162.1(事象の発生時)。対策の導入後は 0.165.0、0.166.0 も混在 |
| モデル | gpt-6-astra、推論 effort は xhigh |
| 構成 | Orca 上で、コーディネータ(Claude Code)が Codex のワーカーに作業を割り当てる |
| 作業の内容 | 数時間かかる計算ジョブの実行と結果の分析 |
Orca を使っていない読者向けの一般的な対処法は、「Orca を使っていない場合」の節にまとめました。
Orca でのエージェント間のやり取り
本記事の調査と対策には、Orca の次の3つの仕組みが関わります。
-
ターミナルへの入力によるターンの開始:Orca では、各エージェント(Codex CLI や Claude Code)がアプリ内のターミナルで動作します。ターミナルに文字列が入力されると、エージェントはそれをユーザーの発言として受け取り、新しいターンを始めます。
orca terminal sendコマンドを使うと、外部のスクリプトからも同様に入力してターンを開始させることができます。 -
ワーカーからのメッセージ送信:ワーカーは、コーディネータにメッセージを送って状況を伝えます。種別には、完了報告(
worker_done)、質問(question)、問題の報告(escalation)、状況報告(status)、生存報告(heartbeat)があります。このうちheartbeatは、Orca の指示に従ってワーカーが5分ごとに送ります。 -
コーディネータのメッセージ受信と通知:コーディネータは、
orca orchestration check --wait --types <種別>を実行すると、指定した種別のメッセージが届くまで待機できます。一方、届いたメッセージの種別を待っているプロセスがない場合は、Orca がコーディネータのターミナルに「You have 1 orchestration message」と自動入力するため、コーディネータは新しいターンを始めます(以下、この自動入力をコーディネータへの通知と呼びます)。
発生した事象
問題のセッションは、10/20 11:56 から 10/21 11:41 まで約24時間継続しました。途中の 10/20 15:35 に週間枠がリセットされて使用率は 0% に戻り、その後セッションが終了するまでに 99% に達しました。題名の 99% は、このリセット後の増加分です(使用率は整数で記録されるため、実際の増加は約98〜99%)。なお、リセット前にも使用率が 9% から 23% まで上昇していたため、セッション全体では約 113% を消費したことになります。
この 99% の増加に、他の作業による消費はほとんど含まれていません。リセットからセッション終了までの間に Codex で週間枠を消費していたのは、このセッションと、そこから起動された guardian(Codex が自動承認のために起動する子セッション、ログ上のモデル名は codex-auto-review)のみでした(別の PC の Codex ログでも確認済みです)。また、週間枠は ChatGPT の Work とも共有されていますが、ChatGPT のプロフィール画面に表示される日別トークン数と照合すると、この間に Codex のログ以外で使われたトークンはこのセッションの 1.5% 以下でした。
このセッションのログを集計した結果を、次の表に示します。
| 量 | 値 |
|---|---|
| ユーザーのターン数 | 3 |
| モデルへのリクエスト数 | 1,458 |
| 入力トークン(うちキャッシュ済み入力) | 6.35億(6.32億、99.5%) |
| 非キャッシュ入力 | 330万 |
| 出力(うち推論) | 139万(94万) |
| 1リクエストの入力トークン(コンテキスト長) | 平均 43.6万、最大 78.4万 |
ユーザーのターンは3回でしたが、モデルへのリクエストは1,458回に達しました。モデルはツールの結果が返るたびに呼び出され、そのたびにコンテキスト全体を入力として受け取ります。キャッシュにヒットすると入力の処理にかかる計算の大半を省略できますが、キャッシュ済み入力も週間枠を消費します。
消費の内訳1:時間ごとの推移とトークン種別
週間枠の消費の主な要因が、出力(139万トークン)とキャッシュ済み入力(6.32億トークン)のどちらであるかを、まず時間ごとの推移から確認します。図1を見ると、使用率の増加は出力ではなくキャッシュ済み入力の推移と一致しています。
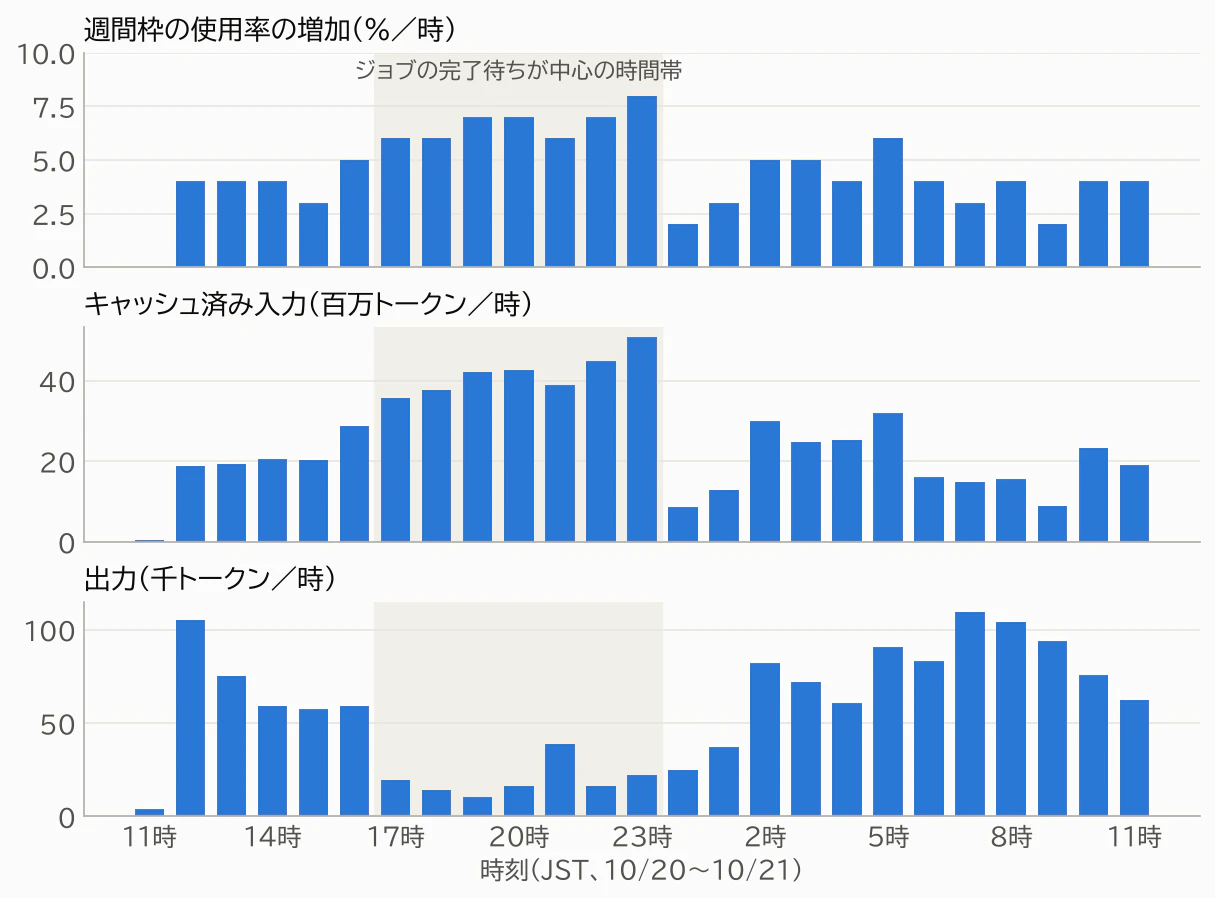
図1:上から、週間枠の使用率の増加(%/時)、キャッシュ済み入力(百万トークン/時)、出力(千トークン/時)。
出力と使用率の推移の違いが明確に現れているのは、網掛けの時間帯(17〜23時)です。この時間帯の出力は毎時 1〜4万トークンと少ないにもかかわらず、週間枠の使用率は毎時 6〜8% ずつ増加しています。このときコンテキスト長は 60〜76万トークンに達しており、リクエストのたびに大量のキャッシュ済み入力が発生していました。
消費をトークン種別に分ける
消費に占める各トークン種別の割合を定量的に確かめるため、まずログの記録から回帰分析を行いました。~/.codex/sessions/ の rollout(セッションログの JSONL)には、リクエストごとのトークン量と、その時点の週間枠の使用率 used_percent が記録されています。そこで、1時間ごとの使用率の増加量を目的変数、種別ごとのトークン量を説明変数として回帰しました(1時間ごとの24点、決定係数 R²=0.958)。信頼区間は、1時間単位のブートストラップ法を用い、used_percent の整数丸めによる誤差(±0.5% の一様乱数)を加えて求めています。
| 種別 | 係数(%/百万トークン) | 95% 信頼区間 |
|---|---|---|
| キャッシュ済み入力 | 0.156 | 0.145〜0.165 |
| 非キャッシュ入力 | 0.88 | −1.31〜8.96 |
| 出力 | 8.23 | −5.3〜14.63 |
キャッシュ済み入力の係数は信頼区間が狭い一方、他の2つの係数は信頼区間が0をまたいでおり、不確かです。そこで、回帰の係数だけでなく、公開されている料金比を用いた指標でも確認します。本記事では、トークン量に料金比を掛けて合計した値をコストと呼び、次の式で定義します(単位は非キャッシュ入力1トークン分です)。
\text{コスト} = \sum_{i=1}^{N} \left( 0.1 \cdot c_i + u_i + r \cdot o_i \right)
$N$ はリクエスト数、$c_i$、$u_i$、$o_i$ はそれぞれ $i$ 番目のリクエストのキャッシュ済み入力、非キャッシュ入力、出力のトークン数です。係数の 0.1 と $r$(6〜10 程度)は、Codex の料金表として報告されている比です(GPT-5.x の値で、gpt-6-astra の値は確認できていません)。
このセッションの消費に占めるキャッシュ済み入力の割合を計算すると、回帰の係数では 87%(95% 信頼区間 79〜93%)、固定の料金比によるコスト(キャッシュ済み入力 0.1、出力 $r$=6〜10)では 79〜85% でした。いずれの方法で計算しても、週間枠の消費の8割前後はキャッシュ済み入力によるものです。
消費の内訳2:リクエストの契機
今回のようにキャッシュのヒット率が高い(99.5%)場合、各リクエストのキャッシュ済み入力 $c_i$ はその時点のコンテキスト長とほぼ同じになります。そしてキャッシュ済み入力が消費の8割前後を占める条件では、消費の大きさは「リクエスト数 × 平均コンテキスト長」でほぼ決まります。
そこで、1,458回のリクエストが何を契機に送信されていたかを調査しました。ターンの先頭のリクエストはユーザーの指示に分類し、それ以外のリクエストは直前のツール呼び出しの種類で分類しています。表の割合は、回帰の係数で計算した場合と、固定の料金比($r$=6、10)でコストを計算した場合の3通りの値の範囲です。
| 契機 | リクエスト数 | 消費に占める割合 |
|---|---|---|
ポーリング(空入力の write_stdin、wait、sleep) |
557 | 38〜41% |
| heartbeat の送信(5分ごとの生存報告) | 235 | 17% |
| 実作業 | 663 | 41〜44% |
| ユーザーの指示 | 3 | 1% |
ポーリングと heartbeat の送信を合わせた待機中の呼び出しが、消費の 55〜58% を占めました。ジョブの実行中は、ログに次の操作が繰り返し記録されていました。
18:01 write_stdin(空入力, 60秒待つ)
18:02 write_stdin(空入力, 60秒待つ)
18:03 write_stdin(空入力, 60秒待つ)
18:04 write_stdin(空入力, 60秒待つ)
18:05 heartbeat を送信
ここでモデルが判断しているのは「まだ終わっていない、もう一度待つ」のみです。その判断のために、毎分 60〜75万トークンのコンテキストを再入力していました。
受け手のモデルも呼び出されていた
heartbeat のたびにモデルが呼び出されていたのは、送り手のワーカーだけではありませんでした。受け手のコーディネータも、heartbeat が届くたびに新しいターンを始めていました。ワーカーが稼働していた間のコーディネータのログを集計した結果を次の表に示します。
| 指標 | 値 |
|---|---|
| heartbeat のみを契機に始まったターン | 90 回 |
| その90ターンでのモデルへのリクエスト | 218 回 |
| その90ターンでのキャッシュ済み入力 | 1.01億トークン(同じ期間のコーディネータのキャッシュ済み入力全体の 65%) |
この原因は、コーディネータ側でのメッセージの待ち受け方にあります。コーディネータの待機スクリプトは、worker_done、escalation、question の3種別のみを check --wait で待っていました(Orca のドキュメントにある例と同じ指定です)。heartbeat を待つプロセスは存在しなかったため、ワーカーから heartbeat が届くたびに Orca がコーディネータのターミナルへ通知を入力し、コーディネータの新しいターンが始まっていました。このように、受け手もメッセージの着信でターンを始める構成では、定期報告を1通送るごとに送り手と受け手の両方でモデルが呼び出されます。
どこまでが Orca 固有か
今回は Orca 上での事例ですが、問題の大半は Orca を使わない環境でも発生します。問題のセッションでは、待機による消費(55〜58%)のうち、ポーリングによる 38〜41% は Orca を使わない Codex でも生じる分で、heartbeat による 17% が Orca の構成による分です(いずれもセッション全体の消費に対する割合)。
本記事で扱う現象と対策がどの範囲に当てはまるかを、次の表に整理します。
| 項目 | 範囲 | 根拠 |
|---|---|---|
| モデルを呼び出すたびにコンテキスト全体を再入力する | エージェント全般 | モデルの呼び出し方の問題。キャッシュ済み入力の寄与が大きいと、コストは「リクエスト数 × 平均コンテキスト長」でほぼ決まる |
| ジョブ待ちのポーリング | Codex 全般 | Orca を使っていない26セッションでも、コストの 31% |
| 定期報告のたびに送り手と受け手の両方でモデルが呼び出される | 定期報告を行うマルチエージェント構成 | 考え方は共通で、数値は Orca で測定 |
| 待っているプロセスがない種別のメッセージによる、コーディネータへの通知 | Orca 固有 | 実験で確認 |
対策:ターンを終えたワーカーへの外部からの入力(orca terminal send) |
実装のみ Orca 依存 | 他の環境では別の手段が必要 |
| コストあたりの週間枠の消費量の変動 | Codex 全般(後述) | Orca とは無関係のアカウント側の値 |
対策:ジョブの完了をスクリプトで監視する
待機中にモデルが行っていた判断は「もう一度待つ」のみでした。そこで、判断が不要な間はモデルを呼び出さないことを原則とし、ワーカー側とコーディネータ側の双方で対策を行いました。
ワーカー側:ターンを終えて完了通知を待つ
ワーカーはジョブを起動すると直ちにターンを終え、ジョブの終了後に完了通知を受けて作業を再開します。これを完了通知方式と呼びます。
ジョブの起動には park.py(末尾の「コード」の節に掲載)を使います。park.py は、ワーカーとは独立して動作し続けるプロセス(以下、サイドカー)を起動したあと、自身は直ちに終了します。そのため、ワーカーはジョブの完了を待たずにそのままターンを終えることができ、次の入力があるまでモデルは呼び出されません。
サイドカーは実際のジョブを子プロセスとして起動し、親プロセスとしてその終了コードを取得します。ジョブが終了すると、サイドカーが orca terminal send でワーカーのターミナルに完了通知の文を入力します。ワーカーはこの入力をユーザーの発言として受け取って新しいターンを始め、作業を再開します。
ワーカーへの指示には、次の内容を含めました。
- 実行中のジョブをポーリングしない(空の write_stdin、wait/sleep、tail の繰り返し)。
- 1分以上かかるジョブは park.py で起動し、ターンを終える。
- "[orca-park keepalive" で始まる入力には、ジョブの完了を待っている間なら、ツールを呼ばずに一言返してターンを終える。
- "[orca-park done]" で始まる入力が来たら、ログを読んで再開する。
キャッシュを維持するための呼び出し(keepalive)
完了通知を待つ時間が長い場合、その間にキャッシュが破棄されることがあります。待機中に一定間隔でモデルを呼び出すこと(以下、keepalive)でキャッシュを維持できますが、keepalive 自体にもコストがかかります。
$C$ をコンテキスト長(トークン数)とすると、keepalive 1回のコストは $0.1C$、キャッシュミスで増えるコストは $0.9C$ です。keepalive 9回分のコストがキャッシュミス1回分の増加と等しいため、1回の待機に keepalive が9回より多く必要な場合は、keepalive を中止してキャッシュミスを1回許容するほうがコストは低くなります(同じ損益分岐は Vaughan 氏の記事にも示されています)。
ジョブの長さは事前には不明なため、keepalive は25分ごとに行い、最大4回で打ち切ることとしました。長いジョブでは keepalive のコストをかけ続けず、キャッシュミスを1回許容します(スキーレンタル問題と同じ考え方です)。
コーディネータ側:すべての種別を待つ
コーディネータ側では、待機スクリプトが待つ種別に heartbeat と status を加えました。
orca orchestration check --run <run_id> --wait \
  --types worker_done,escalation,question,heartbeat,status \
  --timeout-ms 600000 --json
この check を繰り返し実行するスクリプトが coord_wait.py(以下、待機ループ。末尾に掲載)です。待機ループは Claude Code の Bash ツールでバックグラウンド実行します。待機ループが終了したときにのみコーディネータにその結果が返り、コーディネータのモデルが呼び出されます。
待機ループは、heartbeat と status を受け取ると ack(受信確認)してファイルに記録し、終了せずにそのまま待機を続けます。待機ループが終了するのは、完了報告(worker_done)・質問(question)・問題の報告(escalation)が届いたときと、ワーカーやサイドカーの停止を検知したときに限られます。そのため、コーディネータのモデルが呼び出されるのはこれらの場合のみとなり、ワーカーの生存確認はモデルではなく待機ループが行います。
heartbeat の間隔を延ばす
コーディネータ側の待機ループで受け手側のモデル呼び出しは防げますが、ワーカーが稼働中に5分ごとに heartbeat を送る際のモデル呼び出し自体は残ります(後述する導入後の実運用でも、ワーカーのコストのうち最大 8.0% は heartbeat の送信によるものでした)。
現在の Orca では、Settings → Agent Orchestration で heartbeat の間隔を1〜60分の範囲で変更することや、heartbeat を停止することができます(既定は5分。Orca のドキュメントで確認。この設定は、変更後に作業を割り当てたワーカーから適用されます)。筆者が使った 1.4.229 にこの設定があったかは確認しておらず、本記事の数値はすべて5分間隔でのものです。なお、coord_wait.py は完了通知を待っていないワーカーから1時間メッセージが届かない場合に終了するため、heartbeat を停止する場合はこの判定も見直す必要があります。
検証
実運用に入れる前に、ワーカー側の完了通知方式とコーディネータ側の待機ループがそれぞれ意図どおりに動作するかを検証しました。
Codex ワーカーでの通し試験
コンテキスト長が約2万トークンの Codex ワーカーで、55分かかる sleep の終了を完了通知方式で待つ試験を行いました。
| ターン | 時刻 | リクエスト数 | ツール呼び出し | ターン先頭のリクエストで、直前のリクエストの入力のうちキャッシュから読み込まれた割合 |
|---|---|---|---|---|
| ジョブの起動 | 02:10 | 2 | 1 | — |
| keepalive 1回目 | 02:36 | 1 | 0 | 0.58 |
| keepalive 2回目 | 03:01 | 1 | 0 | 0.99 |
| 完了通知 | 03:06 | 2 | 1 | 0.99 |
待機中のモデルの呼び出しは、keepalive の2回のみでした。サイドカーは park.py の終了後も動作し続け、ジョブの終了から3秒後にワーカーへ完了通知を送信しました。
コーディネータへの通知は停止するか
待機ループの実行中にコーディネータへの通知が届かなくても、それだけでは待機ループの効果とは断定できません。Orca が待機ループとは別の理由で通知を出していなかった可能性があるためです。そこで、待機ループの実行中に通知が止まることと、終了後に再び通知が届くことをあわせて確認しました。
| 条件 | 結果 |
|---|---|
| 待機ループの実行中に、ワーカーのターミナルから heartbeat を3通送る | コーディネータへの通知は0回。3通とも、約1秒以内に待機ループが受信した |
待機ループの終了後に、worker_done を1通送る |
数秒でコーディネータに通知が届いた |
待機ループの終了後に、status を1通送る |
コーディネータに通知が届いた(コーディネータが応答している最中のターンにも割り込んだ) |
導入後の実運用
実際の作業でも、待機に伴うモデルの呼び出しは大幅に減少しました。導入後の数値は約2週間(10/23〜11/4)の実績で、上記の試験は除外しています。
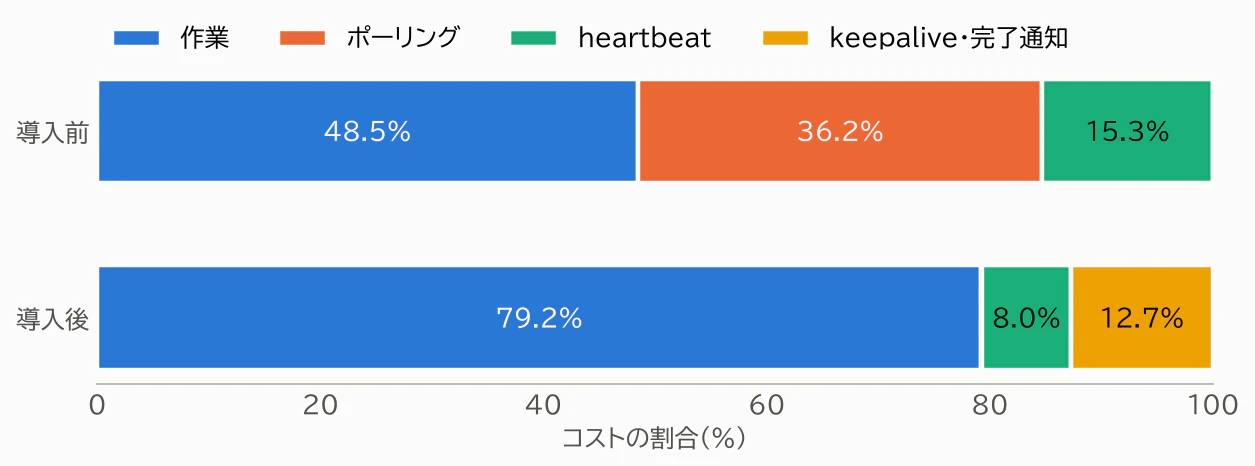
図2:Orca のワーカーとして動作した Codex セッションのコストの内訳。導入前は10セッション、導入後は9セッション。コストは $r=6$ で計算した。
| 指標 | 導入前 | 導入後 |
|---|---|---|
| ポーリングの呼び出し | 753 回 | 1 回 |
| heartbeat の呼び出し | 297 回 | 69 回 |
| コストに占める待機関連の割合 | 51.5% | 20.8% |
| コーディネータへの通知 | 99 回(10/20〜21) | 0 回 |
導入後に残った 20.8% の内訳は、keepalive と完了通知が 12.7%、heartbeat が 8.0%、ポーリングが 0.1% です。heartbeat の 8.0% には、実作業のコマンドと同時に heartbeat を送信した分も含まれるため、待機関連の割合は最大でも 20.8% です。
なお、導入の前後で作業の内容が異なるため、これは同一条件での実験ではなく実運用での比較です。ここではコストの総量ではなく、割合と回数を比較しています。
他の待ち方とのコストの比較
待ち方によって待機コストがどれだけ変わるかを確かめるため、導入後に完了通知方式で待った45回のジョブ(計117時間、中央値30分、最長約28時間、コンテキスト長の中央値21万トークン)について、実際のコストと、同じジョブを5分ごと・1分ごとのポーリングで待った場合の見積もりでのコストを比較しました。
ポーリング1回あたりの非キャッシュ入力と出力には導入前の平均(非キャッシュ入力 802、出力 239 トークン)を、キャッシュ済み入力には各ジョブのコンテキスト長を使い、コストは $r=6$ で計算しています。ポーリングを続けることでコンテキストが長くなる分は無視しているため、ポーリング側のコスト見積もりは控えめな(少なめに見積もられた)値です。
| 待ち方 | コスト(百万単位) | 完了通知方式との比 |
|---|---|---|
| 完了通知方式(実際の値) | 3.63 | — |
| 5分ごとにポーリングした場合 | 31.2 | 8.6倍 |
| 1分ごとにポーリングした場合 | 156.1 | 43倍 |
最長のジョブをポーリング側から除いても(完了通知方式のコストは45回分のまま)、比は5分ごとで 7.0倍、1分ごとで 35倍です。
短いジョブでは、ポーリングの間隔を延ばすだけでもコストを大幅に削減できます(詳しくは Yusg_6 氏の記事 を参照してください)。完了通知方式との差が大きくなるのは長いジョブです。約28時間のジョブでは、5分ごとにポーリングすれば約333回モデルを呼び出す計算ですが、完了通知方式では5回(keepalive 4回と完了通知1回)で済みました。
キャッシュは何分保持されるのか
keepalive の間隔を25分にしたのは、キャッシュが少なくとも30分は保持されると見込んだためです。この見込みが妥当であったかをログから検証しました。
検証では、リクエスト間の空白時間(前のリクエストの終了から次のリクエストの開始まで)と、キャッシュ残存率の指標 cached_input_tokens / 直前のリクエストの input_tokens との関係を調べました。分母を今回のリクエストではなく直前のリクエストの入力にしたのは、今回の入力を分母にすると、新しいツール出力が大きいだけでも値が下がってしまうためです。集計対象は、guardian を除いたエージェント本体(以下、主エージェント)のリクエストのうち、直前のリクエストの入力が1.5万トークン以上のものとしました。コンテキストの圧縮・モデル変更・履歴の縮小があった回は除き、指標の値が 0.8 未満の場合をキャッシュミスと判定しています。
| 空白時間 | キャッシュミス/件数 |
|---|---|
| 5〜10分 | 1 / 14 |
| 10〜20分 | 0 / 13 |
| 20〜30分 | 1 / 79 |
| 30〜60分 | 3 / 5 |
| 1〜2時間 | 6 / 13 |
| 2時間超 | 14 / 21 |
空白時間が5〜30分の場合、キャッシュはほぼ残っていました。5〜30分の3区間を合わせたミス率は 1.9%(95% 信頼区間 0.5〜6.6%)で、OpenAI サポートの「30 minutes as a minimum lifetime, rather than a hard expiry」という説明と矛盾しません。実運用の keepalive 73回でも、キャッシュミスは1回も発生しませんでした(コンテキスト長の中央値は約21万トークン。73回とも、最初のリクエストではツールを呼び出していません)。
一方、Vaughan 氏の記事の表では、OpenAI で600秒の空白時間の後にキャッシュが残っていた割合は 19/24(79%)で、筆者の測定(空白時間5〜10分で 13/14、93%)より低い値です。条件が異なる可能性がありますが、この割合の差が生じた理由は不明です。
また、1時間を超える空白時間では、ミス率が時期によって大きく異なりました。9〜10月は 83%(19/23)だったのに対し、11月は 9%(1/11)です。11月のデータは件数が少なく(95% 信頼区間 2〜38%)、この違いが仕様変更によるものかは確認できていません。
この1時間超でのミス率の違いは、そもそも keepalive でコストが減るかどうかに関わります。実運用では30分以上待機を行ったジョブが23回ありました。実際に73回行った keepalive の合計コストは、仮に keepalive を一切行わず、この23回すべての再開時にキャッシュが破棄されていたとした場合に増えるコストの 36% でした。したがって、再開時にコンテキスト全体のキャッシュが破棄される確率を一律と仮定すると、30分以上の待機でのミス率が 36% を下回る環境では、keepalive を行わないほうがコストは低くなります。上記のミス率は部分的なミスを含み、空白時間の範囲も異なるため、この 36% とそのまま比較することはできませんが、空白時間が長くてもキャッシュミスが起きにくい状態が続く場合、keepalive はかえってコストを増やす可能性があります。
週によるコストあたりの消費量の変動
冒頭で述べたとおり、1セッションで週間枠を 99% 消費したという結果には、トークン量とは別の要因も影響していました。コスト(トークン量に料金比を掛けた値)100万単位あたりの週間枠の使用率の増加(以下、コストあたりの消費量)を週ごとに比較すると、想定していなかった差がありました。
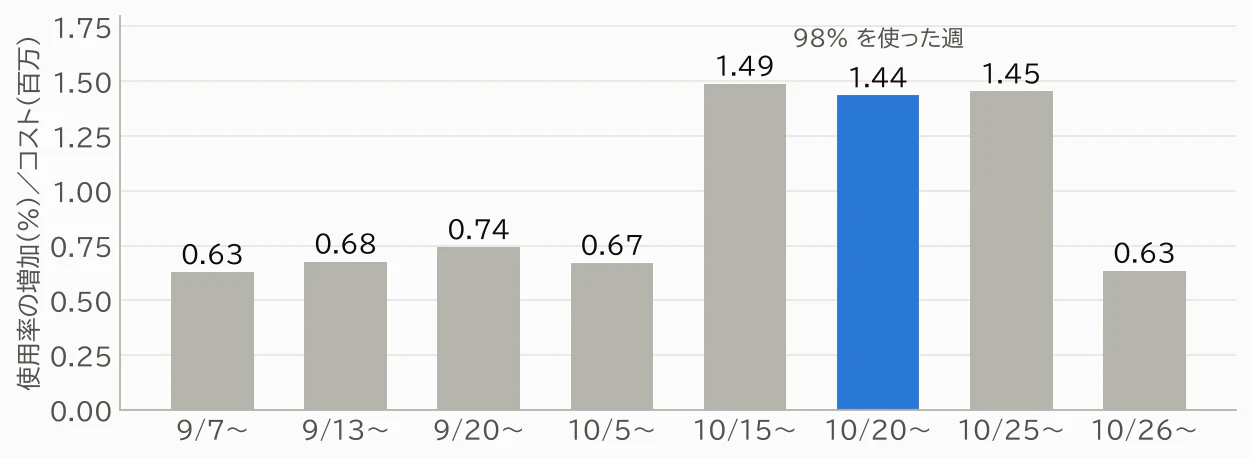
図3:週ごとの、週間枠の使用率の増加 ÷ コスト(百万単位)。guardian のトークンは含まない。gpt-6-astra が主に使われた週のみ。別のモデルが主に使われた 9/27 の週(値 0.33)と、コストが250万単位未満の 10/23 の週(使用率の増加 6%、値 3.07。Codex のログにない Work の利用を含む)は除いた。10月中旬以降は予定外のリセットが続いたため、1週間より短い区間がある。
10/15〜10/25 のコストあたりの消費量は、前後の週の約2倍になっています。事象が発生したセッションの回帰係数を使って他の週の使用率の増加を予測すると、9月の週と 10/26 からの週のいずれにおいても、予測値は実際の約2倍になりました。99% を使った週のコストあたりの消費量(1.44)を、9〜10月前半の水準(0.68)に置き換えて換算すると、同じセッションのトークン量による使用率の増加は約 47% になります。
コストあたりの消費量が変わる要因としては、モデルの料金(単価)の変更か、週間枠の利用上限自体の変動が考えられますが、今回の変動の原因は特定できていません。まず、gpt-6-astra の料金が10月に変わったという情報は見つかりませんでした。一方、利用上限が変化した可能性については、時期が近い出来事が2つあります。
- 利用上限の適用不具合(10月中旬):10/17〜18 に「消費が想定より速い」という報告が相次ぎ、OpenAI の Codex 責任者が 10/21 未明(日本時間)に「約4万アカウントで、適用された利用上限が選択したプランと一致していなかった」と公表しました。ただし、筆者は該当者であるという連絡を受けておらず、修正の公表後もコストあたりの消費量は下がりませんでした。
- 一部プランの利用上限引き上げ(10月下旬):10/29 に一部プランの Work と Codex の利用上限が2倍に引き上げられました(BleepingComputer)。筆者の環境でコストあたりの消費量が9月の水準に戻ったのは 10/25 から 10/30 の間で、時期は重なりますが、この変更が原因かは確認できていません。
原因は不明ですが、コストあたりの消費量が週によって変わる以上、今回の対策の効果は、導入前後の週間枠の使用率(%)を比較しても判断できません。10/26 からの週は 18% の消費にとどまっていますが(11/4 時点)、この値にはコストあたりの消費量が約半分に戻った影響も含まれています。本記事で導入前後の効果をトークン量ベースのコストで比較していたのは、この週ごとの変動の影響を除くためです。
Orca を使っていない場合
Orca を使っていない環境でも、ログの集計による現状把握(1〜2)と、待機中のモデル呼び出しを減らす対策(3〜5)は同様に適用できます。
-
リクエスト数と平均コンテキスト長の計測:まず、セッションログからリクエスト数と平均コンテキスト長を集計します。リクエスト数がユーザーのターン数よりはるかに多く、コンテキストも長い場合は、本記事の事例と同じ状況です。
import json, sys

n = inp = cached = out = 0
seen = None
for line in open(sys.argv[1]):
    d = json.loads(line)
    p = d.get("payload") or {}
    if p.get("type") != "token_count" or not p.get("info"):
        continue
    u = p["info"]["last_token_usage"]
    key = (u["input_tokens"], u["cached_input_tokens"], u["output_tokens"])
    if key == seen:  # the same usage can be written twice
        continue
    seen = key
    n += 1
    inp += u["input_tokens"]
    cached += u["cached_input_tokens"]
    out += u["output_tokens"]
print(f"requests={n} mean_context={inp // max(n, 1):,} cached={cached:,} ({cached / max(inp, 1):.1%}) output={out:,}")
rollout の形式は公開仕様ではなく、バージョンによって変わる可能性があります(Codex 0.162〜0.166 の rollout で確認)。
-
モデルを呼び出さない使用率の取得:週間枠の使用率は、app-server の
account/rateLimits/readを使えばモデルを呼び出さずに取得できます。この方法で監視しても週間枠は消費しません(Codex 0.166.0 で確認)。{ echo '{"id":1,"method":"initialize","params":{"clientInfo":{"name":"probe","version":"0"}}}' echo '{"method":"initialized"}' echo '{"id":2,"method":"account/rateLimits/read"}' sleep 5 } | timeout 20 codex app-server 2>/dev/null \ | jq -c 'select(.id == 2) | .result.rateLimits.primary' -
短いジョブでの対策(ポーリング間隔の延長):短いジョブでは、ポーリングの間隔を延ばすことが効果的です。Yusg_6 氏の記事に設定方法が解説されています。なお、コマンドに
timeout 1800を付けて実行しても、ツール呼び出しは30分待たずに戻ります。Codex のコマンド実行ツールは、待機の上限yield_time_msを過ぎると、コマンドの完了前に結果を返すためです。 -
長いジョブでの対策(ターン終了と外部からの再開):長いジョブでは、エージェントにいったんターンを終えさせ、ジョブの終了後に外部から入力を送って再開させるか、別のセッションで作業を続けます。入力を送る手段は環境によって異なります(tmux の
send-keysなどが候補ですが、筆者は Orca のterminal sendでしか検証していません)。dev.to の記事のように、状態をファイルに書いてセッションを終える方法もあります。 -
モデルを使わない生存確認:ジョブの生存確認にはモデルを使わず、ジョブのプロセスや、ジョブ自身が更新するファイルで確認します。Codex の rollout の更新時刻はモデルが最後に呼び出された時点の目安にはなりますが、完了通知方式ではジョブの実行中にモデルを呼び出さないため、ジョブの生存確認には使用できません。
限界
- 環境の固有性:データはすべて筆者の環境で取得したものです。週間枠の大きさは環境によって異なるため、使用率の絶対値は他の環境での値と比較できません。
- 回帰係数の適用範囲:回帰の係数は1セッション・24点から求めたもので、他の週には当てはまりません。
- 料金比の前提:コスト計算に用いた料金比は GPT-5.x の値として報告されたもので、gpt-6-astra では未確認です。
- 導入前後の比較条件:導入前後で作業内容が異なるため、本記事の比較は適切にデザインされた実験ではなく実運用の観察に基づくものです。
- 試算の仮定:他の待ち方との比較では、ポーリング1回の非キャッシュ入力と出力が導入前の平均と同じだと仮定しています。
- ChatGPT Work との共有による影響:週間枠は ChatGPT の Work とも共有されていますが、Work の利用は Codex のログに残りません。そのため、週ごとのコストあたりの消費量には Work の利用分が含まれている可能性があります。たとえば 10/24(UTC)には、Codex のログにないトークンが約5300万ありました。
- 未解明の現象:ターンの途中で、リクエスト間の空白時間が1分未満でもキャッシュミスが 92/18,152 件ありました。また、guardian は主エージェントと異なり、30分以内でも空白時間が長いほどミス率が上がります(1〜5分で 5.6%、20〜30分で 27.7%)。週によってコストあたりの消費量が変わった理由も不明です。
- Orca のバージョン依存:Orca の通知の挙動は、2026年10月時点の配布物と実験で確認したものです(確認時と下書きの執筆時のバージョンは 1.4.229)。今後の更新で変わる可能性があります。
関連する記事
- CodexにCIの状態を何度も確認させるのをやめたら、入力トークンが約9割減った:ツールごとの待機時間の仕組みと設定(入力 587,257 → 65,982)。本記事はその「長いジョブ」の場合を扱います。
- Codex CLIの作業記録を数えたら、トークンの99%は入力で、その93%はキャッシュだった:99セッションの集計。
- トークン数はコストの代理変数にならない:Claude Code の25,574ターンの分析。
- Stop Paying Your Agent to Wait:ポーリングのコストの整理と、ツールごとの待機設定。
- Keepalive economics:キャッシュを維持するための呼び出しの損益分岐。
- Case Study: I asked an AI agent to revise a slide deck. It read ten million tokens:親エージェントがコンテキストを繰り返し読み込んだ事例と、OpenAI サポートの回答。
コード
実際に使っているコードです(整形し、環境固有の記述を除きました)。Python の標準ライブラリで動作します。usage_regression.py のみ numpy が必要です。完了通知方式の実装(park.py と coord_wait.py)は Orca の CLI に依存します。
集計は次の順に実行します。
python requests_table.py requests.jsonl
python session_breakdown.py requests.jsonl <セッションID>
python usage_regression.py requests.jsonl "2026-10-20 02:56" "2026-10-21 02:41"  # 基準とする期間(UTC)
python before_after.py requests.jsonl "2026-10-23 03:30"                         # 導入時刻(JST)
python cache_gap.py requests.jsonl
python robustness.py requests.jsonl "2026-10-23 03:30"
before_after.py と robustness.py の3つ目の引数には、試験用など集計から除くセッションの ID を指定できます。本文の数値は、「Codex ワーカーでの通し試験」のセッションを除いたものです。
park.py(ワーカー側:ジョブを起動してターンを終え、完了時に通知する)
"""Park an Orca worker while a long job runs, and wake it from outside.

A parked worker ends its turn instead of polling. A detached sidecar owns the
job as its child, so it gets the exit code, and types two kinds of prompts into
the worker's terminal with `orca terminal send`:

- keepalive: every --keepalive-s seconds, at most --max-keepalive times. With the
  rate ratios reported for Codex, one keepalive costs 0.1 C and one cache miss 0.9 C
  extra (C = context tokens). Stopping after a fixed count is the ski-rental rule:
  long jobs accept one miss instead of paying for keepalives without end.
- done: once, when the job exits, with its exit code and log path.

Both are sent only after `orca terminal wait --for tui-idle` succeeds. That
check appears to be output-quiescence based (it held at once on a `cat`
terminal and on a Claude terminal mid-turn), so it does not prove the agent is
idle: both texts are worded to be harmless inside a running turn. A keepalive
whose idle wait times out is skipped (a busy worker's cache is warm anyway).
One dispatch parks one job at a time: a second `start` is refused while one is parked.

State lives in ~/.cache/orca-park/<dispatch>.json; coord_wait.py reads it.

Usage:
  uv run --no-project python park.py start --terminal TERM --dispatch DISPATCH \
      --log LOG [--keepalive-s 1500] [--max-keepalive 4] -- CMD ...
  uv run --no-project python park.py status DISPATCH
"""

from __future__ import annotations

import argparse
import json
import os
import shlex
import subprocess
import sys
import time
from datetime import datetime, timezone
from pathlib import Path

STATE_DIR = Path.home() / ".cache" / "orca-park"
ORCA = os.environ.get("ORCA_CLI_COMMAND", "orca")
CACHE_TTL_S = 1800  # OpenAI documents 30 min as the minimum prompt-cache lifetime


def _now() -> float:
    return time.time()


def _iso(t: float | None) -> str | None:
    return None if t is None else datetime.fromtimestamp(t, timezone.utc).isoformat()


def state_path(dispatch: str) -> Path:
    return STATE_DIR / f"{dispatch}.json"


def read_state(dispatch: str) -> dict:
    return json.loads(state_path(dispatch).read_text())


def write_state(st: dict) -> None:
    # Atomic replace: coord_wait.py may read the file at any moment.
    p = state_path(st["dispatch"])
    tmp = p.with_suffix(".json.tmp")
    tmp.write_text(json.dumps(st, indent=1))
    os.replace(tmp, p)


def _orca(*args: str, timeout: float) -> tuple[bool, str]:
    try:
        r = subprocess.run([ORCA, *args, "--json"], capture_output=True, text=True, timeout=timeout)
    except (OSError, subprocess.TimeoutExpired) as e:
        return False, repr(e)
    return r.returncode == 0, (r.stdout + r.stderr).strip()[-2000:]


def terminal_writable(terminal: str) -> tuple[bool, str]:
    """A closed terminal stays in `terminal show` as orphaned; `tui-idle` on it
    only times out, so check first to fail fast."""
    ok, out = _orca("terminal", "show", "--terminal", terminal, timeout=60)
    if not ok:
        return False, f"terminal show failed: {out}"
    try:
        t = json.loads(out)["result"]["terminal"]
    except (ValueError, KeyError, TypeError):
        return False, f"terminal show unparsable: {out[:300]}"
    alive = not t.get("orphaned") and t.get("writable", True) and t.get("connected", True)
    flags = {k: t.get(k) for k in ("orphaned", "connected", "writable")}
    return alive, "" if alive else f"terminal not writable: {json.dumps(flags)}"


def send_prompt(terminal: str, text: str, idle_timeout_s: float) -> tuple[bool, str]:
    """Type `text` + Enter into the worker terminal once its TUI is idle."""
    ok, out = terminal_writable(terminal)
    if not ok:
        return False, out
    ok, out = _orca(
        "terminal",
        "wait",
        "--terminal",
        terminal,
        "--for",
        "tui-idle",
        "--timeout-ms",
        str(int(idle_timeout_s * 1000)),
        timeout=idle_timeout_s + 30,
    )
    if not ok:
        return False, f"tui-idle wait failed: {out}"
    return _orca(
        "terminal",
        "send",
        "--terminal",
        terminal,
        "--text",
        text,
        "--enter",
        "--wait-submit",
        "30",
        timeout=90,
    )


def _fmt_elapsed(s: float) -> str:
    return f"{int(s // 3600)}h{int(s % 3600 // 60):02d}m"


def sidecar(dispatch: str) -> int:
    st = read_state(dispatch)
    with open(st["log"], "ab") as log:
        job = subprocess.Popen(
            st["cmd"],
            cwd=st["cwd"],
            stdin=subprocess.DEVNULL,
            stdout=log,
            stderr=subprocess.STDOUT,
        )
    st.update(job_pid=job.pid, sidecar_pid=os.getpid(), phase="parked")
    write_state(st)

    t0 = st["started_at"]
    next_keepalive = t0 + st["keepalive_s"]
    while job.poll() is None:
        time.sleep(5)
        now = _now()
        if now < next_keepalive or st["keepalive_sent"] >= st["max_keepalive"]:
            continue
        n = st["keepalive_sent"] + 1
        # tui-idle can be satisfied while an agent is mid-turn, so the text must
        # be harmless when it lands in a running turn.
        text = (
            f"[orca-park keepalive {n}/{st['max_keepalive']}] job {job.pid} still "
            f"running ({_fmt_elapsed(now - t0)}). If you are idle and parked on this "
            f"job, reply with one line and end the turn without calling any tool. "
            f"If you are in the middle of other work, ignore this line and continue."
        )
        # Short idle wait: a busy TUI means the cache is already warm.
        ok, out = send_prompt(st["terminal"], text, idle_timeout_s=60)
        if ok:
            st.update(keepalive_sent=n, last_wake_at=_now(), last_send_receipt=out)
        else:
            st["last_keepalive_skip"] = out[-300:]
        next_keepalive = _now() + st["keepalive_s"]
        write_state(st)

    st.update(phase="job_exited", exit_code=job.returncode, exited_at=_now())
    write_state(st)
    text = (
        f"[orca-park done] job {job.pid} exited with code {job.returncode} after "
        f"{_fmt_elapsed(st['exited_at'] - t0)}. Log: {st['log']}. Resume the task "
        f"(if you are in the middle of other work, finish that step first)."
    )
    # The worker may have been woken by someone else meanwhile; wait up to 1 h
    # for it to go idle rather than typing into a running turn.
    err = ""
    for _ in range(6):
        ok, out = send_prompt(st["terminal"], text, idle_timeout_s=600)
        if ok:
            st.update(phase="wake_sent", wake_sent_at=_now(), last_wake_at=_now(), last_send_receipt=out)
            write_state(st)
            return 0
        err = out
        if out.startswith("terminal "):  # closed or unknown terminal: retrying cannot help
            break
    st.update(phase="wake_failed", error=err[-500:])
    write_state(st)
    return 1


def start(a: argparse.Namespace) -> int:
    cmd = a.cmd[1:] if a.cmd[:1] == ["--"] else a.cmd
    if not cmd:
        sys.exit("park.py start: missing job command after --")
    if a.keepalive_s >= CACHE_TTL_S:
        print(
            f"warning: --keepalive-s {a.keepalive_s} >= cache TTL {CACHE_TTL_S} s; "
            "keepalives will arrive after the cache has expired",
            file=sys.stderr,
        )
    STATE_DIR.mkdir(parents=True, exist_ok=True)
    if state_path(a.dispatch).exists():
        old = read_state(a.dispatch)
        pid = old.get("sidecar_pid")
        if old.get("phase") in ("starting", "parked", "job_exited") and pid and Path(f"/proc/{pid}").exists():
            sys.exit(
                f"dispatch {a.dispatch} already parks job {old.get('job_pid')} (sidecar {pid}); "
                "chain several jobs into one command instead"
            )
    log = str(Path(a.log).resolve())
    Path(log).parent.mkdir(parents=True, exist_ok=True)
    st = {
        "dispatch": a.dispatch,
        "terminal": a.terminal,
        "cmd": cmd,
        "cwd": os.getcwd(),
        "log": log,
        "phase": "starting",
        "started_at": _now(),
        "keepalive_s": a.keepalive_s,
        "max_keepalive": a.max_keepalive,
        "keepalive_sent": 0,
        "job_pid": None,
        "sidecar_pid": None,
        "exit_code": None,
        "exited_at": None,
        "wake_sent_at": None,
        "last_wake_at": None,
    }
    write_state(st)
    side_log = open(STATE_DIR / f"{a.dispatch}.sidecar.log", "ab")
    side = subprocess.Popen(
        [sys.executable, os.path.abspath(__file__), "_sidecar", a.dispatch],
        stdin=subprocess.DEVNULL,
        stdout=side_log,
        stderr=subprocess.STDOUT,
        start_new_session=True,  # survive the end of the worker's tool call
    )
    for _ in range(100):
        st = read_state(a.dispatch)
        if st["job_pid"] is not None:
            break
        if side.poll() is not None:
            sys.exit(f"sidecar exited early (code {side.returncode}); see {side_log.name}")
        time.sleep(0.1)
    else:
        sys.exit(f"sidecar did not start the job within 10 s; see {side_log.name}")
    print(
        json.dumps(
            {
                "parked": True,
                "job_pid": st["job_pid"],
                "sidecar_pid": side.pid,
                "state": str(state_path(a.dispatch)),
                "log": log,
                "cmd": shlex.join(cmd),
                "started_at": _iso(st["started_at"]),
            }
        )
    )
    return 0


def main() -> int:
    if len(sys.argv) == 3 and sys.argv[1] == "_sidecar":
        return sidecar(sys.argv[2])
    ap = argparse.ArgumentParser(description=__doc__.split("\n\n")[0])
    sub = ap.add_subparsers(dest="action", required=True)
    s = sub.add_parser("start", help="launch a job and park the worker")
    s.add_argument("--terminal", required=True, help="worker terminal handle (term_...)")
    s.add_argument("--dispatch", required=True, help="Orca dispatch id (ctx_...)")
    s.add_argument("--log", required=True, help="job stdout/stderr file")
    s.add_argument("--keepalive-s", type=int, default=1500)
    s.add_argument("--max-keepalive", type=int, default=4)
    s.add_argument("cmd", nargs=argparse.REMAINDER)
    q = sub.add_parser("status", help="print the park state of a dispatch")
    q.add_argument("dispatch")
    a = ap.parse_args()
    if a.action == "status":
        print(json.dumps(read_state(a.dispatch), indent=1))
        return 0
    return start(a)


if __name__ == "__main__":
    sys.exit(main())
coord_wait.py(コーディネータ側:全種別を待つ待機ループ)
"""Coordinator wait loop: wake the coordinator only when it must act.

Orca types "You have N orchestration messages" into an idle coordinator for every
unread message type that has no live `check --wait` waiter. Waiting only on
worker_done/escalation/question therefore lets every heartbeat wake the coordinator.
This loop waits on every type, acks heartbeat/status batches into OUT.msgs, and exits
only for:

  0  a delivery with any other type (left unacknowledged in OUT)
  10 the watched dispatch's fleet liveness is `exited`
  11 park.py could not deliver its wake (park state `wake_failed`)
  12 the park sidecar died before delivering its wake
  13 silence: no message from a watched dispatch for --silence-s (default
     60 min) while that worker is not parked. Workers piggyback heartbeats on
     commands they run anyway, so a long think or edit can look silent: treat
     13 as "go and look", not as proof of a stall.

One loop per Run: `check` consumes the Run's FIFO deliveries, so two loops on
one Run would steal each other's batches. Repeat --dispatch to watch several
concurrent workers.
  4  --max-iter waits completed
  5  `check` itself failed MAX_CHECK_ERRORS times in a row

Run it with Bash `run_in_background` (the Bash tool stops at 600 s).

Usage:
  uv run --no-project python coord_wait.py --run RUN --dispatch D1 [--dispatch D2 ...] --out OUT
      [--max-iter 48] [--wait-ms 600000] [--silence-s 3600]
"""

from __future__ import annotations

import argparse
import json
import os
import subprocess
import sys
import time
from datetime import datetime
from pathlib import Path
from zoneinfo import ZoneInfo

ORCA = os.environ.get("ORCA_CLI_COMMAND", "orca")
PARK_DIR = Path.home() / ".cache" / "orca-park"
QUIET_TYPES = {"heartbeat", "status"}
ALL_TYPES = "worker_done,escalation,question,heartbeat,status"
CHECK_ERROR_BACKOFF_S = 30
MAX_CHECK_ERRORS = 20


class OrcaError(RuntimeError):
    pass


def orca_json(*args: str, timeout: float) -> dict:
    r = subprocess.run([ORCA, *args, "--json"], capture_output=True, text=True, timeout=timeout)
    out = json.loads(r.stdout)
    if not out.get("ok", True) or "result" not in out:
        err = out.get("error") or {}
        raise OrcaError(f"{err.get('code')}: {(err.get('message') or r.stderr)[:300]}")
    return out


def fleet_liveness(run: str, dispatch: str) -> str:
    try:
        rows = orca_json("orchestration", "worker-list", "--run", run, timeout=120)["result"]["workers"]
    except Exception as e:  # noqa: BLE001 - liveness is advisory; keep waiting
        return f"err:{type(e).__name__}"
    row = next((w for w in rows if w.get("dispatchId") == dispatch), None)
    return row["projection"]["liveness"]["verdict"] if row else "missing"


def park_state(dispatch: str) -> dict | None:
    try:
        return json.loads((PARK_DIR / f"{dispatch}.json").read_text())
    except (OSError, ValueError):
        return None


def pid_alive(pid: int | None) -> bool:
    if not pid:
        return False
    try:
        os.kill(pid, 0)
    except ProcessLookupError:
        return False
    except PermissionError:
        return True
    return True


def from_dispatch(msg: dict, dispatch: str) -> bool:
    try:
        return json.loads(msg.get("payload") or "{}").get("dispatchId") == dispatch
    except ValueError:
        return False


def check_dispatch(run, d, last_seen, silence_s, note, i, n, kinds) -> int:
    """Return an exit code when dispatch `d` needs the coordinator, else 0."""
    live = fleet_liveness(run, d)
    park = park_state(d)
    phase = park.get("phase") if park else None
    note(f"iter={i} count={n} kinds={','.join(kinds) or 'none'} dispatch={d} liveness={live} park={phase}")
    if live == "exited":
        print(f"{d}: worker exited")
        return 10
    if phase == "wake_failed":
        print(f"{d}: park wake failed: {park.get('error')}")
        return 11
    if phase in ("starting", "parked", "job_exited"):
        if not pid_alive(park.get("sidecar_pid")):
            print(f"{d}: park sidecar {park.get('sidecar_pid')} died in phase {phase}")
            return 12
        return 0  # silence is expected while parked
    ref = max(last_seen, (park or {}).get("wake_sent_at") or 0)
    if time.time() - ref > silence_s:
        print(f"{d}: silence for {int(time.time() - ref)} s (park={phase})")
        return 13
    return 0


def main() -> int:
    ap = argparse.ArgumentParser()
    ap.add_argument("--run", required=True)
    ap.add_argument("--dispatch", required=True, action="append")
    ap.add_argument("--out", required=True, help="file that receives the actionable delivery")
    ap.add_argument("--max-iter", type=int, default=48)
    ap.add_argument("--wait-ms", type=int, default=600_000)
    ap.add_argument("--silence-s", type=int, default=3600)
    a = ap.parse_args()
    out = Path(a.out)
    log = out.with_name(out.name + ".log").open("a")
    msgs = out.with_name(out.name + ".msgs").open("a")

    def note(line: str) -> None:
        ts = datetime.now(ZoneInfo("Asia/Tokyo")).strftime("%F %T")
        log.write(f"{ts} {line}\n")
        log.flush()

    start = time.time()
    last_seen = dict.fromkeys(a.dispatch, start)  # last message per watched dispatch
    ack: list[str] = []
    i = errors = 0
    while i < a.max_iter:
        try:
            res = orca_json(
                "orchestration",
                "check",
                "--run",
                a.run,
                *ack,
                "--wait",
                "--types",
                ALL_TYPES,
                "--timeout-ms",
                str(a.wait_ms),
                timeout=a.wait_ms / 1000 + 120,
            )["result"]
        except Exception as e:  # noqa: BLE001 - a failed check is a checkpoint, not a wake
            # A failing check returns at once (e.g. while another waiter holds the Run):
            # back off instead of spinning, keep the pending ack, and do not count it.
            errors += 1
            note(f"iter={i} check error #{errors} {type(e).__name__}: {e}")
            if errors >= MAX_CHECK_ERRORS:
                print(f"check failed {errors} times in a row: {e}")
                return 5
            time.sleep(CHECK_ERROR_BACKOFF_S)
            continue
        errors = 0
        i += 1
        ack = []
        batch = res.get("messages", [])
        kinds = sorted({m.get("type", "?") for m in batch})
        for d in a.dispatch:
            if any(from_dispatch(m, d) for m in batch):
                last_seen[d] = time.time()
        if batch and set(kinds) <= QUIET_TYPES:
            for m in batch:
                body = (m.get("body") or "").replace("\n", " ")
                msgs.write(f"{m.get('created_at')} {m.get('type')} {m.get('subject')} | {body}\n")
            msgs.flush()
            if res.get("deliveryId"):
                ack = ["--ack", res["deliveryId"]]
        elif batch:
            out.write_text(json.dumps(res, ensure_ascii=False, indent=1))
            note(f"iter={i} delivery kinds={','.join(kinds)}")
            print(f"delivery {','.join(kinds)} -> {out}")
            return 0

        for d in a.dispatch:
            code = check_dispatch(a.run, d, last_seen[d], a.silence_s, note, i, len(batch), kinds)
            if code:
                return code
    print("max_iter")
    return 4


if __name__ == "__main__":
    sys.exit(main())
requests_table.py(全リクエストの表を作成する。以下の集計の入力)
"""Build one row per Codex model request from every rollout under ~/.codex/sessions.

Usage: uv run --no-project python requests_table.py OUT.jsonl

A request = one deduplicated token_count event with usage. Fields that matter:
- idle_s: previous request's end -> this request's start. Start is the timestamp of
  the last input item (tool output, user message) before this request's first output
  item, so the model's own generation time is excluded.
- prefix_hit: cached_input_tokens / previous request's input_tokens. Unlike
  cached/input it is not lowered by a large new tool output.
- compaction: a `compacted` item before this request or before the next one (the
  compaction request itself).
"""

import glob, json, os, sys
from datetime import datetime

OUT_TYPES = {"reasoning", "function_call", "custom_tool_call"}
IN_TYPES = {"function_call_output", "custom_tool_call_output"}


def classify_call(p):
    """poll / heartbeat / work, by the call's name and arguments."""
    name, a = str(p.get("name")), str(p.get("arguments") or p.get("input") or "")
    if name in ("wait", "sleep") or (name == "write_stdin" and '"chars":""' in a.replace(" ", "")):
        return "poll"
    if "--type heartbeat" in a:
        return "heartbeat"
    return "work"


def ts(s):
    return datetime.fromisoformat(s.replace("Z", "+00:00")).timestamp()


def rows_of(path):
    rows, seen, prev, ev = [], None, None, []
    model = effort = None
    first = json.loads(open(path).readline())
    meta = first.get("payload", {})
    guardian = "guardian" in json.dumps(meta.get("source"))
    orca = "You are working inside Orca" in open(path).read(400_000)
    for line in open(path):
        try:
            d = json.loads(line)
        except ValueError:
            continue
        p = d.get("payload") or {}
        t = d.get("type")
        pt = p.get("type") if isinstance(p, dict) else None
        if t == "turn_context":
            model, effort = p.get("model"), p.get("effort") or p.get("reasoning_effort")
        if pt == "token_count" and p.get("info"):
            u = p["info"]["last_token_usage"]
            k = (u["input_tokens"], u["cached_input_tokens"], u["output_tokens"])
            if k == seen:
                continue
            seen = k
            t_end = ts(d["timestamp"])
            start, saw_out = None, False
            for e_t, kind in ev:
                if kind == "out":
                    saw_out = True
                elif not saw_out and kind == "in":
                    start = e_t
            kinds = {k_ for _, k_ in ev}
            rl = (p.get("rate_limits") or {}).get("primary") or {}
            r = {
                "file": os.path.basename(path),
                "session": meta.get("id"),
                "guardian": guardian,
                "parent": meta.get("parent_thread_id") or meta.get("forked_from_id"),
                "cli": meta.get("cli_version"),
                "model": model,
                "effort": effort,
                "t_end": t_end,
                "t_start": start or (prev["t_end"] if prev else t_end),
                "input": u["input_tokens"],
                "cached": u["cached_input_tokens"],
                "output": u["output_tokens"],
                "reasoning": u.get("reasoning_output_tokens", 0),
                "used_pct": rl.get("used_percent"),
                "resets_at": rl.get("resets_at"),
                "turn_first": "task_started" in kinds,
                "trigger": next((x[5:] for _, x in ev if x.startswith("user:")), None),
                "tools": [x[5:] for _, x in ev if x.startswith("tool:")],
                "compaction_before": "compacted" in kinds,
                "compaction_next": False,
                "world_state": "world_state" in kinds,
                "additional_tools": "additional_tools" in kinds,
                "session_meta": "session_meta" in kinds,
                "orca_worker": orca,
            }
            if prev:
                r["idle_s"] = max(0.0, r["t_start"] - prev["t_end"])
                r["prev_input"] = prev["input"]
                r["prefix_hit"] = u["cached_input_tokens"] / prev["input"] if prev["input"] else None
                r["model_changed"] = prev["model"] != model or prev["effort"] != effort
            rows.append(r)
            prev, ev = r, []
            continue
        if not d.get("timestamp"):
            continue
        e = ts(d["timestamp"])
        if t == "compacted":
            if rows:
                rows[-1]["compaction_next"] = True
            ev.append((e, "compacted"))
        elif t in ("world_state", "session_meta"):
            ev.append((e, t))
        elif pt == "task_started":
            ev.append((e, "task_started"))
        elif t == "response_item":
            if pt in OUT_TYPES:
                ev.append((e, "out"))
                if pt != "reasoning":
                    ev.append((e, "tool:" + classify_call(p)))
            elif pt in IN_TYPES:
                ev.append((e, "in"))
            elif pt == "additional_tools":
                ev.append((e, "additional_tools"))
            elif pt == "message":
                if p.get("role") == "assistant":
                    ev.append((e, "out"))
                else:
                    ev.append((e, "in"))
                    if p.get("role") == "user":
                        txt = "".join(c.get("text", "") for c in p.get("content", []) if isinstance(c, dict))
                        if not txt.lstrip().startswith(
                            ("<environment_context", "# AGENTS.md", "<skills_instructions", "<permissions")
                        ):
                            ev.append((e, "user:" + txt.strip()[:80]))
    return rows


def main():
    files = glob.glob(os.path.expanduser("~/.codex/sessions/**/rollout-*.jsonl"), recursive=True)
    n = 0
    with open(sys.argv[1], "w") as f:
        for p in sorted(files):
            for r in rows_of(p):
                f.write(json.dumps(r) + "\n")
                n += 1
    print(len(files), "files", n, "requests")


if __name__ == "__main__":
    main()
session_breakdown.py(1セッションのリクエストを契機ごとに分類する)
"""Attribute one session to what woke each request, under three cost assumptions.

Usage: uv run --no-project python session_breakdown.py REQUESTS.jsonl SESSION_ID
"""

import json, sys
from collections import defaultdict

rows = [json.loads(l) for l in open(sys.argv[1])]
s = sorted((r for r in rows if r["session"] == sys.argv[2]), key=lambda r: r["t_end"])
costs = {
    "regression (0.156/0.88/8.23 %/Mtok)": lambda r: (
        0.156 * r["cached"] + 0.88 * (r["input"] - r["cached"]) + 8.23 * r["output"]
    ),
    "fixed ratio (0.1/1/6)": lambda r: 0.1 * r["cached"] + (r["input"] - r["cached"]) + 6 * r["output"],
    "fixed ratio (0.1/1/10)": lambda r: 0.1 * r["cached"] + (r["input"] - r["cached"]) + 10 * r["output"],
}


def woke(r, prev):
    if r["turn_first"]:
        return "user/dispatch"
    c = prev["tools"] if prev else []
    if "poll" in c:
        return "poll"
    if "heartbeat" in c:
        return "heartbeat"
    return "work"


print(
    "requests",
    len(s),
    "input",
    sum(r["input"] for r in s),
    "cached",
    sum(r["cached"] for r in s),
    "output",
    sum(r["output"] for r in s),
    "reasoning",
    sum(r["reasoning"] for r in s),
    "turns",
    sum(r["turn_first"] for r in s),
)
for name, f in costs.items():
    A, n = defaultdict(float), defaultdict(int)
    prev = None
    for r in s:
        k = woke(r, prev)
        A[k] += f(r)
        n[k] += 1
        prev = r
    T = sum(A.values())
    print(
        name,
        {k: f"{100 * v / T:.1f}% ({n[k]})" for k, v in sorted(A.items(), key=lambda kv: -kv[1])},
        f"waiting={100 * (A['poll'] + A['heartbeat']) / T:.1f}%",
    )
usage_regression.py(週間枠の使用率の回帰、信頼区間、週をまたいだ予測)
"""How well do token counts explain the Codex weekly used_percent, and how stable is it?

Usage: uv run --no-project --with numpy python usage_regression.py REQUESTS.jsonl T0 T1
T0, T1: reference window in UTC, "YYYY-MM-DD HH:MM".

Hourly increments of used_percent (all sessions pooled, account-wide) are regressed on
cached / uncached / output tokens (millions) of gpt-6-astra main sessions. Hours with a
weekly reset or with non-astra traffic above 2 % of tokens are dropped from the fit.
CI: hour-block bootstrap, plus +-0.5 % rounding jitter on the integer used_percent.
Out of sample: coefficients from the reference window predict every other weekly window.
"""

import json, sys
from collections import defaultdict
from datetime import datetime, timezone, timedelta
import numpy as np

J = timezone(timedelta(hours=9))
rows = sorted((json.loads(l) for l in open(sys.argv[1])), key=lambda r: r["t_end"])
rows = [r for r in rows if r["used_pct"] is not None]
# weekly windows: a new window starts when used_pct falls by more than 2 points
win, w = [], 0
last = None
for r in rows:
    if last is not None and r["used_pct"] < last - 2:
        w += 1
    r["win"] = w
    last = r["used_pct"]


def vec(r):
    return np.array([r["cached"], r["input"] - r["cached"], r["output"]], float) / 1e6


H = defaultdict(lambda: {"astra": np.zeros(3), "other": np.zeros(3), "guard": 0.0, "last": None, "win": None})
for r in rows:
    h = H[(r["win"], int(r["t_end"] // 3600))]
    if r["guardian"]:
        h["guard"] += r["input"] / 1e6
    elif r["model"] == "gpt-6-astra":
        h["astra"] += vec(r)
    else:
        h["other"] += vec(r)
    h["last"] = r["used_pct"]
    h["win"] = r["win"]
keys = sorted(H)
pts = []
for a, b in zip(keys, keys[1:]):
    if a[0] != b[0]:
        continue
    pts.append(
        {"k": b, "d": H[b]["last"] - H[a]["last"], **{x: H[b][x] for x in ("astra", "other", "guard", "win")}}
    )


def fit(P):
    X = np.array([p["astra"] for p in P])
    y = np.array([p["d"] for p in P], float)
    co = np.linalg.lstsq(X, y, rcond=None)[0]
    pr = X @ co
    return co, 1 - ((y - pr) ** 2).sum() / ((y - y.mean()) ** 2).sum(), X, y


t0 = datetime.strptime(sys.argv[2], "%Y-%m-%d %H:%M").replace(tzinfo=timezone.utc).timestamp()
t1 = datetime.strptime(sys.argv[3], "%Y-%m-%d %H:%M").replace(tzinfo=timezone.utc).timestamp()
ref = [p for p in pts if t0 <= p["k"][1] * 3600 <= t1]
co, r2, X, y = fit(ref)
print(
    f"reference window: n={len(ref)} hours  coef %/Mtok cached={co[0]:.3f} uncached={co[1]:.2f} output={co[2]:.2f}  R2={r2:.3f}"
)
rng = np.random.default_rng(0)
B = []
for _ in range(5000):
    idx = rng.integers(0, len(y), len(y))
    yy = y[idx] + rng.uniform(-0.5, 0.5, len(y)) - rng.uniform(-0.5, 0.5, len(y))
    B.append(np.linalg.lstsq(X[idx], yy, rcond=None)[0])
B = np.array(B)
lo, hi = np.percentile(B, [2.5, 97.5], axis=0)
print(
    "95% CI  cached",
    lo[0].round(3),
    hi[0].round(3),
    " uncached",
    lo[1].round(2),
    hi[1].round(2),
    " output",
    lo[2].round(2),
    hi[2].round(2),
)
tot = X.sum(0)
sh = B * tot
sh = sh / sh.sum(1, keepdims=True)
print(
    "share of consumption, cached: median %.0f%%, 95%% CI %.0f-%.0f%%; output: %.0f%% (%.0f-%.0f%%); uncached: %.0f%% (%.0f-%.0f%%)"
    % (
        100 * np.median(sh[:, 0]),
        *(100 * np.percentile(sh[:, 0], [2.5, 97.5])),
        100 * np.median(sh[:, 2]),
        *(100 * np.percentile(sh[:, 2], [2.5, 97.5])),
        100 * np.median(sh[:, 1]),
        *(100 * np.percentile(sh[:, 1], [2.5, 97.5])),
    )
)
print(
    "cached/uncached price ratio: median %.2f, CI %.2f-%.2f"
    % (np.median(B[:, 0] / B[:, 1]), *np.percentile(B[:, 0] / B[:, 1], [2.5, 97.5]))
)
for rr in (6, 8, 10):
    z = X[:, 0] * 0.1 + X[:, 1] + X[:, 2] * rr
    k = (z @ y) / (z @ z)
    p = z * k
    print(
        f"fixed ratio cached 0.1 / output {rr}: k={k:.3f} %/Munit R2={1 - ((y - p) ** 2).sum() / ((y - y.mean()) ** 2).sum():.3f} cached share={tot[0] * 0.1 / (tot[0] * 0.1 + tot[1] + tot[2] * rr):.0%}"
    )
print("\nweekly windows: actual increase vs prediction with the reference coefficients (astra only)")
print("win first_hour(JST)   hours actual pred  pred/act  astra_Mcached other_Mtok guard_Min")
for w in sorted({p["win"] for p in pts}):
    P = [p for p in pts if p["win"] == w]
    act = sum(p["d"] for p in P)
    A = sum((p["astra"] for p in P), np.zeros(3))
    O = sum((p["other"] for p in P), np.zeros(3))
    G = sum(p["guard"] for p in P)
    pred = float(A @ co)
    first = datetime.fromtimestamp(P[0]["k"][1] * 3600, J).strftime("%m-%d %H")
    print(
        f"{w:3d} {first:>12} {len(P):8d} {act:6.0f} {pred:6.1f} {pred / act if act else float('nan'):7.2f} {A[0]:12.1f} {O.sum():9.1f} {G:9.1f}"
    )
pure = [p for p in pts if p["other"].sum() < 0.02 * max(p["astra"].sum(), 1e-9) and p["astra"].sum() > 0]
co2, r22, X2, y2 = fit(pure)
print(
    f"\nall astra-only hours pooled: n={len(pure)} coef cached={co2[0]:.3f} uncached={co2[1]:.2f} output={co2[2]:.2f} R2={r22:.3f}"
)
for w in sorted({p["win"] for p in pure}):
    P = [p for p in pure if p["win"] == w]
    if len(P) >= 8:
        c, r, *_ = fit(P)
        print(
            f"  win {w}: n={len(P)} cached={c[0]:.3f} uncached={c[1]:.2f} output={c[2]:.2f} R2={r:.3f} actual_sum={sum(p['d'] for p in P):.0f}"
        )
before_after.py(導入前後の比較と、他の待ち方との比較)
"""Compare Codex main sessions before / after the parking protocol.

Usage: uv run --no-project python before_after.py REQUESTS.jsonl "YYYY-MM-DD HH:MM" [EXCLUDED_SESSION]
The date is the introduction time in JST.
A request is attributed to what woke it: the previous request's tool calls, or the
user prompt that opened the turn. Cost unit: credits-like "units" with published ratios
cached 0.1 / uncached 1 / output 6 (Codex rate card as reported for GPT-5.x; the
gpt-6-astra card is unconfirmed), used only to compare within the same ratio.
"""

import json, re, sys
from collections import defaultdict
from datetime import datetime, timezone, timedelta

J = timezone(timedelta(hours=9))
CUT = datetime.strptime(sys.argv[2], "%Y-%m-%d %H:%M").replace(tzinfo=J).timestamp()
rows = [json.loads(l) for l in open(sys.argv[1])]
EXCLUDED = sys.argv[3] if len(sys.argv) > 3 else None  # e.g. a controlled test: in neither period
all_models = [r for r in rows if not r["guardian"] and r["session"] != EXCLUDED]
print(
    "post-cut main requests by model:",
    {
        m: sum(1 for r in all_models if r["model"] == m and r["t_end"] >= CUT)
        for m in {r["model"] for r in all_models}
    },
)
rows = [r for r in all_models if r["model"] == "gpt-6-astra"]
by = defaultdict(list)
for r in rows:
    by[r["session"]].append(r)


def unit(r):
    return 0.1 * r["cached"] + (r["input"] - r["cached"]) + 6 * r["output"]


def woke(r, prev):
    t = r["trigger"] or ""
    if t.startswith("[orca-park keepalive"):
        return "keepalive"
    if t.startswith("[orca-park done"):
        return "park done"
    if r["turn_first"]:
        return "user/dispatch"
    c = prev["tools"] if prev else []
    if "poll" in c:
        return "poll"
    if "heartbeat" in c:
        return "heartbeat"
    return "work"


def report(sel, title):
    A = defaultdict(lambda: [0, 0.0, 0, 0])
    wall = 0.0
    sess = 0
    for s, rs in by.items():
        rs.sort(key=lambda r: r["t_end"])
        if not sel(rs):
            continue
        sess += 1
        turn_gap = sum(
            min(r["t_end"] - p["t_end"], 600) for p, r in zip(rs, rs[1:])
        )  # active wall time; idle gaps capped at 10 min
        wall += turn_gap
        prev = None
        for r in rs:
            a = A[woke(r, prev)]
            a[0] += 1
            a[1] += unit(r)
            a[2] += r["cached"]
            a[3] += r["input"]
            prev = r
    T = sum(a[1] for a in A.values())
    N = sum(a[0] for a in A.values())
    CT = sum(a[2] for a in A.values())
    print(
        f"\n{title}: sessions={sess} requests={N} cached={CT / 1e6:.0f}M units={T / 1e6:.1f}M mean_ctx={sum(a[3] for a in A.values()) / max(N, 1) / 1e3:.0f}k"
    )
    for k, a in sorted(A.items(), key=lambda kv: -kv[1][1]):
        print(f"  {k:14s} req={a[0]:6d} ({100 * a[0] / N:4.1f}%) units={100 * a[1] / T:5.1f}%")
    w = sum(A[k][1] for k in ("poll", "heartbeat", "keepalive", "park done"))
    print(
        f"  => waiting-related share of units: {100 * w / T:.1f}%; requests/active hour {N / (wall / 3600):.1f}"
    )


report(lambda rs: rs[0]["orca_worker"] and rs[-1]["t_end"] < CUT, "BEFORE, Orca workers")
report(lambda rs: rs[0]["orca_worker"] and rs[0]["t_end"] >= CUT, "AFTER, Orca workers")
report(lambda rs: not rs[0]["orca_worker"] and rs[-1]["t_end"] < CUT, "BEFORE, non-Orca sessions")

# Counterfactual on the actual parks: same job durations and contexts, other waiting policies
post = [r for r in rows if r["t_end"] >= CUT]
pre_poll = []
for s, rs in by.items():
    prev = None
    for r in rs:
        if prev and r["t_end"] < CUT and woke(r, prev) == "poll" and r["cached"] / max(r["input"], 1) > 0.9:
            pre_poll.append(r)
        prev = r
pu = sum(r["input"] - r["cached"] for r in pre_poll) / len(pre_poll)
po = sum(r["output"] for r in pre_poll) / len(pre_poll)
print(f"\nmeasured per-poll cost before: n={len(pre_poll)} mean uncached={pu:.0f} mean output={po:.0f}")
dur = re.compile(r"after (\d+)h(\d+)m")
tot_h = actual = cf60 = cf5 = 0.0
n_park = 0
ka_units = 0.0
ka_n = 0
ctxs = []
for r in post:
    t = r["trigger"] or ""
    if t.startswith("[orca-park keepalive"):
        actual += unit(r)
        ka_units += unit(r)
        ka_n += 1
    elif t.startswith("[orca-park done"):
        m = dur.search(t)
        if not m:
            continue
        mins = int(m[1]) * 60 + int(m[2])
        tot_h += mins / 60
        n_park += 1
        ctxs.append(r["prev_input"])
        actual += unit(r)
        per = 0.1 * r["prev_input"] + pu + 6 * po
        cf60 += mins * per
        cf5 += (mins / 5) * per
print(
    f"parks={n_park} job_hours={tot_h:.1f} median_ctx={sorted(ctxs)[len(ctxs) // 2] / 1e3:.0f}k keepalives={ka_n}"
)
print(
    f"actual waiting cost (keepalive + done requests) = {actual / 1e6:.2f}M units (keepalive part {ka_units / 1e6:.2f}M)"
)
print(
    f"if polled every 1 min = {cf60 / 1e6:.1f}M units ({cf60 / actual:.0f}x); every 5 min = {cf5 / 1e6:.1f}M units ({cf5 / actual:.0f}x)"
)
allpost = sum(unit(r) for r in post)
print(
    f"all post-cut astra main units = {allpost / 1e6:.1f}M; waiting cost share {100 * actual / allpost:.1f}%"
)
cache_gap.py(空白時間とキャッシュミス)
"""Prefix-cache survival vs idle time, separating visible causes of a miss.

Usage: uv run --no-project python cache_gap.py REQUESTS.jsonl
miss = prefix_hit < 0.8. "Excluded" rows have a visible reason for losing the prefix.
"""

import json, sys
from collections import Counter

rows = [json.loads(l) for l in open(sys.argv[1])]
rows = [r for r in rows if "idle_s" in r and r["prev_input"] >= 15000]


def reason(r):
    if r["compaction_before"] or r["compaction_next"]:
        return "compaction"
    if r["model_changed"]:
        return "model/effort change"
    if r["input"] < 0.95 * r["prev_input"]:
        return "history shrank"
    return None


BINS = [0, 1, 5, 10, 20, 30, 60, 120, 1e9]


def label(a, b):
    return f"{a}-{b}m" if b < 1e9 else f">{a}m"


def table(rs, title):
    print(f"\n{title}\n{'idle':>9} {'n':>6} {'miss':>5} {'miss%':>6} {'median':>7}")
    for a, b in zip(BINS, BINS[1:]):
        s = [r for r in rs if a * 60 <= r["idle_s"] < b * 60]
        if not s:
            continue
        h = sorted(r["prefix_hit"] for r in s)
        m = sum(x < 0.8 for x in h)
        print(f"{label(a, b):>9} {len(s):6d} {m:5d} {100 * m / len(s):5.1f}% {h[len(h) // 2]:7.3f}")


for name, sel in (("main", False), ("guardian", True)):
    rs = [r for r in rows if r["guardian"] == sel]
    print(
        f"\n===== {name}: {len(rs)} requests; misses by visible cause (idle<30m):",
        Counter(reason(r) for r in rs if r["prefix_hit"] < 0.8 and r["idle_s"] < 1800),
    )
    clean = [r for r in rs if reason(r) is None]
    table(clean, "clean, all requests")
    table([r for r in clean if r["turn_first"]], "clean, first request of a user turn")
    table([r for r in clean if not r["turn_first"]], "clean, inside a turn")
robustness.py(週ごとのコストあたりの週間枠の消費量、最長ジョブの影響、keepalive の損益)
"""Robustness checks for the before/after figures.

Usage: uv run --no-project python robustness.py REQUESTS.jsonl "YYYY-MM-DD HH:MM" [EXCLUDED_SESSION]
1. %-per-unit by weekly window (fixed ratios cached 0.1 / uncached 1 / output 6).
2. Counterfactual concentration: is one long job carrying the result?
3. Keepalive policy: what the production keepalives cost vs. the cache misses they could prevent.
"""

import json, re, sys
from collections import defaultdict
from datetime import datetime, timezone, timedelta

J = timezone(timedelta(hours=9))
CUT = datetime.strptime(sys.argv[2], "%Y-%m-%d %H:%M").replace(tzinfo=J).timestamp()
EXCLUDED = sys.argv[3] if len(sys.argv) > 3 else None
rows = sorted((json.loads(l) for l in open(sys.argv[1])), key=lambda r: r["t_end"])
unit = lambda r: 0.1 * r["cached"] + (r["input"] - r["cached"]) + 6 * r["output"]

print("1) percent per million units, by weekly window (main sessions; guardians excluded)")
w, last, W = (
    0,
    None,
    defaultdict(
        lambda: {"u": 0.0, "min": None, "max": None, "t0": None, "t1": None, "models": defaultdict(float)}
    ),
)
for r in rows:
    if r["used_pct"] is None:
        continue
    if last is not None and r["used_pct"] < last - 2:
        w += 1
    last = r["used_pct"]
    x = W[w]
    x["t0"] = x["t0"] or r["t_end"]
    x["t1"] = r["t_end"]
    x["min"] = r["used_pct"] if x["min"] is None else min(x["min"], r["used_pct"])
    x["max"] = r["used_pct"] if x["max"] is None else max(x["max"], r["used_pct"])
    if not r["guardian"]:
        x["u"] += unit(r)
        x["models"][r["model"]] += unit(r)
for k, x in W.items():
    d = x["max"] - x["min"]
    top = max(x["models"], key=x["models"].get) if x["models"] else "-"
    print(
        f"  win {k:2d} {datetime.fromtimestamp(x['t0'], J):%m-%d %H}~{datetime.fromtimestamp(x['t1'], J):%m-%d %H} used {x['min']:.0f}->{x['max']:.0f} units={x['u'] / 1e6:7.1f}M pct/Munit={d / (x['u'] / 1e6) if x['u'] else 0:5.2f} top={top} ({100 * x['models'][top] / x['u'] if x['u'] else 0:.0f}%)"
    )

print("\n2) counterfactual by park")
post = [
    r
    for r in rows
    if not r["guardian"] and r["t_end"] >= CUT and r["session"] != EXCLUDED and r["model"] == "gpt-6-astra"
]
dur = re.compile(r"after (\d+)h(\d+)m")
P = []
for r in post:
    t = r["trigger"] or ""
    m = dur.search(t) if t.startswith("[orca-park done") else None
    if m:
        P.append((int(m[1]) * 60 + int(m[2]), r["prev_input"], r))
PER = lambda c: 0.1 * c + 802 + 6 * 239  # measured mean uncached 802, output 239 per poll before the cut
actual = sum(unit(r) for r in post if (r["trigger"] or "").startswith("[orca-park"))
ds = sorted(p[0] for p in P)
print(
    f"  parks={len(P)} minutes: median={ds[len(ds) // 2]} p90={ds[int(len(ds) * 0.9)]} max={ds[-1]} sum={sum(ds) / 60:.1f}h"
)
for label, S in (("all", P), ("without longest", sorted(P, key=lambda p: p[0])[:-1])):
    c60 = sum(m * PER(c) for m, c, _ in S)
    c5 = sum(m / 5 * PER(c) for m, c, _ in S)
    print(
        f"  {label}: 1-min polling={c60 / 1e6:.1f}M ({c60 / actual:.0f}x) 5-min={c5 / 1e6:.1f}M ({c5 / actual:.1f}x) vs actual={actual / 1e6:.2f}M"
    )

print("\n3) keepalive policy")
ka = [r for r in post if (r["trigger"] or "").startswith("[orca-park keepalive")]
ka_cost = sum(unit(r) for r in ka)
need = [(m, c) for m, c, _ in P if m >= 30]
extra = sum(0.9 * c for _, c in need)
print(f"  keepalive cost={ka_cost / 1e6:.2f}M units for {len(ka)} wakes; parks >=30 min: {len(need)}")
print(
    f"  no keepalive, every such wake misses: extra={extra / 1e6:.2f}M units -> keepalive {'pays' if ka_cost < extra else 'loses'} (ratio {extra / ka_cost:.2f})"
)
for pm in (0.5, 0.1):
    print(
        f"  no keepalive, miss rate {pm:.0%}: extra={pm * extra / 1e6:.2f}M -> ratio {pm * extra / ka_cost:.2f}"
    )
done = [r for _, _, r in P]
long_d = [r for r in done if r["idle_s"] >= 1800]
print(
    f"  'done' after >=30 min real idle (keepalives exhausted): n={len(long_d)} hit>=0.8: {sum(r['prefix_hit'] >= 0.8 for r in long_d)}; lost tokens={sum(r['prev_input'] - r['cached'] for r in long_d if r['prefix_hit'] < 0.8) / 1e6:.2f}M"
)