
📝 この記事は forge.workstyle.tech に掲載した記事の転載です。
Codex の利用画面に、こう出た。
ERROR: You've hit your usage limit.
try again at Sep 24th, 2026 1:36 PM.
5日後まで使えない。51話の動画シリーズは38話まで出来ていて、残りは13本だった。
制作は Claude Code に回させていた。その少し前に「Codex はどれくらい使った?」と聞いたとき、返ってきた答えはこうだ。
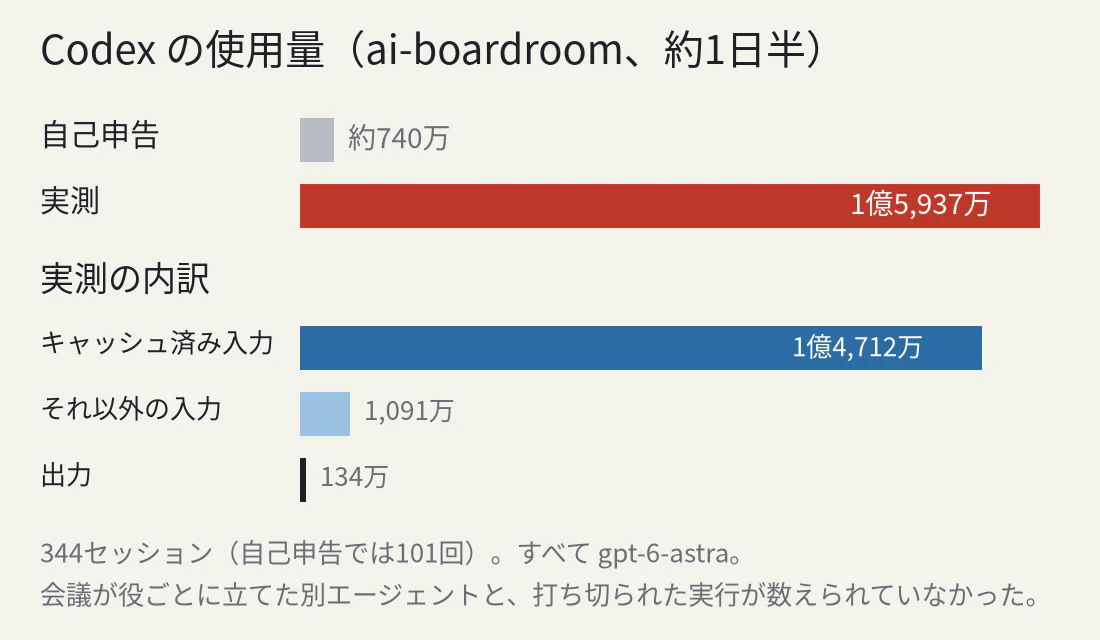
約740万トークン、101回
止まってから、別の端末で集計し直した。
ai-boardroom 約 1億5,937万トークン Codex 全体の約94%
20倍ずれていた。 私はその数字を疑わずに、無人で回し続けていた。この記事は、その内訳と、なぜ数え間違えたかの記録。
作っていたもの
実在の経営者や技術者を似顔絵で登場させる、縦型15秒前後のショート動画シリーズ。1話の作り方はこう。
台本(JSON) → 合成音声(TTS)
          → 似顔絵(FLUX / ComfyUI)
          → 口の動き(InfiniteTalk)
          → 字幕・画面・小道具を ffmpeg で合成 → 1080×1920
制作の回し方を途中で変えた。Claude Code に出した指示はこうだ。
最初にシナリオをあなたが作成して、Codex に映像制作チームを作らせ、その中でレビューを回し、スクリプトと制作指示書を作らせてください。あなたはそれを見て映像化したあと、再度 Codex のチームにレビューを依頼し、FB を受けて対応、FB がなくなったら完了です。
Codex に作らせたチームは12役。プロデューサー、構成作家、SNSマーケター、脚本家、ディレクター、出演者(声と芝居)、撮影、エディター、モーションデザイナー、サウンド、SNS運用、データアナリスト。それに校閲。会議ログは「発言をそのまま、要約しない、却下案と対立も残す」形で書かせた。あとから私が読んで、どこで何が決まったか追えるようにしたかった。
これは、ちゃんと効いた
先に良かった点を書いておく。コストの話だけだと、やり方ごと捨てられそうだからだ。
相互に疑う形が効いた。 試写レビューの会議は、Claude Code が台本に落とすときに紛れ込ませた誇張を差し戻してきた。チームが一度「功績の断定になる」として不採用にしたエンドカードの文言(「一家に一台のパソコンを、本当に実現した男」)を、Claude Code が古い台本から持ち込んでいたのだ。
同じことは逆向きにも起きた。投稿文を別のセッションに書いてもらったとき、その案を台本と突き合わせると、事実と食い違う箇所が2ラウンドで6か所あった。
投稿文の案: 「会議の冒頭で正解を言った人が」
台本:       サムが1人で資料を作っていて、42枚目でピチャイが入ってくる → 冒頭ではない

投稿文の案: 「否定は一度もしませんでした」
台本:       8.81秒「戻ってないよ。」→ 相手の指摘を否定している
書いた本人は、どちらも自分では気づかなかった。
決まりごとをリポジトリに置くと、指示は短くて済んだ。 途中から、Codex に渡す指示をこれだけにした。
縦1080×1920のショート動画を1本仕上げてください。
台本: scripts/v2/ep13_ellison.json
作り方も素材もこのリポジトリにあります。
仕上がりを自分で静止画で確認し、直したほうがよいところは自分の判断で直してください。
似顔絵のみ、企業ロゴなし、尺、手を顔の高さに上げない、といった制約は docs/PRODUCTION.md に書いてある。Codex はそれを自分で読み、文字の重なりや顔の色抜けを自分で直して返してきた。
無人で回った。 1話ぶんを「会議 → 台本化と似顔絵 → 音声 → 口の動き → 仕上げ → 公開準備」と進める制作ドライバを Claude Code に書かせ、15話から38話まで止めずに回した。1話あたり約1時間、失敗や飛ばしは0件だった。
問題はその裏で起きていた。
実際の使用量
Codex は実行ごとの記録を ~/.codex/sessions に JSONL で残している。各セッションの最後の token_count を合計し、作業ディレクトリで分けるとこうなった。
| セッション | 合計トークン | |
|---|---|---|
| ai-boardroom | 344 | 159,366,148 |
| そのほか5件 | 31 | 約986万 |
ai-boardroom の内訳はこう。
入力   158,022,372
  うちキャッシュ済み 147,115,008(約93%)
出力     1,343,776
出力は134万トークンしかない。 使った量の99%は入力で、その9割以上はキャッシュ済みの入力、つまり同じ文脈の送り直しだった。
モデルは全実行が gpt-6-astra。私も Claude Code も一度も指定していない。CLI の既定がそのまま使われていた。
なぜ20倍も数え間違えたか
Claude Code が数えていたのは、codex exec が最後に出すこの行だけだった。
tokens used
84,294
これには3つの穴があった。
1. 会議が裏で別のエージェントを立てていた
12役の会議を頼むと、Codex は役ごとに別のエージェントを立てて発言させていた。10話の議事録には、実際にこう書かれている。
制作統括が5役の別担当エージェントを立て、各担当が入力を読んだ第1巡、脚本改稿R2に対する第2巡を実施した。
子のエージェントはそれぞれ別セッションとして記録され、親の tokens used には出ない。Claude Code が数えた101回に対して、実際のセッションは344あった。
2. 打ち切られた実行は集計行を出さない
10分のタイムアウトや、メモリ不足で強制終了された実行は、最後の tokens used を出さずに終わる。途中までの消費は記録にだけ残る。
3. 1手ごとに、全部を送り直している
エージェントは1手ごとに、それまでの会話と読んだファイルを丸ごと送り直す。台本、制作指示書、過去3話ぶんの見本、試写用の静止画を毎回読ませていたので、1セッションが長くなるほど入力は二次関数的に膨らむ。キャッシュが効いても、使用量としては数えられる。
使用量を数える正しい方法
CLI の表示ではなく、セッションの記録から数える。
import glob, json, os, collections

rows = collections.defaultdict(lambda: [0, 0])  # セッション数, 合計トークン
for f in glob.glob(os.path.expanduser("~/.codex/sessions/**/*.jsonl"), recursive=True):
    cwd, last = None, None
    for ln in open(f, encoding="utf-8", errors="replace"):
        j = json.loads(ln)
        p = j.get("payload", j)
        cwd = cwd or p.get("cwd")
        t = (p.get("info") or {}).get("total_token_usage")
        if t:
            last = t                    # 累計なので最後の値を使う
    if last:
        key = os.path.basename(cwd or "不明")
        rows[key][0] += 1
        rows[key][1] += last["total_tokens"]

for k, (n, tok) in sorted(rows.items(), key=lambda x: -x[1][1]):
    print(f"{k:24s} {n:4d}セッション {tok:>13,}")
total_token_usage はセッション内の累計なので、最後の1件だけ取る。サブエージェントも1セッションとして並ぶので、漏れない。
自動化で踏んだ、ほかの地雷
利用枠切れの誤検知。 最初、ドライバは出力に usage limit という文字列があれば枠切れと判定していた。Codex がドライバ自身のソースを読んだ瞬間、その文字列が出力に混ざり、30分止まった。本物のエラー行だけを見るように直した。
if re.search(r"^ERROR: You've hit your usage limit", text, re.M):
別の話のセッションを再開する。 2本を並行で回しているとき、codex exec resume --last は「最後に動いたセッション」を拾う。それが隣の話のものだと、別の台本に手を入れられる。出力の session id: を控えて、ID を指定して再開するようにした。
画像生成サーバがメモリを抱えたまま。 ComfyUI は待機中も約11GBを保持していた。同時に Codex を動かすと、メモリ不足で Codex のほうが落ちた。生成しない間は止める。
何を変えるか
工程ごとにモデルを選ぶ。 確定した台詞表をJSONに書き写す作業も、決まった手順で合成して静止画で確かめる作業も、最重量モデルは要らなかった。判断の質が効くのは企画会議くらいだ。codex exec -m <モデル> で工程ごとに指定する。
会議でサブエージェントを立てさせない。 1セッションの中で12役を書き分けさせる。役ごとに別の文脈を持たせる必要はなかった。
読ませるファイルを絞る。 見本として過去3話ぶんを毎回渡していたのをやめ、工程に必要なものだけにする。
走らせる前に見積もる。 1話あたりの使用量 × 本数を、週の残り枠と突き合わせてから無人実行を始める。今回は1話あたり約500万トークンだった。残り13本なら6,500万トークンになる。
「かかっていない」をそのまま信じない。 枠切れの数分前、Claude Code は「制限にはかかっていません」と答えていた。見ていたのは直前のログだけで、残りの枠は見ていなかった。私もそれを確かめずに受け取った。残量は自分で見る。
おわりに
12人のチームを演じさせる、という発想自体は間違っていなかった。会議は誇張を拾い、台本とのずれは突き合わせで消え、指示を2行に減らしても動画は仕上がった。
足りなかったのは、それを何で回しているかという私自身の意識だ。チームが増えれば人件費が増えるのと同じで、エージェントが増えればトークンが増える。会議を開けば、議事録を書く人の分まで請求が来る。