


開発現場におけるAI活用の限界──なぜ「トークン量」や「コスト」を追っても意味がないのか
みなさんこんにちは。株式会社ハイヤールー代表の葛岡 宏祐です。本日は「『AI協働力』の可視化〜開発組織の新しい物差し〜」というテーマで、これからのAIネイティブな開発組織づくりに必要な視点についてお伝えします。
私はDeNAでAIエンジニアとして研究開発に携わった後、メルカリへ移り画像検索プロジェクトやMLOps開発のテックリードを担当してきました。2020年にハイヤールーを創業し、エンジニア評価サービス等を通じてこれまで320社・116万件以上の評価実績を積み重ねています。
その中で今、最も強く感じていること。それは開発現場において「AIを使っている」ということ自体では、もはや組織の差にならなくなってきたということです。
DevOpsの世界的調査として知られるDORAの2025年調査を見ると、エンジニアのAI利用率はすでに「9割」に達しています。しかし、生産性への効果について最も多かった回答は「わずかに向上」(41%)にとどまっています。エンジニアの9割がAIを使っている以上、他社と圧倒的な差を生むのは「使っているか(量)」ではなく「どのように使っているか(質)」です。
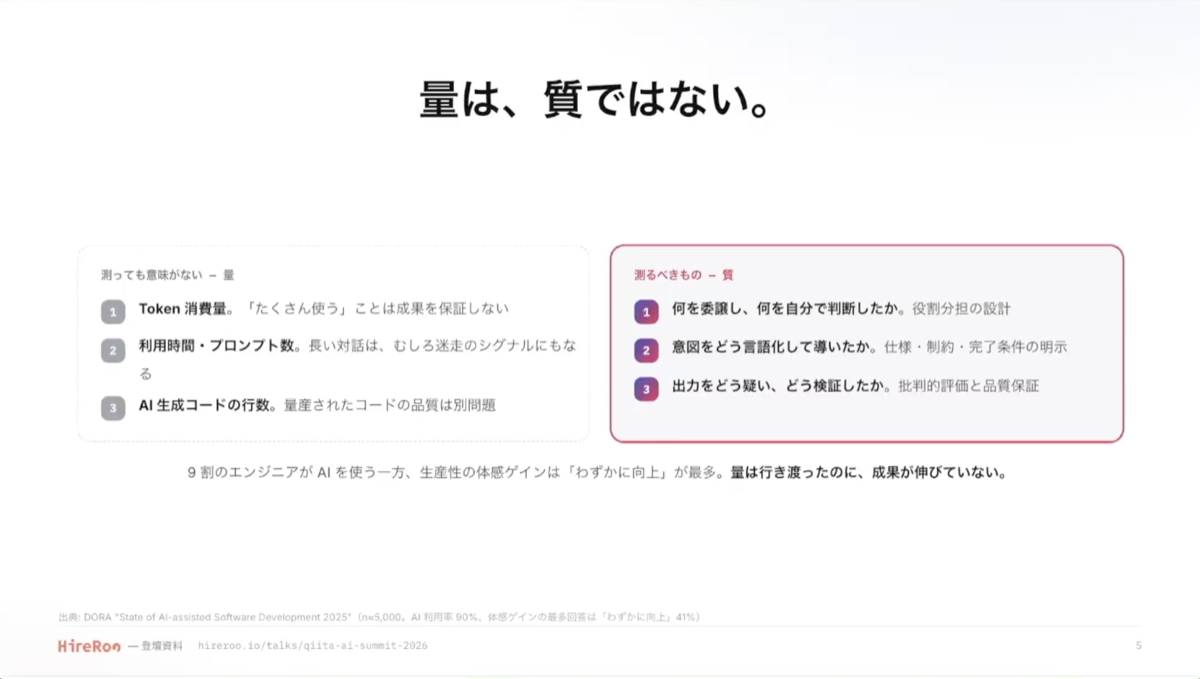
「どれくらいAIを使っているか」を把握するために、APIのトークン消費量や月額コストをダッシュボードでモニタリングしている組織も多いでしょう。ですが、トークン消費量やコストといった「量」の指標だけを追うことには、ほとんど意味がありません。
不必要なコンテキストを大量に読み込ませたり、プロンプトの出し方が悪く裏で無駄なループ処理を延々と回していたりしても、トークン消費量は青天井で上がっていきます。つまり「量」の指標だけを追うのは「効果測定を一切せずにテレビCMを打ち続けている」のと同じ状態なのです。
「今月はこれだけトークンを使いました」という報告では、経営陣に対して「それで、どんな開発成果が出たのか?」という問いに答えられません。「使っている量」を測るフェーズは終わりました。これからの開発組織に必要なのは、ブラックボックス化しがちなAI活用の「質」を測定し、改善につなげる新しい物差しです。
海外ビッグテックも注目「AI活用の質」を定義する指標
では、私たちが追うべき「AI活用の質」とはどのように定義すれば良いのでしょうか。海外のAIベンダーや先進的なビッグテック企業では、すでに「量」から「質」へと評価の軸足を明確にシフトさせています。
1つ目は、モデル「Claude」を提供するAnthropic社が提唱する「AI Fluency (4D)」です。

- Delegation(委譲):「何をAIに任せ、何を人間が行うべきか」の切り分け力。
- Description(記述):目的・コンテキスト・制約条件を言語化し、期待通りの出力を引き出す力。
- Discernment(識別):生成されたコードの妥当性を見抜き、単に鵜呑みにせず新たな推論を引き出す能力。
- Diligence(誠実):AIの利用と、その結果に責任を持つこと。
2つ目は、Metaの中途採用等で使われるCoderPad社の4万件の選考データ分析から導き出された「5大指標」です。

- AIの戦略的活用(Strategic Use)
- 問題のフレーミング(Problem Framing)
- 説明とアーキテクチャ(Explanation & Architecture)
- 批判的評価と修正(Critical Evaluation & Revision)
- 問題解決(Problem Solving)
CoderPadが「最も重要である」とハイライトしているのが、4つ目の「批判的評価と修正」です。AIの出力を鵜呑みにせず、その提案に対して疑いの目を向け、ロジックの破綻やエッジケースの考慮漏れを指摘して正しく修正できるかが問われています。
両者の共通解は、「AIを自分自身の推論を拡大するための『増幅器(Amplifier)』として使えているか」という点にあります。AIを「単なる作業代行ツール」として使うか、自らの思考や推論を何倍にも引き伸ばす「増幅器」として使いこなすかで、開発成果に決定的な差が生まれるのです。
日本の開発組織に向けた新たな指標「AI協働力」──116万件のデータから見えた日本のエンジニアの伸びしろ
海外の抽象的な指標を日本の開発現場に落とし込むため、私たちが定義したのが「AI協働力」です。
エンジニアにペーパーテストを受けてもらう必要はありません。Claude CodeやCodexなどのCLIやAIエージェントを日常業務で使う「行動ログ」を自動収集・解析します。海外の汎用指標の解像度を極限まで高め、エンジニアの行動パターンを「460項目」にまで細分化・定義しました。行動ログから測定するため、スコアの裏返しがそのまま直ちに取り組むべき現場の改善策になります。
「AI協働力」を構成する5つの重要スキル

当社が持つ累計320社・116万件以上の評価データを分析した結果、AI協働力は以下の「5つの領域」に集約されることが分かりました。
- 共同推論(Collaborative Reasoning):AIの提案を批判的に評価し、対話を通じてより良い代替案や新しい推論を引き出す力。
- 環境構築(Harnessing):プロンプトやリポジトリ、MCPなどを通じて「AIエージェントにとって働きやすい環境」を整える力。
- 実行の統制(Execution Control):脱線しそうなAIを正しく軌道修正し、目的の出力へ収束させる力。
- 意図の仕様化(Intent Specification):目的や制約をプロンプトとして明確に仕様化する力。
- 出力の品質保証(Output Quality Assurance):出力をそのまま横流しせず、責任を持ってレビュー・検証する力。
116万件のデータ分析で私たちが最も衝撃を受けたのは、AI活用の本質である「共同推論」のスコア平均が「43.7%」と、他の領域に比べて突出して低かったことです。日本のエンジニアが最も苦手とするこの領域こそが、日本の開発組織における最大の伸びしろ(他社と差がつくポイント)なのです。
【事例1】同じトークン量でも請求額が倍違う!「キャッシュヒット率9%」の罠と78%コスト削減の裏側
ここからは、開発ログの可視化から見えた3つのリアルな現場改善事例をお話しします。
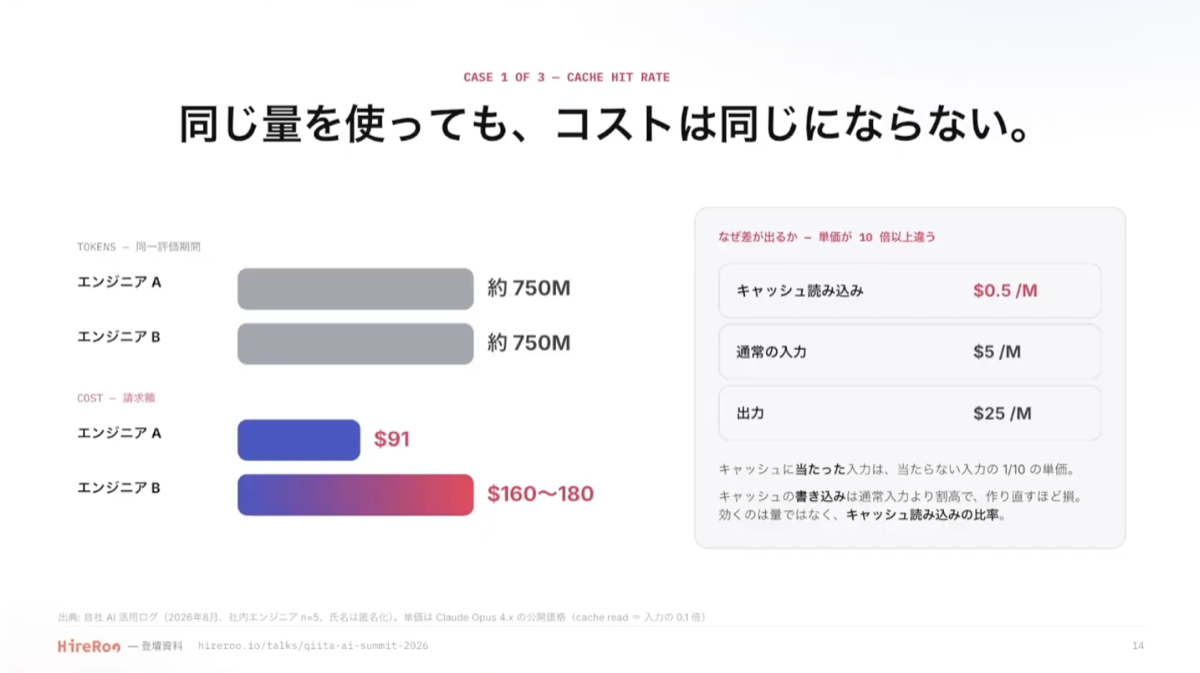
あるクライアント企業で、ほぼ同じ期間に同じモデル(Claude)を使い、全く同じ「750Mトークン」を消費して同等の仕事量をこなした2人のエンジニアがいました。しかし、月末の請求額を確認すると、片方が「91ドル」なのに対し、もう片方は「160〜180ドル」と倍近い差が開いていました。

別のエンジニアCさんのデータを詳しく見ると、300Mトークン消費(9人中下から3番目の消費量)にもかかわらず、コストは最安クラスではなく980ドルに達していました。一方、別のエンジニアDさんは2,725Mトークン(Cさんの9倍のトークン)を使っていますが、請求額は861ドルと、Cさんより安かったのです。
同じモデルで同じ量なのに、なぜこれほど金額が違うのか? 原因は「プロンプトのキャッシュヒット率」にありました。
LLMのAPI仕様として、入力がキャッシュにヒットすれば1Mトークン単価は「0.5ドル」ですが、非ヒット時は10倍の「5ドル」になります。Cさんのキャッシュヒット率を調べると、組織平均(84%)に対しわずか「9%」にとどまっていました。入力の9割以上で毎回キャッシュが効かず、10倍の高額単価で叩き続けていたのです。
では、Cさんのキャッシュヒット率はなぜそれほど低かったのか。Cさんは期間内に「312セッション」(組織平均44セッションの約7倍)ものセッションを不必要に細かく切りまくっていました。セッション間でコンテキストが共有されないため、AIエージェントに情報が蓄積する前にセッションが破棄されてしまいます。その結果、新しいセッションでイチから巨大なプロンプトを再送し続けていたのです。

そこで、「無駄なセッション切りを禁止し、1つのメインセッションでプルリク作成からリリースまで走り切ること。並列で進める場合は、まずメインセッションでMarkdown形式の実行計画(Plan)を作成し、それを複数エージェントで参照しながら開発する」という改善を指導しました。
その結果、こなした仕事量やトークン消費量は全く同じままで、キャッシュヒット率は9%→86%へ上昇、セッション数は312→38へ適正化し、請求コストは980ドルから214ドルへと「78%のコスト削減」を達成しました。ツールの構造的特性をログから可視化し、正しいプロセスを導くことの威力を実感した事例です。

【事例2】待ち時間の無駄をなくす「並列セッション」の活用

2つ目は、「量」の指標だけをモニタリングしていても絶対に異常を検知できない事例です。
エンジニアGさんのトークン消費量や月額コスト(約600ドル)、セッション数(40セッション/組織平均44)は平均同等で、量だけを見れば問題のない優良な利用状況に見えました。しかし、ダッシュボード上の「最大並列セッション数」と「平均並列セッション数」を確認すると、いずれも「1」を示していたのです。
つまりGさんは、1つのセッションでAIに指示を出した後、AIがコードを出力している間、画面の前でじっと待つだけで他の作業やセッションを動かしていませんでした。
高額なエンジニアの人件費の上に単にAIの利用コストが重なっているだけの状態であり、非常にもったいない時間の使い方です。AIを使いこなすエンジニアは、AIの出力待ち中に別タスクを進めるか、複数エージェントを並列実行させます。熟練者になると、大きな設計・開発指示を夜寝る前にポチッと押し、翌朝10本の並列セッション成果を一気に確認・レビューするような使い倒し方をしています。

そこでGさんに対し、タスクの全体像をMarkdownのプランとしてまとめ、複数エージェントに並列で渡す「Markdownプランニング」をハンズオンで指導しました。
その結果、月額コスト(604ドル→618ドル)やトークン消費量は以前と変わりませんが、最大並列セッション数は1→8、平均並列セッション数は1.0→3.6へと急上昇しました。コストを増やさずにAIの出力待ちという無駄時間をゼロにし、同一時間内での開発スピードとアウトプット量を爆増させることができたのです。

【事例3】エースエンジニアのスコアがA→Cランクへ急降下!? 個人のスキルではなく「環境要因」が引き起こすボトルネック

3つ目は、エンジニア個人の使い方ではなく「組織側の環境」に起因するボトルネックの事例です。
我々の指標でAI協働力が「Aランク」と非常に高かったエンジニアFさんが、ある日別のプロジェクトに異動した途端、総合スコアがCランクまで落ち込んでしまいました。特に、5つの重要スキルのうち「環境構築能力」のスコアだけが18点(異動前は70点以上)と異様に低くなっていたのです。個人のスキルが明日突然下がるなんてことはあり得ませんから、「何かおかしい」と詳細を分析しました。
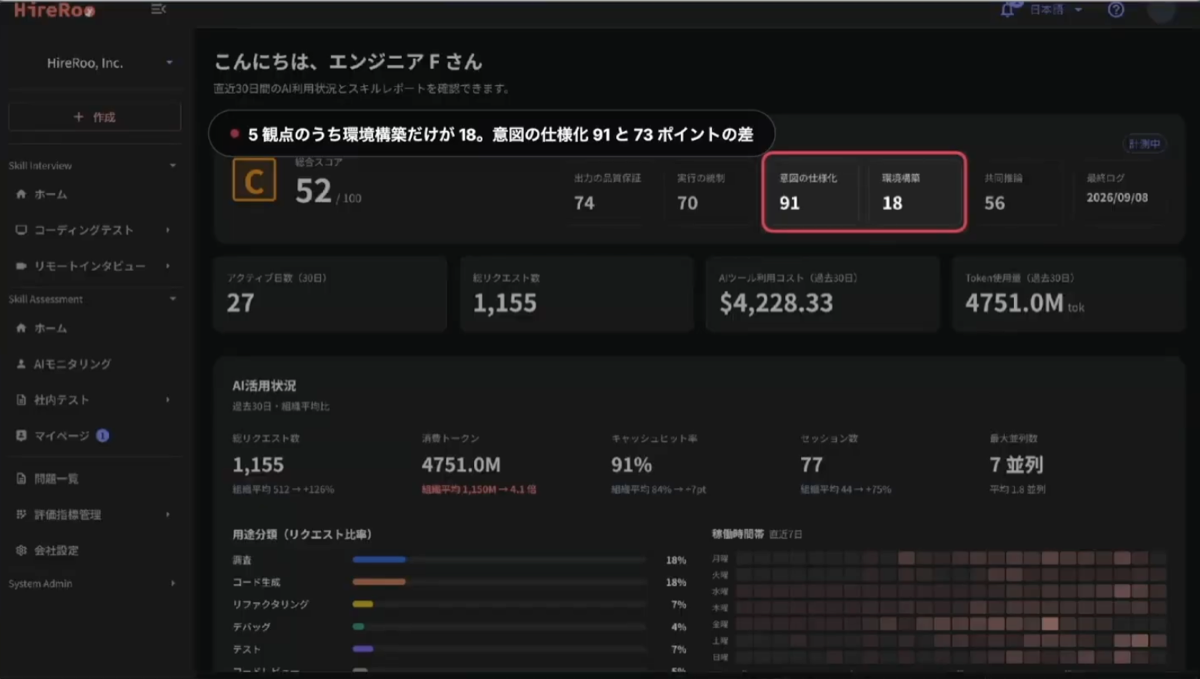
プロジェクトのログを確認すると、形式知としてのMarkdown(Skills)の利用が「1回」しかない一方で、MCP経由でのPostgres読み取り接続が「4,120回」も実行されていました。
要するに、異動先のプロジェクトでは社内Wikiやリポジトリなどの「形式知」が全く整備されていなかったのです。そのため、AIに「お客さんの課題を分析して」と漠然と投げた結果、AIエージェントは「そもそもユーザーの声はどのデータベースのどのテーブルにあるんだ?」という探索から始めなければならず、何度もSQLのクエリ発行に失敗しながら迷子になっていたわけです。
データベースのスキーマやテーブル構造は、毎日コロコロ変わるものではありません。そこで我々は、よく使う集計やテーブルの参照手順を「BQ(BigQuery)のスキル」として1つ定義し、組織全体で共有できるように整備しました。
結果として、無駄なクエリ探索がなくなり、このエンジニアの環境構築スコアは18点から79点にV字回復、AI協働力も再びAランクに戻りました。個人のスキル指導だけでなく「AIが働きやすい環境を整える」組織側のアプローチが不可欠であることを証明する事例です。

AIネイティブ組織への変革──個人と組織の「両輪」を可視化する「スキルアセスメント」
3つのケーススタディを振り返ると、大きな学びがあります。
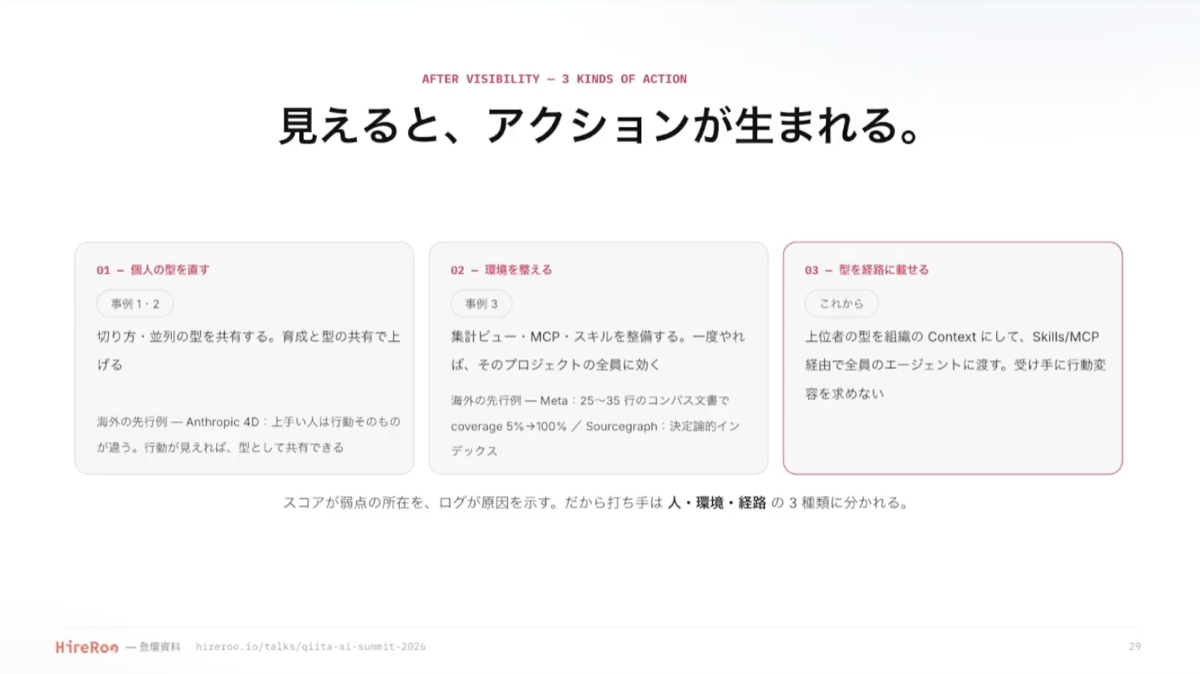
事例1と事例2のように「個人の使い方」に起因する非効率は、正しい使い方を共有しハンズオンで介入することで改善できます。しかし、事例3のように「環境や組織」に起因する課題は、組織全体で形式知を整備しなければ、どれだけ優秀な人を連れてきてもボトルネックは解消しません。
トークンの使用量やコストといった「量」を可視化しても、全く意味がない時代になってきました。これからの開発組織に必要なのは、エンジニア一人ひとりがどのようにAIと協働し、どこにつまづいているのかという「質」の可視化です。
人と環境、それぞれの課題を切り分けて可視化し、適切なアクションを取り続けること。それこそが、AIを真の増幅器として使いこなす「AIネイティブな組織」への最短距離だと私は確信しています。
当社では、普段の開発環境からCLIコマンド一発でログを収集し、トークン量・コスト・キャッシュヒット率・「AI協働力」5大指標をリアルタイム可視化する「スキルアセスメント」を提供しています。特別なテストは不要で、現場のボトルネックをその日のうちに特定できます。
「使っている量」を報告するフェーズは終わりました。「我が社のエンジニアはAIをどう使いこなし、どのような生産的価値を生み出しているか」を定量的に説明できる新しい物差しを持ち、真のAIネイティブ組織へと向かいましょう。詳細な解析ロジックをまとめたホワイトペーパーも無料公開中ですので、ぜひご活用ください。
