
はじめに
AI にコードを書かせることが多くなってきた昨今、加速する開発スピードに対して「どのように品質を保証するか」という戦略が重要になってきたように日々感じています。
1つのアプローチとして、「E2E テスト」を用いたテストを厚めにするという手段があると思いますが、E2E テストは保守の事を考えずに構築すると一気に形骸化の一途を辿ります。
この記事では E2E テストをできるだけ形骸化させないための仕組みを考えることに焦点を置き、導入する際にどういったことに気をつけると保守性を落とさずに運用へ乗せやすくなるのか、参考として1つのワークフローを提案できればと思います。
実装には Playwright を前提としますが、考え方自体は他の E2E テストフレームワークにも置き換えられるものです。
※ 本記事は全てのテスト工程を E2E で置き換える事を推奨するものではなく、人が手動で行なっている結合工程などを E2E でカバーするなどのユースケースを想定しています
ボトルネック
最初にボトルネックについて整理します。
今回、主に整理した問題点は以下のとおりです。
1. なぜ E2E テストは形骸化するのか
テストが増えるほど、何を・何故確認しているのかわからなくなりがちです。
加えて、どの観点が網羅されているか、UI を変更したときにどのテストに影響するかといった見取りも、コードからは失われていきます。
これらの対策としてどういった手段があるかについて触れます。
2. どんな仕組みなら導入・運用を続けられるのか
仕組みが重いほど形骸化が加速するため、既存の開発フローにどこまで薄く乗せられるかを軸に、既存のテストフローからどのように移行するかについて触れます。
3. AI が書いたテストを、誰が・どう確認するのか
生成コストが下がったぶん、人の確認のコストが相対的にボトルネックになるため、どのように確認コストを減らすかや、非エンジニアでもわかる形式でアウトプットするかについて触れます。
考えるべきこと
AI 時代の開発においてネックとなるのは、AI の生成物を人がチェックする必要があることです。
すでに一般化されてきた話ではありますが、弊社でも AI の生成物には何かしらの視覚情報をセットで出力し、確認しやすくすることを意識しています。
E2E テストにおいてこの「視覚情報」に相当するのが、テスト観点マトリクス (○×表) と整理します。
AI に「テストを書かせる」だけでなく「人に見せるものをセットで書かせる」こと、これが今回提案するワークフローの重要な要素です。
もう1つ意識したのは、手で更新する資産を「正」にしないことです。
テストの意図をコメントで残す、テスト一覧をスプレッドシートで管理する、といった手法は更新が人の手によるため、いずれ実装との乖離が始まります。
乖離した資産は信頼されず、信頼されない資産は更新されなくなる。形骸化の正体はこのループだと考えています。
そのため本ワークフローでは、人が確認する資産はすべて生成物として都度出し直します。入力が変われば出力も変わるため、乖離の起点を断てます。結果として、テストコードが常に正である状態を保てます。
解決の方向性
ワークフローの提案の前に、問題点ごとに「何をすれば解決できるか」を整理しておきます。
1. マトリクス表をテストコードから生成する(問題点1 & 3)
Playwright のタグやアノテーションを使用してそれらの情報を npx playwright test --list --reporter=json で出力、出力した情報を入力としてマトリクス表を生成します。
こうすることで、テストコードのコメントに現れる確認観点などがケースの情報として集約され、常にケースが正となる表が生成されます。
以下は実装例です。
export const viewpoints = {
  requiredError: "必須項目を空で送信するとエラーが表示される",
  focusOrder: "入力後のフォーカス移動が自然な順序で行われる",
  responsiveLayout: "モバイル幅でもレイアウトが崩れない",
} as const;

export type Viewpoint = keyof typeof viewpoints;

export const viewpoint = (...names: Viewpoint[]) => ({
  annotation: names.map((name) => ({ type: "viewpoint", description: viewpoints[name] })),
});
spec ではこのヘルパーをアノテーションとして呼び出し、ケース ID はタグで付与します。引数が Viewpoint 型のため、エディタの補完から観点を選べ、定義に存在しない観点はコンパイルエラーになります。
test.fixme("お名前を空のまま送信すると必須エラーが表示される", {
  tag: "@input-01",
  ...viewpoint("requiredError", "focusOrder"),
}, async ({ page }) => {});

test.fixme("フリガナを空のまま送信すると必須エラーが表示される", {
  tag: "@input-02",
  ...viewpoint("requiredError", "focusOrder"),
}, async ({ page }) => {});

test.fixme("メールアドレスに不正な形式を入力するとエラーが表示される", {
  tag: "@input-05",
  ...viewpoint("requiredError"),
}, async ({ page }) => {});

test.fixme("電話番号は 0 から始まる 10〜11 桁のときだけ受理される", {
  tag: "@input-06",
}, async ({ page }) => {});

test.fixme("モバイル幅で入力画面を表示してもレイアウトが崩れない", {
  tag: "@common-02",
  ...viewpoint("responsiveLayout"),
}, async ({ page }) => {});
fixme としておくことで、この外郭で生成されたマトリクスを先にレビューすることなどが可能です。
アノテーションを付けたテストは、テストを実行せずに一覧化できます。
npx playwright test --list --reporter=json
以下のようなマトリクスが生成されるようなイメージです。
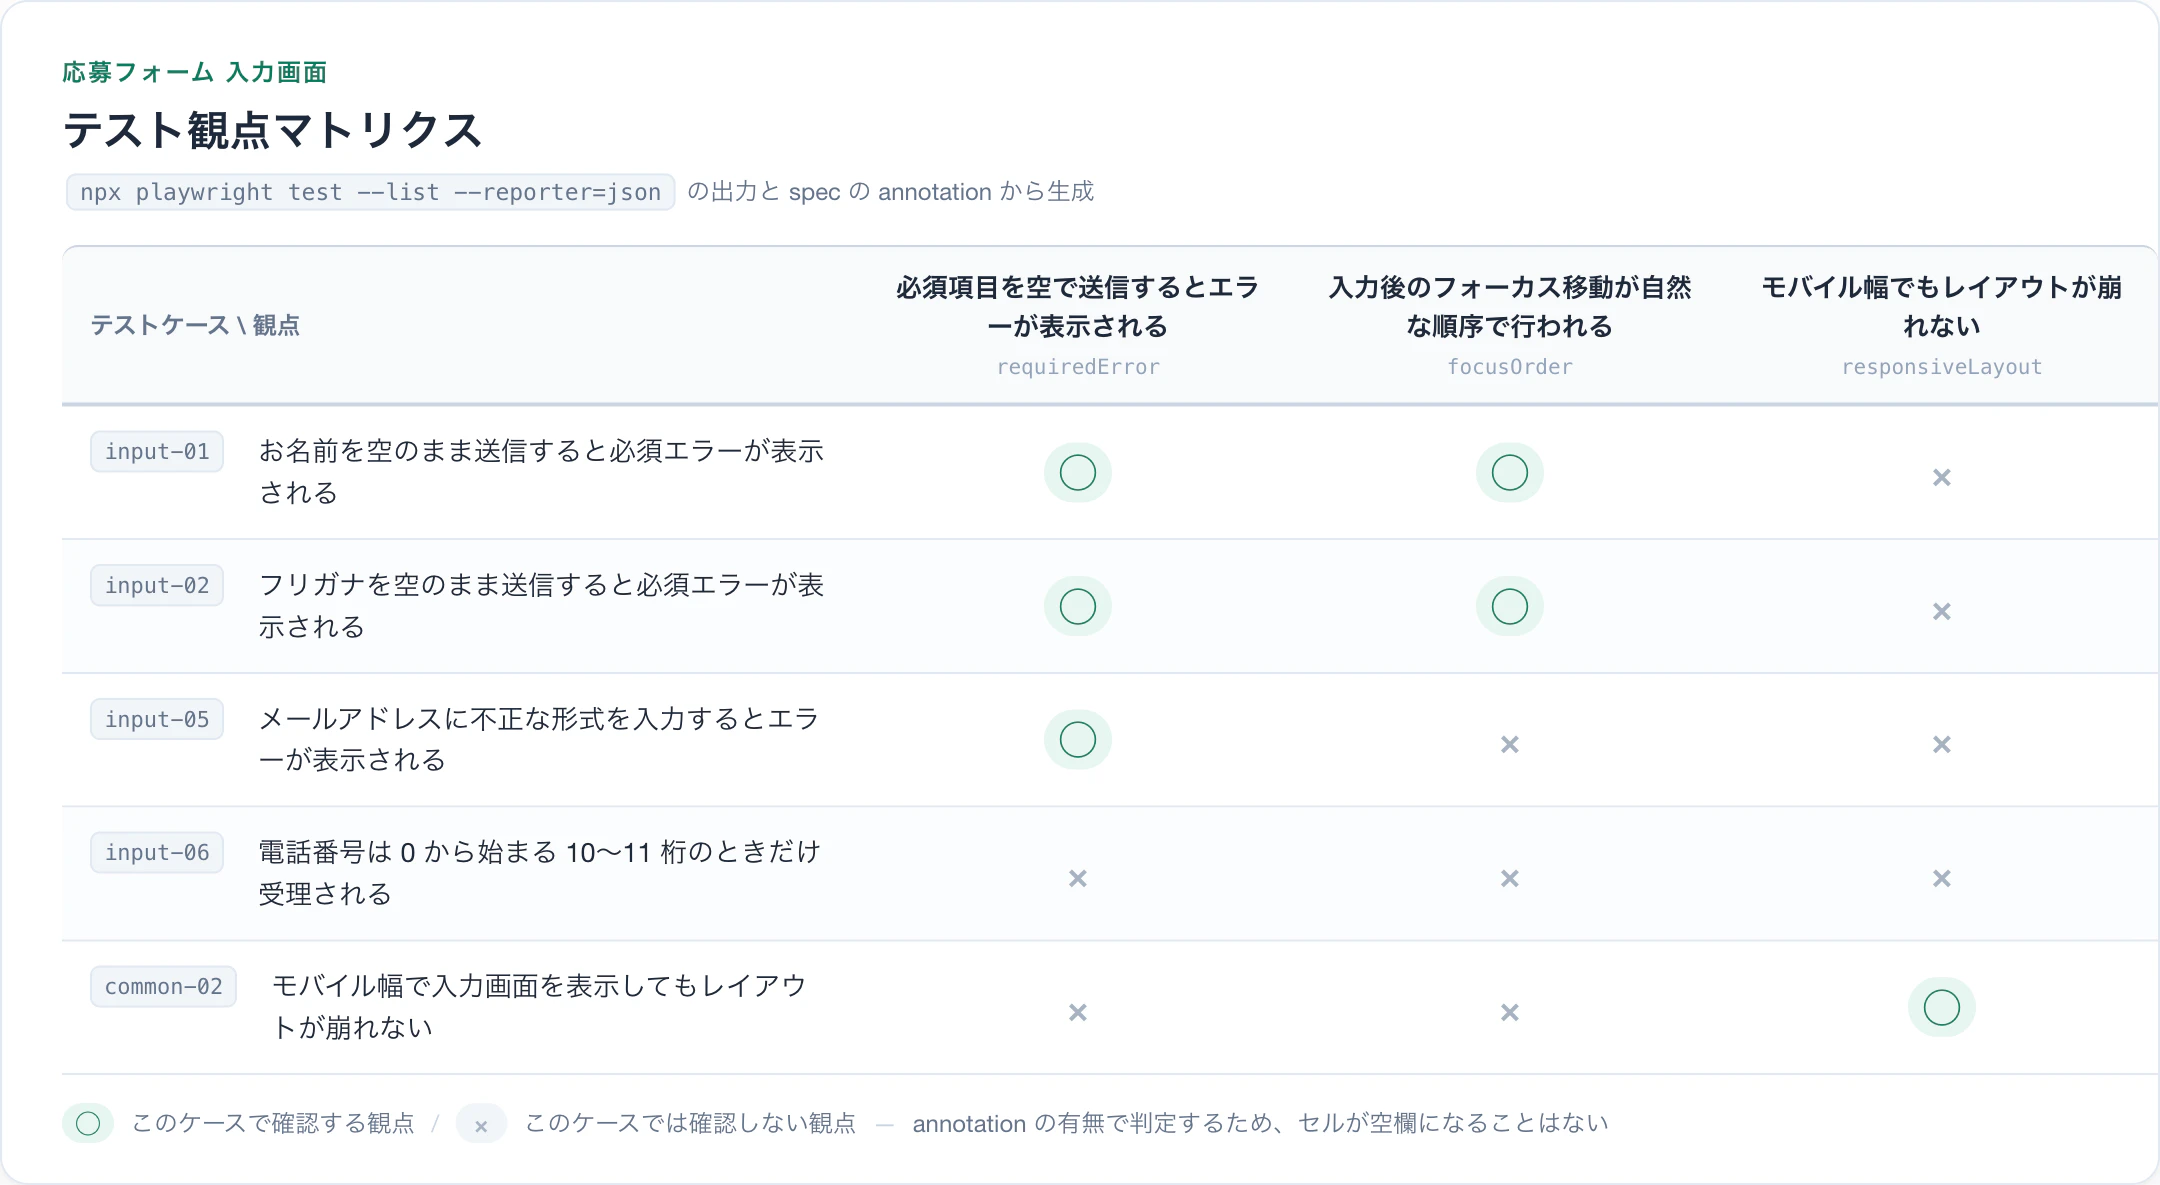
※ 同時にケースのスナップショットとして json や md を生成するのも有用だったため、差分検証として必要であれば導入してみてください
2. ケース内にロケーターを登場させない(問題点2)
E2E の管理が重くなる最大の理由として、ロケーターなどの指定が点在することで仕様変更に追従できなくなることがあると思います。
こういったことを避けるために PageObject などを利用し、ロケーターは PageObject に閉じ込めるなどの戦略が必要です。
3. 既存のテスト管理がどのようにされているのかを把握し移行する(問題点2)
既存のテスト項目がどのように管理されているのかを把握し、スプレッドシートならスプレッドシートで過去の観点などを上記で触れた内容で fixme として実装、出力されたマトリクスが既存のテスト項目を満たしているかなどをチェックするのが第一歩です。
そもそもない場合には、次の項で提案するワークフローを参考にしてみてください。
提案するワークフロー
この方向性を、次の6ステップの流れで実現します。
- (AI)対象画面をブラウザで実際に操作・実コードを取得しマトリクスを生成する
- (人間)レビューする
- (AI)生成したマトリクスを元に、
fixmeで外郭を作成する - (人間)
fixmeからスクリプトで生成されたマトリクスと、1 で生成したマトリクスに差がないかレビューする - (AI)ケースに沿って Playwright のテストを実装する
- (人間)実行しエビデンスを確認する

手を動かす作業はすべて AI が担い、人が介在するのは2・4・6で生成物を前にして判断を下す場面です。判断は次の3点に絞ります。
-
生成物のレビュー:
- 観点の抜け、判定の誤り、説明の曖昧さを指摘する
-
曖昧な挙動の仕様確定:
- 既存で項目がない場合にはより重要で、観測で分かるのは「こう動く」までで、「こう動くのが正しい」は人間が判断する
-
変更時の分岐判断:
- その変更が仕様変更か、不具合かを見極める
1. ブラウザで実際に操作して、観点マトリクスを作る(ステップ1・2)
AI が対象画面をブラウザで実際に操作・あわせて実装コードも取得し、観測だけでは見えない分岐や状態を補いながら観点を洗い出して○×表にします。
一番意識しているのは「表に空欄を作らない」ことです。
確認が必要な観点は○、条件が揃ったときにだけ必要な観点は△、対象外と判断した観点は×を付け、「考えていない」セルを無くすことで、考慮漏れと「対象外と判断した結果」を区別します。
あわせて、実際のエラー文言や遷移先といった観測メモを表とセットで残し、判断の根拠にします。
こうすることで、「何が網羅されていて何が抜けているのか」の指標となり、人が眺めて指摘するのが最初の介入ポイントです。
外部サービスへの送信など副作用を伴う操作の前には、実行してよいか人に確認を取るルールにするのも良いでしょう。
2. マトリクスから fixme の外郭を作り、差分で確かめる(ステップ3・4)
AI がマトリクスの○と△を、確認手順と期待結果を持ったテストケースに変換します。
△や「要確認」の観測は挙動が仕様通りであるかを人が確定させ○へ変換します。曖昧な観測を残さず、マトリクスを唯一の情報源に保つのがポイントです。
ケースは中身が空のまま test.fixme の外郭として作成・マトリクスを生成します。
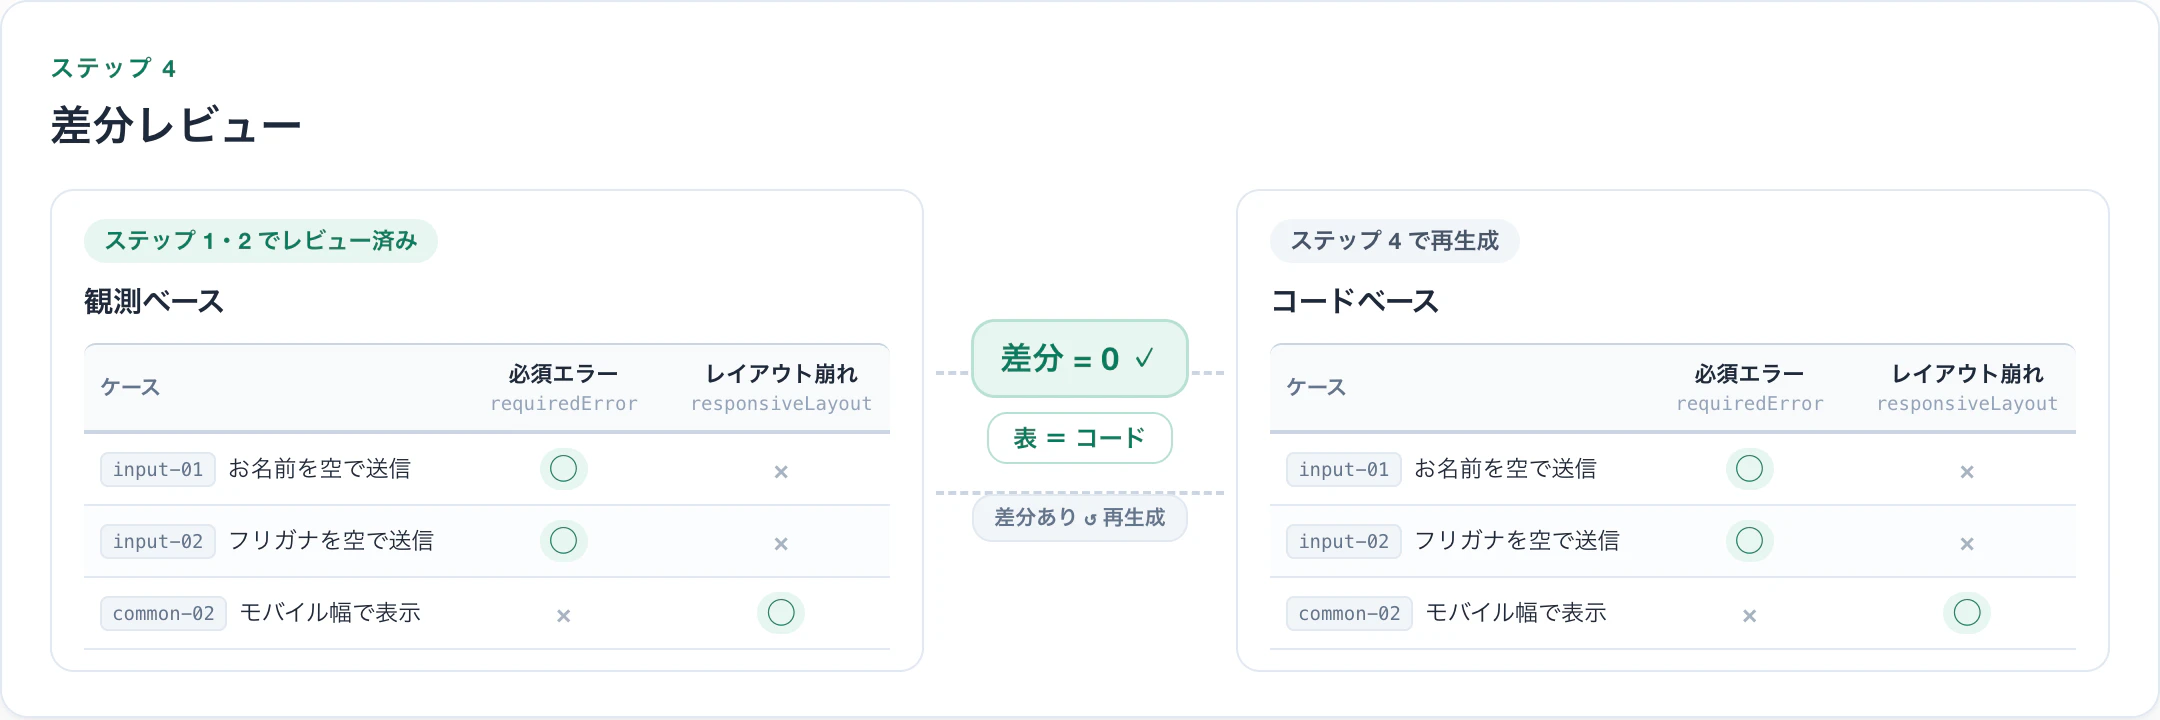
そしてステップ4が、このワークフローの要になる差分レビューです。
外郭からスクリプトでマトリクスを再生成し、ステップ1でレビューした表との差分ゼロをもって、レビュー済みの表がそのままコードに写っていることを確認します。
(元としたスプレッドシートなどがある場合はそちらと見比べるのが良いでしょう)
3. ケースに沿ってテストを実装し、エビデンスを確認する(ステップ5・6)
外郭の fixme を test に書き換えながら検証を埋め、「どう操作して何を検証するか」はコードに、「なぜその確認が必要か」はマトリクスに、と役割を分けます。
この時、外郭の情報は意味なく変更されないため、実装中の乖離を防ぐ効果もあります。
最後の検証ポイントが、テストの実行とエビデンスの確認です。
パスの自動判定だけでは埋まらない「期待どおりだった」を、レポートのスクリーンショットやトレースで人の目で確かめます。
エビデンスの確認をしやすくするために、PageObject の各操作系メソッドにスクリーンショットを取得するアノテーションを付与して取得の粒度がブレないようにすると保守しやすくなります。
コードのレビューも残りますが、意図の確認はすでにマトリクスとケースのレビューで済んでいるため、差分で見るのは「期待値の確認が正当であるか」だけになります。
4. 変更はマトリクスから逆算する
UI 変更では、まずマトリクスのどの観点に影響するかを AI が洗い出してから、対応する spec の外郭を直し、ステップ4のレビューに進みます。
ケース量が少なければ全部実行してしまうのが良いですが、多い場合には生成しているマトリクス表から案件に応じて必要なテストを走らせるようなイメージで行うと、塩梅が取れるようになると思います。
まとめ
E2E テストの形骸化は、「何を・なぜ確認しているのか」「何が網羅されているのか」「変更の影響範囲」がコードから見えなくなることを原因として挙げました。
今回のワークフローの要点は2つです。人が確認する対象をコードの外に、生成物として出し続けること。そして生成を AI に任せきりにする代わりに、レビュー・仕様確定・変更の分岐という判断のポイントだけ人の手に残すことです。
生成のコストが下がった時代だからこそ、確認をどう設計するかが品質を左右すると思います。同じ課題を持つ方の参考になれば幸いです。