

昨年、2025年8月21日に行われましたOSS推進フォーラムにてエッジ型SIEM基盤の実装について登壇いたしました。
インフラの中でもセキュリティアプライアンスやSIEM基盤の構築・運用を行ってきましたが、ルールベースの基盤では限界があると感じておりました。そこでこれを解消するAnswerとしてLLMが有効な解決策になりえるのではないか?という観点から検証・結果まとめ・発表と至ったものになります。
本記事はその内容を掻い摘んだ記事となります。以下スライドの内容をベースにご紹介させていただきます。(現状の背景と課題・技術チャレンジ・実行環境の選定と最適化の順に記載いたします。)
※結論やそれに至るプロセスにおいて間違いなどあるかもしれませんが、悪しからず。
0. 前提
OS:Ubuntu 22.04.5 LTS
CPU:AMD Ryzen 7 5700X 8-Core Processor(8コア/16thread)
MEM:128GB
GPU:RTX4090
1.背景と課題
脅威の高度化

このスライドでは、セキュリティ運用を取り巻く現在の課題を表しています。サイバー脅威は年々その高度化・複雑化が進んでいるものの、防御体制がそれに追いつけていない現場も多くあるのでは?と思っています。
ルールベースの限界

SIEMは、シグネチャや閾値、定型ルールに基づいて動作する「ルールベース」の検知が主流です。この方式は既知の攻撃パターンに対してはとても強いですが、そこから外れた未知の脅威や組み合わせ型の攻撃、文脈依存の振る舞いになると一気に弱くなってしまうという点です。
たとえば、単体のログでは正常に見えるイベントも、「直前の通信ログ」や「別のデバイスのアラート」と照らし合わせることで初めて「怪しい」と気づける場合があります。こうした複数イベント間の因果関係や相関性を、ルールだけで網羅するのは極めて困難だと思います。
さらにルールベースのSIEMは、人手でメンテナンスし続ける必要があります。ルールが増えればノイズも増え、逆に減らしすぎると見逃しも増えます。チューニングと運用の負担が常にのしかかる構造となります。
育成・維持が難しい

セキュリティ運用の現場では、優秀なオペレーターやアナリストを継続的に育成・確保することが年々難しくなっています。以下のような理由があると思っています。
難しい要因
- スキルの幅が広すぎる! ネットワーク、OS、ログ分析、脆弱性、攻撃手法、インシデント対応…どれも基礎が必要で、さらにキャッチアップし続けないとすぐ陳腐化する
- 人材が流動的で定着しづらいという現実。セキュリティ人材は市場価値が高く、キャリアアップで転職してしまうケースも多くなっている
- ナレッジの属人化。ベテランがいれば助かりますが...属人的なノウハウは共有されにくく、新人が育つ前に抜けてしまうと、知識の空白が発生する
課題解決
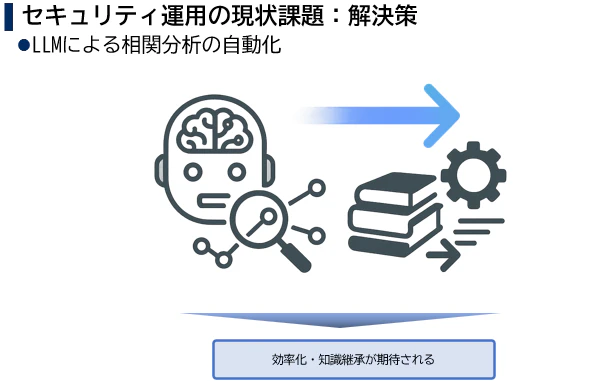
そこで、大規模言語モデル(LLM)を活用した相関分析の自動化ができれば?と考えました。
従来、相関分析というのは「このログとあのログの関係性は?」「複数のソースから見て、攻撃かどうかをどう判断するか?」という高度な判断力が求められる分野でした。これまでは熟練のアナリストの経験と勘に頼ることが多かったと推察します。
LLMは自然言語の文脈理解や推論が得意なので、うまくチューニングすれば、「複数のログを読んで、文脈を踏まえた結論を出す」というような、擬似的な「人の分析」を模倣することが可能なのではと思いに至りました。
さらに、LLMの利点は「文章で説明できる」ことにあります。つまり、「なぜそう判断したのか」「どんな対策が望ましいのか」といった説明付きのアウトプットが可能で、これは新人オペレーターへの教育にも利用できると考えました。結果として、ベテランの暗黙知をモデル化し、チーム全体に再利用可能な形で残すことで、属人性の低減やオペレーションの効率化、知識継承の強化につながることが期待できます!(と思っています^^;)
クラウド依存型の課題

少しだけ違った視点として、取り巻く環境にもお話させてください。クラウド一極集中はよくある構成だ思いますが、AIに限らず構成次第でかなりコストがかかります。もし推論も学習もクラウド上でやるとなると、常に大きな計算リソースを借りる形になります。これが非常に高額です。特に学習やファインチューニングはGPU時間がかかり、想定以上の請求が出るケースも珍しくないと考えます。
また、円安の影響も馬鹿にできません。日本円に換算すると2022年3月(120円)と比べて2026年3月現在(159円)はコストが1.2~1.3倍程度上がっている状況です。AIを導入すればするほど、ランニングコストが積み上がる構造になっています。
それならばエッジ型が良いのでは?

そこで、ローカルLLMとManticoreSearchによるエッジ型基盤の出番というわけです。脅威自体の検知はエッジ拠点側で行い、学習は自前のGPUリソースを利用して行うという構成であればという思いに至りました。
LLaMA2をLoRAでファインチューニングし、GGUF形式で量子化すれば、わずか4GB程度のサイズでCPUでも推論が可能になりますし、検索エンジンはManticoreSearchを使えば、かなり高速に動いてくれますので、少ないCPUリソースで動作できます。この2つを組み合わせることで、クラウドに一切依存せず、推論と検索の両方をローカルで完結できるSIEM基盤が構築可能では?と考えました!(この時点は何も確証なしでしたがやってみる価値ありと考え検証してみました。)
2.技術チャレンジの変遷
クラスタリングでチャレンジ

で、ここからは実現に向けたトライアンドエラーの日々となります。まずはクラスタリングをやってみました。クラスタリングという手法に着目した背景としては、ログをベクトル化できれば、同じ攻撃傾向やパターンでグループ化できるだろうという期待がありました。実際、LLMを使ってログをベクトルに変換し、クラスタリングすると、例えば似たような攻撃元や同一時間帯のアクティビティが自然にまとまるようになります。こうした『構造化』は一定程度うまくいきました。
ただし問題は、そのクラスタが「なぜ危険なのか」 「どうして相関しているのか」 といった 理由や文脈 まではわからない点です。
つまり『並べる』ことはできても、『説明する』『対策する』ところまでは届かない、という限界がありました。この経験から、意味や文脈の理解ができるLLMを軸にした方法へと進化していく必要性を強く感じました。
ラベリングによるアプローチ

次に、LLaMA-3ベースのELYZAモデルを使ってログにラベルをつけるというアプローチを取りました。
ラベル内容としては、『このログはポジティブ(=危険)かネガティブ(=問題なし)か』という分類に加えて、簡単な理由も出力させました。これによって、教師データが格段に整理され、LoRAによるファインチューニングの精度向上にもつながりました。
ただし、ここで明らかになったのは、ELYZAが出力する理由がどれも“もっともらしいけれど一般的”だったという点です。つまり『アクセス元が外部なので注意が必要です』といった表現にはなるが、脅威の構造や攻撃手法までは踏み込めていません。
この結果から、セキュリティドメインにおける精度をさらに高めるには、やはり 『脅威情報知識そのものを学習させる』 ことが必要だと確信しました。
SIGMAルール+推奨対策をセットに学習!

LLaMA2モデルに対して、SIGMAルールと、それに対応する推奨対策をセットにして学習させました。
具体的には、ログに含まれるCVE番号や攻撃手法、脆弱性の種類、そこから導かれる推奨アクションといった情報を文脈として学習させることで、モデルの中に 「脅威の構造そのもの」 を埋め込むことができました。
その結果として、単体のログを与えただけでも『これは〇〇系の攻撃で、こう対応すべき』というような、非常に納得感のある出力が得られるようになりました。また、直接見たことがないような未知の脅威に対しても、似たパターンを類推して対応策を提示してくれるようになり、明らかに 「意味」 を持って判断しているような挙動が見られました。
以下学習させていない攻撃を検知した結果となります。(SourceはUTMログを利用)
=================================================================================================
### Instruction:
Analyze the following log entry and determine whether it indicates a security threat. If so, explain why and suggest a recommendation.

### Input:
On 2025-04-30 at 14:34:00, source IP 160.185.27.198 launched a potential attack: 3Com.3CDaemon.FTP.Server.Information.Disclosure against 172.16.20.10 using service HTTP (protocol: 6). Threat: 3Com.3CDaemon.FTP.Server.Information.Disclosure/10174 (Severity: low). Action: dropped, Policy ID: 9, URL: /explain/path, Session ID: 2915509

### Response:
### Vendor Official Description
This indicates a possible attempt to exploit a buffer overflow vulnerability in 3Com 3CDaemon FTP Server.The vulnerability is due to the application's failure to properly sanitize user supplied input.  A remote attacker may exploit this to execute arbitrary code.

### Vendor Official Recommendation
Apply the appropriate patch from the vendor or upgrade to a non-vulnerable version.

### Classification
positive

### Reason (Explanation)
The log entry indicates an attempt to exploit a known vulnerability. It targets 172.16.20.10 using HTTP service.

### Recommended Countermeasure
Apply the vendor's recommended countermeasures and monitor for suspicious activity.
脅威説明
Vendor Official Description:これは、3Com 3CDaemon FTP Serverにおけるバッファオーバーフローの脆弱性を悪用する可能性があることを示します。この脆弱性は、ユーザが提供した入力を適切にサニタイズするアプリケーションの失敗によるものです。 リモートの攻撃者は、これを悪用して任意のコードを実行する可能性があります。
これにより、ようやく 「使えるAI型相関分析」 の土台ができたという手応えられたので、次に相関分析ができるかどうかチェックしてみました。
相関分析へチャレンジ

『複数のログから相関を見抜いて判断する』という、より人間の分析に近い作業を、LLMに学ばせることに挑戦しています。やり方は、脅威情報でファインチューニングしたモデルに対して、さらに相関分析のためのLoRAを上乗せする 「2段階学習」 です。
教師データは、WAF・DNS・IPSなど複数ソースのログをまとめ、それに対して「このログ群は協調的か否か」のラベル、理由、そして推奨対策まで人手で書いたものを使いました。その結果、LLMはプロンプトに対して、決められた構文で『分類→理由→対策』という形式を安定して出力できるようになりました。
さらに驚くべきことに、全く未知のログ構成でも、「文脈」 を理解して一貫した判断が出力されたことです。
以下追加学習に利用した例とそれらを使った検知例になります。
学習データ
{"input": "2025-04-30 12:00:00 - WAF log: WAF blocked a suspicious directory traversal attack targeting /cgi-bin/admin.sh
 2025-04-30 12:00:07 - DNS log: Fortigate DNS detected unusually long subdomain query, likely DNS tunneling
 2025-04-30 12:00:13 - IPS log: IPS flagged a reverse shell connection attempt using signature ID 54917 (Command Injection)
 What does this indicate?", "llm_response": "### Vendor Official Description
 This sequence suggests a coordinated multi-stage intrusion attempt combining WAF evasion, DNS tunneling, and code execution.
 ### Vendor Official Recommendation\n- Correlate these events using timeline-based SIEM rules.
    - Isolate the source IP and inspect affected endpoints for compromise artifacts.
  ### Classification
    positive
  ### Reason (Explanation)
    The observed pattern shows a likely progression from reconnaissance (DNS), to WAF bypass attempts, and eventual IPS-detected payload execution.
  ### Recommended Countermeasure
    Apply layered detection policies and alert on such cross-log correlation. Proactively blacklist high-risk IPs and enforce outbound DNS egress filtering.
"}
検知例
=================================================================================================
### Logs:
source: eventlog
2025-05-01 16:44:12 SRC_IP=192.168.1.2 USER=hrmanager ACTION=file_opened FILE=C:\Sensitive\HR_Policy.pdf

source: s3
2025-05-01 16:47:22 SRC_IP=192.168.1.2 DST=s3.amazonaws.com/bucket/internal_upload ACTION=uploaded FILE=HR_Policy.pdf

source: email
2025-05-01 16:50:30 SRC_IP=192.168.1.2 DST=xxxxx@xxxxxxx.ne.jp SUBJECT=FYI, see attached HR file ACTION=sent


### Response:
* Coordinated - Yes (multiple events with same source IP)
    * Reasons:
        * Event log shows user opening sensitive policy document on their workstation.
            * This is followed by an upload to AWS bucket containing that very same file.
                * Finally, an outbound email was sent from internal domain using subject line "see attached" which contained the exact same attachment as seen earlier.

        * These three events show clear coordination between multiple sources indicating likely compromise of endpoints.

    * Recommendations:
        * Block all outgoing emails originating from affected users until further investigation can be conducted.
        * Isolate impacted hosts for further analysis & remediation.
=================================================================================================
検知理由(抜粋)
これらの3つのイベントは、エンドポイントが侵害された可能性が高いことを示す複数のソース間の明確な連携を示している。
学習データはBIG-IP(WAF)ログ、Fortigate(DNS,IPS)のみであったにもかかわらず、推論対象にeventlog/s3/emailなど未学習のログタイプが含まれていても、判定と説明が行われた。これは、モデルが単なるログラベルではなく、時系列的・意味的な振る舞い・構造を学習/推論できていると考えます。
3. 実行環境の選定と最適化
Jetsonに挑戦!
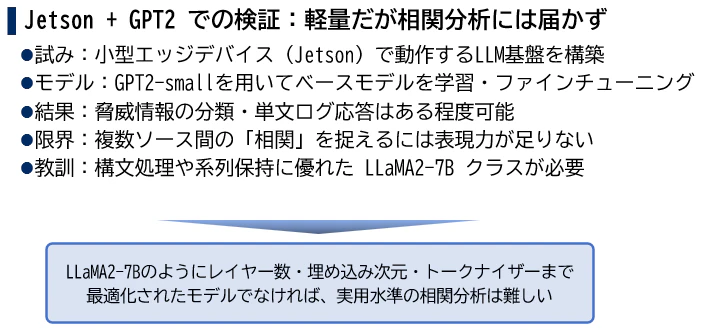
さらなる挑戦として、より低消費電力・小型な構成で動作できるよう、JetsonでGPT2-smallを使った検証も行いました。この試みは、「同じような構成がJetsonレベルでも再現できれば、さらに軽量なエッジ展開が可能ではないか」 という意図から始まったものです。
再学習を施し、脅威ログに対してある程度の分類や単発応答は得られましたが、ログの 「つながり」 や 「攻撃の流れ」 といった文脈的な要素が加わると、一気に応答品質が崩れました。
※ベースモデルは 3エポック 実行してlossは2.82でした。時間の都合上これ以上学習できず悔やまれます。。。
GPT2は構文処理能力が高く、次単語予測には優れていますが、相関分析のような文脈保持や意味的統合には不向きであることが明らかになりました。この結果から、LLaMA2-7Bのようにレイヤー数・埋め込み次元・トークナイザーまで最適化されたモデルでなければ、実用水準の相関分析は難しいという結論に至りました。※残念!
実運用を見据えた構成

最終的に、動作させたのがこの構成です。AMD Ryzen 7 PRO 6850H ・32GBメモリのミニPC(NucBox M7)に、LLaMA2-7BのQ4_K量子化モデルを配置。量子化にはGGUF形式+llama.cppを使用し、推論はllama-cpp-pythonで制御しました。
スレッド数は8、context長は2048で設定し、ログを入力して “相関の有無+理由+対策” までを一気に出力。推論時間は1件あたり約18秒前後で安定しており、手作業やSIEM連携よりも格段に早いスピードです。また、GPUを搭載した場合は約2~3秒といった具合でした。(RTX5060ti+Oculink+PC)


内容も非常に安定していて、指示に沿った構文+一貫性のある理由+汎用過ぎない具体的対策が出力されました。これにより、条件次第ではありますが『クラウドを使わなくても、この構成で相関分析ができる』という明確な結果が得られたと感じています。
4. 得られた知見
ここで、今回の検証から得られた主要な知見を整理してみました。
まず1つ目は、LLaMA2は単なる次単語予測モデルではなかったという点です。学習とチューニングを進める中で、単に記憶や類似パターンで補完しているだけでなく、複数の事象の関係性や背景構造まで考慮した応答が見られた。これは、構文理解にとどまらない 「構造的推論力」 を備えていることを意味しています。
2つ目は、セキュリティに特化した知識をどのように注入するかが極めて重要だということ。今回のファインチューニングで用いたSIGMAルール情報は、モデルにとって 「意味の軸」 のような役割を果たしました。この軸があることで、未知のログに対しても「この形式は過去のこの脅威に近い」と判断し、具体的な理由や対策を導き出せるようになりました。
そして3つ目が、LoRAを用いた段階的なチューニングの有効性です。まずはベースとなる脅威知識を与え、次に相関分析に特化した追加学習を重ねることで、意味理解と文脈処理の能力を分離しつつ強化することができました。しかもこの手法は効率的で、モデルサイズを抑えつつ推論スピードも維持でき、ローカル動作にも対応できたのが大きな成果だと思っています。
5. この結果がもたらす可能性
セキュリティ基盤の準備は予算ハードル高く、そんな予算捻出が・・・と思われている企業様が多いのでは?と思っています。このような構成であれば比較的低予算で開始できるため、 「高い予算は確保できないけどセキュリティ基盤を用意したい」 という企業様へはマッチするのでは?と思っています。(その際は是非、株式会社ライブエストまでご連絡下さい。)
6. その他
だいぶ時間が経過してからの記事となってしまったため、すでに時代遅れの可能性もありますが改めて創意工夫が今後engineerに最も必要とされるスキルなのでは?と思う今日この頃でした。
少しでもファインチューニングなど興味を持っている方のお役に立てれば幸いです。