
Microsoft Ignite 2026 にて、Azure AI Search は正式に Foundry IQ に名称変更されました。今後は、Azure ポータル、Foundry ポータル、ドキュメント、および製品ページでは、名称は Foundry IQ (Azure AI Search) と表示されます。サービス、機能、および性能に変更はありません。
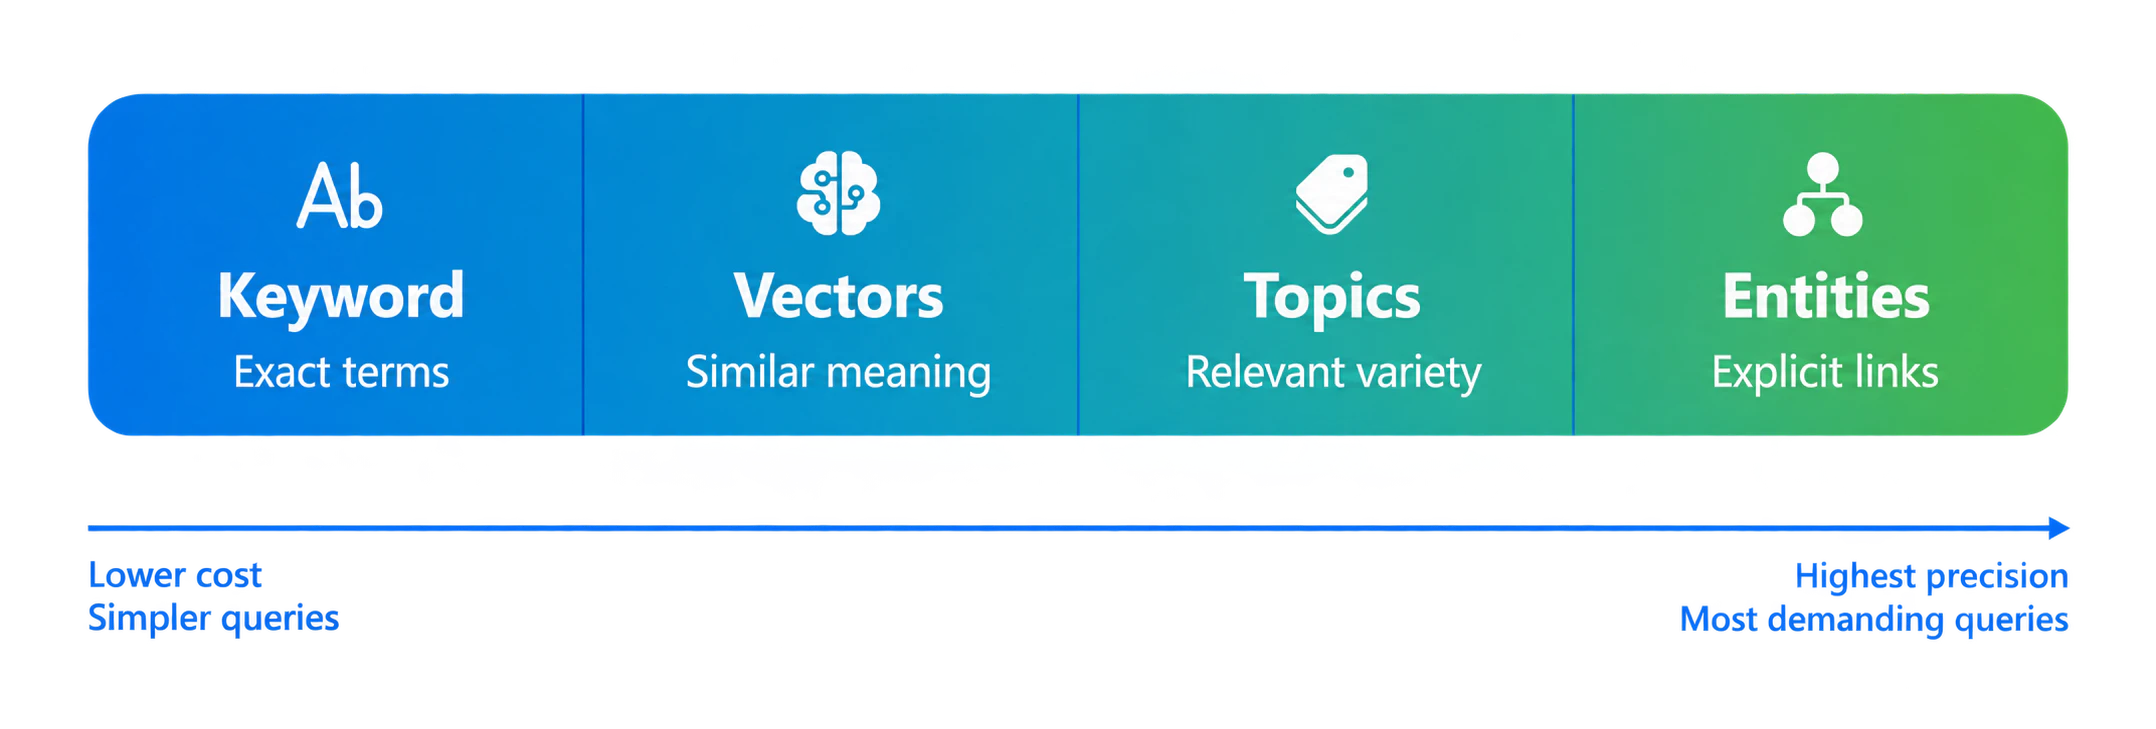
そして、とうとう来ましたね!Foundry IQ に2 種類のナレッジグラフ機能が搭載されました!トピックグラフはテーマ全体にわたる証拠を広げ、エンティティグラフは特定のエンティティ間の関連性を追跡します。現状の実装はすべての工程がマネージド化されたわけではないですが、素晴らしい一歩だと思います。今後の進展に期待です✨

これで Foundry IQ はあらゆる RAG のニーズに対応できるようになったということですね。それだけではなく、新モデル Microsoft Retriever 1 が、エージェントのグラウンディング結果を向上させる新しい検索モデルとして内部に実装されました。
🎉Big News サマリー
2026 年 11 月のアップデートでは、安定版 REST API(Search Service 2026-10-01、Search Management 2026-11-01)で Serverless や agentic retrieval の主要機能が一般提供となりました。
| 機能 | Ignite の発表 | 要点 |
|---|---|---|
| エンティティ グラフ | パブリックプレビュー | インデックス作成時にオントロジーでエンティティと関係を抽出し、各接続に出典を残す。自然言語または GQL で問い合わせる。 |
| トピック グラフ | パブリックプレビュー | 既存の埋め込みからトピックとサブトピックを自動で特定し、コーパスのサイトマップにする。候補オントロジーの提案にも使える |
| Microsoft Retriever 1 | パブリックプレビュー | 検索の計画を立てる専用モデル。既存インデックスの上で動き、検索計画のために最先端モデルをデプロイする必要がない |
| SharePoint ナレッジ ソース(権限対応) | 一般提供 | Entra グループと SharePoint サイト グループの権限を、利用者の ID で適用する |
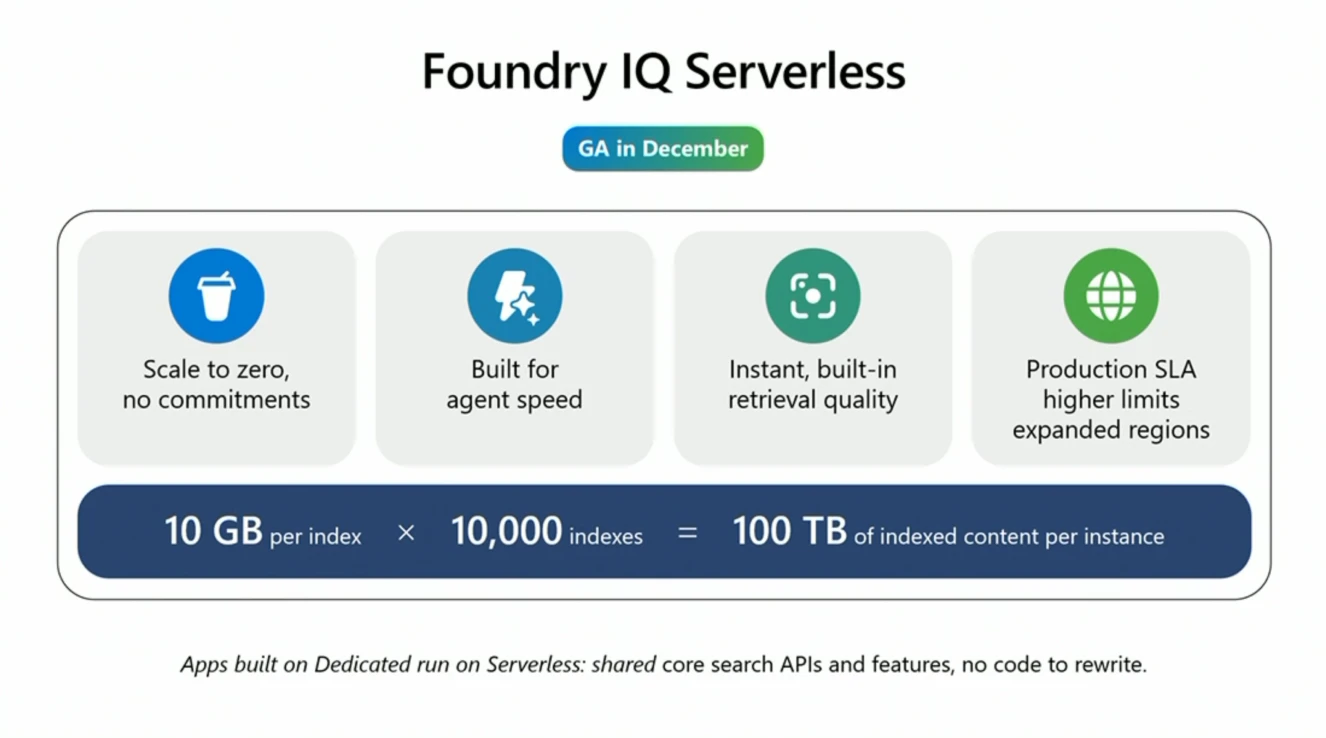
| Foundry IQ Serverless | 2026 年 12 月に一般提供予定 | 使用量課金。アイドル時はゼロにスケール。一般提供で SLA、上限引き上げ、リージョン追加 |
| 新規 Foundry プロジェクトへの組み込み | 2026 年 12 月にパブリック プレビュー予定 | 管理型の Foundry IQ リソースが各プロジェクトに用意される |
上記以外の Update 一覧
2026 年 11 月: (preview) 表記のない項目
Search Service 2026-10-01 対応。
| 分野 | 項目 | 要点 |
|---|---|---|
| Agentic retrieval | クエリ計画と回答合成 | モデルによるクエリ計画、回答合成、low と medium の推論労力が 2026-10-01 で使える |
| Agentic retrieval | ナレッジ ベースの取得(retrieve)更新 | 応答のストリーミング、引用された文書の参照。ナレッジ ソース パラメーター、アクティビティの警告、取得上限、失敗ポリシー、CORS 設定を追加 |
| ナレッジ ソース | File ナレッジ ソース | ファイルのアップロードと管理、グラウンディング データの取得。非同期取り込みはプレビューのまま |
| ナレッジ ソース | インデックス型 Azure SQL ナレッジ ソース | Azure SQL Database または Managed Instance の行を、管理された取り込みパイプラインで取り込む。列マッピングでスキーマを定義し、埋め込み生成は任意 |
| ネットワーク | インデックス型ナレッジ ソースのプライベート取り込み | Blob、ADLS Gen2、Azure SQL、OneLake が、対象となる Dedicated サービスで利用可能。Serverless は private 実行と送信共有プライベート リンクに非対応で、代わりにネットワーク セキュリティ境界を使う |
| インデクサー | Serverless と S3 HD でのインデクサー実行 | 1 日の共有実行クォータを、インデクサー単位とサービス全体で追跡できる |
| API | 一覧操作のカーソル ページング | 名前の接頭辞で絞り込み、インデックス、インデクサー、データ ソース、スキルセットを継続 URL でたどる |
| セキュリティ | ドキュメント レベルの権限の取り込みとフィルター | push API と、ADLS Gen2、Blob、SharePoint の取り込み経路でネイティブの権限フィルターを使う。ソース別の制約あり |
| セキュリティ | ADLS Gen2 の権限の更新と再同期 | 対象の実行でおよそ 1 日ごとに ACL を自動更新。権限のみの再同期で、コンテンツや埋め込みを作り直さず ACL を揃える |
| セキュリティ | テナント間のカスタマー マネージド キー | フェデレーション ID 資格情報で、別の Entra テナントのキーを使う |
| エンリッチメント | Content Understanding の更新 | セマンティック チャンク化と AI による画像説明が 一般提供 |
| エンリッチメント | OCR スキルのサービスと課金の更新 | Azure Document Intelligence の Read モデルを使う方式に更新(API 2024-11-30)。2026-11-05 以降のどこかで、OCR の課金が Azure Vision から Document Intelligence の利用に変わる見込み。時期はサービスへの反映時期による。環境の移行やスキル設定の変更は不要 |
| クエリ | 類似文書の検索 |
moreLikeThis で、インデックス済み文書に似た文書を探す。検索対象フィールドから語を導く |
2026 年 11 月: (preview) の項目
| 項目 | 要点 |
|---|---|
| OneLake の権限の保持 | ソースの場所のメタデータを保持し、クエリ時に OneLake で要求ユーザーのアクセスを評価する |
| ランダム スコアリング関数 | フィールドをブーストせず、疑似乱数のスコアを割り当てる |
| GPT-6 ファミリーのナレッジ ベース モデル | クエリ計画と回答生成に使える。Responses API を使い、2026-11-01-preview が必要 |
| OpenAI 互換のナレッジ ベース モデル | Azure API Management 経由で接続。対応するモデル プロファイルで Chat Completions か Responses を選ぶ |
| File ナレッジ ソースの非同期取り込み | 取り込みや置き換えを非同期で行い、長時間操作をポーリングし、操作記録を一覧できる |
| Foundry IQ skills for GitHub Copilot CLI |
foundry-iq-skills プラグインで、既存のナレッジ ベースへの引用付きクエリと、ナレッジ グラフの作業を行う |
Big News ①: トピック グラフ(プレビュー)
1. 何を解決するのか
公式ではトピック グラフを「関連するコンテンツのまとまり(コミュニティとも呼ぶ)と、そのまとまりがトピックの階層の中でどうつながるかを表すもの」と説明しています。1 か所の文章に書かれた事実ではなく、文書群全体のテーマやパターンを問う広い質問に答えるためのものです。複数のトピックから根拠をサンプリングすることで、最も近いベクトルだけに偏らず、幅広いテーマを反映した回答を支えます。
このコミュニティや階層というワード、どこかで聞いたような気がしませんか?
はいちょうど2年前に解説しましたね。Microsoft GraphRAG に出てきた用語です!今回 Foundry IQ がコミュニティの検索にも対応したと思われます。今後詳しく分析しますが、今の時点で TopicGraph スキル内の実行体の log に leiden の記述がありましたのでおそらく同様の技術でしょう。

実際、構築したトピック グラフは上記のようにビジュアライズされています。
Foundry IQ ナレッジグラフチームの成果
- ナレッジグラフエンティティ、トークン使用量を削減しながら、構造化グラフクエリに対する正確な回答を可能にします。エンティティグラフ検索は、RAGの26.1%に対し、クエリの93.5%に正しく回答し、トークン使用量は64.3%削減されました。
- ナレッジグラフのトピック機能は、コーパスを閲覧可能なトピックマップに変換し、検索時にその全体から証拠を見つけ出すのに役立ちます。テーマ別の質問において、トピックグラフ検索は、従来のベクトル検索と比較して、証拠の再現率を最大13.2パーセントポイント向上させました。
- これらのアプローチは相互補完的かつ相加的です。直接的な文章一致には従来の検索、正確な記述内容にはエンティティ、そしてテーマ横断的な証拠の統合とコーパスナビゲーションにはトピックを使用します。質問に精度と網羅性が求められる場合は、これらのアプローチを重ね合わせることで、より少ないトークンでより優れた検索を実現できます(この例では、トークン数を52%削減しながら、証拠の想起率を43%向上させています)。

個人的には、トピックグラフ検索で複数のトピックから文書を選び、検索結果の多様性を高める仕組みが興味深かったですね。
2. トピック グラフとエンティティ グラフの使い分け
Foundry IQ のグラフ機能は 2 種類あります。
| 観点 | トピック グラフ | エンティティ グラフ |
|---|---|---|
| 実体 | トピックとその階層。代表となるトピック ベクトルを使い、テーマをまたいで根拠をサンプリングする | 型を持つエンティティをノード、関係をエッジとして表す。グラフ クエリがその接続をたどる |
| 得意な質問 | 文書群全体のテーマやパターンを問う多様な質問 | 関係をたどる質問。特に、複数の接続の連鎖が必要な質問 |
| 質問の例 | 「この文書群の主なテーマは何か」「顧客のフィードバック文書はどんなトピックを扱っているか」 | 「シアトルの組織で働く人は誰か」「Avery Chen の雇用主はどこにあるか」 |
| オントロジー | 不要 | 抽出するエンティティの型と関係を定義するために必要 |
| 準備 | トピック識別子と重心(centroid)ベクトルを持つトピック インデックスを用意する。トピック階層を表すコミュニティ グラフも使える | 抽出対象のエンティティの型と関係を持つオントロジーを定義する |
| 主な制約 | 結果は、トピック インデックスに表現されたトピックと重心に左右される | 結果は、オントロジーの網羅度と抽出の品質に左右される |
3. 必要な部品
トピック グラフ検索は、既存の searchIndex ナレッジ ソースに「トピックによるサンプリング」を足す形で動きます。
| 部品 | 内容 |
|---|---|
| コンテンツ インデックス | すでに文書が入っているインデックス。検索に使うベクトル フィールドが、トピック インデックスに紐づいている必要がある。そのフィールドには、文字列入力に対応するベクトライザーも必要 |
| トピック インデックス | トピック識別子と重心ベクトルを持つ。Foundry IQ skills プラグインで用意する(Learn の前提条件) |
searchIndex ナレッジ ソース |
topicGraph を保存する。リクエストごとに上書きもできる |
4. 前提条件
-
2026-11-01-previewREST API に対応した Foundry IQ (Azure AI Search) サービス - Python 3.10 以降(C# の場合は .NET 8 以降)
- プレビュー版の SDK(
pip install --pre azure-search-documents)とazure-identity - Foundry IQ skills プラグインで用意した、データ入りのトピック インデックス
- 同じサービス上の、データ入りのコンテンツ インデックス(ベクトル フィールドがトピック インデックスに紐づいていること)
- リソースと取得操作に権限のある資格情報(キーレス認証を推奨)
トピック インデックスを用意する Foundry IQ skills プラグインは、GitHub Copilot CLI のスラッシュ コマンドで入れます(Copilot CLI の中で実行します)。前提は、Git、GitHub Copilot CLI(Windows または Linux)、Python 3.12 以降、既存のナレッジ ベースと Azure リソースへのアクセスです。
/plugin marketplace add microsoft/azure-skills
/plugin install foundry-iq-skills@azure-skills
実際のトピックインデックス例
次回もう少し詳しくデータ構造を分析していきましょう。
    {
      "@search.score": 1,
      "id": "ab0455a63fedb7149530e1e18bccf145617647f2181a3931eecaeeb58b2689b0",
      "subject": "Topic 0",
      "subject_type": "Topic",
      "subject_id": "topic:0",
      "subject_id_display_name": "近藤寺の歴史と文化",
      "predicate": "prop:description",
      "object": "京都市東山区にある近藤寺の創建と歴史、本尊・百八面千手観世音菩薩の意味と信仰、境内の建物や庭園、文化財、祭事について紹介する。",
      "object_type": "xsd:string",
      "object_id": "",
      "object_id_display_name": "",
      "object_string": "京都市東山区にある近藤寺の創建と歴史、本尊・百八面千手観世音菩薩の意味と信仰、境内の建物や庭園、文化財、祭事について紹介する。",
      "graph_name": "topicgraph-topic",
      "object_double": null,
      "object_bool": null,
      "object_datetime": null,
      "edge_confidence": null,
      "s_confidence": null,
      "p_confidence": null,
      "o_confidence": null,
      "chunk_id": null,
      "parent_id": null,
      "object_vector": []
    },
現状はグラフデータの構築は完全にはマネージド化されているわけではなく、個別にスキルを使って構築し、それをアップロードする という状況です。 これについては今後の発展に期待ですね。
Big News ②: エンティティ グラフ(プレビュー)
1. 何を解決するのか
公式は、エンティティ グラフを「人、組織、場所、その他の概念をノードとし、それらの関係をエッジとして表すもの」と説明しています。「特定の都市にある組織で働く人は誰か」のように、エンティティ間のつながりに依存する質問に答えるためのものです。Foundry IQ では、グラフ抽出(graph extraction) が Blob のコンテンツをエンティティ グラフに変換します。グラフ対応の Blob ナレッジ ソースを作り、管理されたグラフを、ナレッジ ベース経由、または GQL で直接照会します。トピック グラフと違い、エンティティ グラフは、オントロジーに基づいて、明示的なエンティティとその関係を捉えます。

| 利用できる環境 | Azure portal | Foundry portal | SDK、REST |
|---|---|---|---|
| エンティティ グラフ | 非対応(API のみ) | 非対応(API のみ) | 対応 |
Learn は、エンティティ グラフを「このリリースでは API のみ」と説明しています。組み込みの UI は、Foundry IQ skills プラグインの一部として使えます。
出典: Create and query an entity graph / Knowledge graph features overview
2. 全体像
ナレッジ ソースは、生成したデータ ソース、インデクサー、スキルセット、チャンク インデックス、グラフ インデックスを所有します。createdResources.graphIndex は直接のグラフ クエリに、createdResources.index は出典チャンクの参照に使います。どちらも読み取り専用のプロパティです。ナレッジ ベースは、自然言語の関係の質問を GQL に変換します。このナレッジ ベースのモデル構成は、グラフの抽出に使ったモデルとは別です。
3. 前提条件、制限、ベスト プラクティス
前提条件
-
2026-11-01-previewREST API に対応した Foundry IQ サービス、Python 3.10 以降、プレビュー版の SDK - Blob ナレッジ ソースの前提条件(サービス、モデル デプロイ、認証、課金)
- テキスト コンテンツを置いた Azure Blob Storage のコンテナー。このグラフ ワークフローは、ADLS Gen2、ACL の取り込み、秘密度ラベルの取り込みに対応しません
- 最初のインデックス作成の前に、Blob のネイティブ論理的な削除(soft delete)を有効にする。Blob のバージョン管理は無効にする
- 取り込み用のチャット補完モデル。自然言語でグラフを照会するナレッジ ベースには、別にモデル構成が必要
- テスト用のナレッジ ソースとナレッジ ベースを作成、削除する権限(キーレス認証を推奨)
制限
- エンティティ グラフ検索には、新しいナレッジ ベースが必要です。既存のナレッジ ベースで有効にはできません。
- このリリースでは API のみです。
ベスト プラクティス
| 観点 | 内容 |
|---|---|
| 始め方 | 手順のとおり、Foundry IQ skills プラグインが推奨。REST API や SDK で直接構成することも可能 |
| モデル | 品質とコストのバランスが最もよいのは、gpt-5.6-luna と low の推論労力の組み合わせ |
| オントロジー | ユーザーが尋ねそうな主要な質問を基に設計する。オントロジーの質が、グラフの形と内容を決める。質問に必要なエンティティの型と関係を入れる |
| 範囲 | 1 つの主要なユース ケースと、少数のエンティティの型と関係から始める。拡大する前に、代表的な質問で抽出されたグラフを検証する |
| コスト | コーパスの大きさと、抽出されるエンティティと関係の数の両方から見積もる。プレビュー中は、エンティティ グラフ機能自体の追加料金はなく、使ったモデルのトークンには課金される |
4. 構築手順(要約)
- コンテンツとオントロジーを用意する。 →オントロジーの作成はスキルなどを活用してユーザーが設計
- グラフ対応の Blob ナレッジ ソースを作る。
graphExtraction.ontologyは JSON オブジェクトで、kindをinlineにし、valueに、制約付き JSON-LD を JSON 文字列に直列化したものを入れる。※Entity Graph を作る主体は、Azure AI Search サービス自体。ナレッジ ソースのgraphExtractionを有効にすると、サービス内のマネージドな取り込みパイプラインが、チャンク化、ベクトル化、トリプル(主語・述語・目的語)の抽出を行う。 - 抽出の完了を確認する。
- ナレッジ ベースを作る。 自然言語の質問を GQL に変換するため、ナレッジ ベースには、グラフ抽出とは別に、モデルを明示的に構成する。
- ナレッジ ベース経由で関係の質問をする。 生成されたクエリの開示(include_query)と、来歴(provenance)の出典文書の取得(hydrate)を、リクエストで明示的に選ぶ。
- GQL で直接クエリする。 アプリケーションが走査を自分で組み立てる場合は、マネージドグラフインデックスに直接問い合わせます。直接の
search.graph操作ではgqlが必須。
GQL で直接クエリが可能に!
import os

from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient
from azure.search.documents.models import (
   GraphQueryProvenanceHydrateDocumentsParameters,
   GraphQueryProvenanceParameters,
)

gql = (
   "MATCH (person:Person)-[job]->(org:Organization)"
   "-[location]->(city:Place) "
   "WHERE job.predicate = 'worksFor' "
   "AND location.predicate = 'locatedIn' "
   "AND city.name = 'Seattle' "
   "RETURN person.name AS person, org.name AS organization, "
   "city.name AS city LIMIT 10"
)
with SearchClient(
   os.environ["SEARCH_ENDPOINT"],
   os.environ["GRAPH_INDEX_NAME"],
   DefaultAzureCredential(),
) as client:
   result = client.graph(
       gql=gql,
       include_statistics=True,
       include_diagnostics=True,
       provenance=GraphQueryProvenanceParameters(
           kind="hydrate",
           max_evidence_per_row=10,
           hydrate_documents=GraphQueryProvenanceHydrateDocumentsParameters(
               select="uid,snippet,snippet_parent_id,blob_url"
           ),
       ),
   )
実際のエンティティグラフインデックス例
次回もう少し詳しくデータ構造を分析していきましょう。
    {
      "@search.score": 1,
      "id": "11a8c934f6dd_aHR0cHM6Ly9zdHJzZW1hbnRpYzEuYmxvYi5jb3JlLndpbmRvd3MubmV0L2dyYXBoMS9maXEtaGFuYXBlZGlhLThjNGEzZjljLWVudGl0eS0wYmUyYTBiOWJhN2U4MWJhL3NvdXJjZS1pdGVtLTlkOWRkZmRjODJlZTQ0NzMudHh00_pages_4_raw_triples_1",
      "edge_hash": "d17bbb2766c1e154f64072518622a7a4",
      "subject": "ビル·ゲイツ",
      "subject_type": "Person",
      "subject_id": "ungrounded:v2:ba6b7121117b9625d0c726f234a0f1d2",
      "predicate": "prop:name",
      "object": "ビル·ゲイツ",
      "object_type": "xsd:string",
      "object_id": "ungrounded:v2:c8379b53cc650d4da8ceb51af25685ba",
      "s_confidence": 0,
      "p_confidence": 1,
      "o_confidence": 0,
      "edge_confidence": 0,
      "object_string": "ビル·ゲイツ",
      "object_double": null,
      "object_bool": null,
      "object_datetime": null,
      "graph_name": "fiq-hanapedia-8c4a3f9c-entity-0be2a0b9ba7e81ba",
      "parent_id": "aHR0cHM6Ly9zdHJzZW1hbnRpYzEuYmxvYi5jb3JlLndpbmRvd3MubmV0L2dyYXBoMS9maXEtaGFuYXBlZGlhLThjNGEzZjljLWVudGl0eS0wYmUyYTBiOWJhN2U4MWJhL3NvdXJjZS1pdGVtLTlkOWRkZmRjODJlZTQ0NzMudHh00",
      "chunk_id": "11a8c934f6dd_aHR0cHM6Ly9zdHJzZW1hbnRpYzEuYmxvYi5jb3JlLndpbmRvd3MubmV0L2dyYXBoMS9maXEtaGFuYXBlZGlhLThjNGEzZjljLWVudGl0eS0wYmUyYTBiOWJhN2U4MWJhL3NvdXJjZS1pdGVtLTlkOWRkZmRjODJlZTQ0NzMudHh00_pages_4",
      "subject_id_display_name": "ビル·ゲイツ",
      "object_id_display_name": "ビル·ゲイツ"
    },
Big News ③: Microsoft Retriever 1(プレビュー)

1. 何を解決するのか
microsoft-retriever-1 は Foundry IQ がホストする、専用の検索モデルです。この機能が提供する検索の計画(retrieval planning)のために、外部の計画用モデルを接続する必要がなくなります。さらに直接のインデックス検索でも、ナレッジ ベース経由でも使える専用モデルとなっています。
Agentic Retrieval の最新のパイプラインは以下で詳細に解説しています。 microsoft-retriever-1 が担当するのは、「LLM クエリ計画」の部分と、自動検索推論機能によりエージェントの検索ループが microsoft-retriever-1 に置き換えられ、必要な場合にのみより大きな言語モデルにエスカレーションされます。最初の検索後、microsoft-retriever-1 は結果を確認し、再度検索するかどうかを決定します。
利用の前提は 2 つのみです。Standard Knowledge Retrieval プランを持つ Foundry IQ サービスが、対応リージョンにあること。そして、サンプルのインデックス、ナレッジ ソース、ナレッジ ベースを作成、投入、照会、削除する権限(Search Service Contributor、Search Index Data Contributor、Search Index Data Reader)です。
Foundry IQ の microsoft-retriever-1 チームの成果
- 検索処理を
microsoft-retriever-1に委任するエージェントは、入力トークンの使用数が3分の1少なく、最も高い再現率と回答の正答率を示します。 -
microsoft-retriever-1は、プロビジョニングや再インデックス作成を必要としません。Foundry IQ の検索クエリまたはナレッジベースで有効にするだけです。 - 知識ベースの自動検索推論処理に
microsoft-retriever-1を追加すると、通常のレイテンシが 6 倍以上短縮されます。 - Foundry IQ の検索クエリに
microsoft-retriever-1を追加すると、証拠の想起率が8~11 ポイント向上します。
2. 2 つの使い方
3. 経路 A: インデックスを直接検索する
Learn のサンプルは、id、title、content、フィルター可能な jurisdiction を持つインデックス(mr1-policy-index)に、カナダのポリシー 2 件を入れたものです。まず、リソース名とクライアントを用意し、インデックスと文書を作ります。
from azure.identity import DefaultAzureCredential
from azure.search.documents import SearchClient
from azure.search.documents.indexes import SearchIndexClient
from azure.search.documents.indexes.models import (
    SearchableField,
    SearchFieldDataType,
    SearchIndex,
    SimpleField,
)

search_endpoint = "<search-endpoint>"
index_name = "mr1-policy-index"
knowledge_source_name = "mr1-policy-source"
knowledge_base_name = "mr1-policy-kb"
credential = DefaultAzureCredential()
index_client = SearchIndexClient(search_endpoint, credential)
search_client = SearchClient(search_endpoint, index_name, credential)

index_client.create_index(SearchIndex(
    name=index_name,
    fields=[
        SimpleField(name="id", type=SearchFieldDataType.STRING, key=True),
        SearchableField(name="title"),
        SearchableField(name="content"),
        SimpleField(name="jurisdiction", type=SearchFieldDataType.STRING, filterable=True),
    ],
))
search_client.upload_documents(documents=[
    {"id": "ca-leave", "title": "Canadian parental leave", "jurisdiction": "CA",
     "content": "Canadian employees receive four weeks of paid parental leave."},
    {"id": "ca-request", "title": "Canadian leave requests", "jurisdiction": "CA",
     "content": "Canadian employees submit parental leave requests through the HR portal at least 30 days before leave."},
])
次に、フィルター jurisdiction eq 'CA' で根拠をカナダに限定し、デバッグ モードを agentic にして計画の内訳を確認します。
from azure.search.documents.models import AgenticSearchOptions, QueryDebugMode, QueryType

question = "What parental leave do Canadian employees receive and how do they request it?"
results = search_client.search(
    search_text=question,
    query_type=QueryType.AGENTIC,
    agentic_options=AgenticSearchOptions(max_runtime_in_seconds=60),
    filter="jurisdiction eq 'CA'",
    select=["id", "title", "content", "jurisdiction"],
    top=5,
    debug=QueryDebugMode.AGENTIC,
)
documents = list(results)
diagnostics = results.get_debug_info()
4. 経路 B: ナレッジ ベースの models に指定する
同じインデックスを、検索インデックス ナレッジ ソースとして再利用します。ナレッジ ソースを作り、ナレッジ ベースの models に KnowledgeBaseMicrosoftRetriever1Model() を指定します。
from azure.search.documents.indexes.models import (
    SearchIndexFieldReference,
    SearchIndexKnowledgeSource,
    SearchIndexKnowledgeSourceParameters,
)

source = index_client.create_knowledge_source(SearchIndexKnowledgeSource(
    name=knowledge_source_name,
    search_index_parameters=SearchIndexKnowledgeSourceParameters(
        search_index_name=index_name,
        source_data_fields=[SearchIndexFieldReference(name=n)
                            for n in ("id", "title", "content", "jurisdiction")],
    ),
))
from azure.search.documents.indexes.models import (
    KnowledgeBase,
    KnowledgeBaseMicrosoftRetriever1Model,
    KnowledgeSourceReference,
)
from azure.search.documents.knowledgebases import KnowledgeBaseRetrievalClient
from azure.search.documents.knowledgebases.models import (
    KnowledgeBaseRetrievalRequest,
    KnowledgeRetrievalMinimalReasoningEffort,
    KnowledgeRetrievalOutputMode,
    KnowledgeRetrievalSemanticIntent,
)

knowledge_base = index_client.create_knowledge_base(KnowledgeBase(
    name=knowledge_base_name,
    knowledge_sources=[KnowledgeSourceReference(name=source.name)],
    models=[KnowledgeBaseMicrosoftRetriever1Model()],
    retrieval_reasoning_effort=KnowledgeRetrievalMinimalReasoningEffort(),
    output_mode=KnowledgeRetrievalOutputMode.EXTRACTIVE_DATA,
))

retrieval_client = KnowledgeBaseRetrievalClient(
    search_endpoint, credential, knowledge_base_name=knowledge_base.name,
)
response = retrieval_client.retrieve(KnowledgeBaseRetrievalRequest(
    intents=[KnowledgeRetrievalSemanticIntent(search=question)],  # 質問全体を持つ意図を 1 つだけ
    retrieval_reasoning_effort=KnowledgeRetrievalMinimalReasoningEffort(),
    output_mode=KnowledgeRetrievalOutputMode.EXTRACTIVE_DATA,
    include_activity=True,
))
アクティビティ ログには、計画の結果として次のようなレコードが入ります。Retriever 1 が使われたかどうかは、model.modelName が microsoft-retriever-1 の modelQueryPlanning があるかで判断できます。
{
  "type": "modelQueryPlanning",
  "id": 1,
  "inputTokens": 94,
  "outputTokens": 26,
  "elapsedMs": 251,
  "model": { "modelName": "microsoft-retriever-1" }
}
これに関しては、既存モデルとの比較評価を行う必要がありますね。今後詳しく新機能を掘り下げていきましょう!!

あと Pablo Castro がしれっと Microsoft Ranker 3 出してました。リランカーモデルは内部的に 2 回ほど Update しているので、今風のモデル名で呼ぶことにしたのでしょうか。
Foundry IQ Serverless は 2026 年 12 月に一般提供予定
参考