
はじめに
AIがソースコードを書いてくれる時代になりました。
自然言語で要件を伝えれば、Webアプリケーションの画面を作り、APIを実装し、データベースのスキーマを定義し、テストコードまで生成してくれます。
エラーが発生すればログを解析し、修正案も提示してくれます。
数年前まで数時間、あるいは数日かかっていた作業が、数分で終わることも珍しくありません。
この変化を見て、次のように考える人もいるかもしれません。
AIがコードを書いてくれるのであれば、プログラミングやソフトウェア設計を深く学ぶ必要はないのではないか。
しかし、実際にはその逆です。
AIがコードを書けるようになったからこそ、人間にはソフトウェア開発を体系的に理解することが、これまで以上に求められています。
AIが生成したコードが正しいかを判断するのは人間です。
その設計が将来の変更に耐えられるか、セキュリティ上の問題がないか、運用時に障害を起こさないか、要件を本当に満たしているかを判断する責任も、人間に残ります。
AIが人間のような文章を書けるようになったからといって、日本語を学ぶ必要がなくなるわけではありません。
むしろ、生成された文章の意味や妥当性を判断するには、読み手側に十分な言語能力が必要です。
ソフトウェア開発も同じです。
AIが書いたコードを評価し、修正し、採用するには、コードの背後にある原理、構造、制約を理解していなければなりません。
AI時代になっても、正確な理解が必要であることは変わりません。
変わったのは、コードを書く速度です。
そしてコードを書く速度が上がった結果、誤った設計や理解不足も、これまで以上の速度でシステムへ組み込まれるようになったのです。
以下は特定のツールの優劣を論じるものではなく、開発の進め方の話です。
また「AIを使うべきでない」という主張でもありません。
むしろ、任せる範囲を広げるほど人間側の理解が要る、という立場で書いています。
適切な線引きは組織の規模や扱うデータの性質によって変わるため、ここに書いたものが唯一の正解というつもりはありません。
AIによって「ソフトウェアを作る人」は増えた
生成AIやAIコーディングエージェントの普及により、ソフトウェア開発への入口は大きく広がりました。
従来、アプリケーションを作るには、プログラミング言語、フレームワーク、データベース、インフラなどを段階的に学ぶ必要がありました。
現在は、AIに次のように指示するだけでも、一定の形を持ったアプリケーションが生成されます。
Next.jsとPostgreSQLを使って、
ユーザー登録とログイン機能を持つ予約管理アプリを作ってください。
AIは、画面、API、データモデル、認証処理などをまとめて提示してくれます。
そのため、これまでプログラミングに触れてこなかった人でも、比較的短期間で動くものを作れるようになりました。
これは非常に大きな進歩です。
ソフトウェア開発が、一部の専門家だけに閉じられた領域ではなくなりつつあります。
一方で、新しい問題も生まれています。
AIによって「ソフトウェアに触る人」は増えましたが、同時に「自分が何を作っているのか十分に理解できていない人」も増えました。
実際、AIを使って開発をしていると、次のような場面に遭遇します。
- コードは動いているが、なぜ動くのか説明できない
- エラーが起きると、AIへの再質問以外に対処方法がない
- AIが提案した複数の設計案を比較できない
- 認証や権限管理が正しく実装されているか判断できない
- ライブラリやフレームワークの責務を区別できない
- 動作確認ができたことを「実装が正しい」と考えてしまう
- 本番環境で発生する性能、可用性、運用上の問題を想像できない
この状態では、AIによって開発速度が上がったように見えても、実際には問題を後工程へ先送りしているだけかもしれません。
「動くコード」と「正しいソフトウェア」は違う
AIによる開発で特に注意すべきなのは、コードが動くことと、ソフトウェアとして正しいことは別であるという点です。
例えば、AIにログイン機能を作らせたとします。
ブラウザ上でメールアドレスとパスワードを入力し、ログイン後の画面へ遷移できれば、一見すると実装は完成したように見えます。
しかし、実際には次のような確認が必要です。
- パスワードは安全な方法でハッシュ化されているか
- セッションIDは安全に管理されているか
- Cookieに適切な属性が設定されているか
- CSRF対策は必要か
- ログイン試行回数に制限があるか
- 権限昇格を防げているか
- ログアウト時にセッションが無効化されるか
- パスワード再設定機能が悪用されないか
- エラーメッセージからユーザーの存在を推測できないか
画面上でログインできるという事実だけでは、これらの問いに答えられません。
同様のことは、データベース設計、API設計、画面設計、インフラ構成にも当てはまります。
AIは、要求された処理を実現するコードを生成することは得意です。
しかし、「その要求自体が適切か」「考慮すべき条件がすべて含まれているか」「長期運用に耐えられるか」まで自動的に保証してくれるわけではありません。
AIは与えられた文脈から最もそれらしい実装を作ります。
言い換えると、与えられていない条件については、AIが都合のよい前提を置いて実装する可能性があるということです。
ソフトウェア開発では、この暗黙の前提が大きな問題になります。
AIは間違える。それ以上に、人間が間違いを見抜けないことが問題になる
AIが誤ったコードを生成することは、よく知られています。
存在しないAPIを利用したり、古いライブラリの書き方を提示したり、不完全な例外処理を生成したりすることがあります。
ただし、本当の問題は、AIが間違えることそのものではありません。
人間が書いたコードにもバグはあります。
より重要なのは、人間がAIの間違いを見抜けない状態で、そのコードを採用してしまうことです。
例えば、AIが次のようなコードを生成したとします。
const user = await db.user.findUnique({
  where: {
    id: request.params.userId,
  },
});

return Response.json(user);
このコードは、指定されたユーザー情報を取得して返しています。
構文上も問題なく、実際に動作するかもしれません。
しかし、次の点は別途確認しなければなりません。
- リクエストを送信した利用者は認証されているか
- 他人のユーザーIDを指定できないか
- 返却してはいけない個人情報を含んでいないか
- 管理者だけが利用できるAPIではないか
- 存在しないユーザーを指定した場合の挙動は適切か
- 入力値を信頼してよいか
- 監査ログが必要ではないか
これらは、コードの見た目だけで自動的に解決される問題ではありません。
認証、認可、データ保護、エラー設計、監査という複数の知識が必要です。
AIが生成した一つの関数を正しく評価するためにも、ソフトウェア開発全体への理解が求められます。
理解不足の本質は「知識がないこと」ではなく「知識が分断されていること」
AIを活用する開発者の中には、多くの用語や技術を知っている人も少なくありません。
React、Next.js、Docker、Kubernetes、REST API、GraphQL、OAuth、JWT、CI/CD、マイクロサービスなど、さまざまな技術について聞いたことがあるかもしれません。
しかし、用語を知っていることと、技術の関係性を理解していることは異なります。
理解不足の本質は、単純に知識量が少ないことではありません。
多くの場合、問題は知識が断片的なまま蓄積されていることにあります。
例えば、次のような知識を個別に持っていたとします。
- HTTPにはGETとPOSTがある
- JWTは認証に使われる
- Dockerを使えば環境を構築できる
- Redisは高速なデータストアである
- CDNを使うとWebサイトが速くなる
しかし、これだけではシステム設計はできません。
重要なのは、それぞれがシステムのどこに位置し、何を解決し、何を解決しないのかを理解することです。
JWTはどこに保存するのか。
トークンの失効はどう扱うのか。
Redisをキャッシュとして使う場合、データの不整合をどう防ぐのか。
Dockerを使ったとしても、データの永続化、秘密情報の管理、ログ収集、監視はどうするのか。
CDNでキャッシュしてよい情報と、キャッシュしてはいけない情報は何か。
個別の技術を知っていても、その接続部分を理解していなければ、安全で保守可能なシステムにはなりません。
ソフトウェアは、複数の部品を組み合わせて作られます。
そして障害や脆弱性の多くは、部品そのものではなく、部品同士の境界や接続部分で発生します。
AIは局所的なコードを生成できても、システム全体の文脈を完全には共有していない
AIは、関数単位、ファイル単位、機能単位のコード生成を得意とします。
一方で、実際のソフトウェア開発では、局所的に正しい実装がシステム全体でも正しいとは限りません。
例えば、ある画面の表示速度を改善するために、AIがデータをキャッシュする実装を提案したとします。
その画面だけを見れば、適切な改善に見えるかもしれません。
しかし、システム全体では次のような問題が起こる可能性があります。
- 更新直後のデータが反映されない
- ユーザーごとの情報が別のユーザーへ表示される
- 権限変更後も古い権限情報が残る
- キャッシュ削除の条件が定義されていない
- 複数サーバー間でキャッシュ状態が一致しない
- 障害時にキャッシュが復旧しない
- キャッシュヒット率を観測できない
キャッシュを入れるという局所的な判断は、データの整合性、認証・認可、分散システム、監視、障害対応に影響します。
AIは、与えられたファイルやプロンプトの範囲では最適な提案をしていても、プロジェクト固有の背景を完全に理解しているとは限りません。
長期間にわたる設計判断、過去の障害、組織上の制約、運用担当者のスキル、法的要件、予算、納期などは、コードだけからは読み取れません。
そのため、人間には「このコードは動くか」だけではなく、次の問いを持つことが求められます。
この実装は、システム全体の設計原則と整合しているか。
AI時代に必要なのは、構文知識よりも判断力である
従来のプログラミング学習では、構文を覚えることが大きな比重を占めていました。
変数の宣言方法、条件分岐、ループ、クラス、関数、例外処理などを学び、正しい構文でコードを書く力が求められていました。
もちろん、現在でも構文知識は必要です。
しかし、AIがコード生成を支援する時代では、構文を記憶していることの相対的な価値は下がっています。
一方で、次のような判断力の価値は高まっています。
- どの処理をどこに置くべきか
- どの責務を分離すべきか
- どのデータを信頼してよいか
- どこで検証すべきか
- どの障害を想定すべきか
- どこまで自動化すべきか
- どの実装をテストすべきか
- 何をログとして残すべきか
- どの部分に将来の変更可能性があるか
- 技術的負債をどこまで許容するか
これらは、コードの書き方ではなく、ソフトウェア設計の問題です。
AIは選択肢を出すことはできます。
しかし、どの選択肢を採用するかは、要件、制約、リスクによって変わります。
唯一の正解が存在しない場面では、設計の背景を理解している人間が意思決定しなければなりません。
ソフトウェア開発を体系的に理解するとは何か
体系的な理解とは、すべての技術を暗記することではありません。
重要なのは、ソフトウェアがどのような層で構成され、それぞれの層がどのような責務を持つかを理解することです。
一般的なWebシステムであれば、少なくとも次の観点を関連づけて考える必要があります。
1. 要求と要件
最初に必要なのは、何を作るかを明確にすることです。
利用者が発した要望を、そのまま実装すればよいとは限りません。
例えば、「管理者がユーザー情報を編集できるようにしたい」という要望があった場合でも、次の点を定義する必要があります。
- 誰を管理者とするのか
- どの情報を編集できるのか
- 編集できない情報は何か
- 操作履歴を残す必要があるか
- 誤操作を元に戻せるか
- 本人への通知が必要か
- 複数の管理者が同時に編集した場合はどうするか
要求を実装可能な条件へ落とし込む作業は、AIだけに任せるべきではありません。
要件が曖昧であれば、AIは曖昧なまま実装します。
そして実装されたコードは、一見すると完成しているため、曖昧さが見えにくくなります。
2. データモデル
ソフトウェアの多くは、データを保存し、読み取り、更新する仕組みです。
データモデルを誤ると、後から画面やAPIだけを修正しても解決できない問題が生じます。
例えば、予約システムであれば、単に予約テーブルを作るだけでは不十分です。
- 予約対象
- 利用者
- 利用期間
- 在庫
- 料金
- 支払い状態
- キャンセル状態
- 変更履歴
- タイムゾーン
- 重複予約の扱い
などを考慮する必要があります。
AIはテーブル定義を生成できますが、現実の業務ルールを正しくデータモデルへ反映できるかは、入力された情報に依存します。
3. アプリケーション設計
アプリケーション設計では、処理をどの単位に分割し、どの層へ配置するかを考えます。
例えば、料金計算のロジックを画面コンポーネントに直接書けば、短期的には動きます。
しかし、API、バッチ処理、管理画面でも同じ計算を使う場合、処理が重複します。
その結果、画面とAPIで異なる料金が計算されるかもしれません。
アプリケーション設計では、次のような責務を整理します。
- 表示
- 入力検証
- ユースケース
- ドメインルール
- データアクセス
- 外部サービス連携
- 認証・認可
- エラー処理
責務の境界を理解していなければ、AIが生成するコードを適切な場所へ配置できません。
4. APIと通信
フロントエンドとバックエンド、サービスとサービスは、通信によって連携します。
ここでは、単にHTTPリクエストを送れるだけでは不十分です。
- タイムアウト
- リトライ
- 冪等性
- バージョニング
- レート制限
- エラー形式
- 認証
- データサイズ
- 部分失敗
- ネットワーク障害
などを考慮する必要があります。
AIが生成するサンプルコードは、正常系だけを扱っていることがあります。
しかし、実際のネットワークは失敗します。
ソフトウェア設計では、失敗を例外的な出来事ではなく、通常起こり得る状態として扱わなければなりません。
5. セキュリティ
セキュリティは、完成後に追加する機能ではありません。
要件、設計、実装、運用のすべてに関係します。
最低限でも、次の観点が必要です。
- 認証
- 認可
- 入力検証
- 出力先の文脈に応じたエンコーディング(必要ならHTMLサニタイズ)
- 秘密情報管理
- 暗号化
- セッション管理
- 依存ライブラリ管理
- 監査ログ
- 脆弱性対応
AIはセキュリティコードも生成できます。
しかし、安全性は一つの関数で決まるものではありません。
システム全体のデータフローと信頼境界を理解しなければ、本当に安全かどうかは判断できません。
6. テストと品質保証
AIがテストコードを生成できるようになったことで、テスト作成の負担は下がりました。
しかし、何をテストするかを決めるのは人間です。
単にコードカバレッジを上げればよいわけではありません。
重要なのは、システムのリスクに応じたテストを設計することです。
- 単体テスト
- 結合テスト
- E2Eテスト
- 性能テスト
- セキュリティテスト
- 障害試験
- 回帰テスト
すべてを同じ粒度で行う必要はありません。
障害が発生した場合の影響が大きい部分を特定し、優先的に検証する必要があります。
AIが生成したテストが、実装内容をそのまま追認しているだけということもあります。
実装と同じ誤った前提に基づくテストでは、品質を保証できません。
7. インフラストラクチャと運用
ローカル環境でアプリケーションが動いたとしても、それだけではサービスとして運用できません。
本番環境では、次の要素が必要になります。
- デプロイ
- スケーリング
- バックアップ
- 障害復旧
- ログ
- メトリクス
- アラート
- 証明書
- DNS
- ネットワーク
- コスト管理
- 権限管理
- 秘密情報の更新
AIはDockerfileやCI/CD設定を生成できます。
しかし、生成された設定が運用要件を満たすとは限りません。
例えば、自動デプロイを導入しても、障害時にロールバックできなければ、本番環境では危険です。
監視を導入しても、何を正常状態とみなすかが定義されていなければ、意味のあるアラートは作れません。
AIに任せる範囲が広がるほど、人間は全体を理解する必要がある
一見すると、AIへ任せる作業が増えれば、人間が理解すべき範囲は減るように思えます。
しかし、実際には逆です。
AIが一つの関数だけを書くのであれば、人間はその関数を確認すればよいかもしれません。
ところが、AIが画面、API、データベース、テスト、インフラまでまとめて生成するようになると、人間はそれらの整合性を確認しなければなりません。
つまり、AIの担当範囲が広がるほど、人間にはより広い視野が必要になります。
AIによる自動化は、人間の責任を消すものではありません。
責任の対象を、個々のコード記述から、設計判断と成果物の評価へ移動させます。
これまでの開発者は、自分で一行ずつコードを書きながら、システムを理解していきました。
AI時代の開発者は、短時間で大量に生成されるコードを読み、全体像を把握し、問題を発見しなければなりません。
これは、単純な作業量の削減ではなく、仕事の性質の変化です。
コード生成の高速化は、技術的負債の生成も高速化する
AIは開発速度を大きく向上させます。
しかし、速度が上がるのは良いコードの生成だけではありません。
重複コード、不適切な抽象化、過剰な依存関係、不十分な例外処理、場当たり的な修正なども高速に生成されます。
例えば、同じような処理をAIへ別々のタイミングで依頼すると、それぞれ異なる方法で実装されることがあります。
- ある画面ではfetchを直接呼ぶ
- 別の画面では専用のAPIクライアントを使う
- ある箇所では例外を投げる
- 別の箇所ではnullを返す
- ある機能では日付をUTCで扱う
- 別の機能ではローカル時刻で扱う
それぞれのコードは単独では動いても、システム全体では一貫性が失われます。
一貫性が失われると、変更時の影響範囲が予測できなくなります。
結果として、短期的には高速に開発できても、中長期的には変更コストが急増します。
このような技術的負債を防ぐには、設計原則やコーディング規約だけでなく、「なぜそのルールが必要なのか」を理解する必要があります。
AIにルールを与えることはできます。
しかし、そのルール自体を設計し、妥当性を維持するのは人間です。
抽象化を理解せずにAIを使うと、不要な複雑性が増える
AIは、既存の設計パターンや一般的なベストプラクティスを提示できます。
一方で、必要以上に複雑な実装を提案することもあります。
小規模なアプリケーションに対して、次のような構成を提案するかもしれません。
- マイクロサービス
- イベント駆動アーキテクチャ
- CQRS
- メッセージキュー
- 分散キャッシュ
- Kubernetes
- 複数段階の抽象化レイヤー
これらの技術は、適切な問題に対して使えば強力です。
しかし、導入するだけでシステムが良くなるわけではありません。
技術には、必ず利点とコストがあります。
マイクロサービスを導入すれば、サービスを独立してデプロイできるようになります。
同時に、ネットワーク障害、分散トランザクション、監視、サービス間認証、バージョン管理などの問題が増えます。
抽象化も同様です。
重複を減らすために抽象化した結果、処理の流れが分かりにくくなり、変更が難しくなることがあります。
重要なのは、「この技術を使えるか」ではありません。
この問題に、この技術を使う必要があるか。
この判断には、技術の仕組みだけでなく、導入後の運用コストまで含めた理解が必要です。
AIに良い指示を出すためにも、知識が必要である
AI活用では、プロンプトの書き方が重要だと言われます。
しかし、良いプロンプトは文章表現の工夫だけでは作れません。
何を指定すべきかを知っている必要があります。
例えば、次の指示を比較します。
ログイン機能を作ってください。
メールアドレスとパスワードによるログイン機能を実装してください。

パスワードはArgon2idでハッシュ化し、
セッションはHttpOnly、Secure、SameSite=Lax属性を持つCookieで管理してください。

ログイン失敗時にはユーザーの存在が推測できない共通メッセージを返し、
一定回数以上の失敗に対してレート制限を実装してください。

認証と認可を分離し、
管理者向けAPIではロールだけでなく対象リソースへのアクセス権限も検証してください。
後者の方が、AIから具体的で安全性の高いコードを得られる可能性があります。
しかし、この指示を書くには、認証、Cookie、パスワードハッシュ、レート制限、認可について理解していなければなりません。
つまり、AIを効果的に使うためにも、対象分野の知識が必要です。
知識がなければ、何を依頼すべきか分かりません。
そして何を確認すべきかも分かりません。
AIは知識を不要にするのではなく、知識を持つ人の生産性を大きく増幅する道具なのです。
AIの回答を何度も修正するだけでは、体系的な理解にはならない
AIと対話を続けることで、目の前の問題を解決できることはあります。
エラーを貼り付け、修正コードを受け取り、再びエラーが出れば再質問する。
この反復によって、最終的にアプリケーションが動くこともあります。
しかし、この方法だけでは、知識が体系化されにくいという問題があります。
エラーごとに対処していると、次のような断片的な理解になりがちです。
- このエラーにはこの設定を追加する
- この場合はuse clientを書く
- このコマンドを実行すると直る
- このライブラリを入れると動く
- この警告は無視してよい
手順を覚えていても、その背後にある原理を理解していなければ、少し条件が変わっただけで対応できなくなります。
例えば、CORSエラーに対してヘッダーを追加する方法だけを覚えても、オリジン、プリフライトリクエスト、Cookie、認証情報付きリクエストの関係を理解していなければ、別の構成では解決できません。
AIとの対話を学習に変えるには、単に答えを受け取るだけでなく、次の問いを持つ必要があります。
- なぜこの問題が起きたのか
- どの層の問題なのか
- この修正は何を変えているのか
- 別の解決方法はあるか
- この方法の副作用は何か
- 同じ原理が使われる別の場面はあるか
- どの前提が変わると、この解決方法は使えなくなるか
このように問題を構造化することで、個別のトラブル対応が再利用可能な知識へ変わります。
AI時代の学習では「縦」と「横」の両方が必要になる
ソフトウェア開発を体系的に理解するには、縦方向と横方向の両方から学ぶ必要があります。
縦方向の理解
縦方向とは、一つの処理がシステム内をどのように流れるかを追うことです。
例えば、ユーザーが予約ボタンを押した場合、次の流れがあります。
- ブラウザが入力を受け取る
- フロントエンドが入力値を検証する
- HTTPリクエストを送信する
- サーバーがユーザーを認証する
- サーバーが権限を確認する
- 業務ルールに基づいて予約可能か判定する
- データベースへ保存する
- 決済サービスやメールサービスと連携する
- 結果をブラウザへ返す
- ログやメトリクスを記録する
この一連の流れを理解すると、問題が発生した際に、どの層を調査すべきか分かるようになります。
横方向の理解
横方向とは、システム全体へ共通して影響するテーマを理解することです。
例えば、次のようなものです。
- セキュリティ
- 性能
- 可用性
- 監視
- テスト
- データ整合性
- コスト
- 保守性
- アクセシビリティ
- 法令遵守
予約機能だけが安全でも、ユーザー管理機能に脆弱性があればシステム全体は安全ではありません。
一つのAPIだけが高速でも、データベース全体がボトルネックになっていれば性能問題は解決しません。
縦方向に処理の流れを理解し、横方向に品質特性を理解することで、ソフトウェアを立体的に捉えられるようになります。
AI時代に重要になる基礎知識
AI時代だからといって、すべての技術を深く学ぶ必要があるわけではありません。
しかし、特定のフレームワークに依存しない基礎知識は、これまで以上に重要になります。
コンピューターの基本
- CPU
- メモリ
- ストレージ
- プロセス
- スレッド
- ファイルシステム
これらを理解すると、性能問題や並行処理の問題を考えやすくなります。
ネットワーク
- IPアドレス
- DNS
- TCP
- TLS
- HTTP
- Cookie
- プロキシ
- CDN
Webアプリケーションの多くの問題は、ネットワークの境界で発生します。
データベース
- トランザクション
- インデックス
- 制約
- 正規化
- ロック
- 分離レベル
- レプリケーション
データベースを単なる保存先として扱うと、整合性や性能の問題を見落とします。
プログラミング
- データ構造
- アルゴリズム
- 型
- 状態
- 副作用
- 例外
- 並行処理
- モジュール化
AIがコードを書いても、コードの性質を理解するにはプログラミングの基礎が必要です。
ソフトウェア設計
- 責務
- 凝集度
- 結合度
- 依存関係
- 抽象化
- 境界
- 不変条件
- 変更容易性
設計の基礎は、特定のフレームワークが変わっても残ります。
セキュリティ
- 信頼境界
- 最小権限
- 多層防御
- 入力を信頼しない
- 秘密情報をコードへ埋め込まない
- 認証と認可を区別する
セキュリティは専門家だけが考えればよい問題ではありません。
コードを生成し、採用する人すべてに関係します。
AIを使わずに学ぶ必要はない
ここまで読むと、「まずすべてを理解してからAIを使うべきだ」と感じるかもしれません。
しかし、そうではありません。
AIを使わずに学習する必要はありません。
むしろ、AIは優れた学習支援ツールです。
分からない概念を別の例で説明させたり、コードの処理を一行ずつ説明させたり、複数の設計案を比較させたりできます。
重要なのは、AIを答えの生成機としてだけ使わないことです。
例えば、コードを生成させた後に、次のように質問できます。
このコードの前提条件を列挙してください。
この実装が失敗するケースを挙げてください。
セキュリティ上の問題がないかレビューしてください。
この設計の代替案を3つ示し、それぞれの利点と欠点を比較してください。
この処理を、ブラウザ、サーバー、データベースの境界に分けて説明してください。
この実装で暗黙的に置かれている前提を説明してください。
初心者が誤解しやすい点を挙げてください。
このような使い方をすると、AIは単なるコード生成器ではなく、理解を深めるための対話相手になります。
まず理解し、次に委譲し、最後に検証する
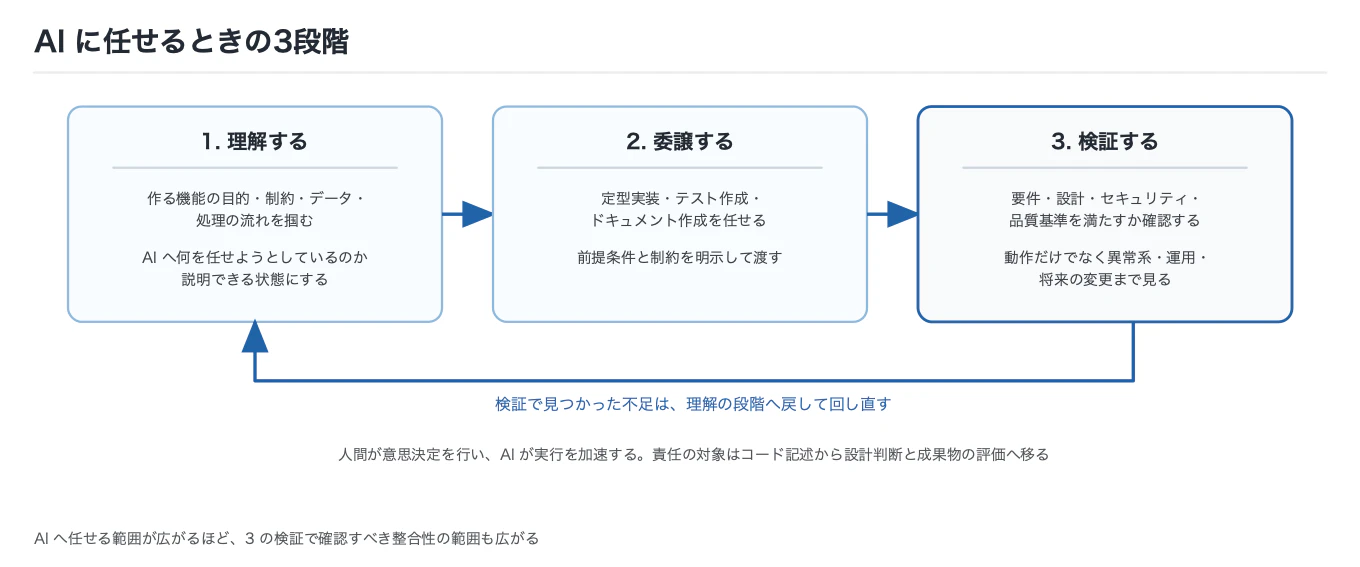
AI時代のソフトウェア開発では、次の三段階が重要です。
テキスト版を開く
1. 理解する
   作る機能の目的・制約・データ・処理の流れを掴む
   AI へ何を任せようとしているのか説明できる状態にする
        ↓
2. 委譲する
   定型実装・テスト作成・ドキュメント作成を任せる
   前提条件と制約を明示して渡す
        ↓
3. 検証する
   要件・設計・セキュリティ・品質基準を満たすか確認する
   動作だけでなく異常系・運用・将来の変更まで見る
        ↓
   見つかった不足は 1. 理解する へ戻して回し直す
1. 理解する
作ろうとしている機能の目的、制約、データ、処理の流れを理解します。
少なくとも、AIへ何を任せようとしているのかを説明できる状態にします。
2. 委譲する
定型的な実装、コード生成、テスト作成、ドキュメント作成などをAIへ任せます。
この段階では、AIが作業しやすいように、前提条件と制約を明確に伝えます。
3. 検証する
生成物が要件、設計、セキュリティ、品質基準を満たしているか確認します。
コードが動いたかだけではなく、異常系、運用、将来の変更まで含めて評価します。
この循環を繰り返すことで、AIの速度と人間の判断力を組み合わせられます。
AIへすべてを任せるのでも、人間がすべてを手作業するのでもありません。
人間が意思決定を行い、AIが実行を加速する関係です。
分からないコードを本番環境へ入れない
AI時代の開発原則として、最も単純で重要なのは次のルールです。
自分たちが説明できないコードを、本番環境へ入れない。
すべての行を暗記する必要はありません。
ライブラリ内部の実装を完全に理解する必要もありません。
しかし、少なくとも次の点は説明できる必要があります。
- 何をするコードなのか
- どの入力を受け取るのか
- どのデータを変更するのか
- どこへ通信するのか
- どのように認証するのか
- 失敗した場合にどうなるのか
- どのようにテストしたのか
- 問題が起きた場合にどう戻すのか
説明できないコードは、制御できないコードです。
制御できないコードに業務や顧客データを預けることはできません。
開発者の価値は「コードを書く量」では決まらなくなる
AIによってコード生成が一般化すると、開発者の価値は、単純なコード量では測れなくなります。
短時間に大量のコードを生成すること自体は、AIにもできます。
人間に求められるのは、より上位の能力です。
- 問題を正しく定義する
- 曖昧な要求を具体化する
- 制約を発見する
- 設計の選択肢を比較する
- リスクを予測する
- 品質基準を定義する
- AIの生成物を評価する
- チームで共有可能な設計へ整理する
- 障害や失敗から学習する
- 技術と事業を接続する
これらの能力は、コードを書かなくても価値があります。
一方で、コードを読み、実装の現実を理解していることが、その判断の精度を高めます。
したがって、AI時代の開発者は、コーディングから離れるのではありません。
コーディングを含むソフトウェア開発全体を理解しながら、より高いレベルの意思決定を担うようになります。
初心者と熟練者の差は縮まるのではなく、別の形で広がる
AIによって、初心者でも見た目の整ったアプリケーションを作れるようになりました。
そのため、初心者と熟練者の差がなくなるように見えることがあります。
しかし、差がなくなるのは、主に最初のコード生成速度です。
要件が変わったとき、障害が起きたとき、利用者が増えたとき、セキュリティ事故が疑われたときには、理解の差が現れます。
熟練者は、問題を層に分け、原因の候補を絞り込み、変更の影響を予測できます。
初心者は、動いていたものがなぜ動かなくなったのか分からず、AIへ無作為に修正を依頼し続ける可能性があります。
AIは両者を支援しますが、基礎知識と経験を持つ人は、より正確な指示を出し、より適切に結果を評価できます。
つまり、AIは能力差を完全に埋めるのではありません。
人間が持つ理解力と判断力を増幅します。
正しい理解を持つ人には、大きな生産性向上をもたらします。
理解が不十分な場合には、誤った判断と技術的負債を高速化する可能性があります。
チーム開発では、共通理解がこれまで以上に重要になる
AIを使うと、個人が短時間で多くのコードを生成できます。
しかし、チーム開発では、個人の速度だけを上げても十分ではありません。
各メンバーが異なる方針でAIへ指示すると、コードベース全体の一貫性が失われます。
例えば、同じプロジェクト内で次のような差が生まれる可能性があります。
- データアクセスの方法が統一されていない
- エラー処理の形式が異なる
- 認可処理の配置場所が違う
- テスト方針が機能ごとに異なる
- 命名規則が揃っていない
- ログに含める情報が統一されていない
AI時代のチームには、詳細なコード規約だけではなく、設計原則と判断基準の共有が必要です。
例えば、次のような事項を明文化します。
- システムの境界
- 各層の責務
- 認証・認可の方針
- データアクセスのルール
- エラー処理の方針
- テスト戦略
- ログと監視の基準
- AI生成コードのレビュールール
- 採用してよいライブラリの基準
- アーキテクチャ上の禁止事項
AIへ渡すプロジェクトルールも、チームの設計知識を反映したものでなければなりません。
ルールをファイルへ書くだけでは不十分です。
チームがその理由を理解していることで、例外的な場面でも適切に判断できるようになります。
AIによるレビューだけでは十分ではない
AIはコードレビューにも利用できます。
バグ、脆弱性、可読性、性能問題などを指摘させることができます。
しかし、AIが生成したコードを別のAIにレビューさせれば、安全性が保証されるわけではありません。
生成とレビューが、同じような前提や学習傾向に基づいている可能性があるからです。
また、AIはプロジェクト固有の業務要件を完全には理解していないことがあります。
例えば、技術的には正しい処理でも、業務上は誤っている場合があります。
- キャンセル期限の判定が契約条件と違う
- 税計算の端数処理が社内ルールと違う
- 個人情報の保存期間が規定と違う
- 管理者権限の範囲が組織ルールと違う
- 監査ログに必要な情報が不足している
AIレビューは有効です。
しかし、人間によるレビュー、テスト、自動解析、運用監視などと組み合わせる必要があります。
品質保証は、一つの手段へ依存するのではなく、複数の防御層を持たせることが重要です。
「AIが作ったから分からない」は理由にならない
ソフトウェアに障害や事故が発生した際、利用者にとって、そのコードを人間が書いたかAIが書いたかは関係ありません。
サービスを提供する側には、成果物に対する責任があります。
個人情報が漏えいした場合に、「AIが生成したコードだったため分かりませんでした」と説明しても、責任を免れることはできません。
決済金額を誤った場合も、予約データを消失した場合も、システムが長時間停止した場合も同じです。
AIは開発手段であり、責任主体ではありません。
AIが生成したコードを採用した時点で、そのコードはプロジェクトの成果物になります。
そのため、AIを利用する組織には、次のような管理が必要になります。
- 生成コードのレビュー
- ライセンスや依存関係の確認
- セキュリティスキャン
- テスト
- 承認プロセス
- 変更履歴
- 本番反映手順
- 障害時の責任分担
AI利用の拡大は、ガバナンスを不要にするのではなく、より重要にします。
体系的な理解は、変化の速い技術に対応するための土台になる
ソフトウェア開発の世界では、新しいフレームワーク、ライブラリ、AIツールが次々に登場します。
特定のツールの使い方だけを覚えても、そのツールが変われば知識が使えなくなることがあります。
一方で、基礎となる概念は長く残ります。
- データはどこに存在するか
- 状態は誰が管理するか
- 処理はどこで実行されるか
- どの境界を越えて通信するか
- 誰を信頼するか
- 失敗時にどう振る舞うか
- 変更の影響をどう限定するか
新しい技術を学ぶ際も、これらの問いを使えば、既存の知識と関連づけられます。
例えば、新しいフレームワークが登場したとき、単にAPIの使い方を覚えるのではなく、次の観点で整理できます。
- どの問題を解決する技術か
- 従来の方法と何が違うか
- どの処理を抽象化しているか
- どの制約が追加されるか
- どの部分は従来と変わらないか
- どのような場面には向かないか
体系的な理解を持つ人は、新しい技術をゼロから学ぶ必要がありません。
既存の地図の中へ、新しい技術を配置できます。
これからのソフトウェア開発者に必要な姿勢
AI時代のソフトウェア開発では、すべてを自分で書くことに価値があるわけではありません。
同時に、AIが生成したものを無条件に受け入れることにも価値はありません。
必要なのは、AIを使いながら、理解と責任を手放さないことです。
そのためには、次の姿勢が重要です。
分からないことを、そのままにしない
コードが動いたとしても、重要な部分が理解できていなければ確認します。
正常系だけで判断しない
入力が不正な場合、外部サービスが停止した場合、通信が途中で切れた場合などを考えます。
技術を目的にしない
新しい技術を使うことではなく、解決すべき問題を中心に考えます。
前提を明文化する
AIにも人間にも、暗黙の前提を共有させないようにします。
小さく検証する
AIが大量のコードを生成できても、一度にすべてを採用せず、段階的に確認します。
判断の理由を残す
なぜその設計を選んだのかを記録し、将来の変更時に参照できるようにします。
基礎へ戻る
問題が複雑になったときほど、HTTP、データ、状態、責務、境界といった基本へ戻ります。
まとめ
AIによって、ソフトウェア開発は確実に変わりました。
コードを書く速度は上がり、開発への参入障壁は下がり、個人でも大規模な機能を作れるようになっています。
これは大きな機会です。
しかし、AIがコードを書いてくれることと、人間がソフトウェアを理解しなくてよいことは同義ではありません。
むしろ、AIによって生成されるコード量と変更速度が増えたからこそ、人間には全体を見渡す力が必要です。
必要なのは、すべてのコードを自力で書く能力だけではありません。
- 何を作るべきかを定義する力
- システムを構造として理解する力
- 設計の良し悪しを比較する力
- リスクや失敗を予測する力
- AIの生成物を検証する力
- 結果に責任を持つ力
これらの能力が、AI時代のソフトウェア開発者には求められます。
AIは、理解の代替ではありません。
AIは、理解を持つ人の能力を拡張するものです。
AIに頼る前にすべてを暗記する必要はありません。
しかし、AIに任せる対象が何であり、生成されたものをどのように評価するかは理解しなければなりません。
AIがソフトウェアを書ける時代だからこそ、ソフトウェア開発を体系的に学ぶ価値は高まっています。
そして今後、開発者の力を分けるのは、どれだけ速くコードを書けるかではありません。
AIが高速に生み出すコードと選択肢に対して、どれだけ正確な判断を下せるかです。
参考
本記事は筆者の考えをまとめたものですが、本文で挙げた具体的な確認項目については、次の資料を土台にしています。
それぞれ、記事のどの部分に対応するかを添えます。
セキュリティの確認項目
- OWASP Top 10 — 「動くコード」と「正しいソフトウェア」は違うで挙げた、認可漏れや設定不備の分類。
- OWASP Cheat Sheet Series — 実装時の確認項目を分野別にまとめた一覧。
- OWASP: Password Storage Cheat Sheet — プロンプト例で指定したArgon2idなど、パスワード保存方式の根拠。
- OWASP: Authorization Cheat Sheet — 他人のIDを指定できてしまう問題(認可漏れ)の考え方。
- NIST SP 800-63B-4: Authentication and Authenticator Management — 認証方式、ログイン試行の制限、セッション管理の基準。旧版の SP 800-63-3 は2025年8月1日付で置き換えられています。なお主たる対象は米国政府機関で、一般のWebサービスにそのまま適用される基準ではありません。
- IPA: 安全なウェブサイトの作り方 — 日本語で読める実装上の注意点の定番資料。
- MDN: Web security — Cookie属性や信頼境界など、ブラウザ側の仕様。
設計・品質・運用
- Martin Fowler: Technical Debt — 技術的負債を「速度と引き換えに将来へ回した支払い」として捉える整理。
- Martin Fowler: The Practical Test Pyramid — テストの粒度をリスクに応じて配分する考え方。
- The Twelve-Factor App(日本語) — 設定、ログ、依存関係など、運用へ渡す前に決めておく項目。
- Google: Site Reliability Engineering — 監視、アラート設計、障害対応を「何を正常とみなすか」から考える視点。
なお、これらは一般に参照される資料であり、本記事の主張そのものを保証するものではありません。