
1.はじめに
港湾空港技術研究所から公開されているブシネスクモデルによる波浪変形計算プログラム、NOWT-PARI Ver.4.6 のFortranプログラムをAIで並列化しました。
2.環境準備
2.1.Visual Studio のインストール
Visual Studio 2026 を ダウンロードしてインストールしてください(自分は、Visual Studio 2022 を使ってます)
2.2.Intel oneAPI のインストール
Intel oneAPI Base Toolkit を ダウンロードしてインストールしてください。
2.3.NOWT-PARI Ver.4.6 をダウンロード
港湾空港技術研究所 のサイトで公開されている(2026/11/02現在)、bsnsq46d8a_r1.zip をダウンロードしてください。解凍後、以下のファイルを、AIで使うプロジェクトフォルダ直下に(PGM\ や data\asase\ のフォルダは付けずに)コピーして下さい
PGM\bsnsq46d8a_r1.f
PGM\bsq_bsq46c8a_r1_og.inc
PGM\rgn_bsq46c8a_r1.inc
PGM\wav_bsq46c8a_r1.inc
data\asase\calcnd_d
data\asase\spectdat.in
コピー後のプロジェクトフォルダ直下は、bsnsq46d8a_r1.f, bsq_bsq46c8a_r1_og.inc, rgn_bsq46c8a_r1.inc, wav_bsq46c8a_r1.inc, calcnd_d, spectdat.in となります
bsq_bsq46c8a_r1_og.inc
は
bsq_bsq46c8a_r1.inc
へリネームしてください
以下のフォルダはフォルダのままプロジェクトフォルダにコピーして下さい
data\
bathymetry\
3.AI による改造
以下は Codex への指示となります。こちらの指示は黄色のブロック、Codex の回答・質問は緑色のブロックです。
3.1.プロジェクトを作成
Codex でプロジェクトを作成し、上記プロジェクトフォルダを追加してください。以下、このプロジェクトでやり取りしてください。
3.2.ルール指示
以後、Fortranソースのコンパイルは
C:\Program Files (x86)\Intel\oneAPI\setvars.bat
で環境変数を設定後、ifx で行ってください
また、MPIは
C:\Program Files (x86)\Intel\oneAPI\mpi\latest
のIntel MPIを使用して下さい
一時的に作成するソースなどは、こちらの依頼へのアクションごとに作業フォルダを作成しそこに保存するようにしてください
こちらの依頼とその回答は履歴.mdに追記して下さい
3.3.メモリの動的確保
bsnsq46d8a_r1.f ですが
インクルードファイル
bsq_bsq46c8a_r1.inc
rgn_bsq46c8a_r1.inc
wav_bsq46c8a_r1.inc
で定義されているパラメータを
calcnd_d の先頭行で定義し、静的に確保されたメモリは動的に確保するように修正してください
calcnd_d へ挿入する先頭行の書式は'(4I10)'で、IMAX JMAX LDM NN を保存してください
225 185 5000 1024
修正ファイルは、bsnsq46d8a_r1a.f へ保存してください
3.4.Fortran 2003
Fortran文法は現在Fortran77ですが、Fortran2003へ変換してください
インデント字下げは4文字
改行はしない
で一度整形してください
その後、120桁を超える行のみ改行してください
(I, J) などの途中で折り返す箇所は読みにくいので
括弧の浅い位置を優先して折り返すようにしてください
修正ファイルは、bsnsq46d8a_r1b.f90 へ保存してください
3.5.MPIで並列化
MPIで並列化したいと考えています
並列効率が最も高いものを求めています
プロセス数は50くらいを考えています
物理コア数56個メモリ768GBのマシンで、将来1000x1000を想定しています
ソースコードを調査し最も優れた並列化方式を提案してください
候補方式の比較
| 方式 | 通信・メモリ | 数値結果への影響 | 評価 |
|---|---|---|---|
| 全配列複製+計算線分配 | 全場の反復配布が重い | 逐次解法を維持しやすい | 試作向け |
| 方向ごとの帯分割+転置 | X/Y切替で大きな再配置 | 逐次解法を維持しやすい | 比較候補 |
| 固定2次元分割+係数集約・Thomas法 | 係数と解を移動 | 比較基準に適する | 検証・代替経路向け |
| 固定2次元分割+省略なし分散直接法 | ハローと小さな境界連立系が中心 | 消去順による丸め差あり | 50 MPIランクの推奨 |
| PDD/DistD2系 | 条件成立時は通信をさらに削減 | 近似誤差の検証が必要 | 将来の高速経路 |
| 少数MPI+OpenMP | MPI通信回数を減らせる | スレッド競合への対処が必要 | 単一マシンで有力 |
固定2次元分割+省略なし分散直接解法
での改造をお願いします
I・J方向の分割数(NPX,NPY)は、calcnd_d の1行目
'(6I10)'で、IMAX JMAX LDM NN NPX NPY
で指定出来るようにして下さい
NPX NPY のいずれかがゼロまたはブランクなら
NPX NPY は IMAX JMAX から自動計算してください
自動計算では、可能な限り NPY が大きくなるようにしてください
ファイル名は bsnsq46d8a_r1c.f90 としてください
4.動作確認
動作確認は物理コア数56個メモリ768GBのPCで行いました
4.1.コンパイルオプション
MPI設定と、浮動小数点モデルの設定が必要です
| 設定 | 値 |
|---|---|
| Fortran > General > Additional Include Directories | C:\Program Files (x86)\Intel\oneAPI\mpi\latest\include\mpi;C:\Program Files (x86)\Intel\oneAPI\mpi\latest\include |
| Fortran > Floating Point > Floating Point Model | Source (/fp:source) |
| Linker > General > Additional Library Directories | C:\Program Files (x86)\Intel\oneAPI\mpi\latest\lib |
| Linker > Input > Additional Dependencies | impi.lib |
浮動小数点モデルはデフォルトで「fast」ですが、これだと計算結果の再現性が保証されません。「fast」以外に変更してください。今回は「source」にしました。
4.2.実行方法
実行フォルダに、実行ファイル、calcnd_d(1行目を追加したもの)、spectdat.in、bathymetry\、data\ を置き、コマンドプロンプトで次のように実行します(-np の後はプロセス数)。
mpiexec -np 12 bsnsq46d8a_r1c.exe
4.3.計算ケース
同梱されたサンプル「球面浅瀬沖側の一様水深からの計算その2」で行いました
A)修正前プログラムで計算
B)修正プログラム bsnsq46d8a_r1c.f90 で計算
ただし、プロセス数を1,2,4,8,12,16,24,36,48,56で計算
4.4.計算結果
出力ファイルはすべてのプロセス数で、修正前のプログラムの結果と完全に一致しました。
以下は、横軸に修正プログラムのMPIプロセス数、縦軸は修正前の計算時間を修正プログラムの計算時間で割った速度比です。計算時間は、出力ファイル fd と cwavg1 の更新時刻の差(時間積分にかかった時間)としました。
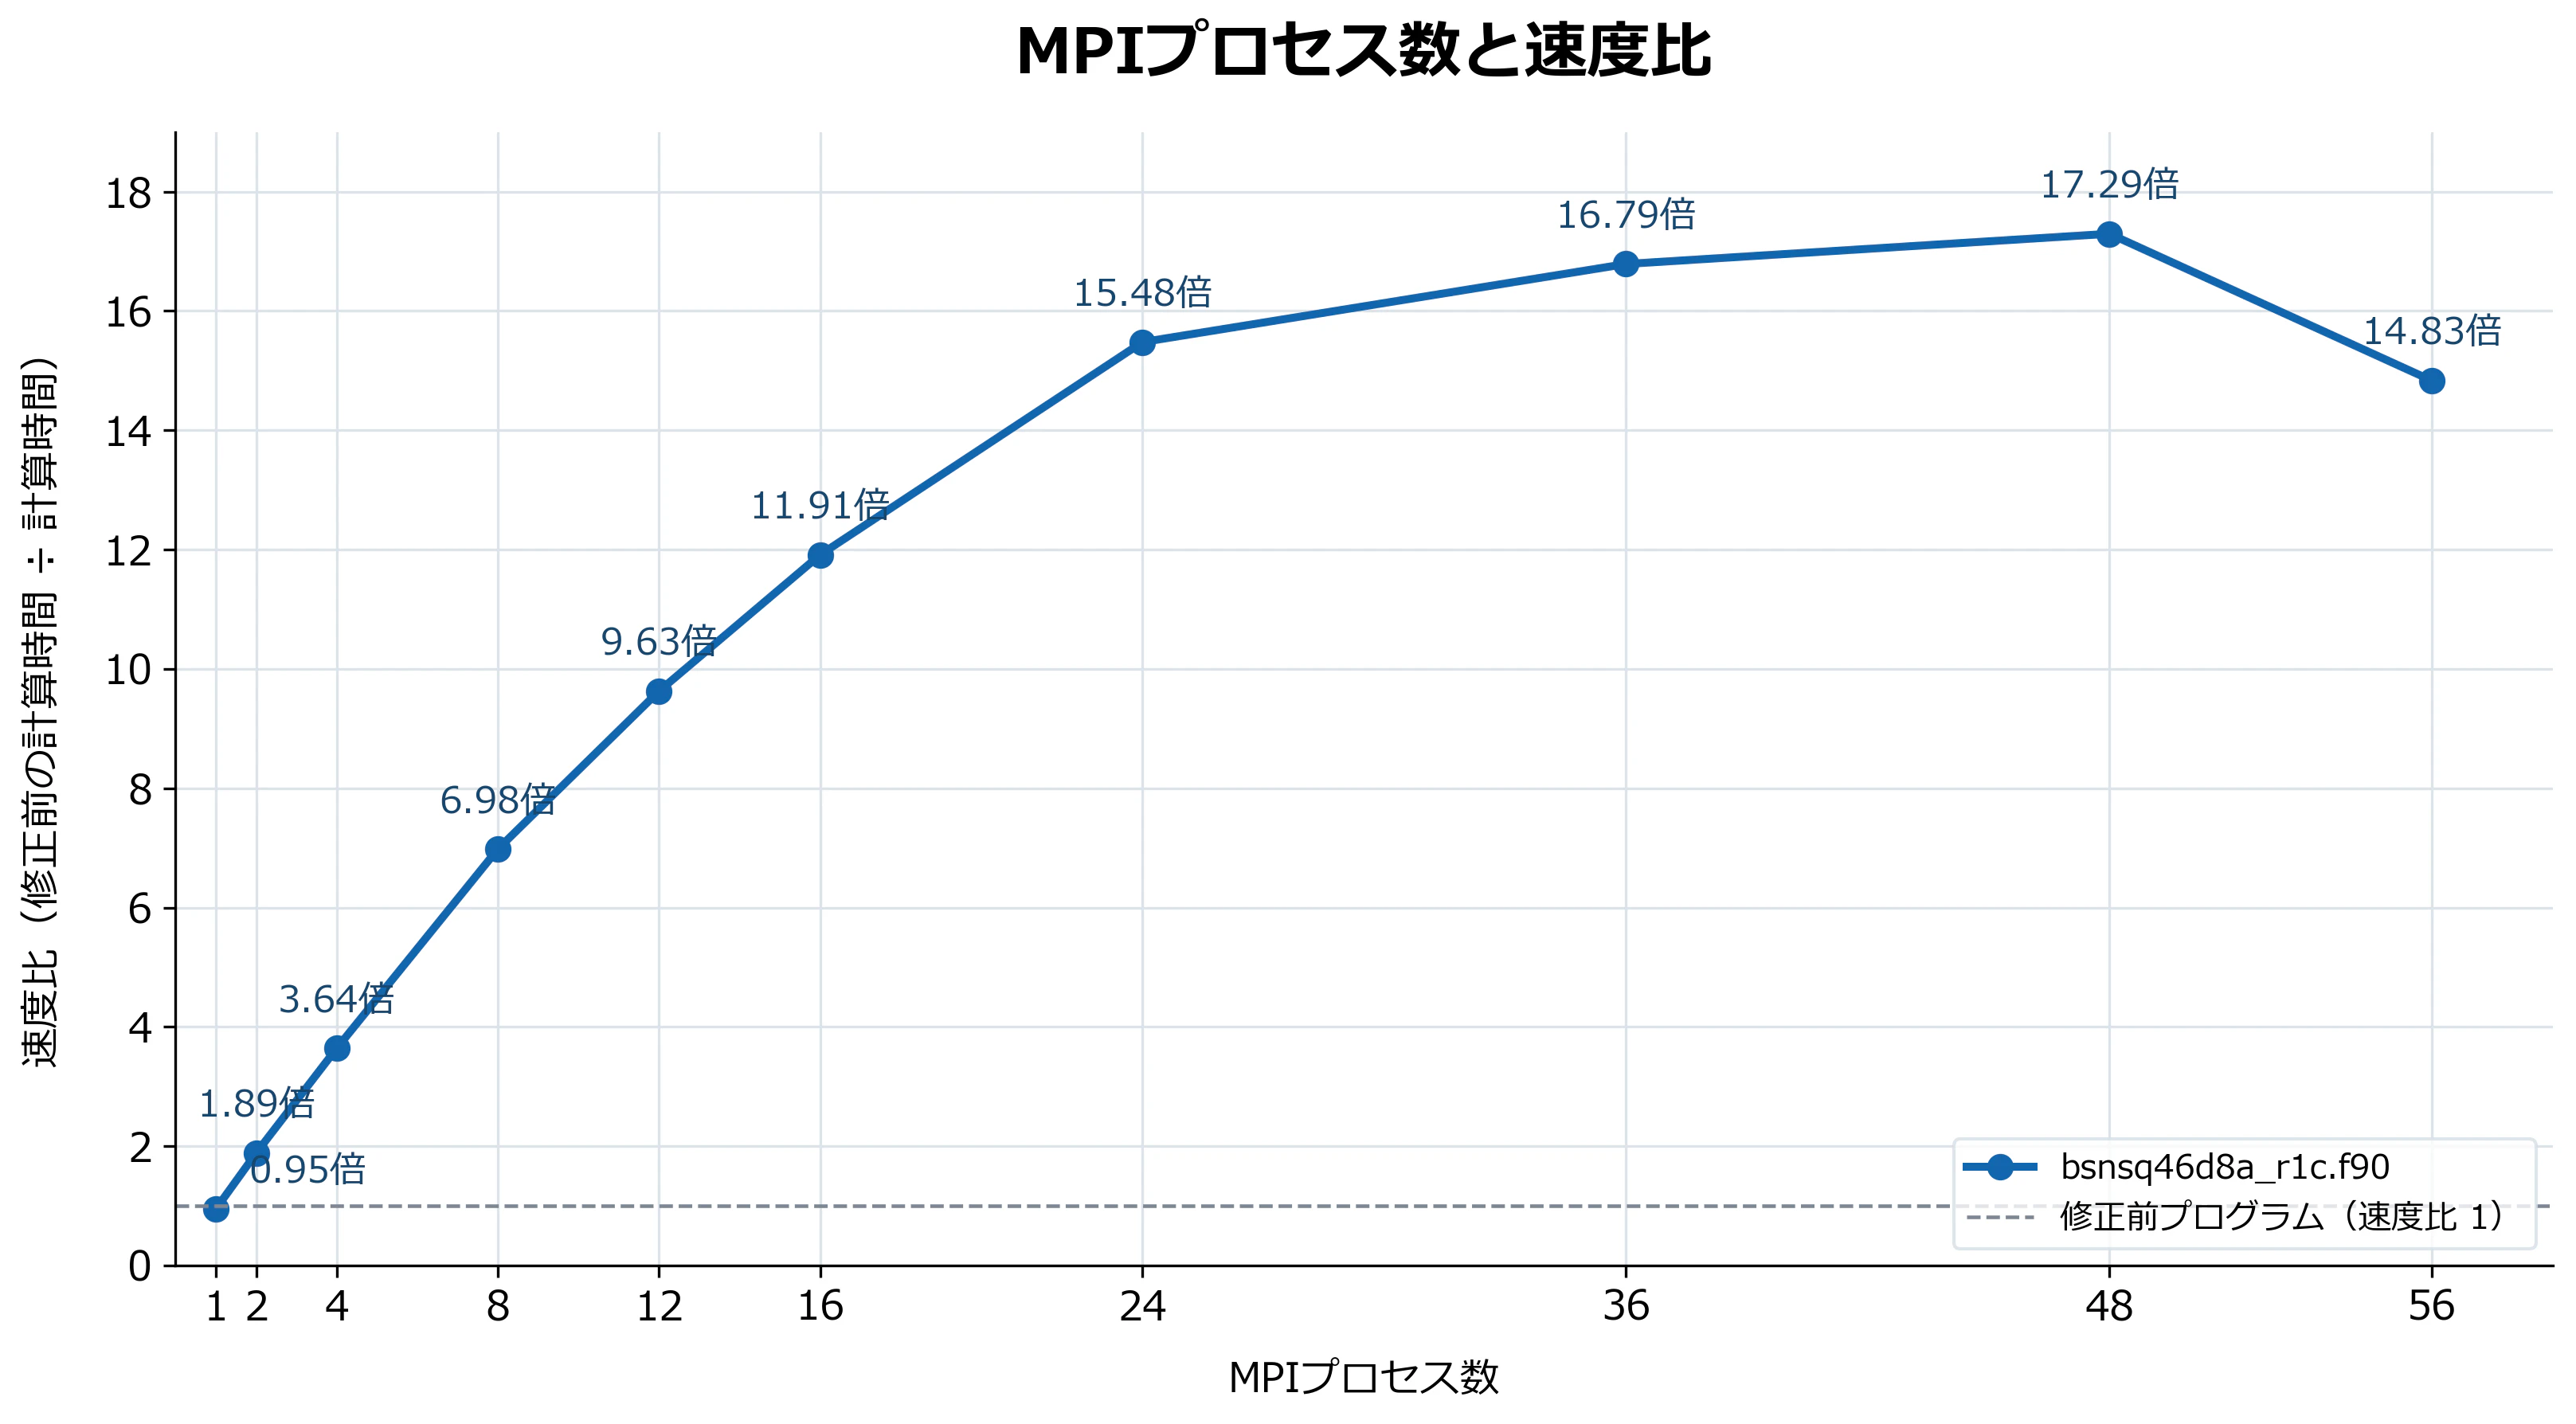
プロセス数56で速度比が落ち込んでいます
この計算ケースのJ方向格子数は185しかないため、185÷56≒3.3と1プロセスに割り当てるJ方向の幅が小さくなったためと思われます。