
こんにちは!最近転職したニシグチです!
今回はQiitaの記事を参考にAWS サーバレスの基本サービスについて学んでいきたいと思います。
はじめに
- 参考記事が2024年12月時点のものなので、現在2026年7月時点で差分がある内容は適宜変更していきます。
参考にした記事
今回はこちらの記事を参考にしました。
非常に丁寧に手順がまとまっており、AWS初心者でもサーバレス構成を実際に触りながら学べる内容でした。
この記事で書くこと・書かないこと
書くこと
- 実際にハンズオンを進めた流れ
- 作業中に理解したAWSサービス同士のつながり
- 詰まったところと解決方法
- 初学者目線で分かりにくかったポイント
書かないこと
- 参考記事と同じ画面操作の詳細な再掲
- AWSアカウントの作成方法
- 各AWSサービスの網羅的な説明
作った構成の概要
今回作成した構成は、API Gateway でHTTPリクエストを受け取り、Lambdaを実行し、LambdaからAmazon Bedrockを呼び出して生成AIの応答を取得し、その結果をDynamoDBに保存する構成です。
ざっくりした流れは以下です。
使用したAWSサービス
- Amazon API Gateway
- AWS Lambda
- Amazon Bedrock
- Amazon DynamoDB
実際に進めた流れ
ここからは、参考記事に沿って実際にAWS上でサーバレス構成を作成していきます。
手順の詳細は参考記事にまとまっているため、この記事では作業の流れと、進める中で理解したポイントを中心に整理します。
1. Lambda関数を作成する
リージョンは東京で進めていきます。
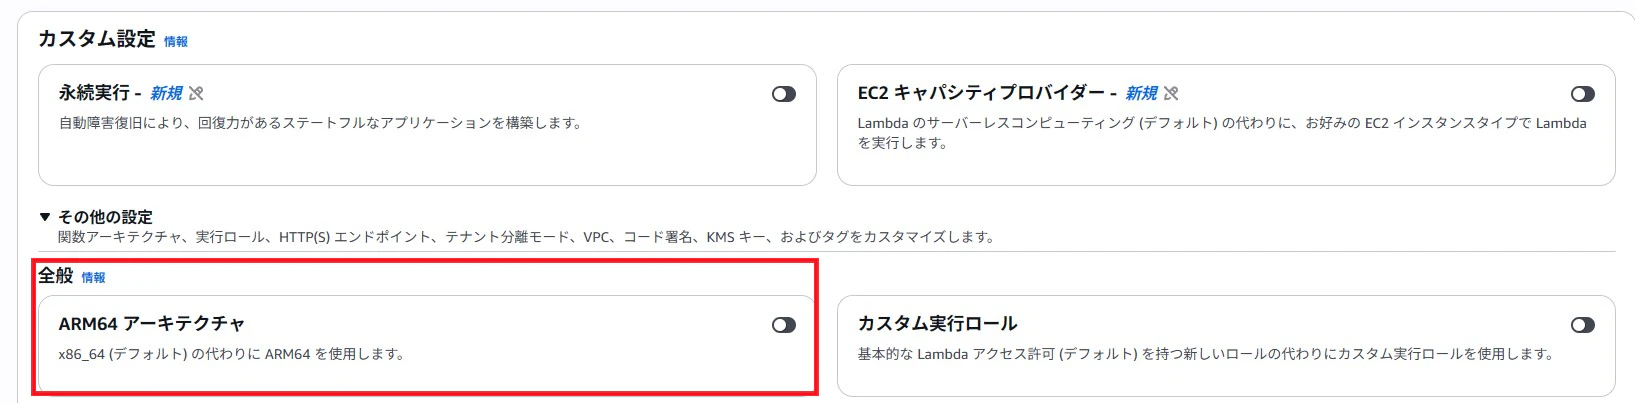
アーキテクチャの選択は今現在少しUIが変わっており、その他の設定をクリックすると設定画面が表示されますが、ここはデフォルトでx86_64になっているので特に弄らずそのまま作成します。(変数名、ランタイムは参考記事の通り進めました)

作成完了。

- 作成後、テストを実行
- タイムアウト時間を1分へ変更
- Lambdaの実行ロールに「AmazonBedrockFullAccess」ポリシーをアタッチ
2. LambdaからBedrockを呼び出す
次に、LambdaからAmazon Bedrockを呼び出し、生成AIの応答を取得できるようにしました。
やったこと
LambdaでBedrockを呼び出すPythonコードに編集し、Deploy押下。
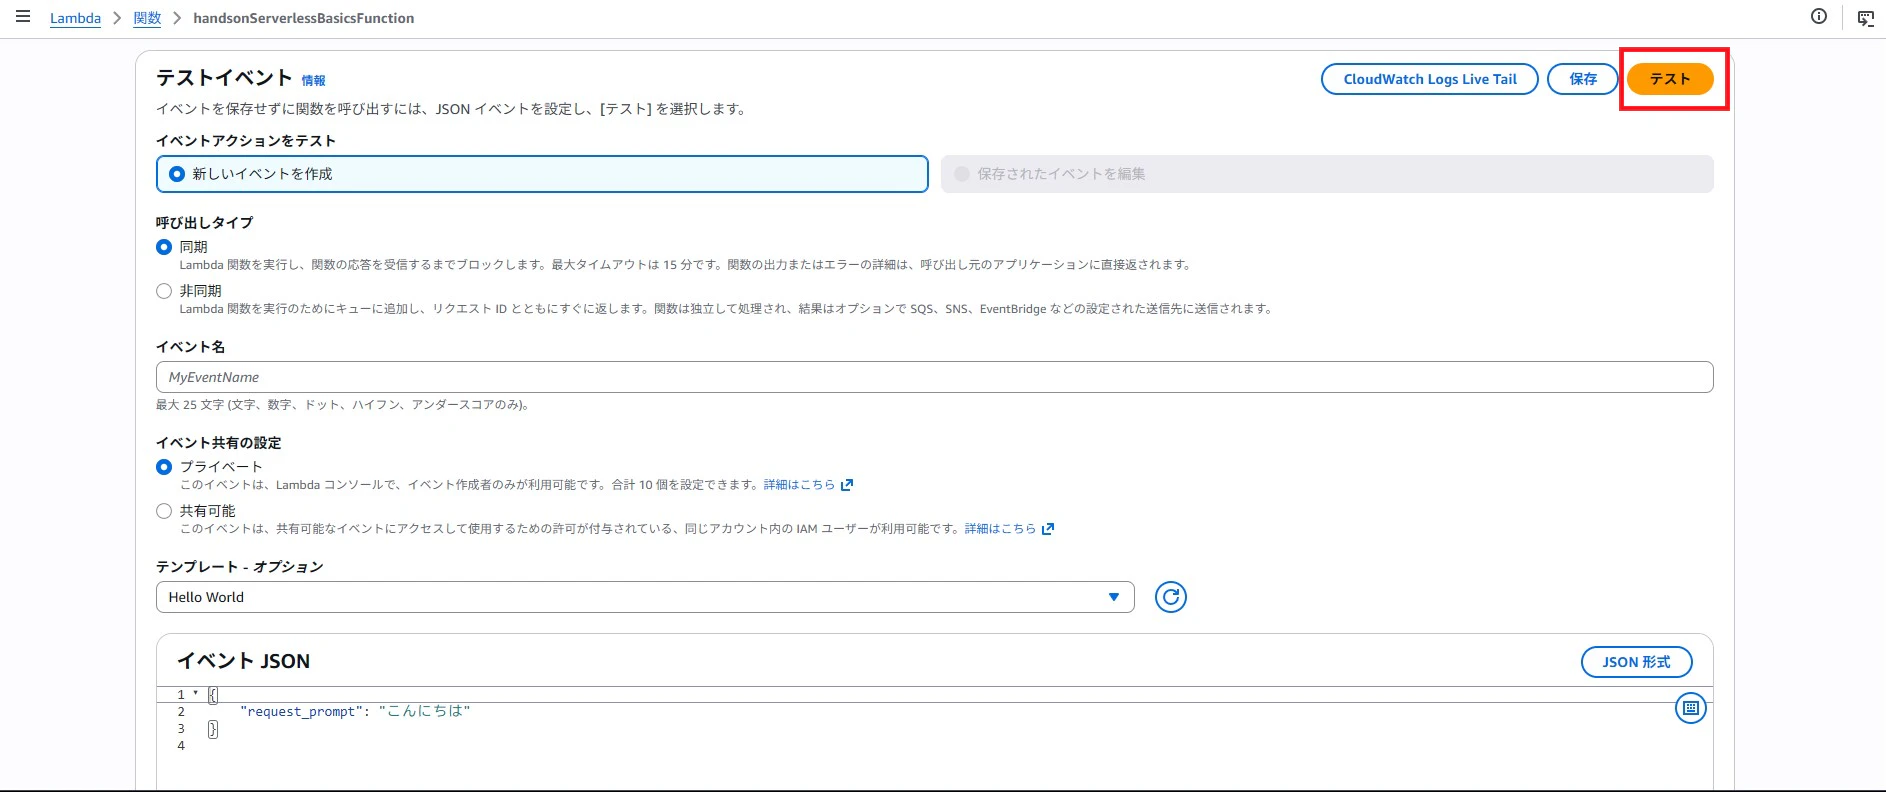
テストでイベントJSONを変更し、テスト押下。
発生したエラー
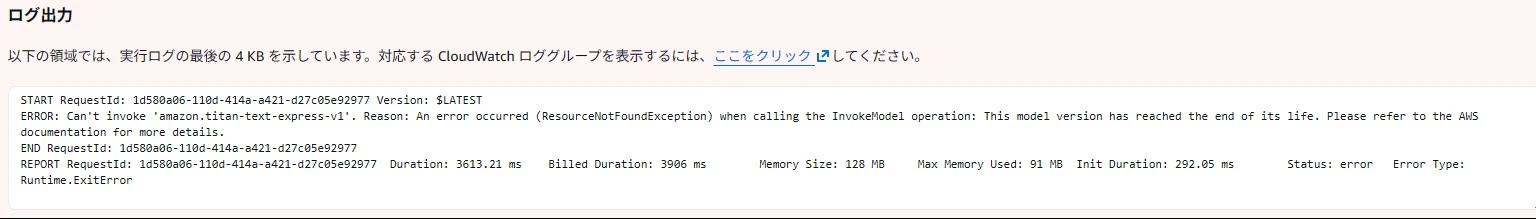
ハンズオンではここでモデルアクセスエラーとなる予定なのですが、
以下のエラーが出力されました。
ERROR: Can't invoke 'amazon.titan-text-express-v1'. Reason: An error occurred (ResourceNotFoundException) when calling the InvokeModel operation: This model version has reached the end of its life. Please refer to the AWS documentation for more details.
原因
どうやら2026年7月現在では、amazon.titan-text-express-v1がサポート終了しているみたいです。
エラーメッセージ見てから公式ドキュメントモデルのライフサイクルに目を通したけど多分合ってるはず。。。(該当するモデルIDが完全一致しなかったから本当かちょっと不安)
追記(2026/07/09)
モデルのライフサイクルのページをよく読んだら以下の記載がありました。 検索にヒットしなかったのはそういうことでした。
やはり今回エラーメッセージが出てたモデルはサポート終了してたみたいです。
不安で本当に間違ってないかコンソールからも確認しました。

対応
LambdaでBedrockを呼び出すPythonコードを以下に変更しました。
変更点:
- モデルIDをTitanからAmazon Novaに変更(
amazon.titan-text-express-v1→amazon.nova-micro-v1:0) - 呼び出し方式をInvoleModel APIからConverse APIへ変更しました
import boto3
import json
from botocore.exceptions import ClientError

def lambda_handler(event, context):
    request_prompt = event["request_prompt"]

    # Bedrockから回答を取得
    output_text = callBedrock(request_prompt)

    # 回答をユーザーに返却
    return {
        "statusCode": 200,
        "body": output_text,
    }

def callBedrock(request_prompt):
    # Amazon Bedrock Runtime clientを作成
    brt = boto3.client("bedrock-runtime", region_name="us-west-2")

    # 現在の主力モデル(Amazon Nova Micro)
    # リージョン(us-west-2)用の推論プロファイルIDを指定します
    model_id = "us.amazon.nova-micro-v1:0"

    # Converse API用のメッセージ構造(ロールとコンテンツのペア)
    messages = [
        {
            "role": "user",
            "content": [{"text": request_prompt}]
        }
    ]

    # 推論パラメータの設定(Converse API共通の構造)
    inference_config = {
        "maxTokens": 512,
        "temperature": 0.5,
        "topP": 0.9
    }

    try:
        # invoke_modelではなく、converse APIを呼び出し
        response = brt.converse(
            modelId=model_id,
            messages=messages,
            inferenceConfig=inference_config
        )

    except (ClientError, Exception) as e:
        print(f"ERROR: Can't invoke '{model_id}'. Reason: {e}")
        return f"Error: {e}"

    # レスポンスの解析(Converse APIは共通フォーマットなので直感的に抽出可能)
    response_text = response["output"]["message"]["content"][0]["text"]
    print(f"{response_text=}")

    return response_text
コード修正後、Deploy押下。
再度、テストを押下。
無事Amazon Bedrockからのレスポンスが返ってきました。
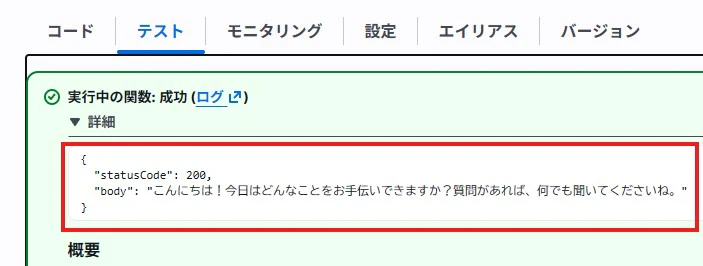
Bedrockを使うのは初めてですが、これでBedrockを通してプロンプトを基盤モデルであるAmazon Novaに投げて推論させて答えさせることが出来ました。
理解したこと
- Bedrockではモデルにプロンプトを渡す時に使うAPIがInvole ModelとConverse APIがある
- Invoke Modelではモデルごとにパラメータが違うため、モデル変更時にコードの書き換えが必要になってくる
- Converse APIはすべてのモデルで共通なのでモデルIDを変えるだけでよい
- 1回限りの特殊な推論とかじゃない限り、基本的にはConverse APIでよさそう
補足
2026年7月時点ではモデルアクセスページにて利用するモデルを手動でいちいち選択しなくても自動的に有効化されるらしいです。

Model access page has been retired
Serverless foundation models are now automatically enabled across all AWS commercial regions when first invoked in your account, so you can start using them instantly. You no longer need to manually activate model access through this page. Note that for Anthropic models, first-time users may need to submit use case details before they can access the model. For models served from AWS Marketplace, a user with AWS Marketplace permissions must invoke the model once to enable it account-wide for all users.Account administrators retain full control over model access through IAM policies and Service Control Policies to restrict access as needed. Learn more
To get started, simply select a model from the Model catalog and open it in the playground or invoke the model using the InvokeModel or Converse API operations. Review our documentation for the complete list of available models.
モデルアクセスページは廃止されました
サーバーレス・ファウンデーション・モデルは、アカウント内で初めて呼び出された時点で、すべてのAWS商用リージョンにおいて自動的に有効化されるようになったため、すぐに利用を開始できます。このページから手動でモデルアクセスを有効にする必要はなくなりました。なお、Anthropicのモデルについては、初めて利用するユーザーは、モデルにアクセスする前にユースケースの詳細を提出する必要がある場合があります。AWS Marketplaceから提供されるモデルの場合、AWS Marketplaceの権限を持つユーザーがモデルを1回呼び出すことで、アカウント内のすべてのユーザーに対してモデルが有効になります。
アカウント管理者は、IAMポリシーおよびサービス制御ポリシーを通じてモデルへのアクセス権を完全に管理し、必要に応じてアクセスを制限できます。詳細はこちら
ご利用を開始するには、モデルカタログからモデルを選択してプレイグラウンドで開くか、InvokeModelまたはConverse API操作を使用してモデルを呼び出すだけです。利用可能なモデルの完全なリストについては、ドキュメントをご確認ください。
3. LambdaからDynamoDBに実行結果を保存する
やったこと
前の手順で、LambdaからAmazon Novaを呼び出し、生成AIのレスポンスを取得できるところまで確認しました。
次に、取得したレスポンスをDynamoDBに保存する処理を追加しました。
今回のハンズオンでは、以下のような情報をDynamoDBに保存します。
- 実行ID
- ユーザーからの入力内容
- Bedrockから返ってきたレスポンス
- 実行日時
コードにDynamoDBのテーブルにレスポンス内容を登録する処理を追加。
テスト実行。(DynamoDBへのアクセス権限エラー出るのでAmazonDynamoDBFullAccess_v2を付与)
テーブル確認してみたところ、実結果が登録されてました。

補足
AmazonDynamoDBFullAccessは非推奨らしいのでAmazonDynamoDBFullAccess_v2をポリシーアタッチしました。(ハンズオンをやっていくうえでは特に問題ないのでどちらでもよい)
4. API GatewayとLambdaを連携してREST APIを作成する
やったこと
- API Gatewayの作成(REST APIで)
- Lambda関数のコード修正
- ブラウザからAPI呼び出し
作成時AWSマネジメントコンソールの画面UIの差分ありましたが、
基本的な設定に変化ありませんでした。参考記事の手順で問題なく確認できました。
5. リソース削除
最後にハンズオンで作成したリソースを削除しました
- API Gateway
- DynamoDB
- IAMロール(Lambdaに使用した)
- Lambda
詰まったところ
最初のLambdaからBedrock呼び出すコード作成する時に、
モデルIDがサポート終了していて現在では動作しなかったので、
APIをInvoke ModelからConverse APIに変更する時、コーディングで少し手間取りました。
やってみて理解できたこと
- LambdaからBedrockを通じた基盤モデルへのプロンプトの渡し方
- DynamoDBへのテーブル登録方法
- API Gatewayとの統合方法
まとめ
AWSのサーバレス構成のハンズをやったのは初めてでした。
Bedrockも含まれていてこれから使うにあたって足がかりになれたのは良かったです。
やはりハンズオンで手を動かしてサービスを使ってみるのは分かりやすいですね!
次はもうちょっと踏み込んだ内容をやってみたいと思います!