

Difyのセルフホスト版でAgentsのベータ版が使えるようになりました。

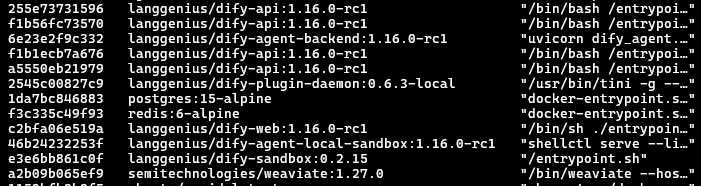
セルフホスト版なのでDockerで起動しています。Agent用のサンドボックスのコンテナも起動しているのでその中で動作するようです。
DifyのSkillは、SKILL.mdを含む50MB以下の.zipまたは.skillファイルとして登録できます。Skillには手順だけでなく、Pythonスクリプトも同梱できます。
Skillの構成は次のとおりです。csv-sales-report.zipとして保存します。
csv-sales-report/
├── SKILL.md
└── scripts/
    └── analyze_sales.py
SKILL.mdは以下のように作成しました。
---
name: csv-sales-report
description: CSV形式の売上データを集計し、商品別・担当者別の集計結果をMarkdownレポートとして作成する。CSVの列は date, product, person, quantity, unit_price を想定する。
---

# CSV売上集計レポート Skill

## 目的

ユーザーから渡されたCSVファイルを集計し、読みやすいMarkdownレポートを作成する。

## 使用条件

次の場合にこのSkillを使用する。

- ユーザーがCSVの売上集計を依頼した場合
- CSVに `date`, `product`, `person`, `quantity`, `unit_price` の列がある場合
- 商品別・担当者別・日別の売上を確認したい場合

必要な列が不足している場合は、処理を続けず、不足している列名をユーザーへ伝える。

## 実行手順

1. 対象のCSVファイルのパスを確認する。
2. `scripts/analyze_sales.py`を次の形式で実行する。

```bash
python scripts/analyze_sales.py "<入力CSVのパス>" "<出力Markdownのパス>"
```

実行例:

```bash
python scripts/analyze_sales.py "/workspace/sample_sales.csv" "/workspace/sales_report.md"
```

3. コマンドの終了コードを確認する。
4. エラーの場合は、エラーメッセージを要約してユーザーへ伝える。
5. 成功した場合は、生成されたMarkdownファイルを読み、次を確認する。
   - 総売上金額
   - 総販売数量
   - 商品別集計
   - 担当者別集計
6. ユーザーへの回答では、主要な結果を簡潔に示し、生成したMarkdownファイルも提供する。

## 出力要件

レポートは次の構成にする。

1. 集計概要
2. 商品別集計
3. 担当者別集計
4. 注意事項

金額は整数の円表記とし、3桁区切りにする。

## 制約

- 元のCSVファイルは変更しない。
- 数値として解釈できない値がある行は無視せず、エラーとして報告する。
- 存在しないデータを推測して補完しない。
- 集計結果を回答する前に、生成されたレポートの内容を確認する。
analyze_sales.pyは以下で作成しました。
from __future__ import annotations

import csv
import sys
from collections import defaultdict
from decimal import Decimal, InvalidOperation
from pathlib import Path

REQUIRED_COLUMNS = {"date", "product", "person", "quantity", "unit_price"}


def parse_decimal(value: str, field: str, row_number: int) -> Decimal:
    try:
        return Decimal(value.strip())
    except (InvalidOperation, AttributeError):
        raise ValueError(
            f"{row_number}行目の {field} が数値ではありません: {value!r}"
        )


def yen(value: Decimal) -> str:
    return f"{value.quantize(Decimal('1')):,.0f}円"


def main(input_path: str, output_path: str) -> None:
    source = Path(input_path)
    destination = Path(output_path)

    if not source.is_file():
        raise FileNotFoundError(f"入力CSVが見つかりません: {source}")

    by_product: dict[str, dict[str, Decimal]] = defaultdict(
        lambda: {"quantity": Decimal("0"), "sales": Decimal("0")}
    )
    by_person: dict[str, dict[str, Decimal]] = defaultdict(
        lambda: {"quantity": Decimal("0"), "sales": Decimal("0")}
    )

    total_quantity = Decimal("0")
    total_sales = Decimal("0")
    row_count = 0

    with source.open("r", encoding="utf-8-sig", newline="") as f:
        reader = csv.DictReader(f)
        columns = set(reader.fieldnames or [])
        missing = REQUIRED_COLUMNS - columns
        if missing:
            raise ValueError(
                "必要な列が不足しています: " + ", ".join(sorted(missing))
            )

        for row_number, row in enumerate(reader, start=2):
            product = (row["product"] or "").strip()
            person = (row["person"] or "").strip()
            if not product:
                raise ValueError(f"{row_number}行目の product が空です")
            if not person:
                raise ValueError(f"{row_number}行目の person が空です")

            quantity = parse_decimal(row["quantity"], "quantity", row_number)
            unit_price = parse_decimal(row["unit_price"], "unit_price", row_number)
            sales = quantity * unit_price

            total_quantity += quantity
            total_sales += sales
            by_product[product]["quantity"] += quantity
            by_product[product]["sales"] += sales
            by_person[person]["quantity"] += quantity
            by_person[person]["sales"] += sales
            row_count += 1

    lines = [
        "# 売上集計レポート",
        "",
        "## 集計概要",
        "",
        f"- データ件数: {row_count:,}件",
        f"- 総販売数量: {total_quantity:,.0f}",
        f"- 総売上金額: {yen(total_sales)}",
        "",
        "## 商品別集計",
        "",
        "| 商品 | 販売数量 | 売上金額 |",
        "|---|---:|---:|",
    ]

    for product, values in sorted(
        by_product.items(), key=lambda item: item[1]["sales"], reverse=True
    ):
        lines.append(
            f"| {product} | {values['quantity']:,.0f} | {yen(values['sales'])} |"
        )

    lines.extend([
        "",
        "## 担当者別集計",
        "",
        "| 担当者 | 販売数量 | 売上金額 |",
        "|---|---:|---:|",
    ])

    for person, values in sorted(
        by_person.items(), key=lambda item: item[1]["sales"], reverse=True
    ):
        lines.append(
            f"| {person} | {values['quantity']:,.0f} | {yen(values['sales'])} |"
        )

    lines.extend([
        "",
        "## 注意事項",
        "",
        "- 売上金額は `quantity × unit_price` で計算しています。",
        "- 金額は1円単位に丸めて表示しています。",
        "",
    ])

    destination.parent.mkdir(parents=True, exist_ok=True)
    destination.write_text("\n".join(lines), encoding="utf-8")
    print(f"レポートを作成しました: {destination}")


if __name__ == "__main__":
    if len(sys.argv) != 3:
        print(
            "使用方法: python analyze_sales.py <input.csv> <output.md>",
            file=sys.stderr,
        )
        sys.exit(2)

    try:
        main(sys.argv[1], sys.argv[2])
    except Exception as exc:
        print(f"エラー: {exc}", file=sys.stderr)
        sys.exit(1)
サンプルの売上データはsample_sales.csvで用意しました。
date,product,person,quantity,unit_price
2026-07-01,センサーA,田中,3,12000
2026-07-01,制御基板B,佐藤,2,28000
2026-07-02,センサーA,佐藤,5,12000
2026-07-03,モーターC,田中,1,45000
2026-07-03,制御基板B,鈴木,3,28000
2026-07-04,モーターC,鈴木,2,45000
「エージェントを作成」からエージェントが作成できます。
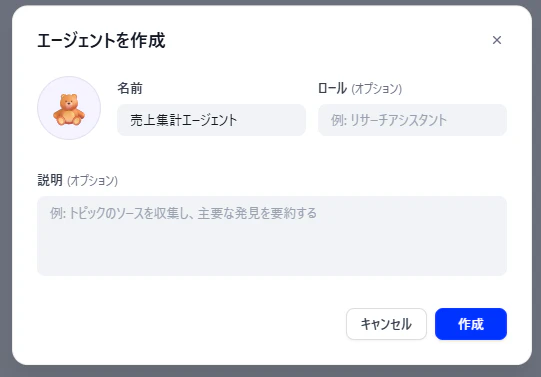
モデルは、OpenAI API経由でGPT-5.5を利用しました。AmazonBedorockやGeminiのAPIも試しましたが上手く実行できませんでした。
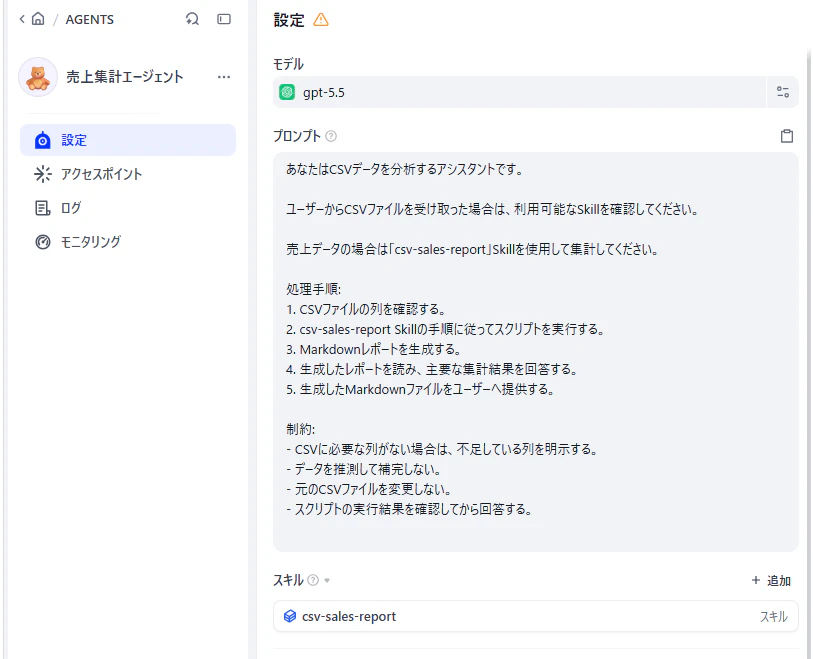
プロンプトは役割やタスクの内容を記載します。
あなたはCSVデータを分析するアシスタントです。

ユーザーからCSVファイルを受け取った場合は、利用可能なSkillを確認してください。

売上データの場合は「csv-sales-report」Skillを使用して集計してください。

処理手順:
1. CSVファイルの列を確認する。
2. csv-sales-report Skillの手順に従ってスクリプトを実行する。
3. Markdownレポートを生成する。
4. 生成したレポートを読み、主要な集計結果を回答する。
5. 生成したMarkdownファイルをユーザーへ提供する。

制約:
- CSVに必要な列がない場合は、不足している列を明示する。
- データを推測して補完しない。
- 元のCSVファイルを変更しない。
- スクリプトの実行結果を確認してから回答する。
スキルに作成したcsv-sales-report.zipをアップロードします。「更新を公開」で作成完了です。
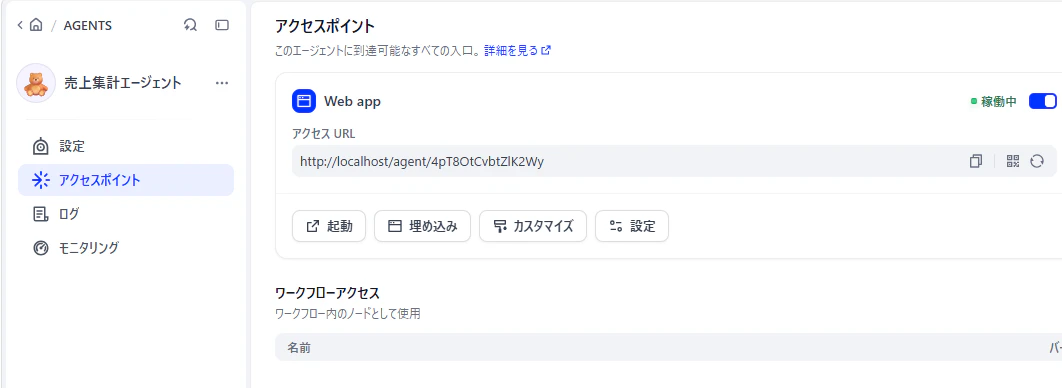
左メニューの「アクセスポイント」からアプリケーションのURLが確認できます。
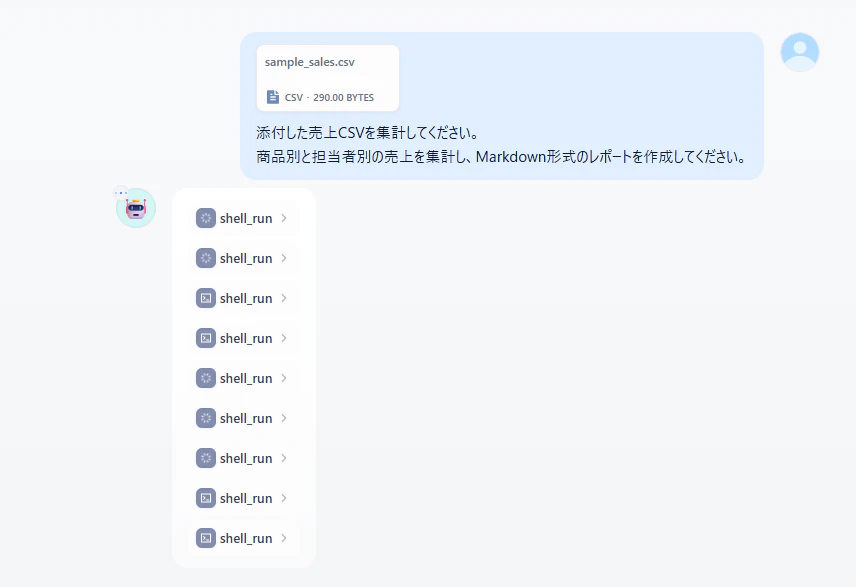
アプリケーションを起動しエージェントに指示と売上データsample_sales.csvを渡し仕事を依頼します。エージェントはサンドボックス内で動作しスキルを呼び出し仕事をこなします。

サンドボックス内でコマンドを実行しエージェントが仕事している様子が確認できます。
エージェントが仕事の結果を表示してくれました。

まだベータ版の機能ですがDifyの可能性が更に広がりそうです。