
はじめに
TypeSafe AI の「Jev」をプロダクトの1機能として導入してみたのでプラクティスを共有します。
個人開発している語学帳アプリの採点機能に Jev を使ってCEFR レベルをスコアリングしていきます。
TL;DR
- 採点ロジックをLLMから判定=Jev、計算=コード、添削文=LLM に分離
- 採点のブレは 5 点満点で 0.01 点(≒ 0.2%)。応答は中央値 249ms
- コストは 1,000 回で 25 円 → 7 円に改善
課題:なぜJevを導入したか
採点ロジックは点数が正しいかよりブレないかが重要です。
Jev 導入前は LLM でスコアリングしていましたが、以下の課題がありました。
| 課題 | 具体的に |
|---|---|
| 点がブレる | temperature を下げてお手本を見せても止まらない |
| 点が粗い | 0〜5 で頼むと 3 と 4 に集中する。2.6 と 3.1 の差が出ない |
| 遅い | 5 観点を別々に聞くと 5 往復。まとめると観点同士が引っ張り合う |
Jev には Choice / Score / Noul という 3 種類の質問の型があります。Score は段階の採点基準を渡すと判定を連続値で返します。
しかも複数の観点を 1 回の往復でまとめて聞けるので3つとも一気に解決出来ました。
作ったもの
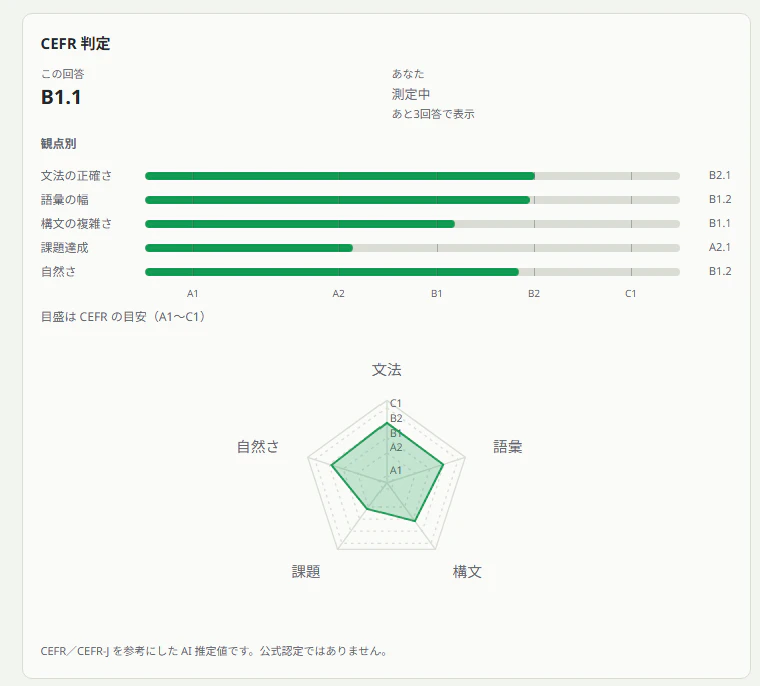
英作文のお題に答えると次の 5 つの観点で採点してレベル判定する機能を作りました。
文法の正確さ / 語彙の幅 / 構文の複雑さ / 課題達成 / 自然さ
実際の画面です。レーダーチャートのほかに今回の回答レベルと現在のレベルを表示します。(回答数が溜まるまでは「測定中」)
設計
方針として「判定=Jev、CEFRレベル変換=コード、解説文=LLM」と役割分担を設けました。
CEFRレベル変換は加重平均で算出しています。機械的に決まる処理なので LLM ではなくコードでロジックを組みます。
const res = await jev.systemOne({
  model: "jev-1.13.0",
  input: { task: taskPrompt, answer: answerText },
  primitives: [
    { type: "score", name: "grammar_accuracy",     rubric: RUBRIC.grammar },
    { type: "score", name: "vocabulary_range",     rubric: RUBRIC.vocabulary },
    { type: "score", name: "syntactic_complexity", rubric: RUBRIC.syntax },
    { type: "score", name: "task_achievement",     rubric: RUBRIC.task },
    { type: "score", name: "naturalness",          rubric: RUBRIC.naturalness },
  ],
});

// 合計とレベル変換は必ずコードでやる
const total = weightedSum(res.scores);
const level = toLevel(total);
その他の工夫として採点(Jev)と添削(LLM)を別APIに分離してます。
採点側は Jev の爆速応答によって早くユーザーが視認できるようになります(= UX 向上)。
実測してみた
CEFR の各レベル相当のAIによる固定回答を1 レベルあたり 5 問、計 30 件用意。
1 件につき 10 回ずつで合計 300 回流しています。
以下の数字はすべて同じログから出しています。
レベル順に点が並ぶか
| レベル | 件数 | 平均 | 標準偏差 | 最小 | 最大 |
|---|---|---|---|---|---|
| A1 | 50 | 0.86 | 0.103 | 0.66 | 0.99 |
| A2 | 50 | 1.79 | 0.127 | 1.60 | 1.96 |
| B1 | 50 | 3.09 | 0.102 | 2.90 | 3.22 |
| B2 | 50 | 4.13 | 0.130 | 3.91 | 4.35 |
| C1 | 50 | 4.63 | 0.086 | 4.51 | 4.78 |
| C2 | 50 | 4.84 | 0.052 | 4.72 | 4.89 |
5 問すべてで A1 から C2 まで一度も逆転せずに上がりました。
レベル間の間隔も見てみます。
| レベル間 | 間隔 | 分布の重なり |
|---|---|---|
| A1 - A2 | 0.93 | なし |
| A2 - B1 | 1.30 | なし |
| B1 - B2 | 1.04 | なし |
| B2 - C1 | 0.50 | なし |
| C1 - C2 | 0.21 | あり |
C1 と C2 は分けられませんでした。
上級者はどの観点も満点近くに張り付きます。
同じ回答を 10 回投げたらどれだけブレるか
本題です。30 件それぞれ 10 回分のブレを見ます。
| 指標 | 実測 |
|---|---|
| 標準偏差の平均(30 件) | 0.0105 |
| 標準偏差の最大 | 0.0215 |
| 最大値と最小値の差(平均) | 0.032 |
| 最大値と最小値の差(最大) | 0.070 |
5 点満点で平均 0.01 点のブレです。LLM ではここまで安定しませんでした。
なお 10 回とも完全に同じ値になった回答は 1 件もありません。
Jev は決まった答えを返す仕組みではありません。あくまで「ほとんど動かない」だけなので注意が必要です。
観点ごとに分けるともう少し動いています。
| 観点 | 標準偏差の平均 |
|---|---|
| 文法の正確さ | 0.0166 |
| 語彙の幅 | 0.0181 |
| 構文の複雑さ | 0.0190 |
| 課題達成 | 0.0194 |
| 自然さ | 0.0211 |
観点単位では 0.02 前後ブレます。5 つを重み付けして合計すると 0.0105 まで小さくなりました。バラバラの方向に揺れた分が打ち消し合うためです。
速さ
300 回分の応答時間です。
| 項目 | 実測 |
|---|---|
| 中央値 | 249ms |
| 90 パーセンタイル | 419ms |
| 95 パーセンタイル | 580ms |
| 最大 | 1,956ms |
| 300ms 以内に収まった割合 | 300 回中 236 回(79%) |
おおむね 0.25 秒前後なので回答した瞬間に点が出ます。ときどき 1 秒を超えますが添削文を待つのに比べれば体感は問題ありませんでした。
つまずいたところ
①「短くて正しい文」が満点になってしまう
I like apples. のような短くて単純で間違いのない文が高得点になってしまいました。
原因は採点基準の書き方です(「文法的に正しいか」とだけ指示していたため)
採点基準を 「何を測るか」から「どの難しさに挑んだ上での達成か」 に変更して解決しました。
以下は同じお題に対して単純な文(S)と複雑な文(C)を書き分けた結果です。
| お題 | 単純な文 (S) | 複雑な文 (C) | 差 |
|---|---|---|---|
| Q1 | 1.68 | 2.37 | +0.70 |
| Q2 | 1.87 | 2.70 | +0.83 |
| Q3 | 1.87 | 2.08 | +0.21 |
| Q4 | 1.66 | 2.32 | +0.66 |
| Q5 | 1.98 | 2.25 | +0.28 |
| 平均 | +0.54 |
どのお題でも複雑な文のほうが高くなりました。張り付きは解消です。
②スコアが動かなくてもレベル表示は動く
ブレは 0.01 点以内なのにレベル不一致が 30 件中 2 件でした。
スコアは安定してもレベル判定が変わる課題です。
| 回答 | 揺れたレベル | 点の幅 |
|---|---|---|
| A2 帯のある回答 | A2.1 ⇄ A2.2 | 1.88 〜 1.91 |
| C2 帯のある回答 | C1 ⇄ C2 | 4.72 〜 4.77 |
どちらも点がレベルの境目のほぼ真上に乗っています。
学習者から見れば「同じ文なのに昨日と違うレベルが出た」状態。
対策としてレベル変化の判定に「行き」と「帰り」で条件をズラしました。境目でバタつかない作りにしています。
③モデルのバージョンは固定しましょう
Jev を本番で使うなら必須です。
最新版を指す指定のままだと中身が入れ替わった日に全員の点がズレます。過去の記録と比べられなくなるので学習アプリとしては致命傷です。jev-1.13.0 のように固定しました。
そのうえで基準セットを流して前回と同じレベルが出るかをチェックするスクリプトを用意しました。
壊れたときどうするか
一番避けるべきは機能停止より誤表示です。以下のフォールバック処理を入れてます。
確信度(confidence)は Jev が返す値です。判断がバラついていると低くなります。先の 300 回(延べ 1,500 観点)で非表示になったのは 45 件(3%) でした。
採点と添削を別 API に分けた理由のひとつです。採点が落ちても添削は出せるのでUXを損ないません。
費用の話
| 1 回あたり | |
|---|---|
| Jev で採点 | 約 0.7 銭 |
| LLM に点を出させる | 約 2.5 銭 |
| 音声認識 | 0 円(スマホの機能を使用) |
Jev は返すものが数値だけなので出力側の費用がかかりません。
以前は LLM のコスト懸念で採点回数に上限をつけていました。今は練習と採点を無料にしています。そもそもユーザーが付いていないので杞憂ですが
ちなみに今回の検証 300 回にかかった費用は 2 円ほどです。気軽に 10 回ずつぶん回せるのも Jev の利点ですね。
公開前にやった手続き
個人開発で地味に面倒な手続きです。
TypeSafe AI へデータを送信する旨の記載が必要になりますので忘れずにやりましょう。
- プライバシーポリシーに第三者提供先として明記
- App Store Connect の App Privacy に申告
- Google Play のデータ セーフティに申告
まとめ
判断の切出が可能ならプロダクト導入でもJevは有効。ただし、あくまでAIなのでコードで組めるならロジックはコードで組むべき。
文章のブレは許容できますが、今回のようなスコア判定でのブレは許容できません。
性質の違う 2 つを当初 LLM だけでやろうとしてスコアがぶれていましたが、Jev を導入して役割を分けたことで解決しました。
スコアリングに LLM を使っているなら Jev 導入を検討するのはアリかと思います。
さいごに
今回 Jev を組み込んだ語学帳アプリ Chunkbook を開発しました。
自分が読んだ文章や見た動画から単語・フレーズを登録して問題形式で復習できるアプリです。
App Storeで公開中です。
紹介した採点機能は「今日の1問」と「瞬間スピーキング」で使えます。
練習と採点は無料で使えるので試しに使ってみてください!
ここまで読んでいただきありがとうございました。