
はじめに
Jevをきっかけに高速に意思決定を行うモデルが注目を浴びてますね。
StrandsAgentsも独自モデルとしてStrands Deciderをリリースしました。
Strands Deciderを手元の端末ではなく、どうやってAWS上で動かすべきか、真っ先に頭に浮かんだのはAmazon Bedrock AgentCoreです。
しかし結論から話すと今回AgentCoreでの駆動に失敗しました。
なぜ失敗したのか、代替案として何があるのか調査したので、その内容を記述したいと思います。
やりたいこと/ゴール
- Strands Decider 2BをAWS上のリソースで起動する
Strands Deciderとは
Strands Deciderは、文章を自由に生成するチャットモデルではなく、与えられたstateについて型付きの意思決定を返すモデルです。たとえば「請求、技術、営業のどの窓口に送るか」「緊急か」「重要度を段階評価するか」を、choice、noul、scoreという質問型で表現します。返答には選択結果だけでなく、候補ごとの確率等も含まれます。
Strands Deciderのinference guide
StrandsDeciderを動かすために必要な条件
今回のcheckpointを動かすために確認した条件は次の通りです。
- モデル本体とbase model: Decider checkpointのほかに、Qwen3.5-2B-Baseの重みが必要です。サイズは約4.57 GBでした
-
推論環境: Linux上でPython、PyTorch、Transformersと
strands-deciderを動かします。今回のCUDA依存はPyTorch 2.7.1 / CUDA 12.8、flash-linear-attentionとcausal-conv1dです。
CUDA系列をdockerイメージに含めるとイメージサイズが重くなる傾向があり、素直な全部盛りdokcerイメージを作成すると約7.4 GiBとなりました。コンテナ内に同梱するとAgentCoreのイメージサイズ上限を超えるため、実行時のローカルディスクに分散しました。 - GPU: GPU利用は絶対条件ではありません。GPUを使う場合は、CUDA対応PyTorch、ホストdriver library、コンテナからのGPU device可視性、Deciderが必要とするCUDA kernelとの整合性担保、等の満たすべき条件が複数あります
Amazon Bedrock AgentCoreを利用した構成案
Amazon Bedrock AgentCore Instancesとは
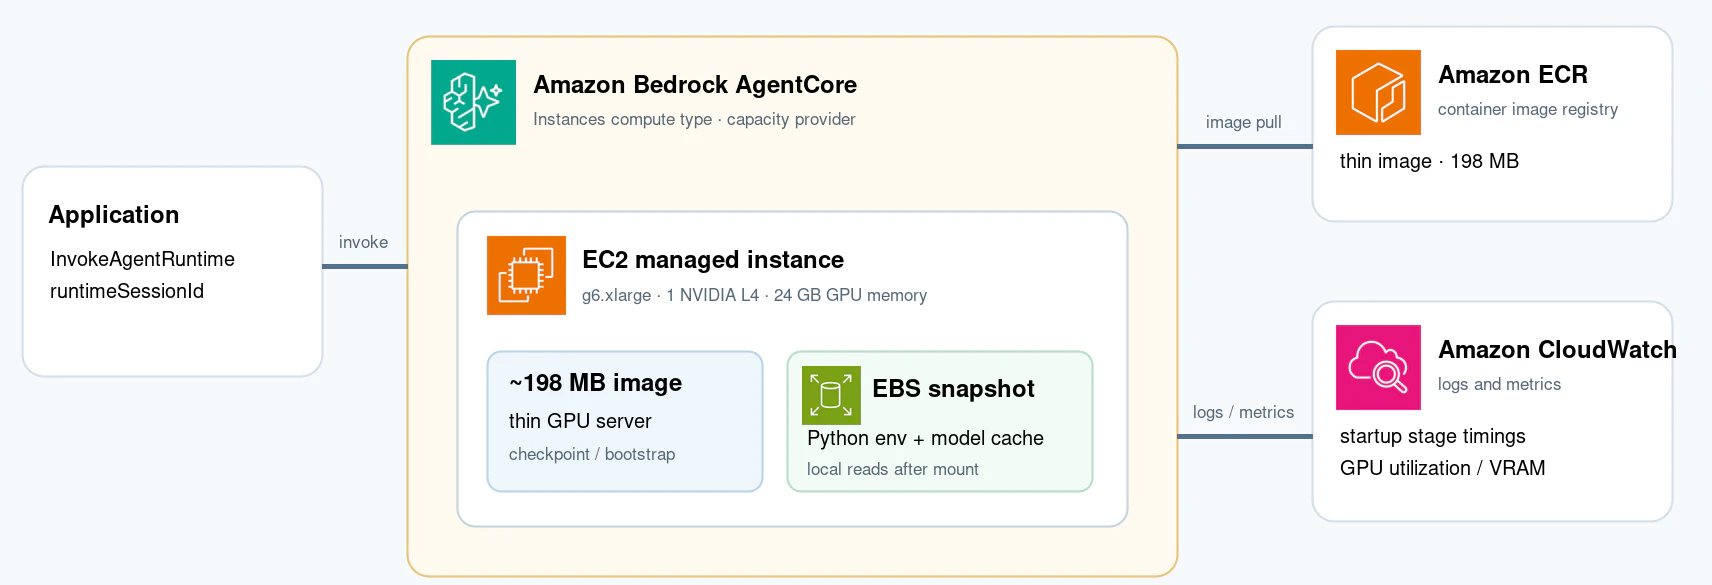
AgentCore RuntimeのInstances compute typeは、capacity providerで指定したEC2構成を使い、AgentCore Runtime sessionをAWS管理のEC2上で実行します。session IDとcapacity providerの組み合わせごとに異なるインスタンスを利用して処理する点が特徴的です。
Runtime Instancesのセキュリティモデル
アンマネージドサービスの代表例であるEC2なので、マシンの顧客管理が求められるのではないかとドキドキしますが、こちらはAWSによるマネージドなインスタンスになっています。GPUつきのマシンをマネージドサービスで扱える貴重なサービスの一つだと考えています。
構成概要
AgentCoreのcontainer image上限は2 GBです。これはRuntime全体のディスク容量ではなく、デプロイするDocker imageの上限です。
AgentCore quotas
したがって、dockerイメージサイズを最小限にするために、Strands Deciderのモデル重みと、CUDA関連の依存関係に関しては、EC2が参照可能なEBSで管理することにしました。
snapshot由来のEBS volumeにあらかじめ配置しておき、実行時はvolumeを/mnt/cacheにmountし、通常の推論I/OはローカルEBSとGPUメモリ上で行います。
AgentCoreへのデプロイの失敗__タイムアウトの発生
AgentCore runtimeは本命のランタイムへのリクエスト以外にコンテナのGET /pingを確認する機能があります。初回のプロビジョニングに限ると、HTTP 200とhealthy statusが返るとリクエストを受け付けられる状態と判断します。
このヘルスチェックにはタイムアウトが明確に設定されており、120秒の制限があるようです。
(※ 公式の「microVM」のページでは明確な記載があるのですが、Instanceのページには記載がないため、推察となります。)
AgentCore runtime microVM
今回はEBS上のモデルの重み読み込みに時間がかかるため、モデル読み込み中に503を返すようにしています。まだ推論できない状態をreadyと誤認させないためです。
この取り組みが良くなかったのか、結果として初回読み込み時に120秒の制限を超過してしまい、AgentCoreが起動失敗状態になってしまいました。
読み込み中も503ではなく、200を返すウラワザ的な方法も考えられますが、モデルが未準備の間にinvokeされる可能性を許容することになります。これはAgentCore Runtimeの設計思想に反するものと考え、今回は採用しませんでした。
今回の結果と分かったこと
- AgentCore Instances上でGPU deviceとホスト提供driverを認識し、CUDA初期化まで成功した
- モデルの重み読み込み表示後もモデルreadyには至らず、AgentCoreから推論結果を得られなかった
したがって私が試した範囲の結論としては、AgentCore runtime のGPUインスタンスを用いた、Strands Deciderの運用は失敗という形になりました。
どうすればうまくいくのか_SageMaker AIの活用。
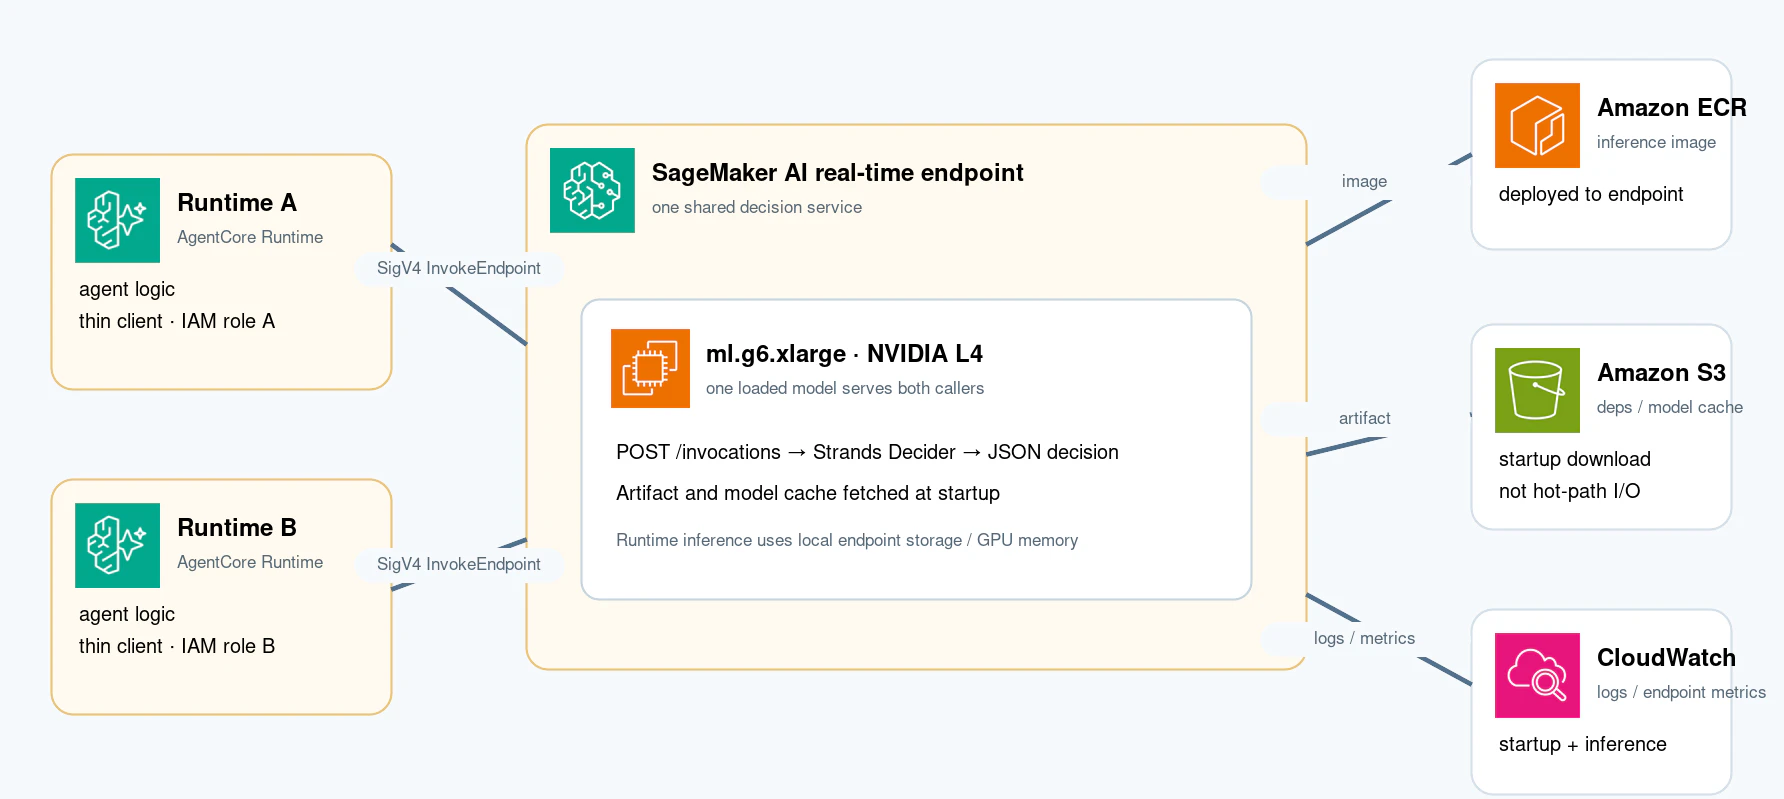
GPUモデルを各AgentCore Runtime sessionの中に同居させる代わりに、deciderだけをSageMaker AIのリアルタイム推論エンドポイントとして独立させる構成が考えられます。AgentCore Runtime側にはエージェント処理とHTTP clientだけを置き、モデルの起動とGPUを一つのSageMaker endpointへ集約します。
AWS Builderで類例がすでに紹介されています。
Strands Decider 2BのSageMaker AIサンプル
サンプルrepository
リアルタイム推論エンドポイントはHTTP(S)のendpointとして推論環境を公開し、InvokeEndpoint APIで呼び出します。呼び出しはSigV4で認証されるため、呼び出し元のIAMロールを指定することも可能です。
SageMaker AIを用いた共通コンポーネントとしてのdecider運用構成
AWS Builder紹介の構成を少しだけアレンジします。
この構成では、異なるAgentCore Runtime(Runtime A、Runtime Bなど)から同じSageMaker endpointを呼び出す構成にしました。
したがって、同じAWSアカウント上に複数の業務エージェントが存在し、その前処理を実行する意思決定モデルは共通のものを利用するユースケースを想定しています。
モデルはSageMaker側で1度だけ読み込まれ、各Runtimeはstateとquestionsを渡して判定結果を受け取ります。モデルの更新・GPUサイズ・endpointのautoscalingをagentから切り離せるため、複数agentに同じ意思決定policyを適用しやすくなります。
共有endpointの実測結果
別々のAgentCore Runtime A/Bから、同じSageMakerリアルタイム推論エンドポイントを呼び出しました。
表の時間は次の区間を測っています。
- AgentCore呼び出し全体: ベンチマーク用クライアントがAgentCore Runtimeを呼び出してから応答を受け取るまで。
-
SageMaker呼び出し往復: AgentCore Runtime内のクライアントがSageMakerの
InvokeEndpointを呼び、結果を受け取るまで。 - SageMaker推論サーバー処理: SageMaker側でリクエストを受けてから応答を返すまで。待ち行列がある場合はその待ち時間も含みます。
ウォーム状態とは、RuntimeセッションとSageMaker上のモデルがすでに起動していて、初回の起動処理を含まない状態です。p50は測定値の中央値、p95は測定値の95%がその時間以内に収まったことを表します。
| モデル起動後の測定方法 | 件数 | AgentCore呼び出し全体 p50 / p95 | SageMaker呼び出し往復 p50 / p95 | SageMaker推論サーバー処理 p50 / p95 |
|---|---|---|---|---|
| 1件ずつ順番に呼び出し | 40件 | 220.2 / 313.8ms | 78.4 / 151.8ms | 67.9 / 70.8ms |
| A/Bから同時に呼び出し(20組) | 40件 | 265.6 / 349.7ms | 94.2 / 146.1ms | 76.1 / 138.0ms |
- ウォーム時に1件ずつ呼び出した場合、AgentCore経由の全体処理時間は中央値約220ms、SageMaker呼び出し往復は約78ms、推論サーバー処理は約68msでした。今回の条件では、SageMaker側の処理が全体の遅延を支配しているとは言いにくい結果です。
AgentCoreの外側にStrands Deciderを配置しても、それ自体が処理速度上のボトルネックにはならないと言えるでしょう。
さいごに
AgentCoreで動かせなかったのは後悔が残りますが、失敗も知見であると考えてこのブログを執筆しました。
Amazon Bedrock内にモデルとして登場し、インスタンスタイプを気にせずに呼び出せるようになってくれたら嬉しいなと思ってます。