
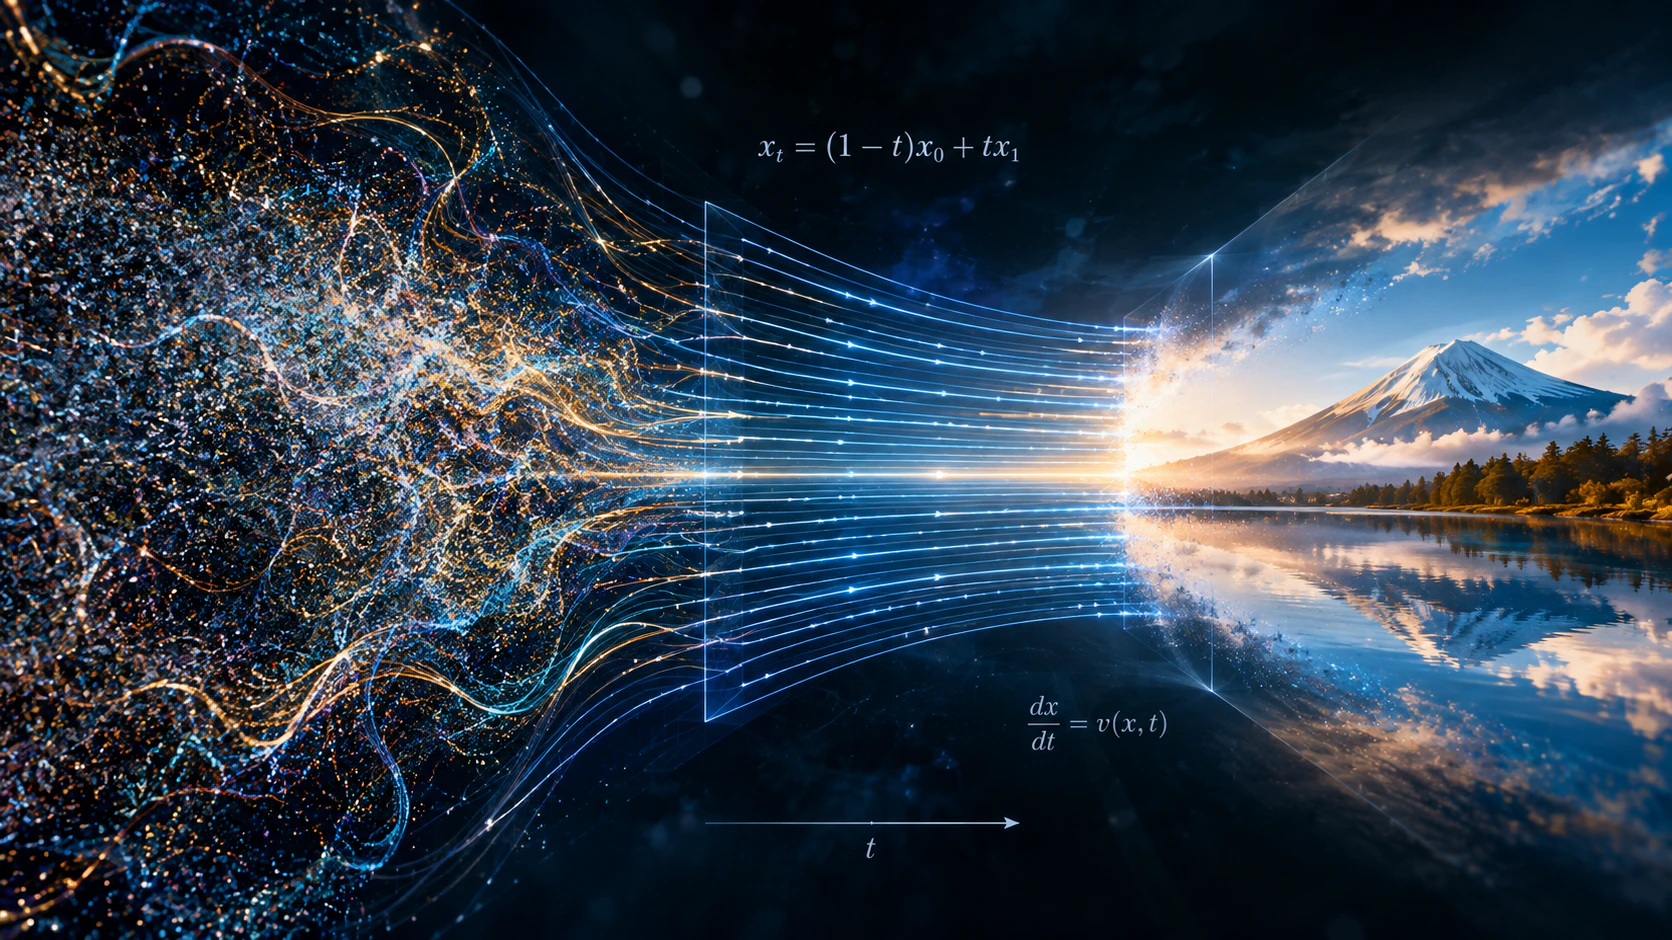
螺旋の果てに掴んだ「曲率ゼロ」 ── フローマッチングが描く等速直線
前回の第五話では、ランダムに揺れ動く熱ゆらぎ(ブラウン運動)を伴う 確率微分方程式(SDE) の霧の向こうに、1ミリの確率密度のズレもなく重なる決定論的な 「確率フローODE」 が隠されているという、数理物理学の奇跡的な等価性を解き明かしました。
「ランダムな暴風に吹かれながら蛇行する必要など最初からなかった。粒子は、スーッと流れる一貫した決定論的な風に乗せて目的地へ運ぶことができる」 ── この発見により、生成AIは第二話で一度は挫折した「決定論的な流体力学(正規化フロー)」の王道へと、華々しく舞い戻ることになりました。
しかし、確率フローODEが描くベクトルの軌跡を注意深く観察したとき、私たちは新たな疑問に突き当たります。
そこに描かれていた風は、どこか不自然に曲がりくねり、大きくうねっていたのです。
なぜなら、確率フローODEの風向き(速度場)は、過去の拡散モデル(SDE)が残していった「データを一度ノイズの砂嵐にまで完全に破壊し、それを段階的に縮小しながら復元する」という歴史的経緯(アニール構造)をそのまま引きずっていたからです。
ここで、数理物理学者たちの探求心は、さらなる根源的な問いへと突き進みます。
「始点(標準ガウスノイズ)と終点(本物のデータ)の場所があらかじめ与えられているのなら、なぜわざわざ途中であんなに曲がりくねった遠回りをしなければならないのか?」
「最初からノイズとデータを、 これ以上ないほど真っ直ぐな最短の等速直線(曲率ゼロ・交差なし) で結ぶ風を吹かせれば、一番速く、一分のボケもなく写真へ着地できるのではないか?」
連載第6話。ついに私たちは、正規化フローから出発し、拡散モデルという壮大な大回りを経て辿り着いた「知の U ターン(螺旋的発展)」の最高到達点へと足を踏み入れます。
第三話で学んだ「Denoising Score Matching(DSM)の条件付きの魂」と、幾何学の美である「最適輸送(Optimal Transport)」が融合し、シミュレーションの壁を完全に粉砕して爆発的な高速生成を達成した現代生成AIの最先端パラダイム ── 「フローマッチング(Flow Matching)」 のドラマを解き明かしていきましょう。
直進性の幾何学 ── McCann 最適輸送とアフィン・フロー
【読者への注意書き】
※ここで時間 $ t $ の定義について重要な補足があります。第一話~第五話の拡散モデルでは「データ($ t=0 $)$ \to $ ノイズ($ t=1 $)」という破壊の方向を時間の進む向きとして扱ってきましたが、フローマッチングの文脈(Lipman et al., 2022等)では、生成の方向(ノイズ $ \to $ データ)をそのまま時間の進む向き($ t=0 \to 1 $)として直感的に再定義します。すなわち、時刻 $ t=0 $ がスタートのノイズ $ \mathbf{x}_0 $、時刻 $ t=1 $ がゴールの画像データ $ \mathbf{x}_1 $ となります。
「ノイズからデータへと、粒子を一番真っ直ぐ等速直線運動で移動させる」とは、数学的にどのように定式化されるのでしょうか。
いま、時刻 $ t = 0 $ における始点(標準ガウス分布からサンプリングされたノイズ)を $ \mathbf{x}_0 \sim p_0(\mathbf{x}_0) $ とし、時刻 $ t = 1 $ における終点(本物のデータ分布から選ばれた1枚の画像)を $ \mathbf{x}_1 \sim p_1(\mathbf{x}_1) $ とします。
この2点 $ \mathbf{x}_0 $ と $ \mathbf{x}_1 $ を、時間 $ t \in \left\lbrack 0, 1 \right\rbrack $ の間で最もシンプルに直線で結ぶ運動を考えてみましょう。
高校の物理で習う位置の一次式、すなわち 「等速直線運動(アフィン補間)」 です。
\mathbf{x}_t = \psi_t(\mathbf{x}_0) = (1 - t)\mathbf{x}_0 + t\mathbf{x}_1 \tag{1}
この式(1)は、幾何学や最適輸送理論で重要な 「直線補間」 です。さらに、$\mathbf{x}_0$ と $\mathbf{x}_1$ の対応関係を適切な最適輸送カップリングとして選べば、McCann (1997) の 「最適輸送変位補間(Optimal Transport Displacement Interpolation)」 につながります。
時刻 $ t = 0 $ を代入すれば $ \mathbf{x}_0 $(完全なノイズ)、時刻 $ t = 1 $ を代入すれば $ \mathbf{x}_1 $(完全な画像)になり、その間の $ t $ では、ノイズと画像が一定の割合で滑らかにモーフィング(線形結合)されていきます。
さて、この直線軌道を走る粒子の「速度(時間微分)」を計算してみましょう。式(1)を時間 $ t $ で微分します。
\frac{d\mathbf{x}_t}{dt} = \frac{d}{dt} \left\lbrack (1 - t)\mathbf{x}_0 + t\mathbf{x}_1 \right\rbrack = \mathbf{x}_1 - \mathbf{x}_0 \tag{2}
なんというシンプルさでしょうか。
速度ベクトル $ \mathbf{x}_1 - \mathbf{x}_0 $ は、時間 $ t $ にも現在の位置 $ \mathbf{x}_t $ にも依存しない、完全な 定数ベクトル(曲率ゼロの直進ベクトル) になります。粒子は始点から終点へ向かって、加速も減速も旋回もせず、一定のスピードで一直線に突き進みます。
ここで、位置 $ \mathbf{x}_t $ の視点に立って、この速度を書き直してみましょう。式(1)を変形して $ \mathbf{x}_0 $ について解くと、$ \mathbf{x}_0 = \frac{\mathbf{x}_t - t\mathbf{x}_1}{1 - t} $ となります。これを式(2)の $ \mathbf{x}_1 - \mathbf{x}_0 $ に代入すると、終点 $ \mathbf{x}_1 $ に条件付けられた条件付き速度場(Conditional Vector Field) $ \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) $ が得られます。
\mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) = \frac{\mathbf{x}_1 - \mathbf{x}}{1 - t} \tag{3}
(※数値計算上の安定性のために微小値 $ \sigma_{\min} \approx 10^{-4} $ を含めた一般形式では、$ \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) = \frac{\mathbf{x}_1 - (1 - \sigma_{\min})\mathbf{x}}{1 - (1 - \sigma_{\min})t} $ と記述されます。)
式(3)の代数的な意味を解釈してみましょう。
この条件付き速度場は、「現在位置 $ \mathbf{x} $ から目的地 $ \mathbf{x}_1 $ までの残り距離 $ \mathbf{x}_1 - \mathbf{x} $」を、「残された時間 $ 1 - t $」で割り算したものです。まさに、 「残り時間でぴったり目的地に到達するための目盛り」 に他なりません。
もし、特定の1つのノイズ $ \mathbf{x}_0 $ と1つの画像 $ \mathbf{x}_1 $ のペアだけを相手にするのなら、私たちが学習すべき風向き(速度場)は、この式(3)によって暗算レベルで一瞬にして一意に計算できてしまうのです。
第二話の壁の再来と「シミュレーション・フリー」の夢
「特定のペアに対する直線速度場 $ \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) $ が数式一発で求まるのなら、これをニューラルネットワークに学習させて、決定論的フロー(CNF)を作ればいいではないか」と思われるかもしれません。
しかし、ここで第二話で絶望の壁となったあのトラウマが再来します。
2018年に登場した従来の連続時間正規化流(FFJORDなどのCNF)では、AIのモデル $ \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) $(ニューラルネットワークが予測する速度場:現在地 $ \mathbf{x} $ と時刻 $ t $ から粒子が進むべき風向きと風速のベクトルを出力するモデル)を更新するたびに、時間 $ t = 0 $ から $ t = 1 $ までODE数値積分ソルバーを実際に走らせて粒子の軌道をシミュレーションし、確率密度の変化(瞬間的変数変換方程式)を逐一追跡しなければなりませんでした(※なぜ重いシミュレーションが必要だったのかの詳細は付録Aを参照)。
現実の画像生成において、AIが対峙しなければならないのは、単一の画像 $ \mathbf{x}_1 $ ではありません。高次元空間全体に複雑に広がる「すべての本物画像の集団(データ分布 $ p_1 $)」です。
空間の各地点 $ \mathbf{x} $ において吹くべき真の風とは、あらゆる画像 $ \mathbf{x}_1 $ へ向かう個別の条件付き速度場を、空間全体の確率の重みで足し合わせた 「周辺速度場(Marginal Vector Field) $ \mathbf{u}_t(\mathbf{x}) $」 でなければなりません。
\mathbf{u}_t(\mathbf{x}) = \int \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) \frac{p_1(\mathbf{x}_1) p_t(\mathbf{x} \mid \mathbf{x}_1)}{p_t(\mathbf{x})} d\mathbf{x}_1 \tag{4}
これは、空間上の点 $ \mathbf{x} $ で吹くべき真の風(周辺速度場 $ \mathbf{u}_t(\mathbf{x}) $)とは、あらゆる着地点 $ \mathbf{x}_1 $ へ向かう個別の風を、『その着地点に辿り着く確率(事後確率)』
p(\mathbf{x}_1 \mid \mathbf{x}_t = \mathbf{x}) = \frac{p_1(\mathbf{x}_1) p_t(\mathbf{x} \mid \mathbf{x}_1)}{p_t(\mathbf{x})}
で重み付き平均(加重平均)したものであることを表しています。
この式(4)に立ちはだかるのは、第二話で見た「全空間の積分(周辺化)」の悪夢です。
パラメータをたった1ステップ更新するためだけに、毎回時間方向の流体シミュレーションを解かなければならない ── この 「シミュレーションの壁(Simulation Barrier)」 によって、当時のCNFは高解像度画像へのスケールアップを前に窒息してしまったのです。
「シミュレーションを1ステップも走らせることなく(Simulation-Free)、空間全体の完璧な周辺速度場 $ \mathbf{u}_t(\mathbf{x}) $ を直接学習する魔法のような方法は存在しないのだろうか?」
この絶対不可能な問いに、知の螺旋の極致となる回答がもたらされます。
Theorem 2 の降臨 ── DSM の魂が咲かせた代数的奇跡
この絶望的な計算の壁を粉砕したのは、本連載の背後をずっと貫いてきた 「あの最大の伏線」 でした。
第三話で私たちが目撃した、Pascal Vincent の Denoising Score Matching(DSM) の代数美を思い出してください。
「全空間を覆う複雑な周辺分布の構造(周辺スコア)を直接計算することは不可能でも、特定のデータ点に条件付けた個別の復元力(条件付きスコア)をL2回帰でフィッティングすれば、理論上、一分一厘の狂いもなく周辺スコアと勾配が一致する」
2022年、Yaron Lipman らは論文 “Flow Matching for Generative Modeling” において、この DSM の「条件付きから周辺へ」というコペルニクス的転換を、スコア(傾き)から 速度場(フロー) へと奇跡的に拡張してみせました。
これが、Conditional Flow Matching (CFM) です。
本来、私たちがAIモデル $ \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) $ に学習させたい真の目的関数(フローマッチング損失:FM損失)は、目標とする周辺速度場 $ \mathbf{u}_t(\mathbf{x}) $ との2乗誤差です。
\mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) = \mathbb{E}_{t \sim \text{Uniform}(0,1), \mathbf{x} \sim p_t(\mathbf{x})} \left\lbrack \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) - \mathbf{u}_t(\mathbf{x}) \right\Vert^2 \right\rbrack \tag{5}
しかし、式(5)の中に存在する $ \mathbf{u}_t(\mathbf{x}) $ や $ p_t(\mathbf{x}) $ は、全空間の積分を含んでいるため直接計算できません。
そこで Lipman らは、個別のデータ点 $ \mathbf{x}_1 $(および始点ノイズ $ \mathbf{x}_0 $)に条件付けた、極めてシンプルな 条件付きフローマッチング損失(CFM損失) を定義しました。
\mathcal{L}_{\text{CFM}}(\boldsymbol{\theta}) = \mathbb{E}_{t \sim \text{Uniform}(0,1), \mathbf{x}_1 \sim p_1(\mathbf{x}_1), \mathbf{x} \sim p_t(\mathbf{x} \mid \mathbf{x}_1)} \left\lbrack \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) - \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) \right\Vert^2 \right\rbrack \tag{6}
式(6)の中に出てくる $ \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) $ は、先ほど式(3)で求めた条件付き速度場です。実際の直線軌道上の点 $\mathbf{x}=\mathbf{x}_t$ では、式(3)は式(2)の「暗算で求まる直線速度ベクトル($ \mathbf{x}_1-\mathbf{x}_0 $)」と一致します。
そして、Lipman らは以下の 歴史的決定打となる定理(Theorem 2) を証明しました(※詳細な数学的証明は付録Bを参照)。
【定理2(Theorem 2:Lipman et al., 2022)】
任意の速度場モデル $ \mathbf{v}_\boldsymbol{\theta} $ に対して、条件付きフローマッチング損失 $ \mathcal{L}_{\text{CFM}}(\boldsymbol{\theta}) $ と、真のフローマッチング損失 $ \mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) $ は、モデルのパラメータ $ \boldsymbol{\theta} $ に関する勾配が数学的に完全に等しくなる。
\nabla_\boldsymbol{\theta} \mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) = \nabla_\boldsymbol{\theta} \mathcal{L}_{\text{CFM}}(\boldsymbol{\theta}) \tag{7}
この定理2が意味する衝撃がご理解いただけるでしょうか。
この数学的帰結によって、第二話以来、人類を苦しめ続けてきた「シミュレーションの壁」は跡形もなく崩壊しました。
AIの学習時に、ODE数値積分ソルバーを走らせる必要は一切なくなりました(Simulation-Free)。
学習の手順は、驚くほどシンプルで高速なものになります。
-
訓練データから1枚の画像 $ \mathbf{x}_1 $ を選び、標準ガウス分布から1つのノイズ $ \mathbf{x}_0 $ をサンプリングする。
-
時間 $ t \in \left\lbrack 0, 1 \right\rbrack $ をランダムに1つ選び、直線補間した点 $ \mathbf{x}_t = (1 - t)\mathbf{x}_0 + t\mathbf{x}_1 $ を作成する。
-
AIモデル $ \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}_t, t) $ に、目標となる直線速度ベクトル $ \mathbf{x}_1 - \mathbf{x}_0 $ を予測させ、その L2 回帰(単なる最小二乗誤差) を最小化するように重みを更新する。
たったこれだけです。
重い数値シミュレーションを1ステップも行うことなく、ただペアを結ぶ直線ベクトルをL2回帰でフィッティングし続けるだけで、空間全体には、無数の直線流が綺麗に束ねられた 完璧な周辺速度場(幾何学的に正しいCNFの風) が自動的に組み上がっていくのです。
最適輸送(OT-CFM)と Rectified Flow ── 速度ベクトル交差の解消
「ノイズ $ \mathbf{x}_0 $ と画像 $ \mathbf{x}_1 $ を直線で結び、L2回帰で学習させる」
このフローマッチング(CFM)の登場によって、生成AIはついに完全なシミュレーション・フリーの連続時間フローを手に入れました。
しかし、ここでさらなる幾何学的な美しさを追求する研究者たちが現れます。
ランダムに選んだノイズ $\mathbf{x}_0$ と、ランダムに選んだ画像 $\mathbf{x}_1$ を無作為に(独立に)ペアリングして直線を引くと、高次元空間の中で異なる直線経路が同じ領域を通ったり、互いに近接したりするという状況が生じます。
あっちへ向かう直線と、こっちへ向かう直線が途中で交差すると、その交差点においてAIは「どちらの方向へ進むべきか」の平均値を学習することになります。その結果、個別の条件付き軌道は真っ直ぐな直線であっても、空間全体で合わしこまれた周辺軌道には、わずかに 「うねり(曲率)」 が生じてしまうのです。
このような直線経路の交差や、それによって生じる速度場の複雑さを抑え、より直線的な流れを作るために導入されたのが、 最適輸送(Optimal Transport: OT) の知恵でした。
Lipman らの OT-CFM では、ノイズの集団 $ p_0 $ とデータの集団 $ p_1 $ の間を、移動コストが小さくなるような 「最適輸送カップリング(OT Coupling)」 でペアリングします。一方、Qiang Liu らの Rectified Flow(リクティファイド・フロー) は、まず与えられたカップリングから直線経路を学習し、その後の Reflow によって経路をさらに直線化していく方法です。
ノイズと画像を輸送コストが小さくなるようにマッチングして直線を引けば、空間内で経路が大きく交差することを抑え、より直線的で単純な流れを作りやすくなります。
さらに、Rectified Flow が提示した Reflow(リフロー) というアプローチは圧巻です。
-
一度学習した1次モデル(1-Rectified Flow)を使って、ノイズ $ \mathbf{x}_0 $ から生成された画像 $ \mathbf{x}_1 $ のペアを大量に作成する。
-
この「モデル自身が追いかけたペア $ (\mathbf{x}_0, \mathbf{x}_1) $」を使って、もう一度モデルを再学習(2-Rectified Flow)させる。
この Reflow 操作を施すと、高次元空間を流れる流線の軌道は、より直線的になり、経路の曲がりや速度場の複雑さが抑えられていきます。これを 整流(Straightening) と呼びます。
軌道が完全な等速直線運動(曲率ゼロかつ速度一定)になると、何が起きるでしょうか。
等速直線運動では、位置の変化は一定の速度に時間を掛けるだけで求まります。
\mathbf{x}_1 = \mathbf{x}_0 + \mathbf{v}(\mathbf{x}_0, 0) \cdot 1 \tag{8}
なんと、もし軌道上の速度が時間を通じて一定であれば、ODE数値積分ソルバーのステップ数を刻む必要すらなくなり、たった 1ステップのオイラー積分(NFE = 1) で終点へ到達できます。実際のモデルでも、軌道を十分に直線化することで、非常に少ないNFEでの生成が可能になります。
工学的圧倒的勝利 ── 低 NFE サンプリングと超高速生成の衝撃
フローマッチング(FM-OT)および Rectified Flow がもたらした「より直線的な流れ」の威力を、過去の世代のモデルと比較してみましょう。
| 世代・モデルパラダイム | 軌道の性質 | 典型的な生成ステップ数 (NFE) | サンプリングの質と課題 |
|---|---|---|---|
| 拡散モデル (DDPM/NCSN) | ランダムな熱ゆらぎを伴う蛇行軌道 (SDE) | 1000 ~ 100 ステップ | 高品質だが、生成が極めて遅い。 |
| 確率フロー ODE (SDE起点) | 決定論的だが、大きくうねる湾曲軌道 | 50 ~ 30 ステップ | 高速化するが、急カーブで離散化誤差が発生。 |
| Flow Matching (OT-CFM) | 直線的な条件付き経路を用いた流れ | 100 ~ 10 ステップ | 適切な経路設計により低NFE化を目指せる。 |
| Reflow / Distilled Flow | より直線化・高速化された流れ | 数ステップ~1ステップ | 少ないNFEでの高速生成を可能にする。 |
なぜ、十分に直線化されたフローモデルでは、わずか10ステップ、さらには1ステップという極限の低NFEであっても、 画像が途中で崩れたりぼやけたりしにくくなるのでしょうか。
その理由は、数値解析において、軌道を直線化することで離散化誤差を小さくできることにあります。
従来の確率フローODEのように軌道が複雑にカーブしている場合、数値積分ソルバーのステップ幅(刻み幅)を大きく荒くしてしまうと、カーブを曲がりきれずに接線方向へ飛び出してしまい、本来のデータ多様体から大きく脱軌して画像が崩壊してしまいます。
しかし、フローマッチング(OT-CFM)では、直線的な条件付き経路を用いることで、より直線的な流れを構成できます。
速度場が完全に一定な直線場であるならば、まっすぐな直線の上を走るため、ステップ幅を大きくしてもオイラー法による更新は同じ直線上にあります。そのため、理想的な直線場では曲率による離散化誤差は生じません。
適応型 ODE ソルバー(Dopri5 や RK45)は、軌道が直線に近づけば大きな時間刻みを取りやすくなり、必要な関数評価回数(NFE)を減らすことができます。
「美しき数理(最適輸送と直線美)は、そのまま最高の工学的性能(超高速・高精度生成)へと直結する」 ── フローマッチングは、数理物理学の美しさと現実の工学的勝利が完璧に合致した、AI史上最も爽快なブレイクスルーと言えます。
螺旋の果てに繋がれたバトン ── 第七話(最終話)へ
第一話から始まった、私たちの知の冒険を振り返ってみましょう。
-
第一話:画像とは高次元空間中の1点であり、生成とは「確率分布の山から点を引き当てるサンプリング」であることを定義した。
-
第二話:確率を水のように変形させる「正規化フロー(CNF)」を夢見たが、「高次元積分の壁(分配関数の困難)」と「シミュレーションの壁」によって一度目の挫折を味わった。
-
第三話:全体を測るのを諦め、局所の傾きを学ぶ「デノイジング・スコアマッチング(DSM)」によって、個別の条件付き復元力から全体の構造を暴く代数美(DSMの魂)を獲得した。
-
第四話:物理学(非平衡熱力学)の知恵を借り、データを一度完全なノイズへと破壊して段階的に復元する「拡散モデル(DDPM/NCSN)」によって、高次元空間の砂漠を克服した。
-
第五話:確率的な砂嵐(SDE)の向こうに、1ミリの密度のズレもなく重なる「決定論的な確率フローODE」を再発見し、再びフローの王道へと還流した。
-
第六話:そして今、DSMの「条件付き」という魂(Theorem 2)と最適輸送の「直線美」を携え、シミュレーション・フリーな究極の連続時間正規化流として、 「フローマッチング(CFM)」 が第二話の原点へと完璧な凱旋帰還(大還流)を果たした。
人類が紡いできたこの知の軌跡は、決して無造作な年表ではありません。
壁にぶつかり、物理の知恵を借りて大きく迂回し、その先で本質を再発見して、より高い次元で元の夢を完璧な形で結実させる ── これこそが、学術史における「知の螺旋(Uターン)」の美しさなのです。
次回、最終話。
この全7話にわたる壮大な数理物理の旅路を総括し、数学と物理が解き明かした生成AIの「知能の根源」、アンド「流れ(Flow)」がひらく未踏の未来の展望について、最後のメッセージを贈ります。
数理が織りなす知のバトンパスの結末を、どうぞお楽しみに。
(第七話へ続く)
第六話 参考文献リスト
-
岡野原大輔 『生成AIのしくみ』 (技術評論社、2024年)
-
岡野原大輔 『拡散モデル』 (岩波書店、2023年)
-
Y. Lipman, R. T. Q. Chen, H. Ben-Hamu, M. Nickel, M. Le, "Flow Matching for Generative Modeling," ICLR, 2023.
-
X. Liu, C. Gong, Q. Liu, "Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow," ICLR, 2023.
-
M. S. Albergo, E. Vanden-Eijnden, "Building Normalizing Flows with Stochastic Interpolants," arXiv, 2022.
-
A.-A. Pooladian, H. Ben-Hamu, C. Domingo-Enrich, B. Amos, Y. Lipman, R. T. Q. Chen, "Multisample Flow Matching: Straightening Flows with Minibatch Couplings," ICML, 2023.
-
R. T. Q. Chen, Y. Rubanova, J. Bettencourt, D. Duvenaud, "Neural Ordinary Differential Equations," NeurIPS, 2018.
第六話 専門用語の簡単な解説
-
フローマッチング(Flow Matching): 決定論的な連続時間正規化流(CNF)の速度場を、シミュレーションを経由せずに目的関数(L2回帰)で直接フィッティングして学習する生成モデルの枠組み。
-
最適輸送(Optimal Transport): ある確率分布から別の確率分布へと最小の移動コスト(距離×質量)で粒子を輸送する数学的理論。
-
条件付きフローマッチング(CFM): 空間全体の複雑な周辺ベクトル場を、個別のデータ点に条件付けた単純な直線ベクトル場を用いて学習する手法(Theorem 2によりFM損失とCFM損失のパラメータに関する勾配が等しくなる)。
-
Reflow(リフロー): Rectified Flowにおいて、学習した流れから得られた始点・終点のペアを用いてモデルを再学習することで、流れの軌道をさらに直線化し、少ないNFEでの生成を可能にしやすくする手法。
-
NFE(Number of Function Evaluations): 画像生成時にニューラルネットワーク(速度場やスコアモデル)を呼び出し・評価した回数。NFEが少ないほど生成速度が高速になる。
付録
付録A:なぜ従来のCNFではシミュレーションと瞬間的変数変換方程式が必要だったのか?
1. AIの学習目標(最尤学習)とシミュレーションの必要性
AIモデル $ \mathbf{v}_\boldsymbol{\theta} $ に本物の画像 $ \mathbf{x}_1 $ を生成させるための学習目標は、データが出現する確率密度(対数尤度 $ \log p_1(\mathbf{x}_1) $)を最大化することです。
しかし、AIが直接計算できるのは初期ノイズ分布 $ \log p_0(\mathbf{x}_0) $ のみです。粒子がノイズ $ \mathbf{x}_0 $ から速度場 $ \mathbf{v}_\boldsymbol{\theta} $ に流されて画像 $ \mathbf{x}_1 $ に届く道中、風の吹き方によって空間が押し潰されたり(密度上昇)引き伸ばされたり(密度低下)します。
そのため、画像 $ \mathbf{x}_1 $ での最終的な確率密度 $ \log p_1(\mathbf{x}_1) $ を評価するには、以下の2つの計算が不可欠でした。
-
軌道のシミュレーション: 画像 $ \mathbf{x}_1 $ から時間をさかのぼり、粒子が辿る軌道全体 $ \mathbf{x}(t) $ をODE数値積分ソルバーで追跡する。
-
体積変化の累積追跡: 軌道上の各ステップで速度場の発散 $ \nabla \cdot \mathbf{v}_\boldsymbol{\theta} $ を計算し、$ t=0 $ から $ t=1 $ まで密度の増減を積分して足し合わせる。
重み $ \boldsymbol{\theta} $ を1ステップ更新するだけでも、訓練画像ごとに毎回 $ t=0 \to 1 $ の流体シミュレーション(ODEソルバーの多数の反復計算)を走らせる必要があり、これが莫大な計算コストを生む 「シミュレーションの壁(Simulation Barrier)」 となっていました。
2. 瞬間的変数変換方程式(Instantaneous Change of Variables Theorem)
連続時間正規化流(CNF / Neural ODE)において、流れに乗って移動する粒子に沿った対数確率密度の変化率を表す定理(Chen et al., 2018)です。
離散フロー(RealNVP等)における重い「ヤコビ行列の行列式 $ \det J $」の計算が、時間連続の極限($ \Delta t \to 0 $)では「速度場のヤコビ行列のトレース = 発散(Divergence: $ \nabla \cdot \mathbf{v}_\boldsymbol{\theta} $)」という1階の偏微分へと帰着されます。
\frac{d}{dt} \log p_t(\mathbf{x}(t)) = -\nabla \cdot \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}(t), t)
これを時間 $ t=0 $ から $ t=1 $ まで全時間にわたって積分することで、データの対数尤度が算出されます。
\log p_1(\mathbf{x}(1)) = \log p_0(\mathbf{x}(0)) - \int_0^1 \nabla \cdot \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}(t), t) dt
この定理によりヤコビアン行列式の計算は回避されましたが、右辺の積分を評価するためにODEソルバーで軌跡 $ \mathbf{x}(t) $ をシミュレーションせねばならないという課題は残されたままでした。
付録B:定理2(Theorem 2:Lipman et al., 2022)の証明
【証明目標】
フローマッチング損失(FM損失):
\mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) = \int_0^1 \int_{\mathbb{R}^d} \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) - \mathbf{u}_t(\mathbf{x}) \right\Vert^2 p_t(\mathbf{x}) d\mathbf{x} dt
条件付きフローマッチング損失(CFM損失):
\mathcal{L}_{\text{CFM}}(\boldsymbol{\theta}) = \int_0^1 \int_{\mathbb{R}^d} \int_{\mathbb{R}^d} \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) - \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) \right\Vert^2 p_t(\mathbf{x} \mid \mathbf{x}_1) p_1(\mathbf{x}_1) d\mathbf{x} d\mathbf{x}_1 dt
に対し、両者のパラメータ $ \boldsymbol{\theta} $ に関する勾配が完全に一致することを示す:
\nabla_\boldsymbol{\theta} \mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) = \nabla_\boldsymbol{\theta} \mathcal{L}_{\text{CFM}}(\boldsymbol{\theta})
【証明手順】
ステップ 1:FM損失の展開と偏微分
$ \mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) $ のノルム2乗を展開し、$ \boldsymbol{\theta} $ に依存しない項 $ \left\Vert \mathbf{u}_t(\mathbf{x}) \right\Vert^2 $ を消去して偏微分します。
\begin{aligned}
&\nabla_\boldsymbol{\theta} \mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) \\&= \nabla_\boldsymbol{\theta} \int_0^1 \int_{\mathbb{R}^d} \left( \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \right\Vert^2 p_t(\mathbf{x}) - 2 \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \cdot \mathbf{u}_t(\mathbf{x}) p_t(\mathbf{x}) \right) d\mathbf{x} dt
\end{aligned}
\tag{B.1}
ステップ 2:CFM損失の展開と偏微分
同様に $ \mathcal{L}_{\text{CFM}}(\boldsymbol{\theta}) $ のノルム2乗を展開し、$ \boldsymbol{\theta} $ に依存しない項を消去して偏微分します。
\begin{aligned}
&\nabla_\boldsymbol{\theta} \mathcal{L}_{\text{CFM}}(\boldsymbol{\theta}) \\&= \nabla_\boldsymbol{\theta} \int_0^1 \int_{\mathbb{R}^d} \int_{\mathbb{R}^d} \left( \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \right\Vert^2 - 2 \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \cdot \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) \right) p_t(\mathbf{x} \mid \mathbf{x}_1) p_1(\mathbf{x}_1) d\mathbf{x} d\mathbf{x}_1 dt
\end{aligned}
\tag{B.2}
ステップ 3:第1項(二乗項)の一致の証明
式(B.2)の第1項において、モデル $ \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) $ は $ \mathbf{x}_1 $ に依存しないため、フビニの定理より $ \mathbf{x}_1 $ に関する積分を先に計算します。周辺確率密度の定義 $ p_t(\mathbf{x}) = \int p_t(\mathbf{x} \mid \mathbf{x}_1) p_1(\mathbf{x}_1) d\mathbf{x}_1 $ を適用すると:
\int_{\mathbb{R}^d} \left( \int_{\mathbb{R}^d} p_t(\mathbf{x} \mid \mathbf{x}_1) p_1(\mathbf{x}_1) d\mathbf{x}_1 \right) \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \right\Vert^2 d\mathbf{x} = \int_{\mathbb{R}^d} p_t(\mathbf{x}) \left\Vert \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \right\Vert^2 d\mathbf{x}
となり、第1項の勾配は完全に一致します。
ステップ 4:第2項(交差項)の一致の証明
式(B.2)の第2項(交差項)に周辺速度場 $ \mathbf{u}_t(\mathbf{x}) $ の定義式である
p_t(\mathbf{x}) \mathbf{u}_t(\mathbf{x}) = \int_{\mathbb{R}^d} \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) p_t(\mathbf{x} \mid \mathbf{x}_1) p_1(\mathbf{x}_1) d\mathbf{x}_1
を代入します。
\begin{aligned}
-2 \int_0^1 \int_{\mathbb{R}^d} \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) &\cdot \left( \int_{\mathbb{R}^d} \mathbf{u}_t(\mathbf{x} \mid \mathbf{x}_1) p_t(\mathbf{x} \mid \mathbf{x}_1) p_1(\mathbf{x}_1) d\mathbf{x}_1 \right) d\mathbf{x} dt \\&= -2 \int_0^1 \int_{\mathbb{R}^d} \mathbf{v}_\boldsymbol{\theta}(\mathbf{x}, t) \cdot \mathbf{u}_t(\mathbf{x}) p_t(\mathbf{x}) d\mathbf{x} dt
\end{aligned}
これにより、第2項の勾配も完全一致することが示されました。
結論
二乗項および交差項の勾配がそれぞれ一致するため、以下が証明されました。
\nabla_\boldsymbol{\theta} \mathcal{L}_{\text{FM}}(\boldsymbol{\theta}) = \nabla_\boldsymbol{\theta} \mathcal{L}_{\text{CFM}}(\boldsymbol{\theta})
(Q.E.D.)
【本記事におけるAI(生成AI)の活用について】
本連載(および本記事)は、著者が約4ヶ月間にわたり積み重ねてきた専門論文の精読・数理的考察と、AIとの徹底的なディスカッションを経て構築したプロットに基づいています。
記事内の本文記述および見出しの言語化・構造化にあたっては、論理の透明性と読みやすさを高めるパートナーとしてAI(LLM)を活用・編集しています。数理的な構想や文脈の意図はすべて筆者の思索に基づくものです。