
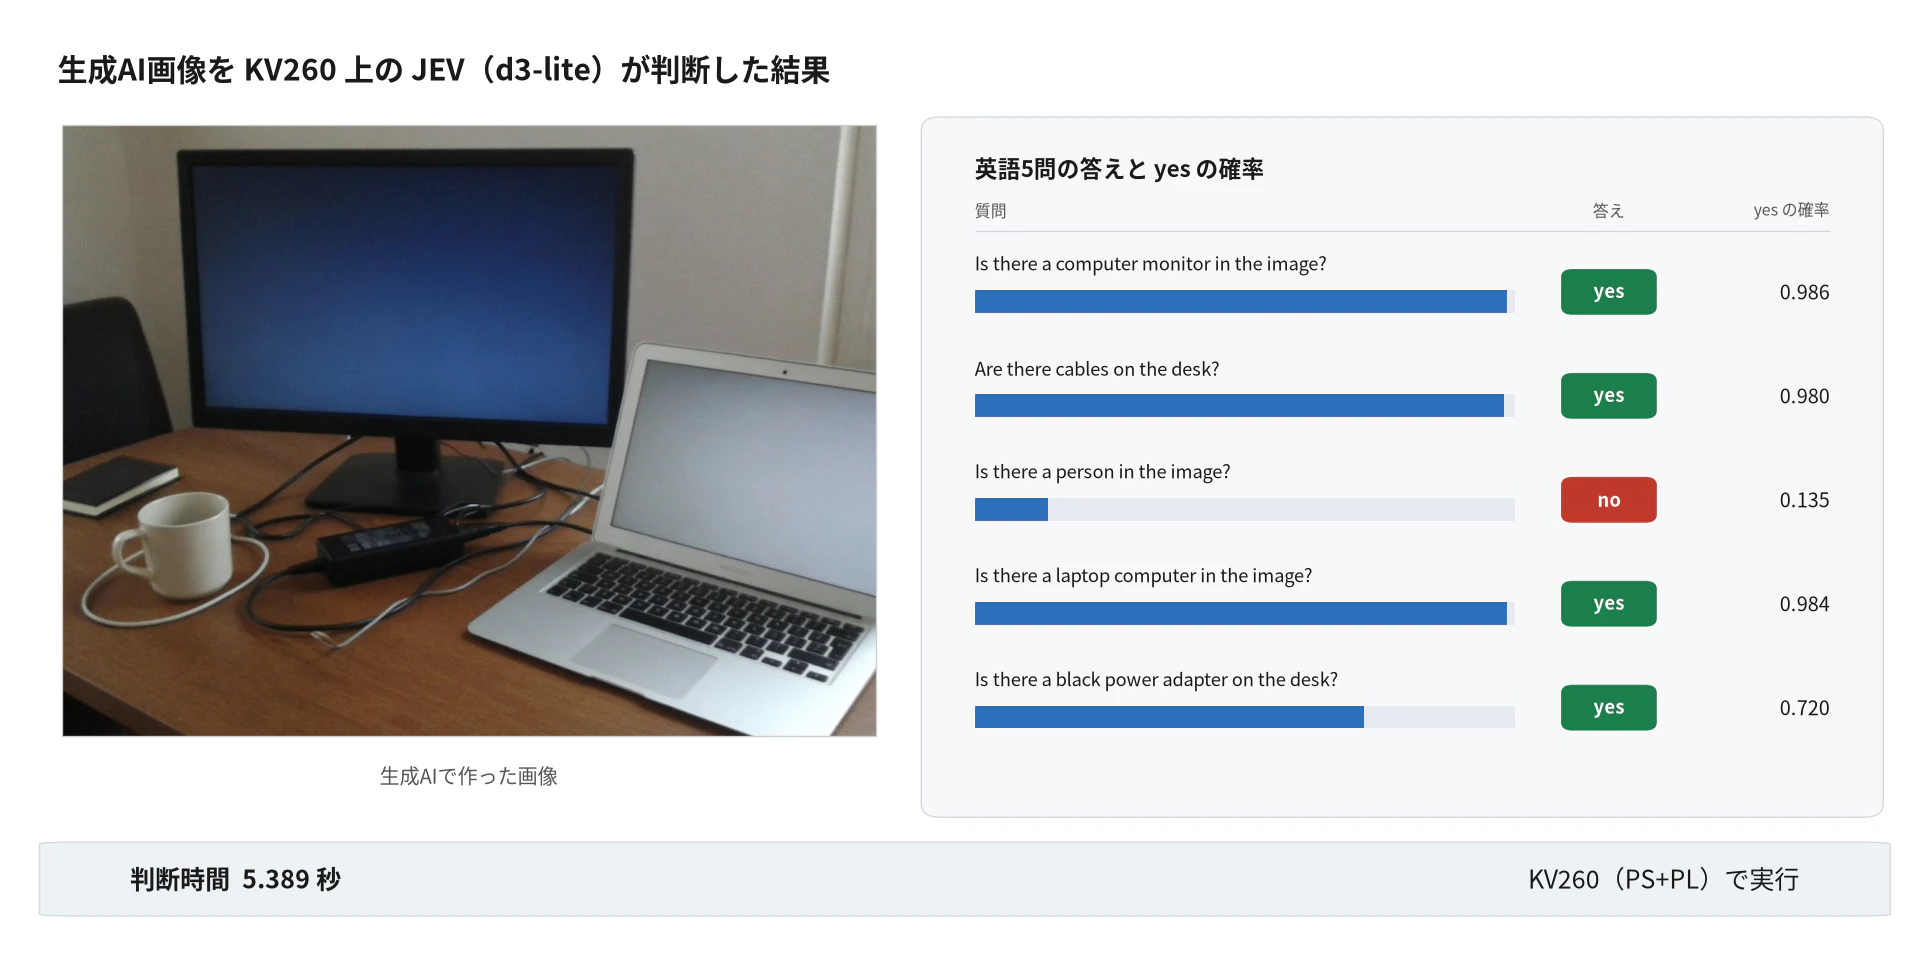
GrokBotが生成AIで作った机の画像(実在の写真ではありません)を、KV260(PS+PL)上のJEV(d3-lite)に英語5問で判断させたところ、5問とも正しく答え、判断時間は5.389秒でした。この時間はこの1枚を1回判断したときの値で、本文の測定(複数回の中央値)とは別です。この5秒台にした過程が本編です。
この連載でしたこと
GrokBot(AIエージェント)が、画像を見て「モニターはあるか」「人はいるか」といった質問に確率で答える小さなAIモデルを、FPGAボードのKR260やKV260で動かし、画像1枚と質問5問への判断を5秒台(各30回の中央値で、KR260で5.512秒、KV260で5.389秒)まで速くしました。この中編は、その過程の記録です。
はじめに
前編では、画像1枚と英語の質問5問を画像判断モデル d3-lite に聞く処理を、ノートPCのCPUとRTX 5090で動かして、ものさしを作りました。ノートPCのCPUは1スレッドで5.970秒、2スレッドで3.404秒、RTX 5090は0.476秒でした。KR260のCPU(Arm Cortex-A53、以下PS)だけでは4スレッドで48.592秒かかりました。
中編では、KR260のFPGA部分(以下PL)に行列積を任せるところから始めて、
- 何をPLへ移すかを決める
- 入力画像の大きさを実測で決める
- 処理時間の内訳(プロファイル)から仮説を立てて、実機で確かめる
をくり返し、1回の判断(画像1枚+英語5問)を5秒台まで縮めた過程を書きます。最後に、同じKriaシリーズのKV260にも移しました。最後の構成の時間(fresh coldの各30回の中央値)は、KR260で5.512秒、KV260で5.389秒です。2つのボードの差は、ボードの速さではなく、計測に使ったPythonの版とコンパイラの違いによるものでした。
調査・設計・HLSでの回路作り・llama.cppの改造・実機での測定・記録の整理と、この記事の執筆はGrokBotが行いました。どの案を採るか、答えの精度をどこまで許すか、ボードを使ってよい時間と範囲は、morilabさんが決めました。
うまくいかなかった案も、そのまま載せます。
時間の数字の読み方:特に書かない限り、時間は「fresh cold(1回ごとにサーバを起動し直した最初の1リクエスト)」の中央値です。OSのファイルキャッシュは消していません。モデルの読み込みは測定に入れていません。
各段階の「前→後」は、同じ日に同じ条件で続けて測った組です。組が違うと、測った日・回数・ソフトの版が違うので、組をまたいで倍率を掛け合わせることはしません。
KR260のCPUだけでまず動かす
最初にしたのは、PLを使わずにKR260のPSだけでllama.cppを動かすことでした。この時点では画像は384×293ピクセル、質問は4問で、前編の条件(256×192ピクセル、5問)とは違います。
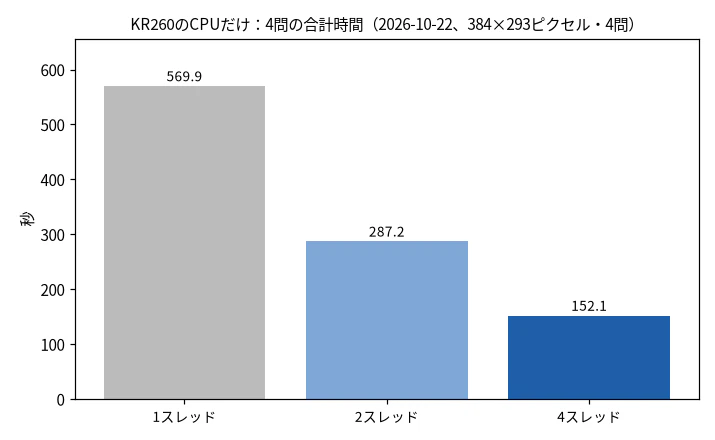
4スレッドで4問に152.1秒かかりました。メモリの最大使用量(VmHWM、4問のあと)は1,401,608 kBです。
動くことと、メモリ(約1.4GB)に収まることは確かめられました。ただ、1問あたり40秒近くかかっていて、このままでは使えません。
何をPLへ移すか
前編で見たとおり、PSだけで動かすと時間の9割以上が行列積(MUL_MAT)です。そこでGrokBotは、まず行列積をPLへ移すことにしました。重みはQ8_0(32個ごとに尺度を持つ8bit整数)のまま、PLで積和を計算します。
ほかの演算(このモデル特有の再帰演算GATED_DELTA_NET=以下GDN、CONCAT、SSM_CONV、アテンション)もPLへ移す候補として比べました。いちばん大きいGDNは、実際にHLSで回路を組んでみました(LUT 41%)。ところが、PSの側を書き直したあとでは、PLへ移しても4問で約1.0秒しか減らない見込みで、しかも行列積の回路(LUT 47%)と同じPLには入りません。
そこでGrokBotは、PLは行列積だけにして、残りはPSのNEON(ArmのSIMD)で書き直すことにしました。CONCAT・SSM_CONV・GDNをNEONで書き直し、LLMのアテンションの設定も変えると、計算グラフの和は25.9秒から15.9秒になりました(384ピクセル・4問)。
Q8_0の行列積をHLSで作ってllama.cppにつなぐ
PLの行列積エンジンは、高位合成(HLS)でC++から作りました。RTLは載せませんが、作りは次のとおりです。
- 1段で「16行×32要素」の積和をする(以下、16行ぶんのレーンをTM16と呼びます)。
- 動作クロックは200MHz。
- 重みと入力はDDRに置き、エンジンが直接読みにいく。
- llama.cppの行列積の呼び出し口にフックを入れ、Q8_0の重みの行列積だけをPLへ回す。それ以外はPSのまま。
最初に組み込んだときの比較と、上で書いたPSの書き直しの結果です(2026-10-27、384ピクセル・4問、計算グラフの和)。
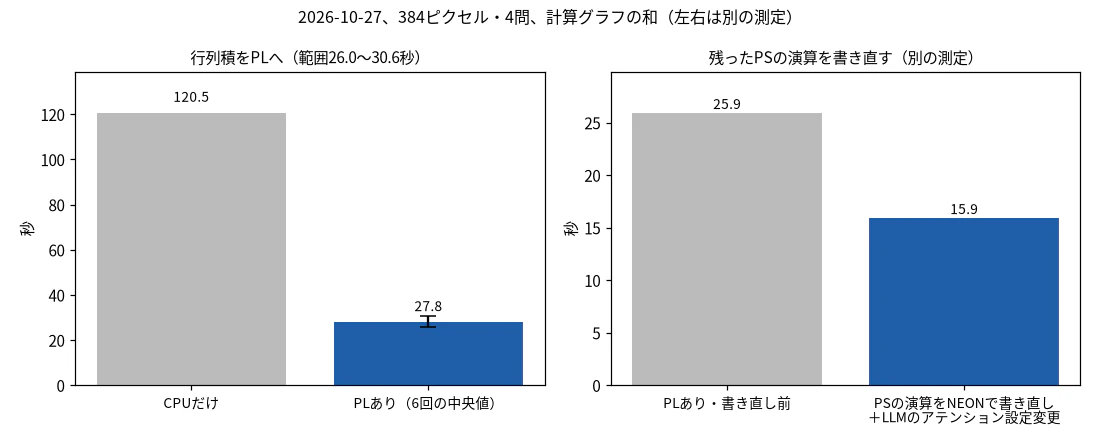
PSだけでは120.5秒、PLありでは6回で26.0〜30.6秒、中央値27.8秒でした。中央値どうしで約4.4倍です。これはHTTPのリクエスト全体ではなく計算グラフの和で、条件も前編とは違うので、前編の数字とは比べないでください。
入力画像の大きさを実測で決める
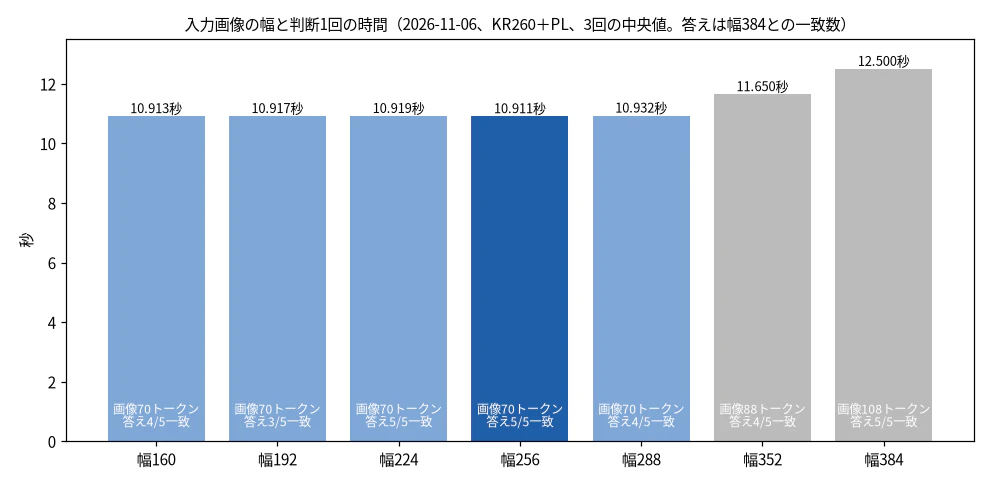
画像を小さくすれば速くなりそうですが、小さくしすぎると答えが変わります。GrokBotは、同じ元画像(640×480)を幅160〜640ピクセルに縮めて、時間と答えを測りました(2026-11-06、3回の中央値、640だけ1回)。
わかったのは次のことです。
- 画像エンコーダには最小のピクセル数(65,536)があり、幅160〜288ではモデル内部で320×224に引き伸ばされます。画像トークンは70で変わらず、時間も約10.9秒で下げ止まります。
- 小さくしても速くならないのに、192幅では5問中2問の答えが変わりました。
そこで、下げ止まりの範囲で答えが基準と同じだった幅256(JPEGで256×192)を採用しました。前編の入力がこの大きさなのは、このためです。ただしこれは1枚の画像での結果で、ほかの画像での精度を保証するものではありません。
プロファイルから仮説を立てて、実機で確かめる
ここからは、「どこに時間がかかっているか」を測り、「こうすれば速くなるはず」と仮説を立て、実機で確かめる、のくり返しです。
時間の内訳は、llama.cppの演算ごとの時間、PLの呼び出しごとの記録(準備・待ち・コピー)、HTTPリクエスト全体の時間の3つを突き合わせて取りました。二重に数えないよう、区間の和がリクエスト全体の時間と合うことを毎回確かめています。
答えが変わっていないことの確かめ方
速くしても答えが変わっては意味がありません。GrokBotは次の2段で確かめました。
- qemuでの全桁比較:実機と同じArm向けのバイナリを、box(GrokBotの作業用Linux)のqemu(Cortex-A53)で動かします。PLと同じ足し算の順番をPS(Cortex-A53)の計算で再現するモードがあり、その確率と実機の確率を全桁で比べます。
- 答えの合格基準:PLを使わずPSだけで計算した答えと比べて、全問で選ぶ答え(yes/no)が同じで、yesの確率の差が0.02以内(0.5〜0.8の迷っている問いは0.05まで)。
以下の「採用」は、すべてこの2つを通ったものです。
PLに回っていなかった行列積を回す(採用)
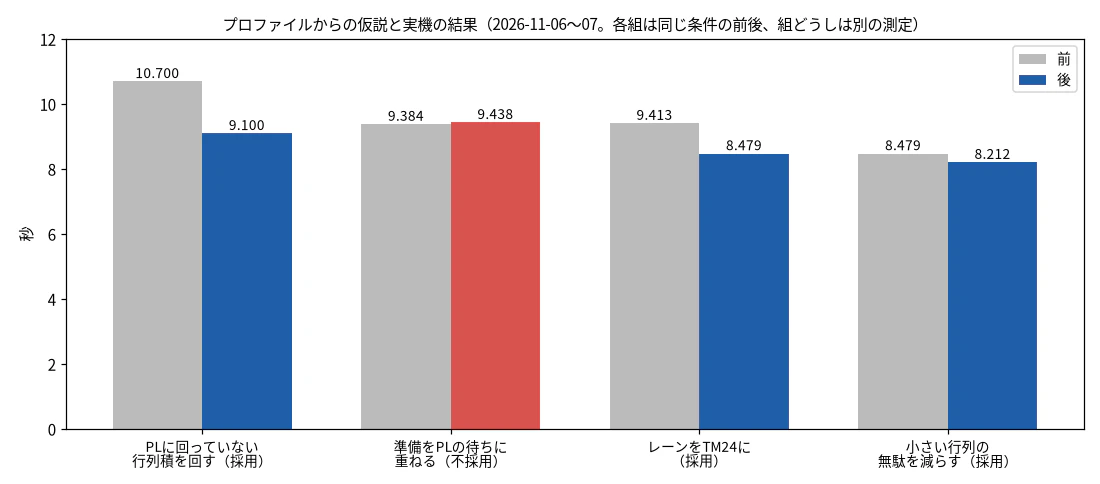
内訳を見ると、5問をまとめて計算する部分が重く、その中にPLに回っていない行列積(ssm_out)が残っていました。行列の形がフックの想定と違っていたためです。形を畳んでPLへ回しました(2026-11-06、前は1回、後は3回の中央値)。
5問をまとめた部分は5.001秒から3.354秒に、リクエスト全体は10.700秒から9.100秒になりました。
PSの準備をPLの待ち時間に重ねる(不採用)
PLが計算している間、PSは待っています。その間に次の行列積の準備をすれば速くなるはず、という仮説です。行列を分けて非同期に動かしてみると、準備を重ねられたのは0.145秒だった一方で、キャッシュの同期(sync_for_device)が0.078秒から0.708秒に増え、全体は9.384秒から9.438秒へかえって遅くなりました(各3回)。採用しませんでした。
レーンを太くする・小さい行列の無駄を減らす(採用)
行列積が計算の速さで決まっているなら、レーンを増やせば速くなるはずです。TM16をTM24(24行)にすると9.413秒から8.479秒(−9.9%)、さらに小さい行列で1段にかかる最低のサイクル数を見直すと8.212秒になりました(各3回)。
比べ方を間違えた失敗
PLとDDRをつなぐポートを増やした版を測ったとき、一度「28.826秒に大幅に悪化した」という結果が出ました。ところが調べ直すと、この測定に使ったホスト側のプログラムからは、共通の前置きの共有・画像の埋め込みのキャッシュ・PSの演算の高速化が抜けていて、画像を5回エンコードしていました。仕事量が違っていたのです。比べ方が成り立っていなかったので、「回路が悪くなった」という結論は取り消しました。以後、比べるときは実行の設定・画像・質問・回数を記録で照合してから比べるようにしています。
エンジンを2本にする(採用)
同じTM16のエンジンを2本載せ、行列積を2本に分けて計算させました。同じ回路・同じソフトで、片方だけ使った場合と比べています(2026-11-07、各3回)。
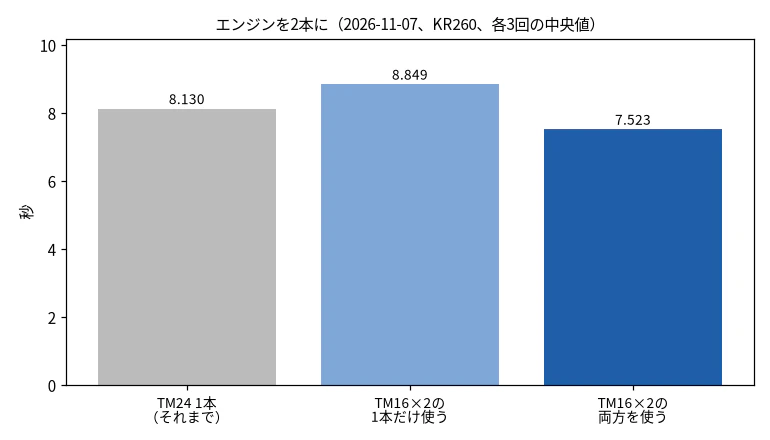
配置配線の結果は、200MHzでタイミングの余裕(WNS)+0.034ns、使用量はLUT 94,426(80.6%)、DSP 1,062(85.1%)、URAM 64(100%)です。PLはほぼいっぱいになりました。
うまくいかなかった案:エンジンをもっと増やす・重みを4bitにする
TM8×4(エンジン4本)
1本を細く(TM8)して4本に分ければ、DDRとつなぐポートを4つ使えて速くなるのでは、という仮説です。実機では正しく動き(単体試験1,199件すべて合格、答えの基準も合格)、200MHzでタイミングも通りました(WNS +0.011ns)。しかしLUTは91.10%、CLBは99.93%とほぼ満杯で、時間はTM16×2の7.504秒に対して7.587秒(+1.10%)と速くなりませんでした(各3回。小さな標本なので、遅くなったとまでは言えません)。行レーンの合計は32で同じなので並列度は増えず、4つのポートも同じDDRを分け合うだけでした。採用しませんでした。
重みを4bit(W4)にして、レーンを倍に
「重みを8bitから4bitにすれば乗算器が小さくなり、浮いた資源でTM16×2をTM32×2にできる」という仮説です。
まずエンジン1個をHLSで合成して資源の見積りを比べました。
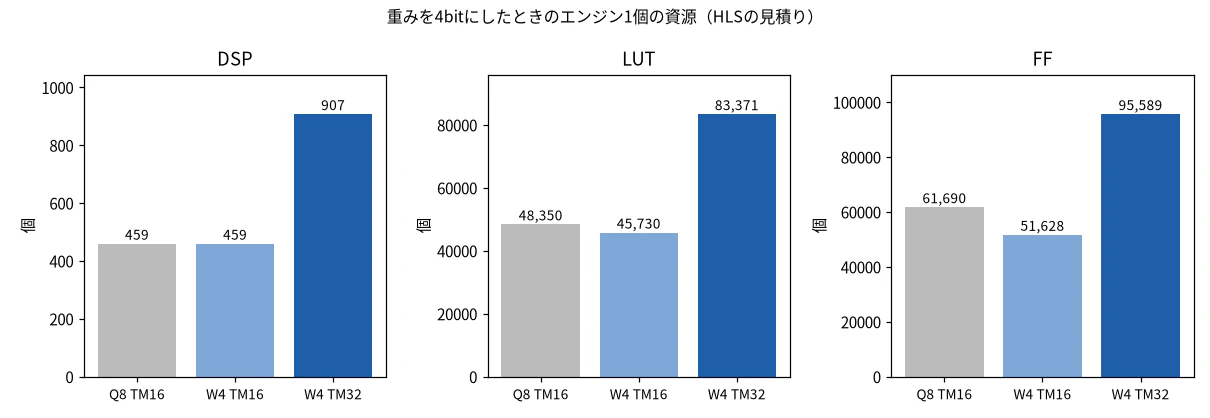
W4にしてもDSPは459のまま減りませんでした。W4 TM32を2個並べると、DSPは1,814(K26の総量1,248)、LUTは166,742(同117,120)で、どちらもはみ出す見積りです。この設計では、仮説は支持されませんでした。
そこで尺度の持ち方を変えた別の設計(行ごとに尺度を持つW4、TM32×2)を作り、実機で測りました(2026-11-09、各3回)。
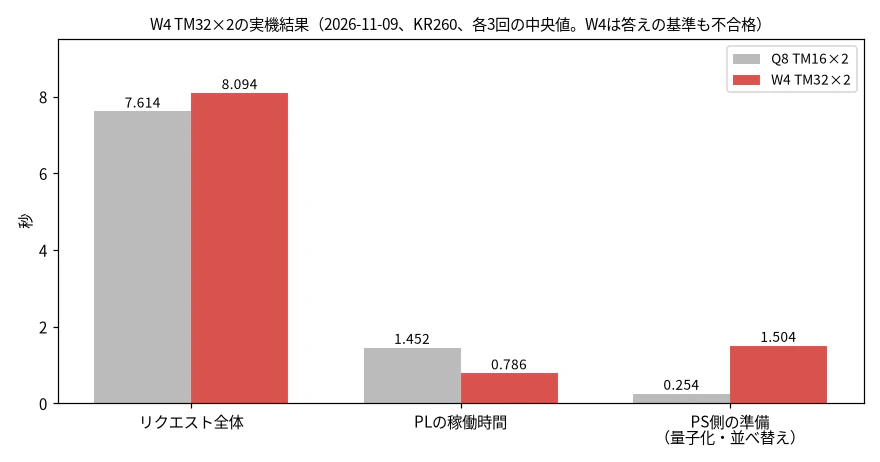
リクエスト全体は7.614秒から8.094秒になりました。PLの部分は狙いどおり約半分になりました。ところが、PS側で画像用の重みを毎回4bitへ変換する処理などが増え、全体では遅くなりました。さらに答えも、PSだけの答えと比べて3問でyes/noが反転し、基準に不合格でした。採用しませんでした。
小さな計算をまとめる:5問を1つのグラフに
何が無駄だったか
ここで内訳を見直すと、PLの時間は「段数×max(N, 40)サイクル」でほぼ決まっていました。Nは一度に計算するトークン数です。40は積和の累算器が同じ場所に戻ってくるまでの最小の間隔で、N=1でもN=40と同じ時間がかかります。DDRの帯域が足りないのではありません(帯域の使用率は2本合わせて約26%)。
5問は、画像と共通の前置き(143トークン)を1回だけ計算して共有し、その後ろの問いの部分を計算します。問いの長さが44・42・43・44・45トークンとそろっていないため、計算が「5×42トークン」と「2・3・2・1トークン」の小さな4つのグラフに分かれていました。この小さな4つの合計が1.17秒あり、1回のリクエストの約15%でした。
言い換えでそろえる(不採用)
最初の案は、問いの文を言い換えて長さをそろえることでした。ところが、全問を45トークンに言い換えると、cablesの答えがyesからnoに反転しました(yesの確率0.5195→0.4608)。迷っている問いは、言い換えだけで答えが変わります。morilabさんからも「問いのトークン数をそろえる、という制約は使う側に重すぎる。長さの上限だけなら受け入れられる」と指摘があり、この案はやめました。
詰め物とマスクでそろえる(採用)
次の案は、問いの文を変えずに、短い問いの後ろに詰め物を足して長さをそろえ、詰め物はどこからも見えないようにマスクする方法です。
ここで1つ落とし穴がありました。このモデルの注意は非因果(同じまとまりの中のトークンが互いに見える)で、単に詰め物を足すと答えのトークンから詰め物が見えて、確率が変わってしまいます。そこで、詰め物の位置をどのトークンからも見えないようにマスクし、答えを読む位置は本物の最後のトークンのままにしました。詰め物を入れた分は、答えを返したあとに消します。
あわせて、最後の出力層(約25万語ぶんの行)は、判定に使う2行(AとBのラベル)だけを計算するようにしました。判定専用の使い方で、文章の生成には使えません。
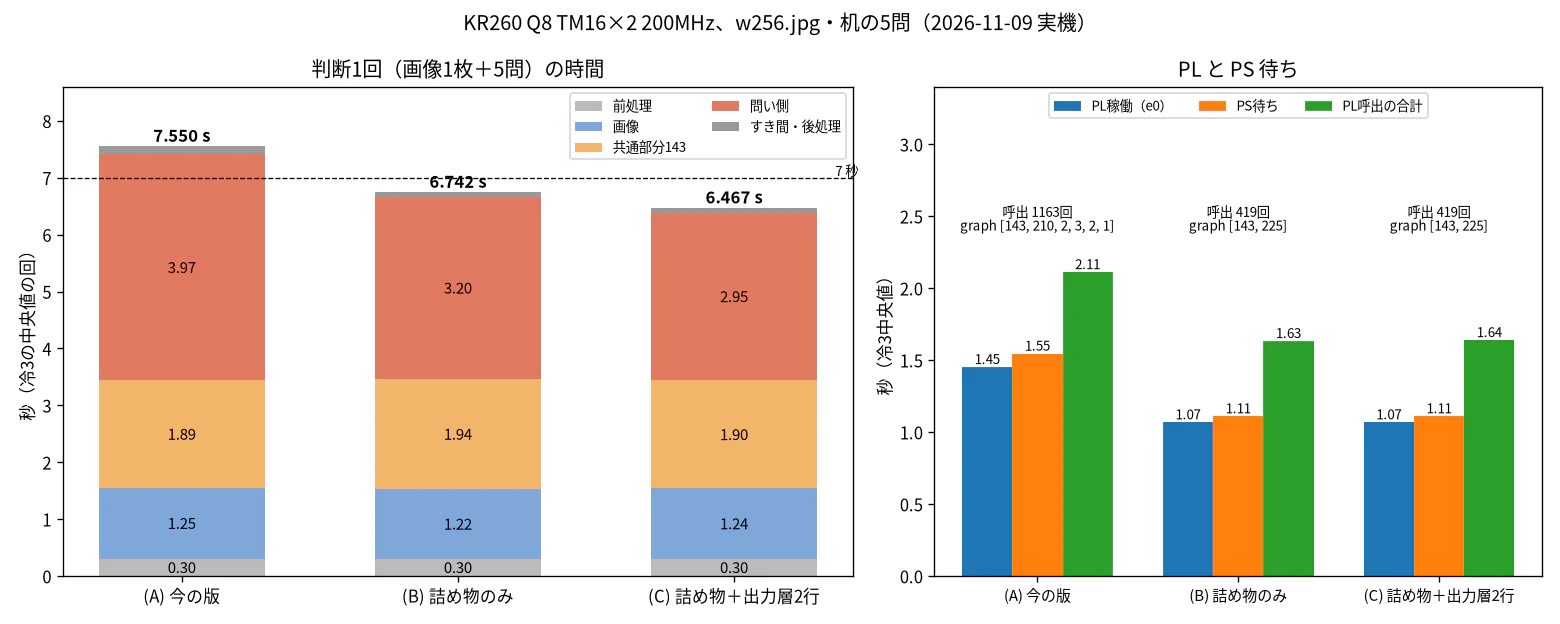
判断1回は、7.550秒から、詰め物だけで6.742秒、出力層の2行化も足して6.467秒になりました(各3回の中央値)。PLの呼び出しは1,163回から419回に、計算グラフは「143, 210, 2, 3, 2, 1」の6個から「143, 225」の2個になりました。
詰め物の分だけ計算量は1.7%増えますが、PLの呼び出しは744回減りました。実機の確率は、qemuでの予測と全桁一致しました。問いの長さがばらばらな別の5問でも、自動で3つのまとまりに分けて7.843秒から6.965秒になりました。
画像の注意とKVの詰め物
6.467秒のうち、画像(約1.2秒)と共通の前置き143トークン(約1.9秒)は、まだ手を付けていませんでした。ここで2つ入れました。
- 画像の注意の速い版:画像エンコーダのアテンションを、答えが全桁同じままの速い計算の仕方に変える。
- KVの詰め物:アテンションで参照するKVの長さを、詰め物で32の倍数にそろえる。
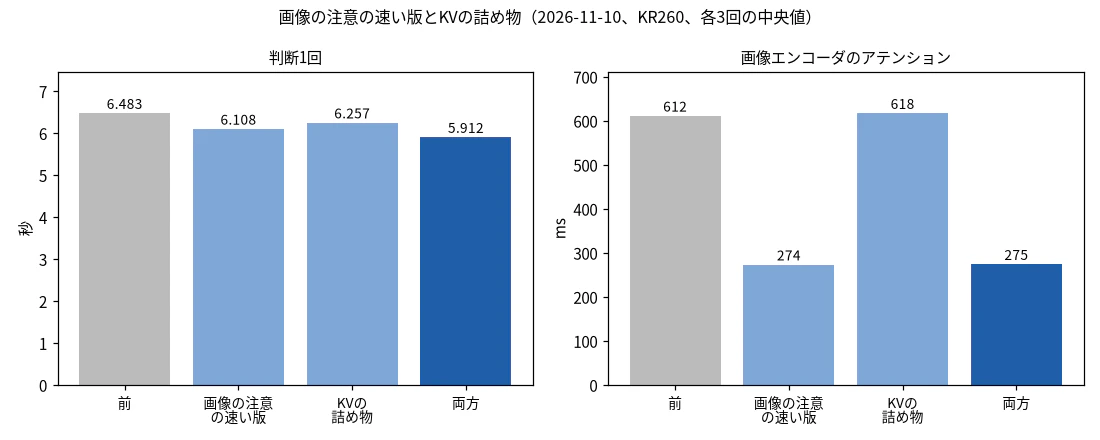
判断1回は6.483秒から、画像の注意の速い版で6.108秒、KVの詰め物で6.257秒、両方で5.912秒になりました。画像エンコーダのアテンションは612msから274msです。
2つの効果はほぼそのまま足し算になり、ここで6秒を切りました。答えは4構成・12回すべてでqemuと全桁一致しました。
GDNのNEON改良と、PSとPLの重ね合わせ
PSとPLを重ねる(採用)
前に「PSの準備をPLの待ちに重ねる」案は失敗しました。今度は、1回の行列積をトークン方向に2つに分け、PLが前半を計算している間に、PSが後半の量子化と、前の結果のコピーをするようにしました。各16回の交互の測定で、中央値は5,956msから5,854ms(−102ms)になりました。計測の前に予測した−74〜−134msの範囲に入っています。
一方、PLの出力をPSのコピーなしで直接書かせる案も試しましたが、行列積の時間は縮んだものの、後ろのGDNが遅くなり、上乗せの効果は誤差の範囲でした。こちらは採用していません。
GDNのNEON改良(採用)
PLへ移さずに残したGDNは、すでにNEONで書いてありました。GrokBotは、内側のループで扱う行を4行から8行に増やし、データを連続に並べ直すなどして、答えが全ビット同じまま速い版を作りました。さらに、Cortex-A53で命令ごとのサイクル数を実測し、128bitの読み込みが浮動小数の計算と重ならないことが速さを決めていると突き止めています。
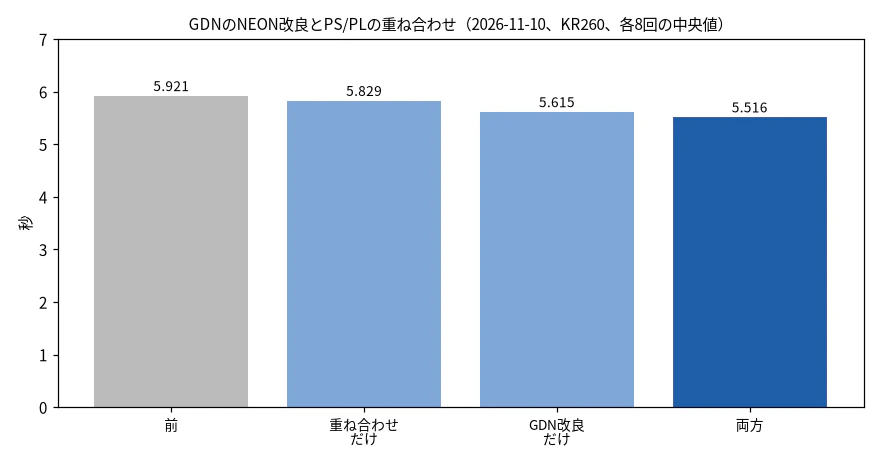
GDNの時間は1,392msから1,083msになりました。判断1回は、重ね合わせだけで5,921msから5,829ms、GDN改良だけで5,615ms、両方で5,516msです。
これでKR260の判断1回は5.516秒(この組の8回の中央値)になりました。2つの改良の効果は、ほぼそのまま足し算になっています。答えは全32回でqemuと全桁一致し、GDNの結果を元の版で計算し直して比べる確認モードでも2,304件すべて一致でした。
Ubuntu 24.04から22.04へ移す
ここまでの計測は、Ubuntu 24.04(カーネル6.8)を入れたKR260で行いました。最後に、同じ2本エンジンのPL回路とソフトを、手元にあったUbuntu 22.04(カーネル5.15)入りのKV260へ移しました。KV260だから22.04というわけではなく、たまたま手元のKV260がこの版だったというだけです。ここで困ったのは、ボードの違いよりもOSの版の違いでした。
- 24.04で作ったllama-serverが、22.04では動きませんでした。 24.04のコンパイラ(gcc 13.3、glibc 2.39)で作ったバイナリはGLIBC_2.38を要求し、22.04のglibcは2.35だからです。GrokBotは、ソース・パッチ・cmakeの設定を変えず(新旧の設定の差は0件)、Ubuntu 22.04のクロスコンパイラ(gcc 11.4、glibc 2.35)で作り直しました。できたバイナリが要求するglibcは2.34までです。作り直した2版とも、qemuで答えが元のバイナリと全桁一致しました。
- カーネルが6.8から5.15に変わるので、PLとのデータの受け渡しに使うカーネルモジュール(u-dma-buf)を作り直しました。 ソースは変えず、ボード上の5.15のヘッダでビルドし直しただけで、560MiBのバッファを同じように確保できました。
- ボード上でビルドする小さなプログラム(PLの単体試験、カメラ画像の取り込み)も、22.04のgcc 11.4で作り直しました。
- ライブラリは22.04の標準のもので足りました(libstdc++はGLIBCXX_3.4.30まであり、
lddで見つからないものはありませんでした)。
OSの版とは別に、ボードに最初から載っていたPLのアプリ(k26-starter-kits)を外しても、そのデバイスの登録が残っていて同じ割り込みを取り合い、PLのエンジン2本のうち1本が登録できないということがありました。古い登録を外してから付け直す手順を、起動の手順に入れています。
PLの単体試験は21形すべて合格し、大きな行列で1本14.229ms、2本で7.170msと、KR260と同じ速さでした。
KV260で最初に測ったとき(11月10日)は、OSの自動更新(unattended-upgrades)がボードのCPU(PS)のコアを1つ使い続けていて、約2倍遅い値(12秒前後)が出ました。答えは同じでしたが、この回は捨てて測り直しています。
KV260でライブのカメラ映像を判断させたときの時間は、6回の中央値で5.231秒でした(映像が毎回少しずつ違うので、下の測定とは別の条件です)。
KR260とKV260を各30回で比べる
最初に移したとき(11月10日、KR260は各8回、KV260は各5回)はKV260のほうが速く出ましたが、回数が少なかったので、11月17日に両方のボードで、GDN改良・重ね合わせの前と後を各30回(fresh cold)測り直しました。答えは120回すべて同じでした。
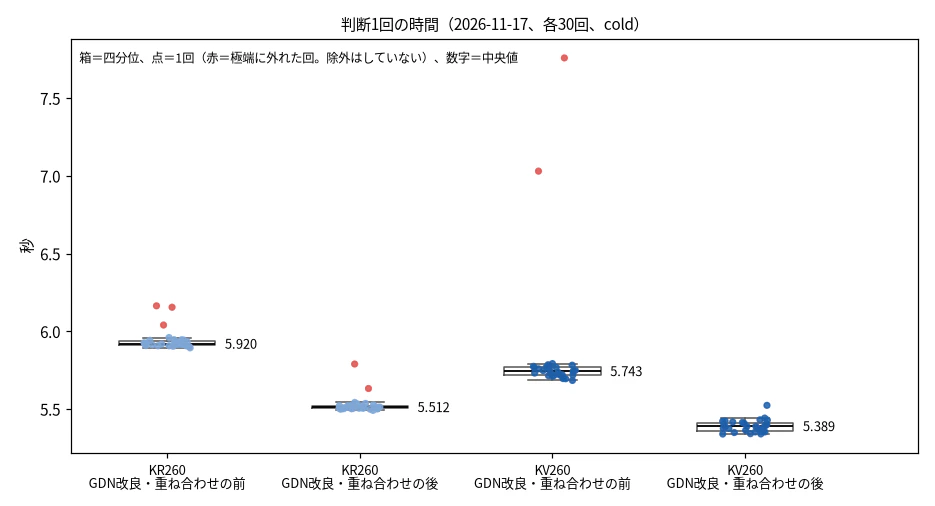
| ボード | GDN改良・重ね合わせの前 | 後 |
|---|---|---|
| KR260(Ubuntu 24.04) | 5.920秒(四分位 5.910〜5.941) | 5.512秒(5.505〜5.522) |
| KV260(Ubuntu 22.04) | 5.743秒(5.718〜5.769) | 5.389秒(5.361〜5.413) |
中央値です。図の赤い点は、ほかの回から極端に外れた回(KR260で5回、KV260で2回。最大はKV260の改良前の7.759秒)で、印を付けただけで除外はしていません。
前編と同じ6つの区切りで分けると、次のとおりです(区切りごとの30回の中央値)。
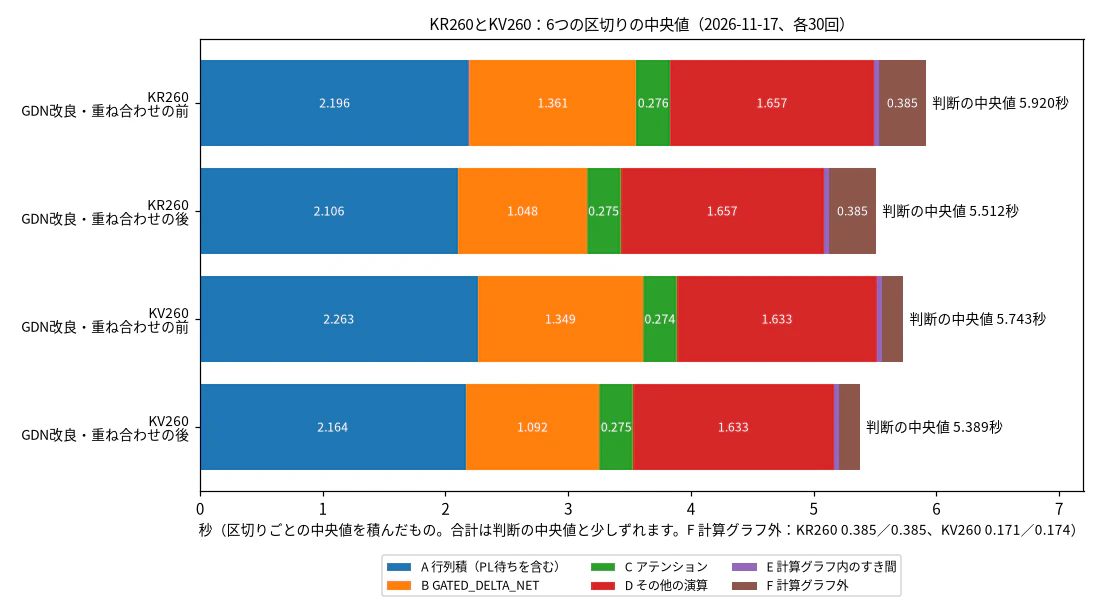
KV260が速い分のほとんどは「F 計算グラフ外」(KR260で0.385秒、KV260で0.171〜0.174秒)で、そのうち、リクエストを出してから最初の計算グラフが始まるまで(以下pre)がKR260で0.303秒、KV260で0.090秒と、約0.21秒違いました。逆に、GDN改良・重ね合わせの後の版では、KV260のほうが「B GDN」で0.044秒(1.048秒→1.092秒)、「A 行列積」で0.059秒遅くなっています。GrokBotは、この2つの差の原因を確かめました。
preの約0.21秒は、計測用Pythonの版の違い
判断時間を測るスクリプトはPythonで書いていて、ボード上で動かし、同じボードのllama-serverに要求を送っています。このPythonが、Ubuntu 24.04では3.12.3、22.04では3.10.12です。Python 3.12のurllibは、最初の要求を送るときに、送り先が暗号化しないhttp://でも、SSLの設定(証明書の読み込み)を作ります。
PLもllama-serverも使わず、Pythonだけで新しいプロセスの1回目を各10回測ると(中央値)、次のとおりでした。
| KR260(Python 3.12.3) | KV260(Python 3.10.12) | |
|---|---|---|
| SSLの設定を作る | 215.2ms | 6.7ms |
| 最初の要求(urlopen) | 219.2ms | 7.2ms |
KR260でも、2回目の要求は2.7msでした。
そこで、計測スクリプトの写しを作り、時間を測り始める前にurllibの準備を済ませる1行だけを足して、元のスクリプトと交互に各10回測りました(GDN改良・重ね合わせの前の版)。
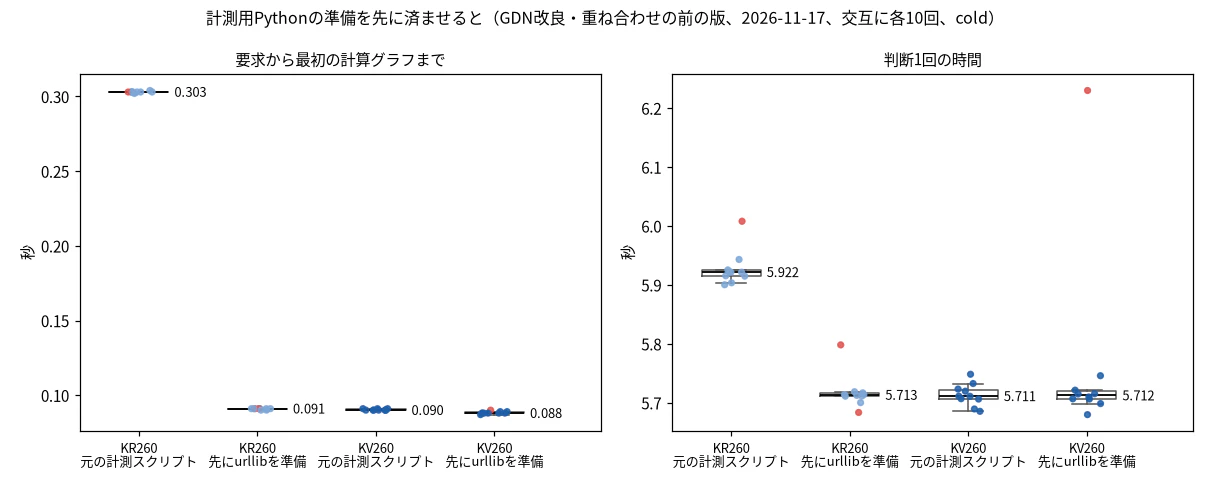
KR260では、preが0.303秒から0.091秒に、判断1回が5.922秒から5.713秒になりました(中央値)。KV260はpreが0.090秒と0.088秒、判断1回が5.711秒と5.712秒で、変わりませんでした。準備を済ませたKR260は、KV260とほぼ同じ値です。
つまり、KV260が速く見えた理由は、ボードやOSの速さではなく、計測に使ったPythonの版の違いでした。llama-serverが要求を受け取ってから後の時間は、2つのボードで1ms以内の差でした(サーバーのログで確認)。なお、GDN改良・重ね合わせの後の版をKR260で「準備済み」にして測ることはしていません。
GDNの差は、コンパイラの違い
KV260で動かしているllama-serverは、22.04のgcc 11.4で作り直したものです。22.04で作ったバイナリは24.04でも動く(要求するglibcが2.34まで)ので、同じKR260で、24.04で作った版と22.04で作った版を交互に各15回測りました。答えは60回すべて同じでした。
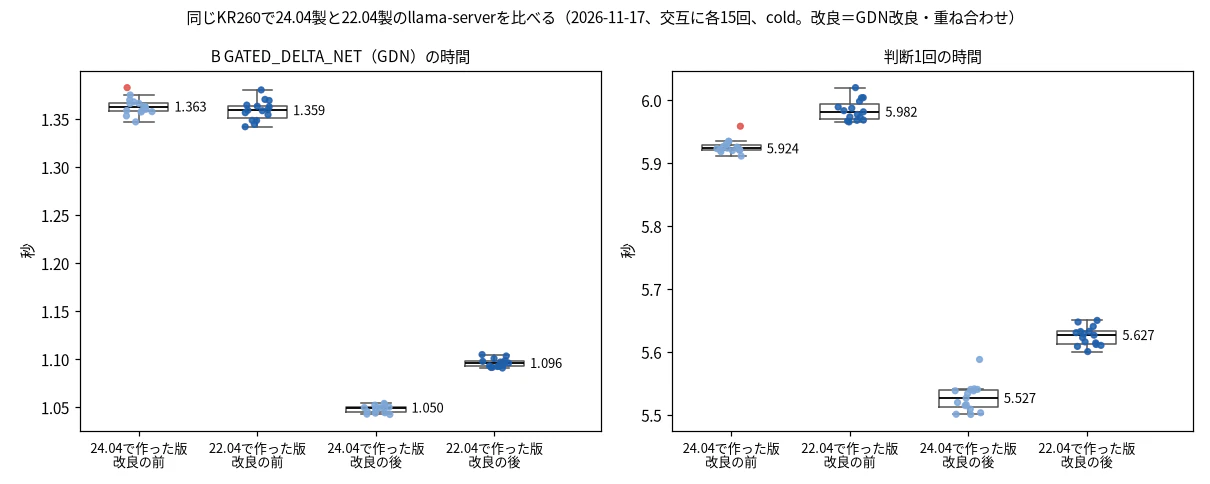
| KR260で動かした版 | B GDN | 判断1回 |
|---|---|---|
| 24.04で作った版、改良の前 | 1.363秒 | 5.924秒 |
| 22.04で作った版、改良の前 | 1.359秒 | 5.982秒 |
| 24.04で作った版、改良の後 | 1.050秒 | 5.527秒 |
| 22.04で作った版、改良の後 | 1.096秒 | 5.627秒 |
同じボード・同じOSでも、22.04で作ったGDN改良版はGDNが1.096秒で、KV260の1.092秒とほぼ同じになりました。改良前の版では差がありません。機械語を比べると、GDN改良版の一番内側のループが、gcc 13.3では57命令、gcc 11.4では60命令(スタックからの読み直しが3回から5回に増える)でした。単体の速さの比較(1要素あたり2.27nsに対して2.39ns、改良前の版は2.78nsと2.77nsで差なし)とも合います。
また、22.04で作った版は、改良の前も後も「A 行列積」が約0.06秒遅くなりました(2.201秒→2.262秒、2.107秒→2.165秒)。この原因はまだ調べていません。
5.3秒台
GDN改良・重ね合わせの後の版は、計測用Pythonの準備の時間がほとんど入らないKV260の実測で5.389秒(30回の中央値)でした。Pythonの準備分を除くと、KV260の実測で5.3秒台まで来ています。
5秒台までのまとめ
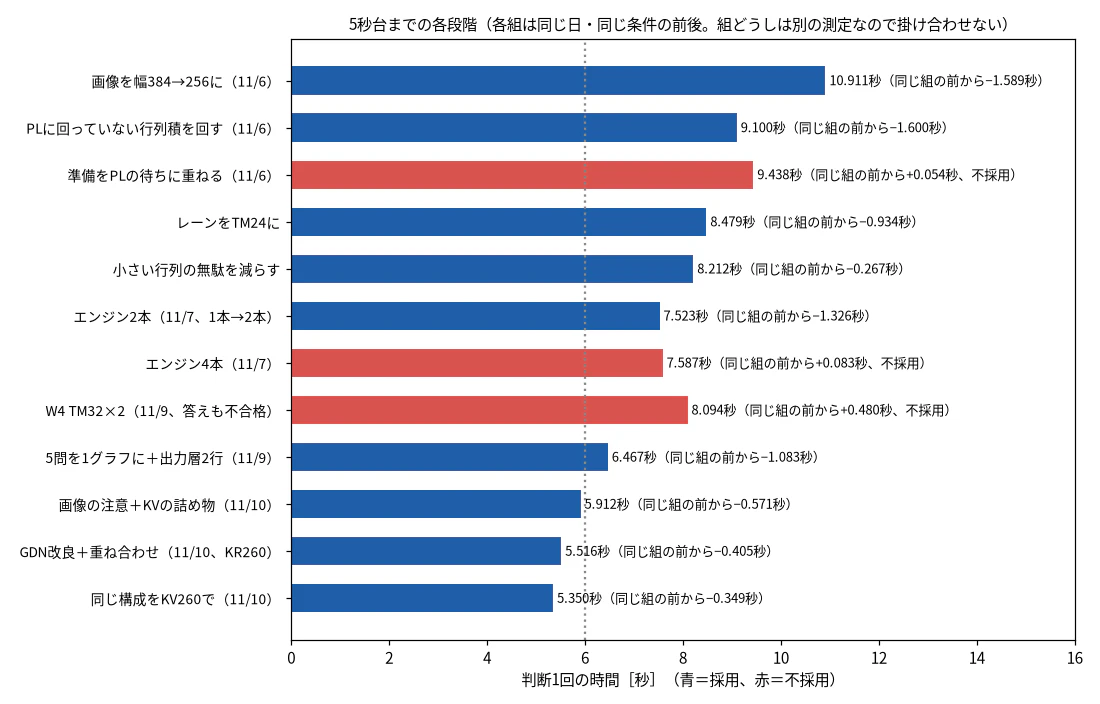
この図に入れていない最初の一歩は、行列積をPLへ移したこと(計算グラフの和で120.5秒→27.8秒、384ピクセル・4問)です。
- PLに任せたのは行列積だけです。残りはPSのNEONで書き直し、PSとPLの重ね合わせで待ち時間を減らしました。
- 速くなった段階の多くは、「回路を大きくする」ではなく、「PLの呼び出しの無駄をなくす」「PSに残った処理を速くする」でした。回路を大きくする案(エンジン4本、W4でレーン倍)は、どちらも速くなりませんでした。
- KR260(Ubuntu 24.04)とKV260(Ubuntu 22.04)の差は、計測用Pythonの版(要求から最初の計算グラフまで約0.21秒)と、llama-serverを作ったコンパイラ(GDNで約0.05秒)の違いでした。Pythonの準備分を除くと、KV260の実測で5.3秒台(5.389秒、30回の中央値)です。
- 前編のものさしと並べると、5秒台はノートPCのCPU 1スレッド(5.970秒)をわずかに下回る程度で、2スレッド(3.404秒)には届いていません(測った回数が違うので、1スレッドとの差は目安です)。
次回
KV260の実測で5.3秒台まで来ましたが、そのうちPLが動いているのは約1.1秒で、残りの大部分はKR260やKV260のPS(Cortex-A53)での計算です。PSの速さには限りがあります。
後編は、Stratix Vを載せた安価なNIC基板(AliExpressで5千円ほど)を使って、PSに残っている計算もFPGA側に持っていく挑戦です。