
この記事はプロモーションを含みます(筆者が作った Kindle 問題集の紹介と、Amazon のアソシエイトリンク)。
生成AIパスポートの受験を考えている方へ。
この試験は過去問が公開されていません。公式に公開されているのは、サンプル問題(例題3問)だけです。
そのため「本番でどんな問題が出るのか分からない」「公認テキストを読んだあと、何で練習すればいいか分からない」と悩む方が多い試験です。
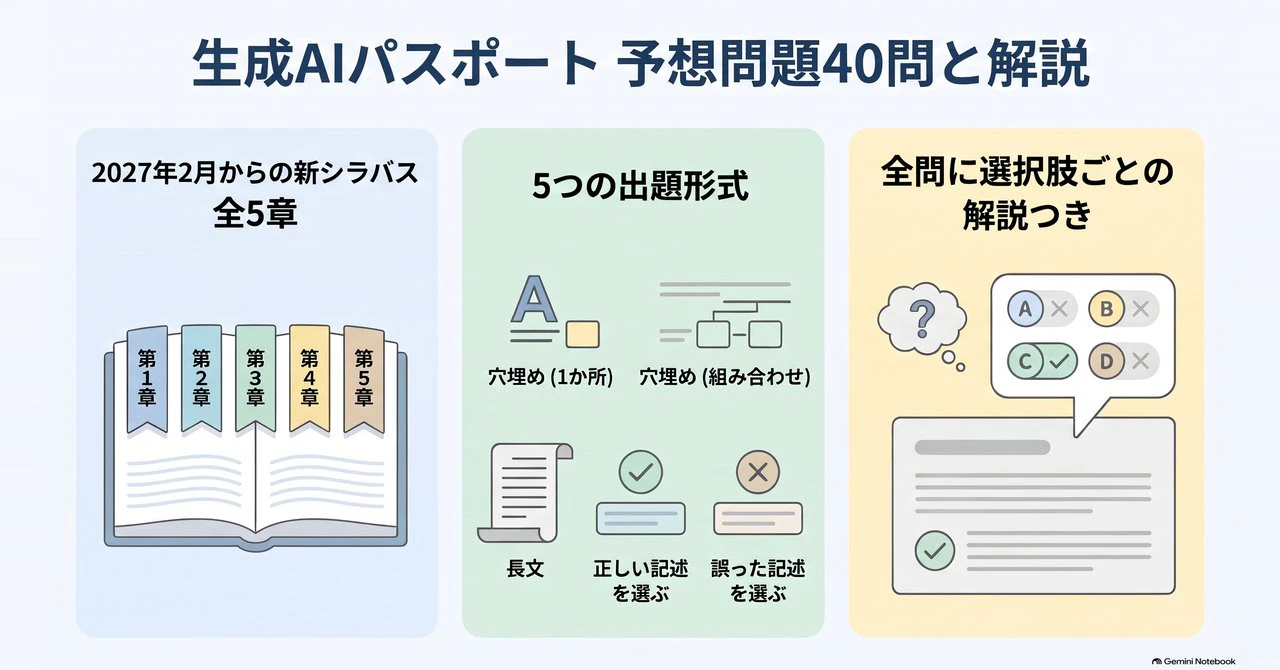
この記事では、過去問の代わりに、2027年2月の試験からの新しいシラバスの章立てに沿って、公認テキスト『最短攻略!生成AIパスポート 公認テキスト&問題集』の内容と公開資料から作ったオリジナルの予想問題を、全5章・5つの出題形式で、合計40問、解説つきで無料公開します。
試験は60問・60分の四肢択一(一部に複数選択)で、IBT(自宅などのパソコン・スマホで受けるオンラインの試験)で年5回(2・4・6・8・10月)行われます。2027年2月の試験から、シラバスが新しくなり、第3章が「AIエージェント」になるなど章立てが変わります(公式ページ)。
試験の概要・難易度・勉強法は、生成AIパスポートの攻略ガイド(note)にまとめています。
この記事の問題について
- 2027年2月の試験からの新しいシラバスの全5章から、5つの形式を1問ずつ(長文は1題4問)選んでいます。
- 第3章「AIエージェント」など新しいシラバスで加わった内容は、新しい公式テキストの発売前に、シラバスと公開資料から作った予想問題です。法令・ガイドライン・サービスの内容は2026年10月時点の情報にもとづいています。
- 解説では、正解の理由だけでなく、ほかの選択肢がなぜ違うのかも書いています。
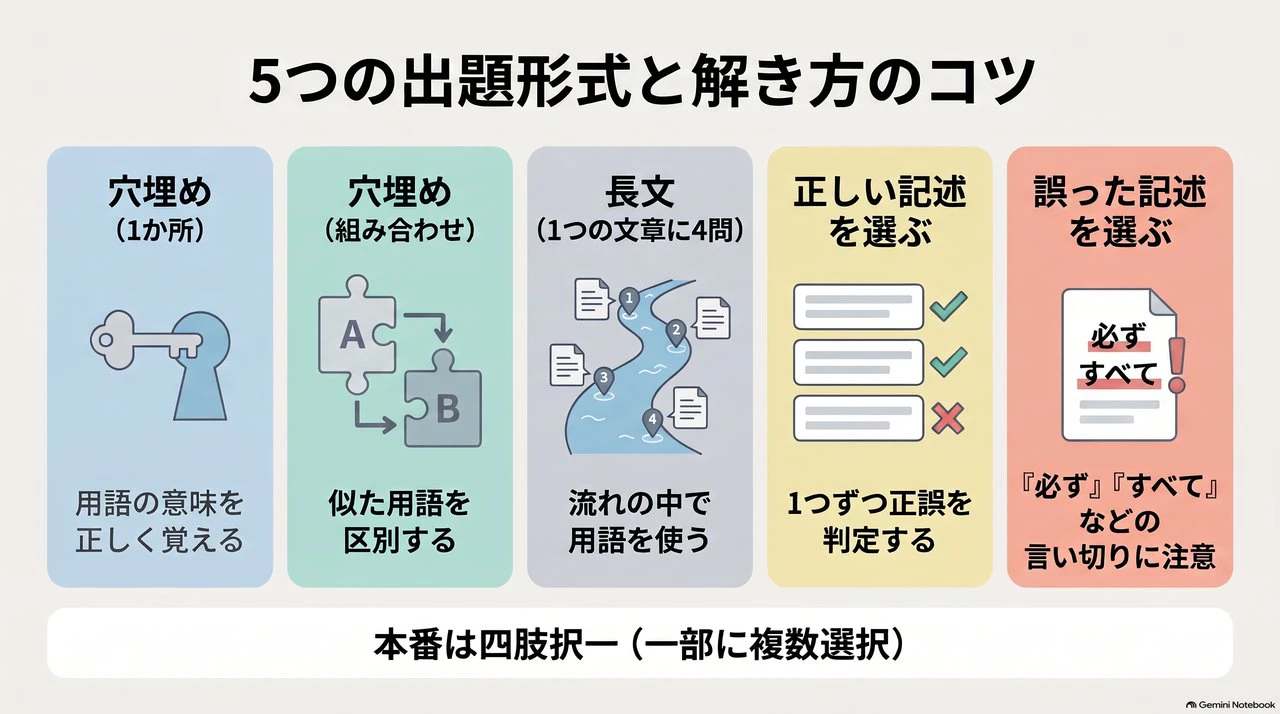
本番は四肢択一(一部に複数選択)で、出題形式の内訳は公表されていません。この記事の問題は、いろいろな角度から知識を確かめられるように、次の5つの形式で作っています。
- 穴埋め(1か所)
- 穴埋め(組み合わせ)
- 長文(1つの文章に4問)
- 正しい記述を選ぶ
- 誤った記述を選ぶ
もっと多くの問題で練習したい方のために、Kindle の問題集も出しています(記事の最後で紹介します)。
第1章 AIの基礎と歴史
形式1:穴埋め(1か所)
次の空欄[1]にあてはまる最も適切な語句を、1~4の選択肢の中から一つ選びなさい。
第2次AIブームで期待されたエキスパートシステムが次第に下火となった主な要因として、専門家の知識を正確に定義・分析して取り込むことが非常に難しく、蓄積された情報やルールの [1] が困難になったことが挙げられる。
- 管理やアップデート
- 処理速度の高速化
- ハードウェアの小型化
- 通信コストの削減
正解と解説を見る
正解:1
専門家の知識を正確に取り込むのが難しく、取り込んだ知識が増えるほど管理やアップデートが困難になったことが、エキスパートシステムが下火になった要因である。
各選択肢の解説
- 管理やアップデート: 【正解】知識が増えるほど管理やアップデートが難しくなったことが、第2次ブームが衰えた理由である。
- 処理速度の高速化: 処理速度の高速化は衰退の要因ではなく、知識の取り込みや管理の難しさという本問の課題とは関係しない。
- ハードウェアの小型化: ハードウェアの小型化は衰退の要因ではなく、知識の管理という本問の課題とは別である。
- 通信コストの削減: 通信コストの削減は衰退の要因ではなく、専門家の知識を管理し続ける困難さとは関係しない。
形式2:穴埋め(組み合わせ)
次の空欄[1]・[2]にあてはまる語句の組み合わせとして最も適切なものを、1~4の選択肢の中から一つ選びなさい。
自社の顧客対応業務を改善する際、過去の不備件数や問い合わせ内容に正確な正解タグが付与されている場合は [1] を用いて分類モデルを構築するのが適している。これに対し、事前の分類ラベルが存在しない大量の購買データから未知の顧客セグメントを把握したい場合は [2] を利用するのが有効である。
- [1] 教師あり学習 [2] 教師なし学習
- [1] 強化学習 [2] 教師あり学習
- [1] 教師なし学習 [2] 強化学習
- [1] 半教師あり学習 [2] ルールベース
正解と解説を見る
正解:1
正解ラベル付きのデータで分類モデルを作るのが教師あり学習で、ラベルのないデータから共通項を見つけるのが教師なし学習である。
各選択肢の解説
- 教師あり学習 / 教師なし学習: 【正解】正解タグがある場合は教師あり学習、ラベルがない場合は教師なし学習で、どちらも正しい。
- 強化学習 / 教師あり学習: 強化学習は報酬で行動を学ぶ方法で空欄(1)に合わず、教師あり学習はラベルが必要なので空欄(2)にも合わない。
- 教師なし学習 / 強化学習: 教師なし学習はラベルのない場面向きで空欄(1)に合わず、強化学習は報酬で行動を学ぶ方法で空欄(2)にも合わない。
- 半教師あり学習 / ルールベース: 半教師あり学習は一部にだけラベルを使う方法で空欄(1)に合わず、ルールベースは人間が条件を定める方式で空欄(2)にも合わない。
形式3:長文(1つの文章に4問)
次の文章を読んで4つの問題に答えなさい。
企業でAIを導入する際、学習方法の特性を理解することが重要である。正解データが存在しないデータ群からAI自身が共通項や特徴を見つけ出し、グループ分けを行う手法は [1] と呼ばれ、顧客の属性分析や異常検知などに活用される。一方、特定の目的達成に向けて、AIの試行錯誤に対して成功には報酬、失敗にはペナルティを与えることで最適な行動パターンを学習させる手法は [2] である。また、AIの学習が進みすぎると、訓練データに過剰に適合して未知のデータに対応できなくなる [3] という現象が発生する。これを防ぐアプローチとして、学習時に一部の人工ニューロンをランダムに休ませることで特定のノードへの過度な依存を抑える手法を [4] と呼ぶ。
問1
文章中の空欄 [1] に入る最も適切な用語を選びなさい。
- 教師なし学習
- 教師あり学習
- 強化学習
- ルールベース
正解と解説を見る
正解:1
正解ラベルの付いたデータを使わず、AI自身が共通項を見つけてグループ分けする学習方法が教師なし学習である。クラスタリングや次元削減が代表的な手法で、異常データの検出にも役立つ。
各選択肢の解説
- 選択肢1: 【正解】教師なし学習は正解データがない状態でAIが共通項を発見して学習する方法であり、空欄(1)の説明に合う。
- 選択肢2: 教師あり学習は正解ラベル付きのデータで学習する方法であり、正解データが存在しない空欄(1)の状況には合わない。
- 選択肢3: 強化学習は報酬とペナルティで最適な行動を学ぶ方法で、空欄(2)に当たり、グループ分けの手法ではない。
- 選択肢4: ルールベースは人間が定めた条件で判断させる方式であり、データから共通項を見つけて分ける手法ではない。
問2
文章中の空欄 [2] に入る最も適切な用語を選びなさい。
- 半教師あり学習
- 転移学習
- 強化学習
- クラスタリング
正解と解説を見る
正解:3
目標達成に関する条件を設定し、成功には報酬、失敗にはペナルティを与えて、AI自身に最適な行動を学ばせる方法が強化学習である。
各選択肢の解説
- 選択肢1: 半教師あり学習は少量のラベル付きデータと大量のラベルなしデータを併用する方法で、報酬による学習ではない。
- 選択肢2: 転移学習は学習済みモデルの知識を別のタスクに再利用する手法で、報酬とペナルティで行動を学ぶ方法ではない。
- 選択肢3: 【正解】強化学習は報酬とペナルティを経験しながら試行錯誤を重ね、最適な行動を学ぶ方法である。
- 選択肢4: クラスタリングは共通項でデータをグループ分けする教師なし学習の手法で、空欄(1)に関わるものであり、空欄(2)ではない。
問3
文章中の空欄 [3] に入る最も適切な用語を選びなさい。
- 次元削減
- 過学習(オーバーフィッティング)
- ハルシネーション
- アーリーストッピング
正解と解説を見る
正解:2
AIが訓練データに過剰に適合し、初めて見るデータの予測が外れやすくなる現象が過学習(オーバーフィッティング)である。機械学習の落とし穴の一つである。
各選択肢の解説
- 選択肢1: 次元削減は重要な情報だけを残してデータを単純化する手法であり、学習が進みすぎて未知のデータに対応できなくなる現象ではない。
- 選択肢2: 【正解】過学習は訓練データに過剰に適合し、未知のデータの予測がうまくいかなくなる現象である。
- 選択肢3: ハルシネーションはもっともらしいが事実と異なる回答が生じることであり、訓練データへの過剰な適合とは別である。
- 選択肢4: アーリーストッピングは学習を途中で打ち切る過学習の回避方法であり、現象そのものではない。
問4
文章中の空欄 [4] に入る最も適切な用語を選びなさい。
- 正則化
- ドロップアウト
- 転移学習
- アーリーストッピング
正解と解説を見る
正解:2
学習時にあえて一部の人工ニューロンを休ませ、特定のノードやネットワークの一部への依存を避けて過学習を抑える方法がドロップアウトである。
各選択肢の解説
- 選択肢1: 正則化はパラメータを制限して情報量を抑える方法であり、ノードを休ませる手法ではない。
- 選択肢2: 【正解】ドロップアウトは一部の人工ニューロンを休ませ、特定のノードへの依存を避けて過学習を防ぐ。
- 選択肢3: 転移学習は学習済みモデルの知識を別のタスクで再利用する手法で、過学習を防ぐ手法ではない。
- 選択肢4: アーリーストッピングは精度が伸びなくなった時点で学習を打ち切る方法で、ノードを休ませる手法ではない。
形式4:正しい記述を選ぶ
AIモデルの運用で課題となる「過学習(オーバーフィッティング)」に関する記述として、最も適切なものはどれか。
- 過学習とは、AIモデルの学習量が不足しているために、訓練データに対してもテストデータに対しても予測精度が出ない状態を指す。
- 過学習とは、AIモデルが訓練データに過剰に適合して細かなノイズまで記憶してしまい、新しく入力された未知データへの対応力が落ちる現象である。
- 過学習が発生すると、学習に使用していない新しく入力された未知の現場データに対して、予測精度が著しく向上する。
- 過学習はニューラルネットワークの層を浅くし、訓練データの量を大幅に減らすことで完全に防ぐことができる。
正解と解説を見る
正解:2
過学習(オーバーフィッティング)は、AIが訓練データに過剰に適合し、初めて見るデータの予測が外れやすくなる現象である。機械学習の落とし穴の一つとされる。
各選択肢の解説
- 選択肢1: 過学習は訓練データへの過剰な適合であり、学習量が足りず訓練データでも精度が出ない状態とする点が誤りである。
- 選択肢2: 【正解】訓練データに過剰に適合し、未知のデータへの対応力が落ちる現象という説明が正しい。
- 選択肢3: 過学習では未知のデータに対する予測がうまくいかなくなるため、精度が著しく向上するとする点が誤りである。
- 選択肢4: 過学習の回避方法はアーリーストッピング、正則化、ドロップアウトなどであり、層を浅くしデータを減らせば完全に防げるとする点が誤りである。
形式5:誤った記述を選ぶ
AIモデル選定におけるノーフリーランチ定理およびAI活用に関する記述として不適切なものを、1~4の選択肢の中から一つ選びなさい。
- 自社のあらゆる業務課題を解決できる万能な単一AIモデルを一度構築すれば、手法の選定や変更は一切不要となる。
- ノーフリーランチ定理とは、すべての問題に対して常に最高性能を発揮する万能な単一アルゴリズムは存在しないことを示す定理である。
- 特定の分野で高い成果を出したアルゴリズムであっても、異なる課題に対してそのまま適用した場合に同等の性能が出るとは限らない。
- ノーフリーランチ定理を踏まえると、実務では解決したい課題やデータの性質に合わせて適切な学習手法を選択する必要がある。
正解と解説を見る
正解:1
ノーフリーランチ定理は、すべての問題に対して最高の性能を示す万能なアルゴリズムは存在しないことを意味する。このため、機械学習ではタスクごとに適切な手法を選ぶ必要がある。
各選択肢の解説
- 選択肢1: 【正解】万能なアルゴリズムは存在せず、課題ごとに手法を選ぶ必要があるため、万能な単一モデルを一度作れば選定や変更が一切不要になるとする点が誤りである。
- 選択肢2: すべての問題に最高性能を示す万能な手法は存在しないという定理の内容そのものであるため、記述の通り正しい。
- 選択肢3: 万能なアルゴリズムがない以上、ある課題で成果を出した手法が別の課題で同等とは限らないため、記述の通り正しい。
- 選択肢4: 課題ごとに適切な手法を選ぶ必要があるといえるため、記述の通り正しい。
第2章 生成AI
形式1:穴埋め(1か所)
次の空欄[1]にあてはまる最も適切な語句を、1~4の選択肢の中から一つ選びなさい。
Transformerモデルの登場後、これをベースとして文章作成や対話を得意とするGPT系列と、文章の分析や文脈解釈を得意とするBERT系列に発展した。このうちGPTモデルは、事前学習データをもとに新しい文脈を組み立てる [1] 型のAIである。
- 分類予測
- 特徴抽出
- 画像再現
- 文章生成
正解と解説を見る
正解:4
GPTはTransformerを基盤とし、事前学習で得た知識をもとに新しい文章を作り出す文章生成型のAIである。質問に文章で答えたり続きを考えたりする処理を得意とする。
各選択肢の解説
- 分類予測: 分類予測は入力をカテゴリに振り分ける処理であり、GPTの特徴である新しい文脈の組み立てではない。
- 特徴抽出: 特徴抽出は入力から特徴を取り出す処理であり、新しい文章を作るGPTの型ではない。
- 画像再現: 画像再現は画像を扱う処理であり、文章作成を得意とするGPTの型ではない。
- 文章生成: 【正解】文章生成型は、学習結果をもとに人が書いたような自然な文章を新たに作る型で、GPTに当たる。
形式2:穴埋め(組み合わせ)
次の空欄[1]・[2]にあてはまる語句の組み合わせとして最も適切なものを、1~4の選択肢の中から一つ選びなさい。
BERTモデルでは、2つの文章が連続して示された際に、それが自然な文章の流れとして繋がっているかを判断する [1] という仕組みが採用されている。この技術による文脈理解力は、社内の問い合わせログから意味の近い回答や文書を抽出する [2] タスクで大きな効果を発揮する。
- [1] MLM [2] 動画自動生成
- [1] NSP [2] 検索・文章理解
- [1] 自己注意機構 [2] 画像識別
- [1] 位置エンコーディング [2] 音声合成
正解と解説を見る
正解:2
2つの文が自然につながるかを判定する仕組みがNSPである。文どうしの関係を理解する力は、検索や文章理解のようなタスクに生きる。
各選択肢の解説
- MLM / 動画自動生成: MLMは文の一部を隠して推測させる学習で、2文の連続判定ではない。動画自動生成もBERTの用途ではない。
- NSP / 検索・文章理解: 【正解】NSPは2文の自然なつながりを判定し、その理解力は検索・文章理解に生かせる。
- 自己注意機構 / 画像識別: 自己注意機構は単語間の重要度の仕組みで、2文の連続判定ではない。画像識別もBERTの用途ではない。
- 位置エンコーディング / 音声合成: 位置エンコーディングは語順を伝える技術で、2文の連続判定ではない。音声合成も該当しない。
形式3:長文(1つの文章に4問)
次の文章を読んで4つの問題に答えなさい。
近年の生成AI技術は単なるテキスト生成を超え、多様なデータの扱いや自律的なタスク実行へと急速に進化している。テキストだけでなく画像や音声など複数種類の情報を扱うモデルをマルチモーダルと呼ぶが、各種データを内部で個別に処理して統合する方式に対し、テキスト・画像・音声などを最初から単一の処理系で同時に理解・処理するモデルを [1] モデルと呼ぶ。また、生成AIの課題である事実と異なる出力を生成する [2] の発生を低減し、数学や高度なプログラミングなどの複雑な課題に対応するため、回答の速さよりも内部で思考プロセスを深めて精査する [3] 型のモデルが開発された。さらに最新の実務利用では、指示に応じてブラウザ操作やコード修正など人間側の業務タスクを代わりに完了まで実行する [4] の導入が進んでおり、ビジネスパーソンには単なるツール選定だけでなくリスク管理を踏まえた適切な業務プロセスの設計が求められている。
問1
文章中の空欄 [1] に入る最も適切な用語を選びなさい。
- マルチタスク
- シングルモーダル
- ルールベース
- オムニモーダル
正解と解説を見る
正解:4
空欄(1)は、テキスト・画像・音声・動画などを最初から1つの流れで統合的に理解・処理するモデルである。種類ごとに個別処理して合成する従来方式とは異なる。
各選択肢の解説
- 選択肢1: マルチタスクは複数の課題をこなす性質を指し、複数形式のデータを統合処理するモデルの名称ではない。
- 選択肢2: シングルモーダルは単一の種類の情報だけを扱う型であり、複数形式を統合するモデルとは逆である。
- 選択肢3: ルールベースは人が定めた規則で動く方式であり、データ形式を統合処理するモデルではない。
- 選択肢4: 【正解】オムニモーダルは複数形式のデータを最初から統合して理解・処理するモデルである。
問2
文章中の空欄 [2] に入る最も適切な用語を選びなさい。
- ハルシネーション
- アライメント
- 勾配爆発
- オーバーフィッティング
正解と解説を見る
正解:1
空欄(2)は、もっともらしいが事実と異なる内容を生成してしまう現象である。生成AIが確率的に文章を作る仕組みから生じる。
各選択肢の解説
- 選択肢1: 【正解】ハルシネーションは、もっともらしいが事実と異なる回答が生じる現象である。
- 選択肢2: アライメントはAIを人間の価値観に沿わせる調整であり、事実と異なる出力そのものを指さない。
- 選択肢3: 勾配爆発は学習中に値が極端に大きくなる現象であり、事実と異なる出力を指す語ではない。
- 選択肢4: オーバーフィッティングは学習データに偏りすぎる状態であり、誤った内容を出力する現象の名称ではない。
問3
文章中の空欄 [3] に入る最も適切な用語を選びなさい。
- 探索
- 推論
- 確率
- 応答
正解と解説を見る
正解:2
空欄(3)は、数学や複雑なプログラムなど難度の高い課題に向け、速さを後回しにして思考を深め、正確さを優先する推論型のモデルである。
各選択肢の解説
- 選択肢1: 探索は候補を調べて回る処理を指し、思考を深めて答えるモデルの型を表す語ではない。
- 選択肢2: 【正解】推論型のモデルは、内部で思考を深めて精査し、難度の高い課題に強みを持つ。
- 選択肢3: 確率型は、出力を確率で選ぶという一般的な性質を指し、じっくり考える型を示す語ではない。
- 選択肢4: 応答型は、回答を返すという一般的な性質を指し、思考を深める型を示す語ではない。
問4
文章中の空欄 [4] に入る最も適切な用語を選びなさい。
- 制限付きボルツマンマシン
- 識別器
- 変分自己符号化器
- 実行型エージェント
正解と解説を見る
正解:4
空欄(4)は、指示に応じてブラウザ操作やコード修正など人間の業務タスクを、代わりに最後まで実行するAIである。実行型エージェントと呼ばれる。
各選択肢の解説
- 選択肢1: 制限付きボルツマンマシンは確率的なニューラルネットワークの一種であり、業務を代行するAIではない。
- 選択肢2: 識別器は入力の真偽や種類を判定するモデルであり、業務タスクを代行するAIではない。
- 選択肢3: 変分自己符号化器は画像などを生成するモデルの一種であり、業務タスクを代行するAIではない。
- 選択肢4: 【正解】実行型エージェントは、ブラウザ操作などの一連の作業を代わりに完了まで実行する。
形式4:正しい記述を選ぶ
大規模言語モデル(LLM)の文章生成の仕組みと特徴に関する記述として最も適切なものを、1~4の選択肢の中から一つ選びなさい。
- 大規模言語モデル(LLM)は、プロンプトを入力するとデータベースから最適な完成文を即座に1冊の本のように一括ダウンロードして表示している。
- 大規模言語モデル(LLM)は、文章を作成する際に過去の会話相手の個人情報を自動検索し、その人物の思想を完全に模倣して発言する。
- 大規模言語モデル(LLM)は、事前学習により膨大な知識を持っているため、外部連携なしの単体で常に最新のニュースや今日の出来事をリアルタイムに反映した回答を出力できる。
- 大規模言語モデル(LLM)は、膨大なパラメータと学習データに基づいて、単語(トークン)同士の繋がりや統計的な確率を計算し、文脈に合った次の言葉を順次選び出して文章を生成する。
正解と解説を見る
正解:4
LLMは、膨大なパラメータと学習データに基づき、トークン同士のつながりを確率的に計算して、文脈に合う次の言葉を順に選んで文章を生成する。
各選択肢の解説
- 選択肢1: LLMは完成文を保存したデータベースから取り出すのではなく、次のトークンを順に選んで生成しており、一括表示とする点が誤りである。
- 選択肢2: LLMは入力された文脈から次の言葉を選ぶ仕組みで、個人情報を自動検索して思想を模倣するものではない点が誤りである。
- 選択肢3: 事前学習だけのモデルは学習データ時点までの知識で答えるため、外部連携なしで最新の出来事を反映できるとする点が誤りである。
- 選択肢4: 【正解】LLMはパラメータと学習データに基づき、トークン同士の確率的なつながりから次の言葉を順に選ぶため、記述の通り正しい。
形式5:誤った記述を選ぶ
Anthropic社が開発した生成AI「Claude」の特徴に関する記述として不適切なものを、1~4の選択肢の中から一つ選びなさい。
- 「Constitutional AI(憲法AI)」と呼ばれる独自設計に基づき、有害でないことや正直であることを重視して動作する。
- Claudeは「利益の最大化」を最優先動作原則として設計されており、出力の安全性や有害性の抑制は考慮されない。
- 非常に長い文章を一度に読み込んで処理できる能力に優れ、長大な契約書やレポートの要約・解釈に適している。
- 生成された文書やプログラムコードをメイン画面とは別のウィンドウで表示・確認・編集できるArtifacts機能を備えている。
正解と解説を見る
正解:2
ClaudeはAnthropic社が開発し、憲法AIという設計思想で無害さ・有用さ・誠実さを最優先とし、長文処理とArtifacts機能に特徴がある。
各選択肢の解説
- 選択肢1: Claudeは憲法AIという独自の設計思想で、有害でないことや正直であることを重視するため、記述の通り正しい。
- 選択肢2: 【正解】Claudeは無害さ、有用さ、誠実さを最優先に設計されており、利益最大化を最優先で安全性を考慮しないとする点が誤りである。
- 選択肢3: Claudeは非常に長い文章を一度に扱える長文読解や要約に強いモデルであるため、記述の通り正しい。
- 選択肢4: Claudeには、生成物を別画面に出して手直しできるArtifacts機能があるため、記述の通り正しい。
第3章 AIエージェント
形式1:穴埋め(1か所)
次の空欄[1]にあてはまる最も適切な語句を、1~4の選択肢の中から一つ選びなさい。
LLMが単独で回答を出力する際、学習データに存在しない最新情報や社内の非公開情報について事実と異なる嘘を出力してしまうハルシネーションが発生しやすい。これを減らすため、回答作成の直前に信頼できる外部データベースから関連情報を検索して取得し、その資料を背景知識としてプロンプトに付与して回答させる技術を [1] と呼ぶ。
- RLHF
- 指示チューニング
- ドメイン適応
- RAG(検索拡張生成)
正解と解説を見る
正解:4
RAGは、回答の前に外部の文書やデータベースから関連情報を検索し、質問と一緒にLLMへ渡して回答させる方法である。モデルを再学習せずに、最新情報や社内情報を使える。
各選択肢の解説
- RLHF: RLHFは、人の評価を使ってモデルを調整する学習手法であり、回答直前に資料を検索して渡す技術ではない。
- 指示チューニング: 指示チューニングは、指示への従い方を学習で整える手法であり、外部資料の検索を伴うものではない。
- ドメイン適応: ドメイン適応は、特定分野向けにモデルを追加学習で調整する考え方であり、検索して付与する本問の技術ではない。
- RAG(検索拡張生成): 【正解】RAG(検索拡張生成)は、検索で得た資料をプロンプトに加えて回答させ、ハルシネーションを減らす方向に働く。
形式2:穴埋め(組み合わせ)
次の空欄[1]・[2]にあてはまる語句の組み合わせとして最も適切なものを、1~4の選択肢の中から一つ選びなさい。
RAGにおける検索精度の向上手法として、ベクトルによる意味的検索と型番・コード等の厳密な文字列一致に強いキーワード検索を組み合わせる方式を [1] 検索と呼ぶ。さらに、初回の検索で得られた多数の候補文書に対し、別のモデルを用いて質問文との関連度を再評価し上位のみを抽出する工程を [2] と呼ぶ。
- [1] ハイブリッド [2] リランキング
- [1] エージェント [2] チャンク分割
- [1] セマンティック [2] クエリ書き換え
- [1] ハイブリッド [2] データサイロ
正解と解説を見る
正解:1
ベクトルによる意味的検索とキーワード検索を併用するのがハイブリッド検索であり、最初の検索で得た候補を別のモデルで関連度順に並べ直す工程がリランキングである。
各選択肢の解説
- ハイブリッド / リランキング: 【正解】空欄(1)はハイブリッド、空欄(2)はリランキングで、どちらも正しい。
- エージェント / チャンク分割: エージェントは検索方式ではなく、チャンク分割は文書を断片に分ける準備作業であり、どちらも合わない。
- セマンティック / クエリ書き換え: セマンティック検索は意味的検索そのものでキーワード検索との併用ではなく、クエリ書き換えは質問の補正で再評価ではない。
- ハイブリッド / データサイロ: 空欄(1)のハイブリッドは正しいが、データサイロは情報の分断状態であり、空欄(2)には合わない。
形式3:長文(1つの文章に4問)
次の文章を読んで4つの問題に答えなさい。
ある会社が、ウェブを巡回して調査を行い、結果をメールで報告するAIエージェントを試験運用している。エージェントが読み込んだウェブページの中に攻撃者が仕込んだ指示が含まれ、利用者が気づかないうちにエージェントがそれに従って動いてしまう攻撃を [1] プロンプトインジェクションという。また、途中の小さな誤りが後の手順に引き継がれて積み重なり、大きな被害につながる現象を [2] という。被害を限定するために、アクセスできるファイルやネットワークを限った隔離環境でエージェントを動かす方法を [3] といい、接続を許す先や実行を許すコマンドをあらかじめ列挙してそれ以外を拒否する方式を [4] 方式という。
問1
文章中の空欄 [1] に入る最も適切な用語を選びなさい。
- 直接
- 並列
- 間接
- 自律
正解と解説を見る
正解:3
空欄(1)は、AIが読み込む外部のウェブページなどに仕込まれた指示に、利用者が気づかないうちに従ってしまう間接プロンプトインジェクションの間接である。
各選択肢の解説
- 選択肢1: 直接は利用者自身が入力したプロンプトで制限を回避する型であり、外部コンテンツに仕込む本問の攻撃ではない。
- 選択肢2: 並列はプロンプトインジェクションの分類として使われる語ではなく、攻撃の経路を表さない。
- 選択肢3: 【正解】間接は、AIが読み込む外部の内容に攻撃者の指示が埋め込まれる型で、利用者が普通に依頼しても起こり、空欄(1)に当てはまる。
- 選択肢4: 自律はエージェントの型を表す語であり、攻撃の経路の区分ではない。
問2
文章中の空欄 [2] に入る最も適切な用語を選びなさい。
- 連鎖的なエラー
- ガードレール
- 権限の過剰付与
- トークン化
正解と解説を見る
正解:1
空欄(2)は、途中の小さな誤りが後の手順へ引き継がれて積み重なり、大きな被害につながる連鎖的なエラーである。
各選択肢の解説
- 選択肢1: 【正解】連鎖的なエラーは、手順が多く長く動くほど誤りが積み重なりやすい性質を指し、空欄(2)に当てはまる。
- 選択肢2: ガードレールは動作に制限を付ける対策であり、誤りが積み重なる現象そのものではない。
- 選択肢3: 権限の過剰付与は誤りの影響が及ぶ範囲が広すぎる設計の問題であり、誤りが積み重なる性質とは別の観点である。
- 選択肢4: トークン化は文章をトークンに分ける処理であり、エージェントの誤りの現象とは無関係である。
問3
文章中の空欄 [3] に入る最も適切な用語を選びなさい。
- ベクトルデータベース
- サンドボックス
- RAG
- コンパクション
正解と解説を見る
正解:2
空欄(3)は、アクセスできるファイルやネットワークを限った隔離環境で動かす方法であるサンドボックスで、自律型は本番前にここで試すことが勧められる。
各選択肢の解説
- 選択肢1: ベクトルデータベースは意味の近い断片を探すための保存先であり、実行環境を隔離する方法ではない。
- 選択肢2: 【正解】サンドボックスは安全な隔離環境で動かして被害を限定する方法であり、空欄(3)に当てはまる。
- 選択肢3: RAGは外部資料を検索して入力に付け足す仕組みであり、実行環境を隔離する方法ではない。
- 選択肢4: コンパクションは長くなった文脈を圧縮して整理する扱いであり、実行環境の隔離とは無関係である。
問4
文章中の空欄 [4] に入る最も適切な用語を選びなさい。
- ブラックリスト
- コンパクション
- ルーティング
- ホワイトリスト(許可リスト)
正解と解説を見る
正解:4
空欄(4)は、許可するものを列挙してそれ以外を拒否する方式であるホワイトリスト(許可リスト)で、最小権限を実現する手段のひとつである。
各選択肢の解説
- 選択肢1: ブラックリストは禁止するものを列挙する方式であり、許可するものを列挙してそれ以外を拒否する本問の方式とは逆である。
- 選択肢2: コンパクションは長くなった文脈を圧縮する扱いであり、接続先や実行を制限する方式ではない。
- 選択肢3: ルーティングは入力の種類に応じて処理を振り分けるパターンであり、許可対象を絞る方式ではない。
- 選択肢4: 【正解】ホワイトリストは許可するものだけを列挙し、それ以外を拒否する許可リスト方式であり、空欄(4)に当てはまる。
形式4:正しい記述を選ぶ
MCP(Model Context Protocol)と A2A(Agent-to-Agent)プロトコルの関係・違いに関する記述として、最も適切なものはどれか。
- MCPは「エージェントと外部ツール・データ」を縦につなぐ規格であり、A2Aは「エージェントとエージェント」を横につなぐ規格として互いに補完し合う。
- A2AはMCPを完全に置き換える上位互換規格であり、MCPの機能は今後廃止される予定である。
- A2A連携では、通信相手のエージェント内部の記憶や所有ツール、実行コードの全てが完全に相手側に開示される。
- MCPはGoogleが開発し、A2AはAnthropicが開発したため、両者を同時にシステムへ組み込むことはできない。
正解と解説を見る
正解:1
MCPはエージェントとツール・データを縦につなぎ、A2Aはエージェントどうしを横につなぐ。両者は置き換えではなく、補い合う関係である。
各選択肢の解説
- 選択肢1: 【正解】MCPはエージェントとツール・データ、A2Aはエージェントどうしをつなぎ、補完し合う。
- 選択肢2: A2AはMCPを置き換えるものではなく補い合う関係であり、上位互換で廃止予定とする点が誤りである。
- 選択肢3: A2Aでは相手の内部の記憶やツールを見せずに協力できることが特徴であり、全てが開示されるとする点が誤りである。
- 選択肢4: MCPはAnthropic、A2AはGoogleが作った規格で併用もできるため、開発元が逆で同時に組み込めないとする点が誤りである。
形式5:誤った記述を選ぶ
AIエージェントに対するプロンプトインジェクション攻撃に関する記述として不適切なものを、1~4の選択肢の中から一つ選びなさい。
- システムプロンプトの中に「外部の指示に従ってはならない」と厳格に明記しておけば、どのような形式のプロンプトインジェクション攻撃であっても100%完全に防止できる。
- 利用者自身が直接入力する指示文によってAIの制限を回避・改ざんしようとする攻撃を「直接プロンプトインジェクション」と呼ぶ。
- Webサイトや電子メール、受信ファイルなどの外部コンテンツに攻撃的な指示が埋め込まれており、それを読み込んだAIが意図しない操作を実行してしまう攻撃を「間接プロンプトインジェクション」と呼ぶ。
- プロンプトインジェクションの脅威を低減させるには、最小権限の原則、信頼できないコンテンツの分離、人間の承認、サンドボックスなどを組み合わせた多層防御が不可欠である。
正解と解説を見る
正解:1
直接プロンプトインジェクションは利用者の入力による攻撃、間接プロンプトインジェクションは外部コンテンツに埋め込まれた指示による攻撃である。完全に防ぐ決定的な方法は知られておらず、多層防御で影響を減らす。
各選択肢の解説
- 選択肢1: 【正解】システムプロンプトに書くだけでは完全に防げず、100%防止できるとする点が誤りである。
- 選択肢2: 利用者自身の入力でAIの制限を回避、改ざんしようとする攻撃が直接プロンプトインジェクションであり、記述の通り正しい。
- 選択肢3: Webページやメールなど外部コンテンツ内の指示をAIが読んで実行してしまう攻撃が間接型であり、記述の通り正しい。
- 選択肢4: 最小権限、承認、サンドボックスなどを重ねる多層防御で影響を減らすため、記述の通り正しい。
第4章 生成AIのリスク予防・AI倫理・ガバナンス
形式1:穴埋め(1か所)
次の空欄[1]にあてはまる最も適切な語句を、1~4の選択肢の中から一つ選びなさい。
生成AIを組織内で安全かつ持続的に運用するためには、ガイドラインの周知だけで終わらせず、アクセスログなどを通じてAIツールの利用状況や異常な挙動を継続的に監視・把握する [1] のプロセスが不可欠である。
- モニタリング
- ワークフロー
- データマイニング
- フィルタリング
正解と解説を見る
正解:1
ガイドラインを周知するだけで終わらせず、アクセスログなどで利用状況や異常な挙動を継続的に把握するモニタリングが、AIを組織で安全に運用するために必要である。
各選択肢の解説
- モニタリング: 【正解】モニタリングは、利用状況や異常を継続的に把握する取り組みで、リスクの早期発見とルールの改善につながる。
- ワークフロー: ワークフローは、業務の流れや手順を表す語であり、利用状況の監視を指さない。
- データマイニング: データマイニングは、大量のデータから規則性を見つける分析手法であり、利用状況の継続的な把握とは異なる。
- フィルタリング: フィルタリングは、条件に合わないものを除外する処理であり、運用状況を継続的に把握する取り組みではない。
形式2:穴埋め(組み合わせ)
次の空欄[1]・[2]にあてはまる語句の組み合わせとして最も適切なものを、1~4の選択肢の中から一つ選びなさい。
スマートフォンのカメラでスキャンするだけでWebサイトへ移動できる手軽さを悪用し、偽の決済ページ等へ誘導する攻撃が存在する。被害を防ぐため、出所不明なQRコードの読み取りを避けるとともに、読み取り後に表示される [1] に不自然な文字列がないか確認し、ログインを求められた場合は [2] からアクセスし直すことが重要である。
- [1] 画像サイズ [2] フリーWi-Fi
- [1] 画像サイズ [2] 公式アプリや公式Webサイト
- [1] ドメイン名 [2] フリーWi-Fi
- [1] ドメイン名 [2] 公式アプリや公式Webサイト
正解と解説を見る
正解:4
偽のQRコードで誤ったサイトへ誘導する手口がある。読み取り後は表示されたURLのドメイン名を確かめ、ログインは公式から入り直す。
各選択肢の解説
- 画像サイズ / フリーWi-Fi: 画像サイズは確認の対象ではなく、フリーWi-Fiも正規のログイン先ではない。
- 画像サイズ / 公式アプリや公式Webサイト: 画像サイズではなくURLのドメイン名を確かめる必要がある。公式アプリや公式Webサイトの部分だけが合っている。
- ドメイン名 / フリーWi-Fi: ドメイン名は合うが、フリーWi-Fiは正規の入口ではなく、ログインは公式アプリや公式Webサイトから入り直す。
- ドメイン名 / 公式アプリや公式Webサイト: 【正解】読み取り後に表示されたURLのドメイン名を確かめ、ログインを求められたら公式から入り直すため、両方とも適切である。
形式3:長文(1つの文章に4問)
次の文章を読んで4つの問題に答えなさい。
生成AIをビジネスで活用する際、入力データの性質と法的なルールを正しく認識することが重要である。生成AIに文章を入力したりファイルをアップロードしたりする行為は、それ自体が外部サービスへの [1] にあたるため、自社の機密情報や個人情報の安易な入力は情報漏洩のリスクを伴う。個人情報保護法において、個人の病歴や犯罪歴、人種など、開示により不当な差別や偏見を受けるおそれが高い情報は [2] と定義され、原則として本人の明示的な同意が必要となる。また、データを安全に利活用するために個人が特定できないよう復元不可能な加工を施したデータは [3] と呼ばれ、照合の禁止などの安全管理措置が義務付けられている。さらに、自社のノウハウや顧客情報などの重要な情報を不正競争防止法上の営業秘密として保護するためには、非公知性や有用性に加えて、社内で適切にアクセス制限を行う [4] の要件を満たしていることが不可欠である。
問1
文章中の空欄 [1] に入る最も適切な表現を選びなさい。
- 暗号化通信の無効化
- 著作権の自動譲渡
- データの提供(送信)
- データの消去
正解と解説を見る
正解:3
生成AIへの文章の入力やファイルのアップロードは、それ自体が外部サービスへのデータの提供にあたる。機密情報や個人情報の安易な入力は漏えいのリスクを伴う。
各選択肢の解説
- 選択肢1: 暗号化通信の無効化は入力行為の意味ではなく、入力が外部への情報の受け渡しである点を表していない。
- 選択肢2: 著作権の自動譲渡は入力で起きるものではなく、情報漏えいのリスクの理由にならない。
- 選択肢3: 【正解】入力や添付は外部サービスへのデータの提供(送信)にあたり、空欄(1)に合う。
- 選択肢4: データの消去は入力と逆の働きであり、外部へ情報を渡すことで生じる漏えいリスクを説明しない。
問2
文章中の空欄 [2] に入る最も適切な用語を選びなさい。
- 個人識別符号
- 匿名加工情報
- 限定提供データ
- 要配慮個人情報
正解と解説を見る
正解:4
要配慮個人情報は、人種、信条、病歴、犯罪歴など、外部に明らかになると差別や偏見を受けるおそれが高い情報である。取得や第三者提供には原則として本人の明示的な同意が必要となる。
各選択肢の解説
- 選択肢1: 個人識別符号は個人を特定できる番号などを指す語であり、差別や偏見のおそれが高い情報を指す語ではない。
- 選択肢2: 匿名加工情報は個人が誰か分からないよう加工し復元できなくしたデータであり、病歴などの情報を指す語ではない。
- 選択肢3: 限定提供データは不正競争防止法で扱われる別の概念であり、個人情報保護法上の配慮が必要な情報ではない。
- 選択肢4: 【正解】要配慮個人情報は病歴、犯罪歴、人種などで、原則として本人の明示的な同意が必要であり、空欄(2)に合う。
問3
文章中の空欄 [3] に入る最も適切な用語を選びなさい。
- 匿名加工情報
- 暗号化データ
- 機微(センシティブ)情報
- 特定個人情報
正解と解説を見る
正解:1
匿名加工情報は、個人が誰か分からないよう加工し、元に戻せない措置を施したデータである。氏名を削除するだけでは足りず、他の情報との照合禁止などの義務が課される。
各選択肢の解説
- 選択肢1: 【正解】匿名加工情報は復元できない加工を施したデータで、照合の禁止などの義務が課され、空欄(3)に合う。
- 選択肢2: 暗号化データは鍵があれば元に戻せるのが前提であり、復元不可能な加工を施したデータではない。
- 選択肢3: 機微(センシティブ)情報は主に金融分野で特に慎重な扱いが求められる情報を指し、加工したデータではない。
- 選択肢4: 特定個人情報はマイナンバーを含む個人情報であり、復元不可能な加工を施したデータではない。
問4
文章中の空欄 [4] に入る最も適切な用語を選びなさい。
- 電磁的管理性
- 秘密管理性
- 相当量蓄積性
- 限定提供性
正解と解説を見る
正解:2
営業秘密として保護されるには、秘密として管理されていること(秘密管理性)、事業活動に役立つこと(有用性)、公開情報でないこと(非公知性)の3要件が必要である。
各選択肢の解説
- 選択肢1: 電磁的管理性は限定提供データの要件であり、営業秘密の3要件に含まれない。
- 選択肢2: 【正解】秘密管理性は秘密として管理されていることで、社内のアクセス制限などが該当し、空欄(4)に合う。
- 選択肢3: 相当量蓄積性は限定提供データの要件であり、営業秘密の3要件には含まれない。
- 選択肢4: 限定提供性は限定提供データの要件であり、営業秘密を保護するためのアクセス制限の要件ではない。
形式4:正しい記述を選ぶ
生成AIを業務で安全かつ効果的に活用するための基本姿勢(マインドセット)に関する記述として、最も適切なものはどれか。
- 組織の承認を受けた安全な生成AIツールであれば、出力結果にハルシネーションが発生することはないため、人間による出力内容の検証は省略できる。
- 生成AIは利用者の意図や背景を自動的に理解するわけではないため、プロンプトには目的や背景、具体的な条件などの文脈を十分に渡す工夫が必要である。
- 生成AIが出力した回答の真偽を確認する際は、生成AIに対して「この回答は事実ですか」と直接質問して真偽を判定させることが最も確実な方法である。
- 社内ルールやガイドラインが整備されていない状況においては、個人のマインドセットに頼って判断することは禁止されており、一切のAI利用を控えるべきである。
正解と解説を見る
正解:2
生成AIは利用者の意図や背景を自動で理解しないため、目的や条件などの文脈をプロンプトで十分に伝える工夫が要る。出力の検証も人間の役割である。
各選択肢の解説
- 選択肢1: ハルシネーションはツールが承認済みでも起こりうるため、人間の検証を省略できるとする点が誤りである。
- 選択肢2: 【正解】生成AIは意図を汲み取れないため、目的・背景・条件を具体的に渡すことが適切な活用姿勢である。
- 選択肢3: 生成AI自身への真偽の質問は誤答を含みうるため、これを最も確実な確認方法とする点が誤りである。
- 選択肢4: ルール未整備でも利用者は自分で判断し、情報の取扱いに注意して使う必要があり、一切の利用禁止とする点が誤りである。
形式5:誤った記述を選ぶ
AI出力の「妥当性レビュー」に関する記述として不適切なものを、1~4の選択肢の中から一つ選びなさい。
- 依頼時に指示した前提条件(対象範囲、期間、地域など)が回答に正しく反映されているかを評価する。
- 結論に至る論理の展開に矛盾や飛躍がないか、必要な視点や例外事項に抜け漏れがないかを見直す。
- プロンプト(指示文)に含まれる利用者のバイアスや偏りが、回答に悪影響を与えていないかを点検することも妥当性レビューに含まれる。
- 妥当性レビューで結論のロジックや整合性が確認できれば、個々の数値や固有名詞の事実関係を一次情報で確認するファクトチェックは不要となる。
正解と解説を見る
正解:4
妥当性レビューは、出力が前提条件に合い、論理に飛躍がなく、抜け漏れや偏りがないかを人が見直すことである。個々の事実を確かめるファクトチェックとは別の作業である。
各選択肢の解説
- 選択肢1: 依頼時に示した対象範囲や期間、地域などの前提が反映されているかを見るのは妥当性レビューであるため、記述の通り正しい。
- 選択肢2: 結論に至る論理の矛盾や飛躍、観点や例外の抜け漏れを見直すのは妥当性レビューであるため、記述の通り正しい。
- 選択肢3: プロンプトに含まれる利用者の偏りが回答に影響していないかの点検も含まれるため、記述の通り正しい。
- 選択肢4: 【正解】論理が確認できれば個々の数値や固有名詞の事実確認は不要とする点が誤りである。文章が自然でも正しいとは限らず、ファクトチェックも要る。
第5章 生成AIの実践と活用事例
形式1:穴埋め(1か所)
次の空欄[1]にあてはまる最も適切な語句を、1~4の選択肢の中から一つ選びなさい。
生成AIを活用して業務課題を解決する際、一回のプロンプト入力だけで理想的な回答を得られない場合は、AIの出力結果を確認した上で追加の修正指示を繰り返す [1] というプロセスが実務上不可欠である。
- ファインチューニング
- プレトレーニング
- Zero-Shotプロンプティング
- プロンプトエンジニアリング
正解と解説を見る
正解:4
一度で完成させず、出力を見て修正指示を重ねてプロンプトを改善していく作業がプロンプトエンジニアリングである。対話的な改善にあたる。
各選択肢の解説
- ファインチューニング: ファインチューニングはモデルの重みを追加学習で更新する手法であり、入力を直しながら改善する本問のプロセスではない。
- プレトレーニング: プレトレーニングは大量のデータで行う事前学習であり、利用者が出力を見て指示を修正する作業ではない。
- Zero-Shotプロンプティング: Zero-Shotプロンプティングは例を示さず指示だけで依頼する手法であり、修正を繰り返す過程そのものを指す語ではない。
- プロンプトエンジニアリング: 【正解】プロンプトエンジニアリングは、モデルを変えずに書き方を試して直し、目的に合う出力を安定して得る技術である。
形式2:穴埋め(組み合わせ)
次の空欄[1]・[2]にあてはまる語句の組み合わせとして最も適切なものを、1~4の選択肢の中から一つ選びなさい。
AIがリファクタリングを行ったあとは、外から見た [1] が変わっていないことを [2] で確かめる必要がある。
- [1] 動作 [2] テスト
- [1] 画面の配色 [2] 目視
- [1] 著作権 [2] 契約書
- [1] ライセンス [2] 法務確認
正解と解説を見る
正解:1
リファクタリングは外から見た動作を変えずに内部構造を整理する作業である。動作が変わっていないかをテストで確かめる必要がある。
各選択肢の解説
- 動作 / テスト: 【正解】空欄(1)の動作が変わっていないことを、空欄(2)のテストで確かめる。
- 画面の配色 / 目視: 空欄(1)の画面の配色はリファクタリングで保つべき対象として問われておらず、空欄(2)の目視だけでは動作の確認として不十分である。
- 著作権 / 契約書: 空欄(1)の著作権と空欄(2)の契約書は、コードの動作を確かめる話と関係がない。
- ライセンス / 法務確認: 空欄(1)のライセンスと空欄(2)の法務確認は、動作が変わっていないかを確かめる手段ではない。
形式3:長文(1つの文章に4問)
次の文章を読んで4つの問題に答えなさい。
ある会社の広報担当者が、生成AIを使って業務を進めている。取引先へのメール文案を作らせたときは、宛名や金額、日付などの事実を送信前に人が確認する。長い契約書の要点を要約させたときは、重要な条件や例外が落ちたり、書かれていないことが足されたりすることがあるため、重要な判断は [1] を確認したうえで行う。また、キャッチコピー案を作る際に特定の作家名やブランド名を指定すると、既存の作品に [2] 可能性が高まり、著作権や商標の問題につながるおそれがある。生成した画像を商用で使う前には、利用するサービスの [3] を確認する必要がある。さらに、広告に載せる実績や効能は、AIが作り話で書くことがあるため、[4] を確かめてから掲載する。
問1
文章中の空欄 [1] に入る最も適切な表現を選びなさい。
- 要約文だけ
- 原文(元の資料)
- AI自身の自己評価
- 文字数
正解と解説を見る
正解:2
要約は、重要な条件や例外が落ちたり、書かれていないことが足されたりすることがある。法律や契約のような資料では、元の資料と照らして確かめてから判断する。
各選択肢の解説
- 選択肢1: 要約文だけでは落ちた条件や足された内容に気づけないため、確認の手段にならない。
- 選択肢2: 【正解】原文(元の資料)と照らせば要約の抜けや付け足しを確かめられ、重要な判断の前に必要で、空欄(1)に合う。
- 選択肢3: AI自身の自己評価では誤りを見抜けない場合があり、独立した確認の根拠にならない。
- 選択肢4: 文字数は要約の長さを示すだけで、重要な条件の抜けや付け足しを確かめる手段ではない。
問2
文章中の空欄 [2] に入る最も適切な表現を選びなさい。
- まったく似なくなる
- 自動的に許諾が得られる
- 権利が消滅する
- 似てしまう
正解と解説を見る
正解:4
特定の作家名、ブランド名、キャラクター名を指定して作らせると、既存の作品に似てしまうおそれが高まる。著作権や商標の問題につながるため、似ていないかの確認が必要である。
各選択肢の解説
- 選択肢1: まったく似なくなるのは逆であり、特定の名前を指定すると既存の作品に似るおそれが高まる。
- 選択肢2: 名前を指定しても許諾が自動的に得られることはなく、権利の問題はなくならない。
- 選択肢3: 権利が消滅するわけではなく、既存の作品の権利は残るため、侵害のおそれがある。
- 選択肢4: 【正解】作家名やブランド名の指定は既存の作品に似てしまう可能性を高め、空欄(2)に合う。
問3
文章中の空欄 [3] に入る最も適切な表現を選びなさい。
- 画像の大きさ
- 生成にかかった時間
- モデルの名称
- 利用規約(ライセンス条件)
正解と解説を見る
正解:4
生成物を商用で使えるかどうかは、サービスやプランによって異なる。利用するサービスの規約が定める商用利用の可否や生成物の扱いを、使う前に確認する。
各選択肢の解説
- 選択肢1: 画像の大きさは仕様であり、商用で使ってよいかを決める条件ではない。
- 選択肢2: 生成にかかった時間は商用利用の可否と関係がなく、確認すべき条件ではない。
- 選択肢3: モデルの名称を知るだけでは、商用利用の可否や生成物の扱いは分からない。
- 選択肢4: 【正解】利用規約(ライセンス条件)に商用利用の可否や生成物の扱いが定められており、空欄(3)に合う。
問4
文章中の空欄 [4] に入る最も適切な表現を選びなさい。
- 文字の色
- 裏付けとなる事実(根拠)
- 掲載する位置
- AIが自信を持っているかどうか
正解と解説を見る
正解:2
広告に載せる数字、実績、効能は、AIが作り話で書くことがある。実在し確認できるものだけを載せるため、裏付けとなる事実を確かめてから掲載する。
各選択肢の解説
- 選択肢1: 文字の色はデザイン上の要素であり、内容が事実かどうかを確かめる手段ではない。
- 選択肢2: 【正解】裏付けとなる事実(根拠)を確かめることで、作り話の実績や効能を載せる誤りを防げ、空欄(4)に合う。
- 選択肢3: 掲載する位置は見せ方の問題であり、内容が事実かどうかを確かめる手段ではない。
- 選択肢4: AIが自信を持っているかどうかは事実の裏付けにならず、AIは自信ありげに誤ることもある。
形式4:正しい記述を選ぶ
生成AIのプロンプトを業務で運用する際の考え方として、最も適切なものを、1~4の選択肢の中から一つ選びなさい。
- 一度うまくいったプロンプトは、どのモデルでも同じ結果になる。
- 設定を変えても出力は変わらないので、確認は不要である。
- プロンプトは長く複雑なほど、必ず良い結果になる。
- モデルや設定によって出力は変わるため、使うモデルで実際に試して確かめ、評価しながら改善する。
正解と解説を見る
正解:4
同じ指示でも、モデルや設定によって出力は変わる。使うモデルで実際に試して確かめ、評価しながら改善する姿勢が重要である。
各選択肢の解説
- 選択肢1: 出力はモデルや設定で変わるため、一度うまくいったプロンプトが全モデルで同じ結果になるとは限らない。同じ結果になるとする点が誤りである。
- 選択肢2: Temperatureなどの設定を変えると出力は変わる。設定で変わらないとして確認を不要とする点が誤りである。
- 選択肢3: 必要な要素を過不足なく入れることが大切で、長さと質は比例しない。必ず良い結果になるとする点が誤りである。
- 選択肢4: 【正解】モデルや設定で出力が変わるため、使うモデルで試して評価しながら改善するので、記述の通り正しい。
形式5:誤った記述を選ぶ
コンテンツ制作の分野での生成AI活用に関する記述として不適切なものを、1~4の選択肢の中から一つ選びなさい。
- 記事や広告文、画像、動画、音声の制作などに生成AIを使うことがある。
- ゲームや広告などの分野では、活用の場面ごとの留意点を確認して使うことが求められる。
- 著作権・肖像権・ライセンス条件などの権利関係の確認が、中心的な論点になる。
- AIが生成したものなので、権利関係は確認しなくてよい。
正解と解説を見る
正解:4
コンテンツ制作では、記事・広告・画像・動画・音声などに生成AIを使う。著作権・肖像権・ライセンス条件などの権利関係の確認が中心的な論点である。
各選択肢の解説
- 選択肢1: 記事や広告文、画像、動画、音声の制作などに生成AIを使うことがあるため、記述の通り正しい。
- 選択肢2: ゲームや広告などの分野では、活用の場面ごとの留意点を確認して使うため、記述の通り正しい。
- 選択肢3: 著作権・肖像権・ライセンス条件などの権利関係の確認が中心的な論点であるため、記述の通り正しい。
- 選択肢4: 【正解】AI生成物でも、権利関係の確認は必要である。確認しなくてよいとする点が誤りである。
さらに練習したい方へ
合格に近づくには、それぞれの形式に慣れて、たくさんの問題を解くことがいちばんの近道です。
勉強の進め方(3つのステップ)と教材の選び方は、生成AIパスポートの攻略ガイド(note)にまとめています。
まずは公認テキスト:『最短攻略!生成AIパスポート 公認テキスト&問題集』
試験はシラバスから出題されます。最初に公認テキストを1回、全体を読んでおくのがおすすめです。2027年2月の試験からのシラバスに対応した公式テキストは、2026年11月24日に発売される予定です。
『最短攻略!生成AIパスポート 公認テキスト&問題集』(Amazon)
おすすめ:Kindle の問題集(筆者が作っています)
『生成AIパスポート 問題集 2027年2月からの新シラバス対応』
過去問が公開されていない試験の対策用に、新しいシラバスの章立てに沿って作ったオリジナルの予想問題集です(全5章・300問、5つの出題形式に対応)。

生成AIパスポートの合格を応援しています!
参考リンク
Amazonのアソシエイトとして、もちこいしは適格販売により収入を得ています。