
はじめに
こんばんは、mirukyです。
Amazon Bedrock シリーズ第7回(最終回)です。
前回(#6)では、AgentCoreの全体像を理解し、Strands Agentsで実装したエージェントをRuntime上にデプロイしました。
今回は、AgentCoreの中でも特に強力なMemory機能とStateful Runtimeを活用して、記憶を持つ高度なAIエージェントを構築します。
従来のAIエージェントは「毎回ゼロから始まる」ステートレスな存在でした。ユーザーが前回何を相談したか、どんな好みを持っているか、過去にどんな問題を解決したかを覚えていません。
AgentCoreのMemory機能を使えば、エージェントに短期記憶(セッション内の文脈) と長期記憶(セッションをまたいだ学習) を付与し、ユーザーの好みや過去のやり取りを記憶して対応するエージェントを実現できます。
出典:Strands Agents SDK - Amazon Bedrock AgentCore Memory - AWS
目次
- AgentCore Memoryの全体像
- メモリの種類と使い分け
- 短期記憶の実装
- 長期記憶(セマンティックメモリ)の実装
- エピソード記憶の実装
- Stateful Runtimeとは
- マルチエージェント構成の概要
- 本番運用のベストプラクティス
- 料金について
- おわりに(シリーズ全体のまとめ)
1. AgentCore Memoryの全体像
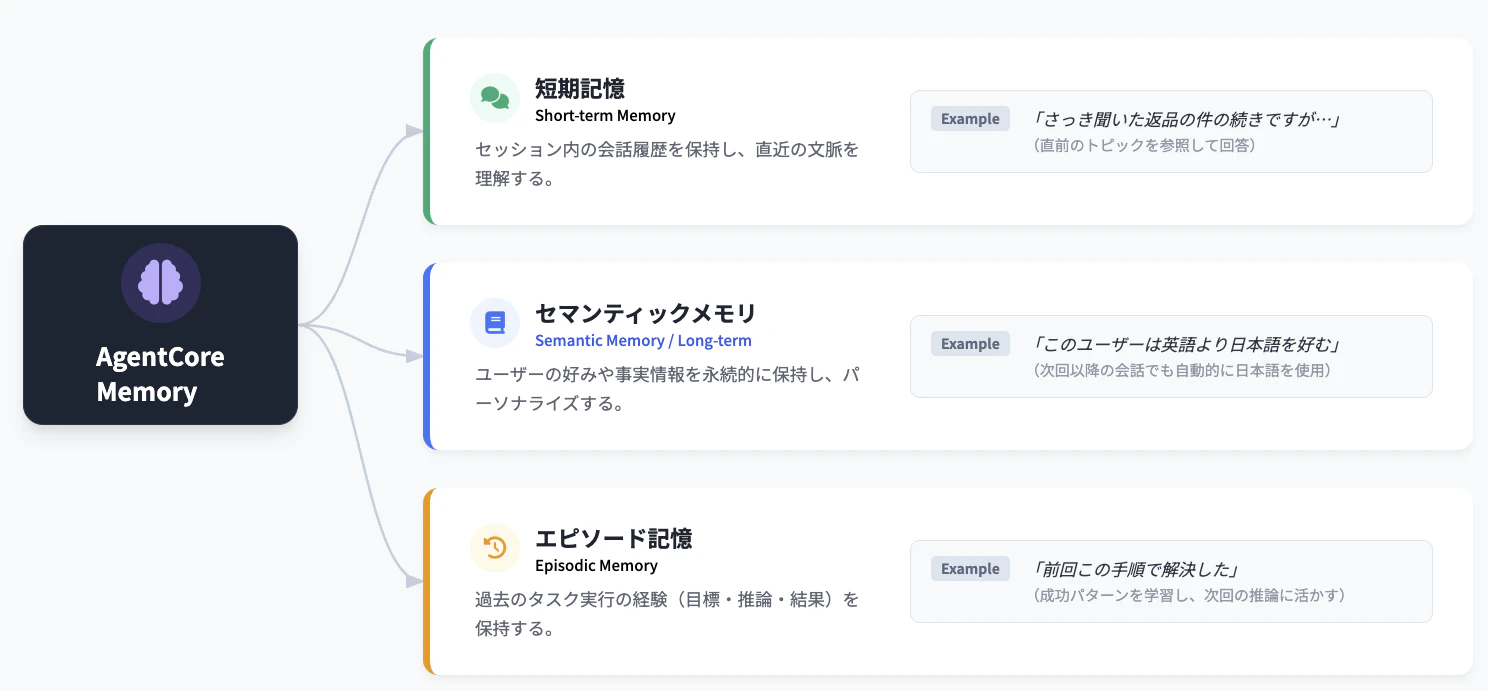
1-1. メモリのアーキテクチャ
1-2. なぜメモリが重要なのか
| 課題 | メモリによる解決 |
|---|---|
| 毎回同じ情報を聞かれる | セマンティックメモリでユーザー情報を記憶 |
| 前の会話を覚えていない | 短期記憶でセッション内の文脈を保持 |
| 過去の失敗を繰り返す | エピソード記憶で過去の経験から学習 |
| ユーザーごとの対応ができない | メモリのユーザー分離でパーソナライズ |
2. メモリの種類と使い分け
| メモリ種別 | 保持期間 | 内容 | 代表的な用途 |
|---|---|---|---|
| 短期記憶 | セッション内 | 会話履歴、直前の文脈 | マルチターン対話 |
| セマンティックメモリ | 永続 | ユーザーの好み、事実情報、要約 | パーソナライズ、顧客対応 |
| エピソード記憶 | 永続 | タスクの目標・推論・行動・結果・反省 | 経験学習、品質改善 |
人間の記憶との対比
- 短期記憶 ≒ 今日の会話を覚えている
- セマンティックメモリ ≒ 「この人はコーヒーよりお茶が好き」と知っている
- エピソード記憶 ≒ 「前回この方法で成功した」と覚えている
出典:Build agents to learn from experiences using Amazon Bedrock AgentCore episodic memory - AWS Blog
3. 短期記憶の実装
3-1. AgentCore Memory Clientの初期化
import os
from bedrock_agentcore.memory import MemoryClient
from bedrock_agentcore.memory.integrations.strands.config import AgentCoreMemoryConfig
from bedrock_agentcore.memory.integrations.strands.session_manager import (
    AgentCoreMemorySessionManager,
)

# メモリIDは事前にAgentCoreコンソールまたはAPIで作成
MEMORY_ID = os.getenv("MEMORY_ID")
SESSION_ID = "session-001"
ACTOR_ID = "user-tanaka"

# Memory Clientの初期化
client = MemoryClient(region_name="ap-northeast-1")

# メモリ設定
memory_config = AgentCoreMemoryConfig(
    memory_id=MEMORY_ID,
    session_id=SESSION_ID,
    actor_id=ACTOR_ID,
)

# セッションマネージャーの作成
session_manager = AgentCoreMemorySessionManager(
    agentcore_memory_config=memory_config,
    region_name="ap-northeast-1",
)
3-2. エージェントへの統合
from strands import Agent, tool


@tool
def get_order_status(order_id: str) -> str:
    """注文のステータスを取得します。"""
    statuses = {
        "ORD-001": "配送中(2026年3月5日到着予定)",
        "ORD-002": "出荷準備中(2026年3月7日到着予定)",
    }
    return statuses.get(order_id, f"注文番号 {order_id} は見つかりませんでした。")


# 短期記憶付きエージェント
agent = Agent(
    system_prompt="""あなたは親切で丁寧なカスタマーサポートのAIアシスタントです。
会話の文脈を記憶し、前の発言を踏まえて回答してください。""",
    tools=[get_order_status],
    session_manager=session_manager,  # ← 短期記憶を付与
)
3-3. 動作確認
# 1回目の質問
response = agent("注文番号ORD-001の状況を教えてください。")
print(response)
# → 「ご注文番号 ORD-001 は現在「配送中」で、2026年3月5日到着予定です。」

# 2回目の質問(文脈を参照)
response = agent("届くのが遅れる場合はどうなりますか?")
print(response)
# → 前の会話を踏まえて、ORD-001に関する遅延対応を回答
短期記憶により、2回目の質問で「届く」が何を指すか(=ORD-001の配送)を文脈から理解して回答します。
4. 長期記憶(セマンティックメモリ)の実装
4-1. セマンティックメモリとは
セッションをまたいで永続的に保持される記憶です。ユーザーの好みや過去のやり取りから抽出された事実情報が自動的に蓄積されます。
4-2. メモリの作成
AgentCoreコンソールまたはAPIでメモリリソースを作成する際に、Memory Strategy(記憶戦略) を指定します。
| 戦略 | 内容 | 用途 |
|---|---|---|
| summary | 会話の要約を保持 | 長い対話のコンテキスト圧縮 |
| preferences | ユーザーの好みや設定を抽出して保持 | パーソナライズ |
| semantic | 事実情報を意味ベースで保持・検索 | ナレッジの蓄積 |
| episodic | タスク実行の経験(目標・行動・結果・反省)を構造化して保持 | 経験学習、品質改善 |
| custom | 独自の抽出・統合ロジックを定義 | ドメイン固有の記憶処理 |
4-3. メモリリソースの作成
from bedrock_agentcore.memory import MemoryClient

client = MemoryClient(region_name="ap-northeast-1")

# メモリの作成(セマンティック + ユーザー好み戦略)
memory = client.create_memory_and_wait(
    name="customer-support-memory",
    strategies=[
        {"semanticMemoryStrategy": {
            "name": "facts",
            "namespaces": ["/support/facts/"],
        }},
        {"userPreferenceMemoryStrategy": {
            "name": "prefs",
            "namespaces": ["/support/preferences/"],
        }},
    ],
    event_expiry_days=30,  # イベントの保持期間(日数)
)

MEMORY_ID = memory["id"]
print(f"Memory ID: {MEMORY_ID}")
4-4. 長期記憶を持つエージェントの実装
from bedrock_agentcore.memory import MemoryClient
from bedrock_agentcore.memory.integrations.strands.config import AgentCoreMemoryConfig
from bedrock_agentcore.memory.integrations.strands.session_manager import (
    AgentCoreMemorySessionManager,
)
from strands import Agent, tool

MEMORY_ID = "作成したメモリID"


@tool
def lookup_product(product_name: str) -> str:
    """商品情報を検索します。"""
    products = {
        "ワイヤレスイヤホン": "価格: 8,980円 / カラー: ブラック, ホワイト / 在庫あり",
        "モバイルバッテリー": "価格: 3,480円 / 容量: 10000mAh / 在庫あり",
    }
    return products.get(product_name, f"「{product_name}」は見つかりませんでした。")


def create_agent_with_memory(session_id: str, actor_id: str) -> Agent:
    """長期記憶付きエージェントを作成する"""
    memory_config = AgentCoreMemoryConfig(
        memory_id=MEMORY_ID,
        session_id=session_id,
        actor_id=actor_id,
    )
    session_manager = AgentCoreMemorySessionManager(
        agentcore_memory_config=memory_config,
        region_name="ap-northeast-1",
    )

    return Agent(
        system_prompt="""あなたは親切で丁寧なカスタマーサポートのAIアシスタントです。
ユーザーの好みや過去の情報を記憶し、パーソナライズされた対応を心がけてください。""",
        tools=[lookup_product],
        session_manager=session_manager,
    )
4-5. セッションをまたいだ記憶の活用
# === セッション1(3月1日) ===
agent_s1 = create_agent_with_memory(session_id="s1-20260301", actor_id="user-tanaka")

response = agent_s1("日本語で回答してほしいです。あと、ブラックのイヤホンが好きです。")
print(response)
# → 「承知しました。今後は日本語で回答いたします。ブラックのイヤホンがお好みなのですね。」
# → preferences戦略により「言語: 日本語」「好み: ブラック」が長期記憶に保存


# === セッション2(3月5日 ─ 別セッション) ===
agent_s2 = create_agent_with_memory(session_id="s2-20260305", actor_id="user-tanaka")

response = agent_s2("おすすめのイヤホンはありますか?")
print(response)
# → 長期記憶から「ブラックが好み」を取得し、
#   「ワイヤレスイヤホン(ブラック)がおすすめです。価格は8,980円です。」と回答
長期記憶のセキュリティ
長期記憶はactor_id(ユーザーID)ごとに完全分離されます。あるユーザーの記憶が別のユーザーに参照されることはありません。マルチテナント環境でも安全に利用できます。
長期記憶の非同期処理について
長期記憶(セマンティック・ユーザー好み・エピソード)の抽出と統合は非同期処理で行われ、完了まで約20〜40秒かかります。会話イベント送信後すぐには長期記憶を検索できないため、即時の文脈参照には短期記憶を使い、長期記憶はバックグラウンドで処理される設計にしてください。
出典:Building smarter AI agents: AgentCore long-term memory deep dive - AWS Blog
5. エピソード記憶の実装
5-1. エピソード記憶とは
エピソード記憶は、エージェントの過去のタスク実行経験を構造化して保持する仕組みです。各エピソードには以下の情報が含まれます。

5-2. エピソード記憶の効果
| シナリオ | エピソード記憶なし | エピソード記憶あり |
|---|---|---|
| 過去に失敗した手順 | 同じ失敗を繰り返す | 過去の失敗を参照し、別の手順を選択 |
| 成功パターン | 毎回ゼロから推論 | 成功体験を参照し、効率的に処理 |
| 類似タスク | 個別に対応 | 類似タスクの経験を活用して精度向上 |
5-3. メモリ作成(エピソード戦略)
from bedrock_agentcore.memory import MemoryClient

client = MemoryClient(region_name="ap-northeast-1")

# エピソード記憶戦略を含むメモリの作成
memory = client.create_memory_and_wait(
    name="support-agent-episodic-memory",
    strategies=[
        {"semanticMemoryStrategy": {
            "name": "facts",
            "namespaces": ["/support/facts/"],
        }},
        {"userPreferenceMemoryStrategy": {
            "name": "prefs",
            "namespaces": ["/support/preferences/"],
        }},
        {"episodicMemoryStrategy": {
            "name": "episodes",
            "namespaces": ["/support/episodes/"],
        }},  # ← エピソード記憶を追加
    ],
    event_expiry_days=30,  # イベントの保持期間(日数)
)

MEMORY_ID = memory["id"]
print(f"Memory ID: {MEMORY_ID}")
5-4. エピソード記憶の活用フロー
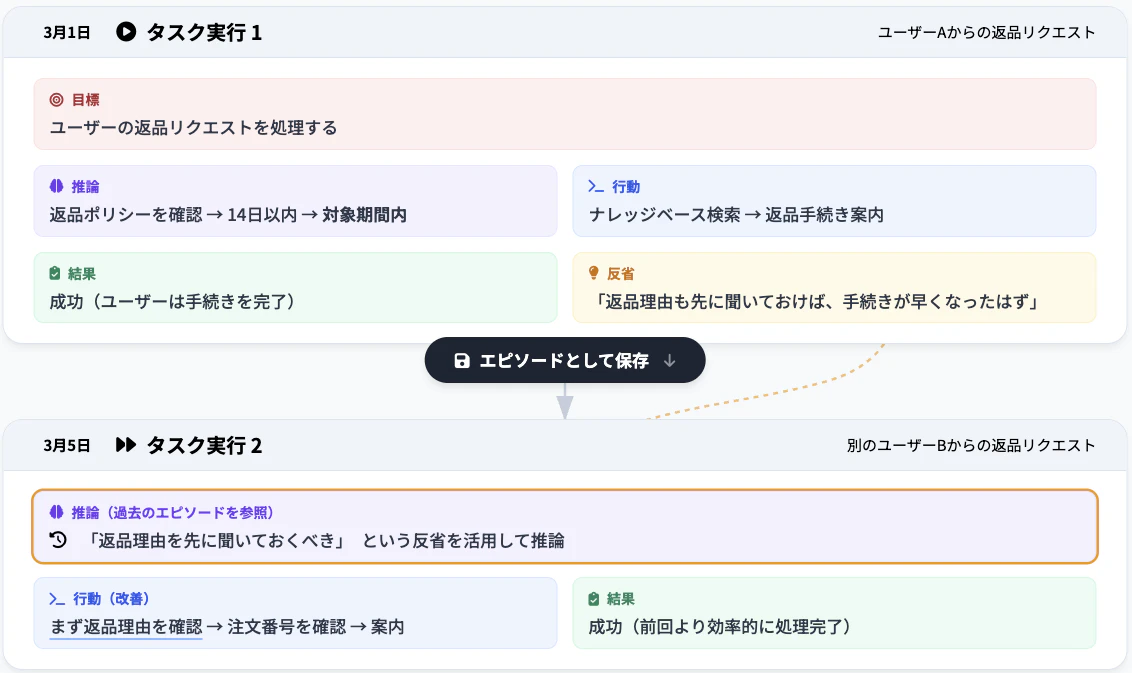
エピソード記憶とベンチマーク
AWSの公式ブログによると、エピソード記憶を有効にしたエージェントは、τ2-benchベンチマーク(カスタマーサービス、小売、航空会社のシナリオ)において、エピソード記憶なしと比較してタスク完了率が大幅に向上したとの結果が報告されています。
出典:Build agents to learn from experiences using Amazon Bedrock AgentCore episodic memory - AWS Blog
6. Stateful Runtimeとは
6-1. ステートレスとステートフルの違い
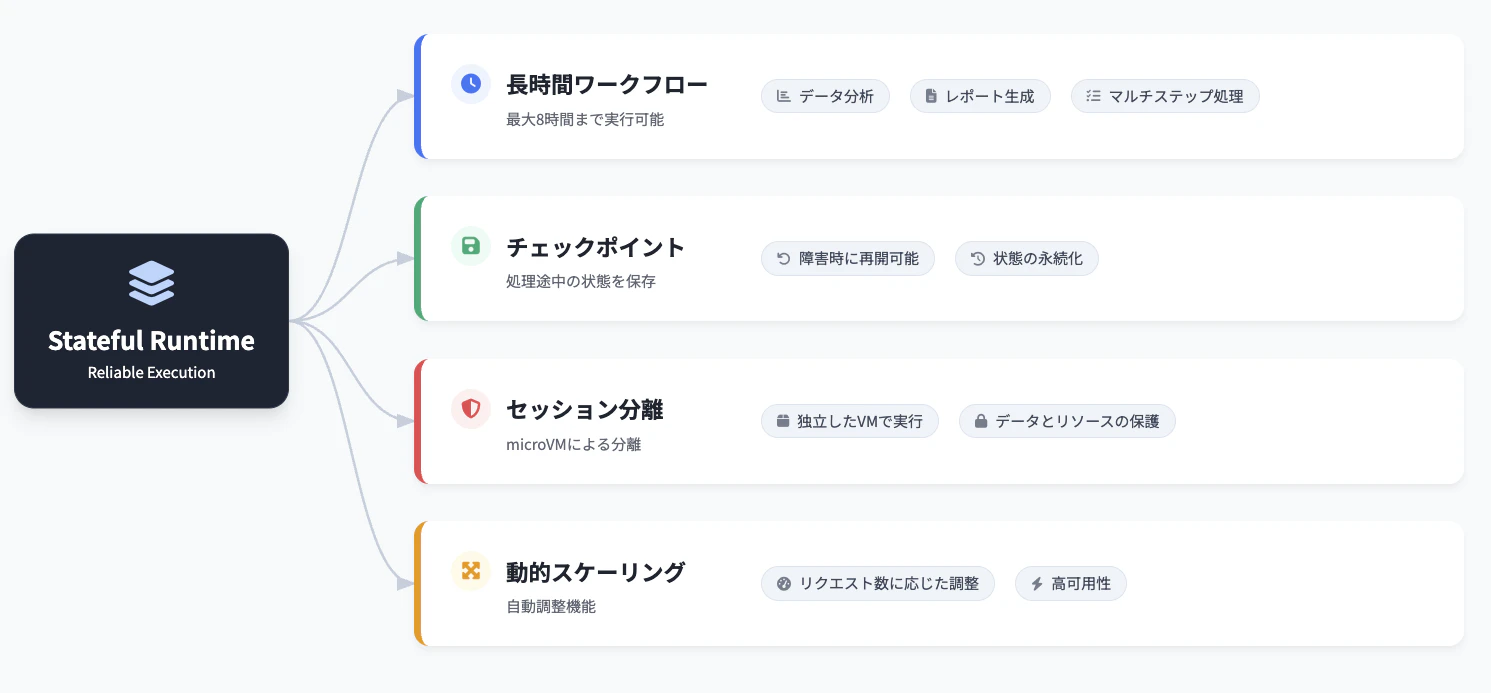
| 観点 | ステートレス(従来) | ステートフル(AgentCore) |
|---|---|---|
| 状態保持 | リクエストごとにリセット | セッション内・セッション間で状態を保持 |
| 長時間タスク | タイムアウトで失敗 | 最大8時間の長時間ワークフローに対応 |
| 実行環境 | 共有環境 | microVMによる完全分離 |
| 中断・再開 | 不可 | チェックポイント機能で中断・再開が可能 |
6-2. Stateful Runtimeの主な特徴
6-3. OpenAIとの共同開発
2026年2月のAmazon×OpenAI提携発表では、Stateful Runtime EnvironmentがOpenAIとAWSの共同開発であることが発表されました。OpenAIのモデルを活用したエージェントが、Bedrock上でステートフルに動作する基盤として位置づけられています。
出典:Introducing the Stateful Runtime Environment for Agents in Amazon Bedrock - OpenAI
Stateful Runtimeのユースケース例
- 大規模データ分析:数百万件のレコードを段階的に処理し、途中結果を保持しながらレポートを生成
- 承認ワークフロー:上長の承認を待つ間、処理状態を保持して承認後に再開
- マルチステップ調査:複数のデータソースを順次調査し、途中経過を記憶して最終レポートを作成
7. マルチエージェント構成の概要
7-1. マルチエージェントとは
複数のエージェントが協調して1つのタスクを処理するアーキテクチャです。AgentCoreはマルチエージェント構成をネイティブにサポートしています。
7-2. 構成パターン

7-3. マルチエージェントの実装例(概念)
from strands import Agent, tool


# === Agent A: 情報収集エージェント ===
@tool
def search_database(query: str) -> str:
    """社内データベースを検索します。"""
    return f"「{query}」に関する検索結果: ..."

info_agent = Agent(
    system_prompt="あなたは情報収集の専門家です。指示に従いデータを検索してください。",
    tools=[search_database],
)


# === Agent B: 分析エージェント ===
@tool
def analyze_data(data: str) -> str:
    """データを分析し、要約を返します。"""
    return f"分析結果: {data} の傾向は..."

analysis_agent = Agent(
    system_prompt="あなたはデータ分析の専門家です。与えられたデータを分析してください。",
    tools=[analyze_data],
)


# === Manager Agent: 統括エージェント ===
@tool
def delegate_to_info_agent(query: str) -> str:
    """情報収集エージェントにタスクを委任します。"""
    response = info_agent(query)
    return str(response)

@tool
def delegate_to_analysis_agent(data: str) -> str:
    """分析エージェントにタスクを委任します。"""
    response = analysis_agent(data)
    return str(response)

manager_agent = Agent(
    system_prompt="""あなたは複数の専門エージェントを統括するマネージャーです。
ユーザーの要求に応じて、適切な専門エージェントにタスクを委任してください。
1. 情報が必要な場合 → 情報収集エージェントに委任
2. 分析が必要な場合 → 分析エージェントに委任
3. 結果を統合してユーザーに報告してください。""",
    tools=[delegate_to_info_agent, delegate_to_analysis_agent],
)

# 実行
response = manager_agent("先月の売上データを調べて、傾向を分析してください。")
print(response)
マルチエージェントのメリット
- 専門性の分離:各エージェントが得意分野に特化し、精度が向上
- スケーラビリティ:エージェントの追加・変更が容易
- 再利用性:汎用的なエージェント(検索、分析、レポート作成等)を複数の業務で共有可能
ただし、エージェント間の通信コスト(LLMの推論回数増加)やデバッグの複雑さなどのトレードオフもあります。シンプルなタスクでは単一エージェントの方が効率的な場合もあります。
出典:Scaling Multi-Agent Systems: Amazon Bedrock AgentCore 2026 Guide - MyTechMantra
8. 本番運用のベストプラクティス
8-1. メモリ設計
| ベストプラクティス | 説明 |
|---|---|
| メモリ戦略は用途に合わせて選択 | すべての戦略を有効にするのではなく、必要な戦略のみ選択してコストを最適化 |
| actor_idの設計を慎重に | ユーザー識別子として一貫したIDを使用。変更するとメモリが分断される |
| メモリの定期的なクリーンアップ | 不要な長期記憶が蓄積するとコストとノイズが増加する |
8-2. セキュリティ
| ベストプラクティス | 説明 |
|---|---|
| IAMポリシーの最小権限原則 | エージェントが必要とする最小限の権限のみ付与 |
| VPCエンドポイントの利用 | パブリックインターネットを経由せずにBedrockやAgentCoreにアクセス |
| Guardrailsの併用 | #5で作成したGuardrailsをAgentCoreエージェントにも適用 |
| Identity統合 | Cognito / Okta / OIDC でエンドユーザー認証を実装 |
8-3. 監視とアラート
| ベストプラクティス | 説明 |
|---|---|
| CloudWatchアラームの設定 | エラー率やレイテンシの異常をリアルタイム検知 |
| トレースの有効化 | リクエストの処理フロー全体を可視化し、ボトルネックを特定 |
| 定期的なログレビュー | エージェントの判断ミスや想定外のツール呼び出しを定期チェック |
| コスト監視 | トークン使用量の推移を監視し、想定外のコスト増加を早期検知 |
8-4. テスト戦略

AIエージェントは非決定的です
同じ入力に対しても異なる応答やツール選択をする場合があります。テストでは「完全一致」ではなく「期待される振る舞いの範囲内か」を検証するアプローチが必要です。
9. 料金について
| サービス | 料金 | 備考 |
|---|---|---|
| AgentCore Runtime | CPU・メモリの実消費量に応じた従量課金(1秒単位) | I/O待機中はCPU課金なし。メモリ最小128MB |
| AgentCore Memory | 短期記憶:イベント作成数、長期記憶:保存レコード数+取得回数に応じた従量課金 | 組み込み戦略の利用料は含まれる |
| AgentCore Gateway | MCPオペレーション・検索クエリ・インデックス化ツール数に応じた従量課金 | |
| AgentCore Identity | OAuthトークン/APIキーリクエスト数に応じた従量課金 | Runtime/Gateway経由の場合は追加料金なし |
| Bedrockモデル利用料 | トークン課金 | エージェントが使用するLLMの料金 |
| CloudWatch | ログ・メトリクスの保存量 | 無料利用枠あり |
メモリの利用コストについて
エピソード記憶は過去の経験を蓄積するため、長期運用ではメモリの保存量が増加していきます。定期的なクリーンアップや、メモリ戦略の見直しを行うことでコストを最適化してください。
料金体系はサービスの成熟に伴い変更される可能性があります。最新の料金は公式ページをご確認ください。
出典:Amazon Bedrock AgentCore - AWS
ハンズオン終了後のリソース削除を忘れずに
- AgentCore Runtime にデプロイしたエージェント
- 作成したメモリリソース
- Lambda関数(#4で作成したもの含む)
- ナレッジベース・S3バケット(#3で作成したもの含む)
- Guardrail(#5で作成したもの)
- 自動作成されたIAMロール
10. おわりに(シリーズ全体のまとめ)
ここまでお読みいただきありがとうございます。
全7回にわたるAmazon Bedrockシリーズ、お疲れさまでした。
今回は、AgentCoreのMemory機能(短期・長期・エピソード記憶) とStateful Runtime、マルチエージェント構成を解説し、記憶を持つ高度なAIエージェントを構築しました。
Amazon Bedrockは、生成AIを安全に、手軽に、スケーラブルに活用するための包括的なプラットフォームです。このシリーズを通じて、概要の理解から本番運用レベルのエージェント構築まで、一通りの流れを体験できたかと思います。
生成AI・AIエージェントの技術は日々進化しています。AWSの公式ドキュメントやブログを定期的にチェックし、最新のアップデートをキャッチアップしていきましょう。
このシリーズが、皆さんのAmazon Bedrock活用の一助になれば幸いです。
ではまた、お会いしましょう。
参考リンク
Amazon Bedrock AgentCore Memory 公式ドキュメント
- Strands Agents SDK - Amazon Bedrock AgentCore Memory - AWS
- Amazon Bedrock AgentCore - AWS
- Amazon Bedrock AgentCore Memory - GitHub
- Memory Gateway Agent - Amazon Bedrock AgentCore Starter Toolkit
長期メモリ技術解説
- Building smarter AI agents: AgentCore long-term memory deep dive - AWS Blog
- Amazon Bedrock AgentCore Memory: Building context-aware agents - AWS Blog
エピソード記憶・Stateful Runtime
- Build agents to learn from experiences using Amazon Bedrock AgentCore episodic memory - AWS Blog
- Introducing the Stateful Runtime Environment for Agents in Amazon Bedrock - OpenAI
- New Amazon Bedrock AgentCore capabilities - About Amazon
マルチエージェント・構築事例
- Scaling Multi-Agent Systems: Amazon Bedrock AgentCore 2026 Guide - MyTechMantra
- The 2026 Guide to Amazon Bedrock AgentCore - goml.io
- Amazon Bedrock AgentCore - Building Intelligent AI Agents with Advanced Memory - fp8.co
- Amazon Bedrock AgentCore Runtime - Using short-term memory with Strands - DEV Community