
MIT開発の画像エージェント「VISTA」が示すマルチモーダル記憶管理の威力
テキストベースのLLMエージェントにおいて、「過去ログを全保持し、検索ツール(Tool/RAG)経由で必要な情報だけをプロンプトに引き戻す」コンテキストエンジニアリングの手法はすでに定着しています。
このアプローチを画像・ビジョン領域へと拡張したのが、MITのQiushi Han氏らによって発表されたマルチモーダルエージェント基盤 「VISTA」(MITライセンスでOSS公開)です。
視覚的推論ベンチマーク 「ARC-AGI-3」 において、初見の人間に比べて57.4%少ないアクション数(Relative Human Action Efficiency: 100 RHAE)で全パズルをクリアするなど、顕著な効率向上を実証しました。
本記事では、VISTAが解決した既存ビジョンエージェントの課題、記憶とツールのアーキテクチャ、そしてエンジニア視点での技術的示唆をまとめます。
1. 従来のビジョンエージェントが抱えていた問題点
ゲームやGUI操作などのインタラクティブ環境を自律エージェントに操作させる際、これまでは以下のような「埋め込み(Embedding)依存の逐次破棄」が一般的でした。
-
Embeddingの情報損失(Lossy)
- 入力フレームを画像エンコーダに通してベクトル化すると、背景の微細なピクセル変化や細部情報が不可逆に失われる。
-
コンテキスト長枯渇による完全ロスト
- コンテキストウィンドウの上限に達したフレーム(またはEmbedding)は削除されるため、後から「あの数手前の変化は何だったか」を検証できなくなる。
VISTAは、「すべての入力フレームを生画像として永続メモリに蓄積し、必要に応じてエージェント自らが『検索(Retrieve)』および『局所拡大(Zoom-in)』できるツールを与える」 ことでこのボトルネックを解消しました。
2. VISTA のアーキテクチャと実行サイクル
VISTAは、バックエンドLLMとして Anthropic Claude Opus 5.0 や OpenAI GPT-5.6 Sol を組み合わせて動作します。
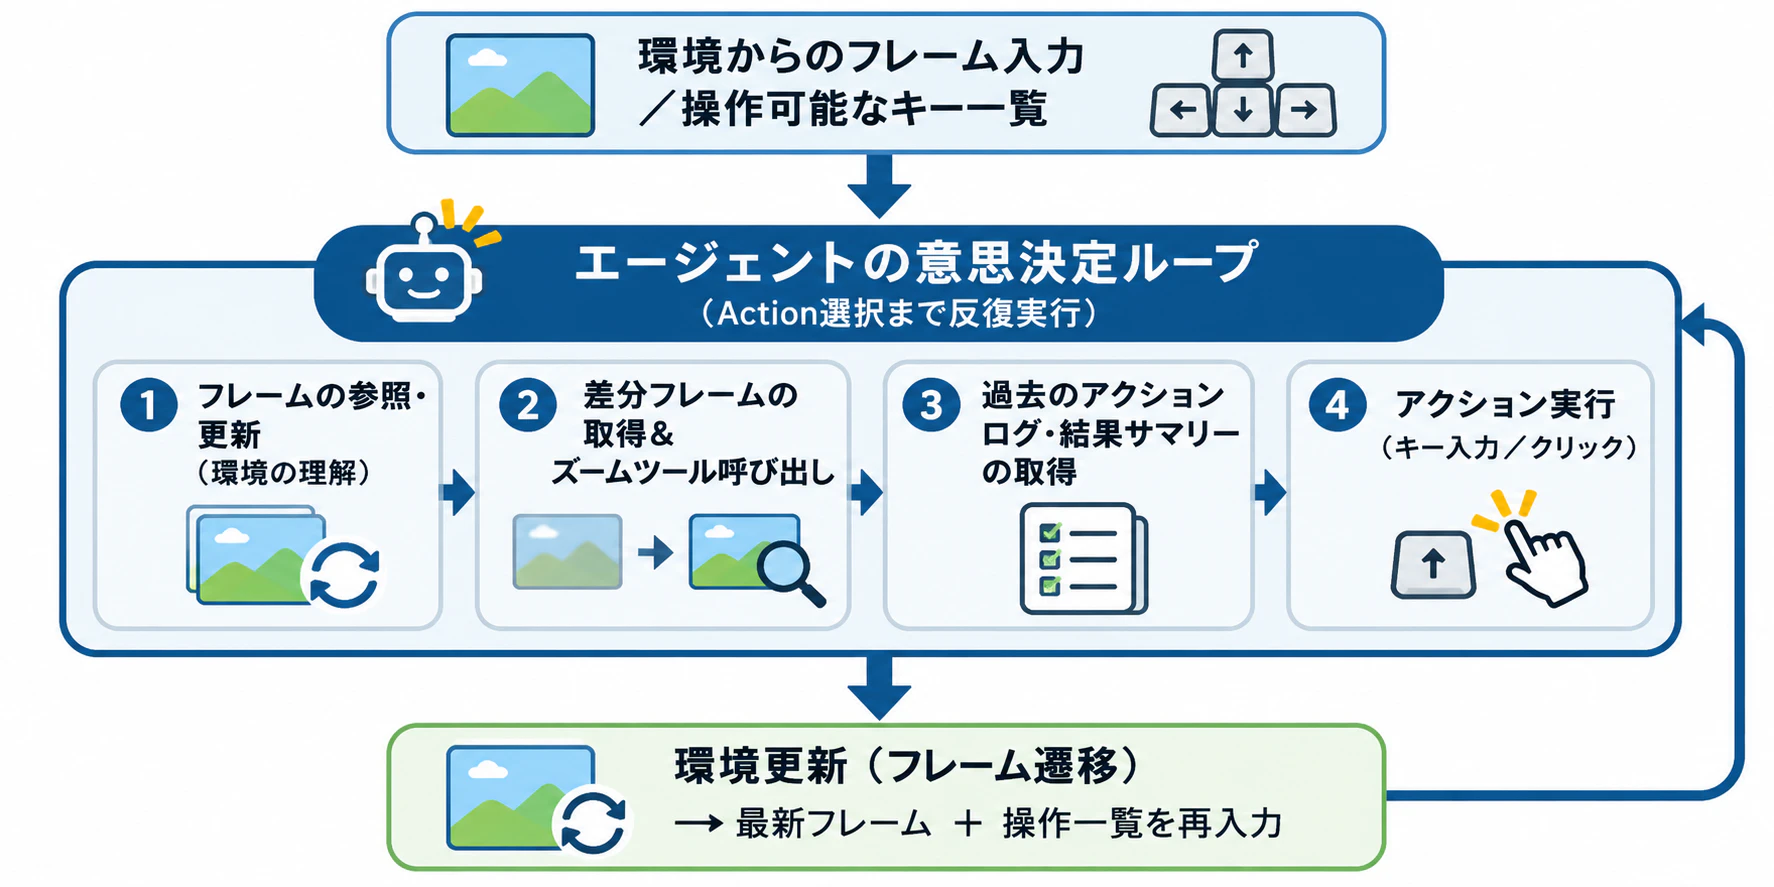
コアとなる3つのメカニズム
-
階層化された外部ノート(Dual Notes)
-
セッション横断の知見ノート: 「茶色のブロックと黒い背景の判定基準」など、レベルや環境を越えて再利用できるルールを記述。
-
現在の課題ノート: 「現在のキャラの強化状態」「直前に失敗した条件」など、当該タスク特有の状態を記録。
-
-
画像の動的リトリーバル & ズームイン(Zoom-in Tool)
- 過去の任意フレームを取り出し、さらに特定の矩形領域をクロップ・拡大してコンテキストへ再注入できる。これにより、全体フレームでは見落としていた微細なピクセル差異を再認識可能。
-
行動履歴と結果のトラッキング
- 過去の操作ログおよびその成否サマリーを保持し、試行錯誤の重複を防ぐ。
3. ベンチマーク結果
視覚的パズルおよびゲーム環境において、初見の人間プレイヤー(First-time human players)および従来型ハーネスを大きく上回る性能を示しています。
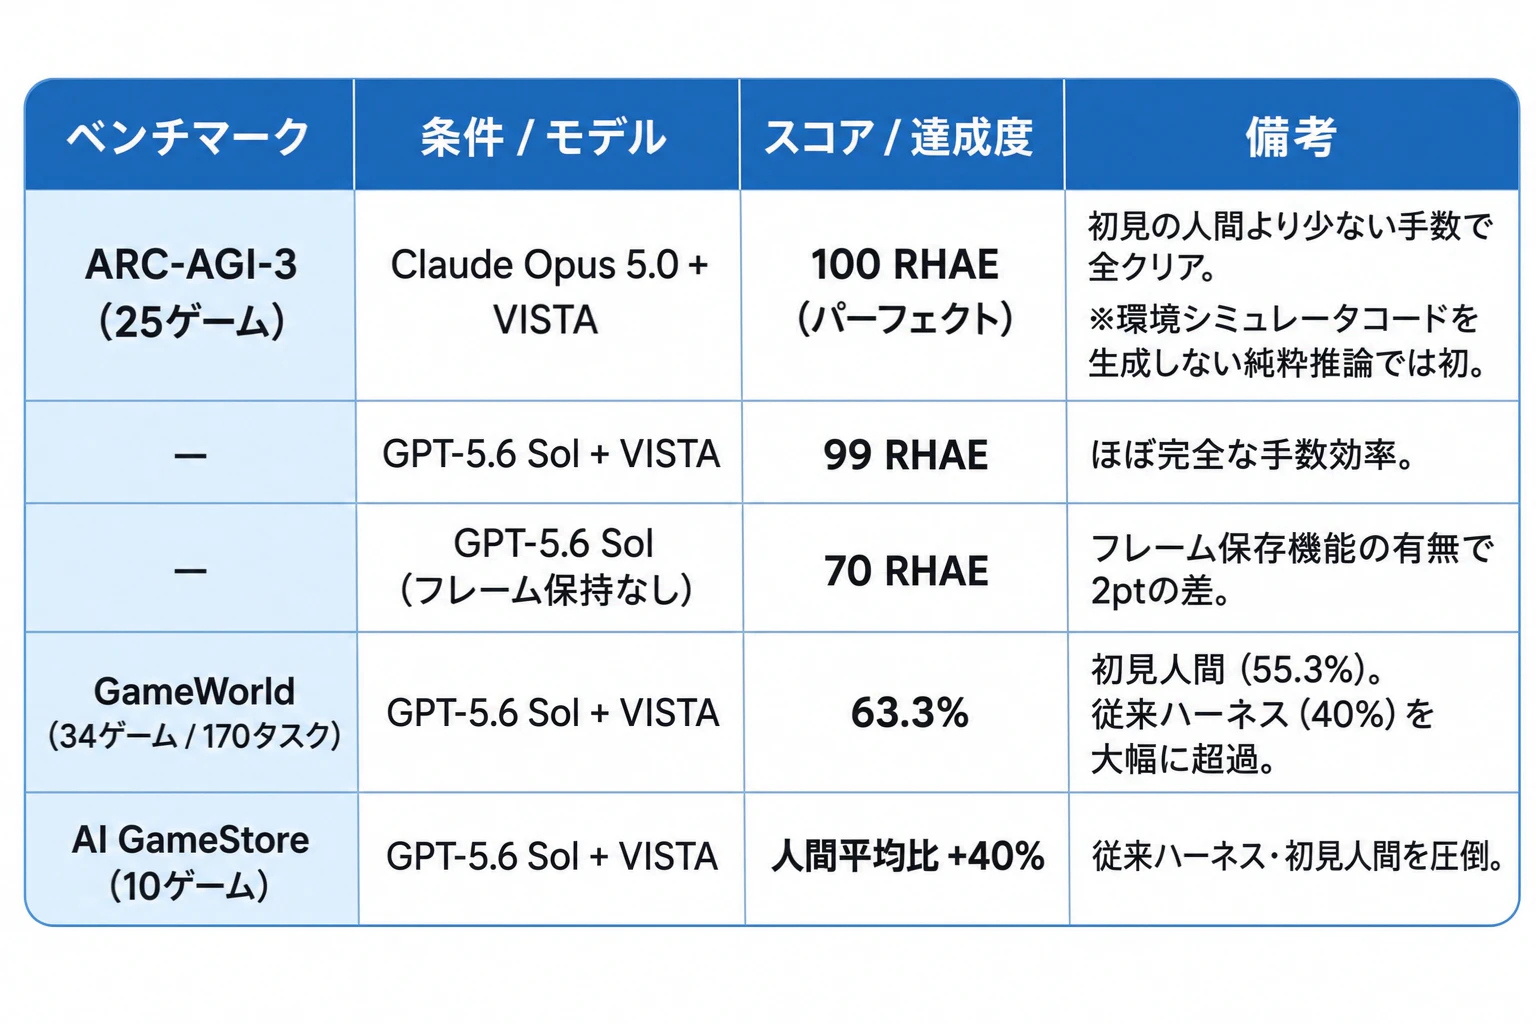
RHAE(Relative Human Action Efficiency) は、AIが人間と比べて、どれだけ効率よく行動して課題を達成できたかを表す指標です。
4. エンジニア視点での技術的示唆
① テキストのRAGから「マルチモーダルRAG(MM-RAG)」へ
エージェントのコンテキストウィンドウを無制限に広げるのではなく、「外部ストレージ(生画像)+検索・切り出しツール(API)」という疎結合なアーキテクチャが画像領域でも最もトークン効率・推論精度が高いことが証明されました。
② 解像度とコンテキスト消費のトレードオフ解決
高解像度画像をそのままトークン化して入れ続けるとコストとレイテンシが爆発します。VISTAのように「通常時は全体フレームの概要を把握し、疑問が生じた箇所だけズームインして高解像度トークンを消費する」設計は、Web GUI操作エージェント(Computer Use)や工場の外観検査エージェントの設計にも直結する有効なパターンです。
「マルチモーダルモデルだからすべてを一度に理解させる」のではなく、「マルチモーダルなコンテキスト管理(Context Engineering)をシステム側でどう設計するか」が、今後の自律エージェント開発の主戦場になることを示唆しています。
作成日:2026/11/07