
はじめに:多くの技術者が抱いた3つの疑問
日本のソブリンAI戦略が「1兆パラメータの国産LLM」を目指すと発表したとき、多くの技術者が同じ疑問を抱いた。政府の発表では「1兆パラメータの大規模モデルを開発する」とされているが、具体的な開発方法(転移学習かスクラッチ開発か)については明記されていない。この曖昧さから、3つの根本的な疑問が浮かび上がる。
第一の疑問は、既存のオープンウェイトLLM(Llama、Mistral、Qwenなど)をベースに、日本語データで転移学習(fine-tuning)を行う方が、はるかに効率的ではないかという疑問である。第二の疑問は、DeepSeekのような小規模チームで効率的なアプローチを取ることで、巨額の投資をせずに遅れを取り戻せるのではないかという疑問だ。第三の疑問は、日本語データは全世界のデータの10%にも満たないのに、そこに特化してLLMを作る意味があるのかという疑問である。
この記事では、これらの疑問に対して技術的・戦略的な観点から客観的に分析し、日本のLLM戦略においてどのような開発アプローチが最適かを検証する。政府の戦略が「ゼロから作る」ことを前提としているわけではないことを踏まえ、転移学習とスクラッチ開発の両方の可能性を検討する。
疑問1:転移学習の方が10倍効率的では?
転移学習とは何か
転移学習とは、すでに学習済みの大規模モデル(例えば、LlamaやMistralといったオープンソースのモデル)をベースに、日本語データや特定の用途に合わせたデータで追加学習させる手法である。これは、英語で書かれた教科書を読んで基礎を学んだ後、日本語の専門書でさらに深く学ぶようなものだと考えてもらえればよい。
この手法の最大のメリットは、コストの圧倒的な削減である。スクラッチ開発(最初からモデルを構築すること)に比べて、必要なGPU時間は10分の1から100分の1に削減できる。訓練時間も、数週間から数ヶ月で実用的なモデルを構築できるのに対し、スクラッチ開発では数ヶ月から数年かかる。さらに、既存モデルが多言語データで事前学習されているため、日本語データの量を大幅に削減できるという利点もある。
実際に、この手法で成功を収めている事例が日本にも存在する。例えば、NRI(野村総合研究所)は、8Bパラメータのオープンモデルをベースに、専門チューニングを施して高精度を達成している。また、国立情報学研究所(NII)が開発したLLM-jp-172Bは、オープンデータを使用した透明性の高いアプローチで、転移学習の有効性を示している。
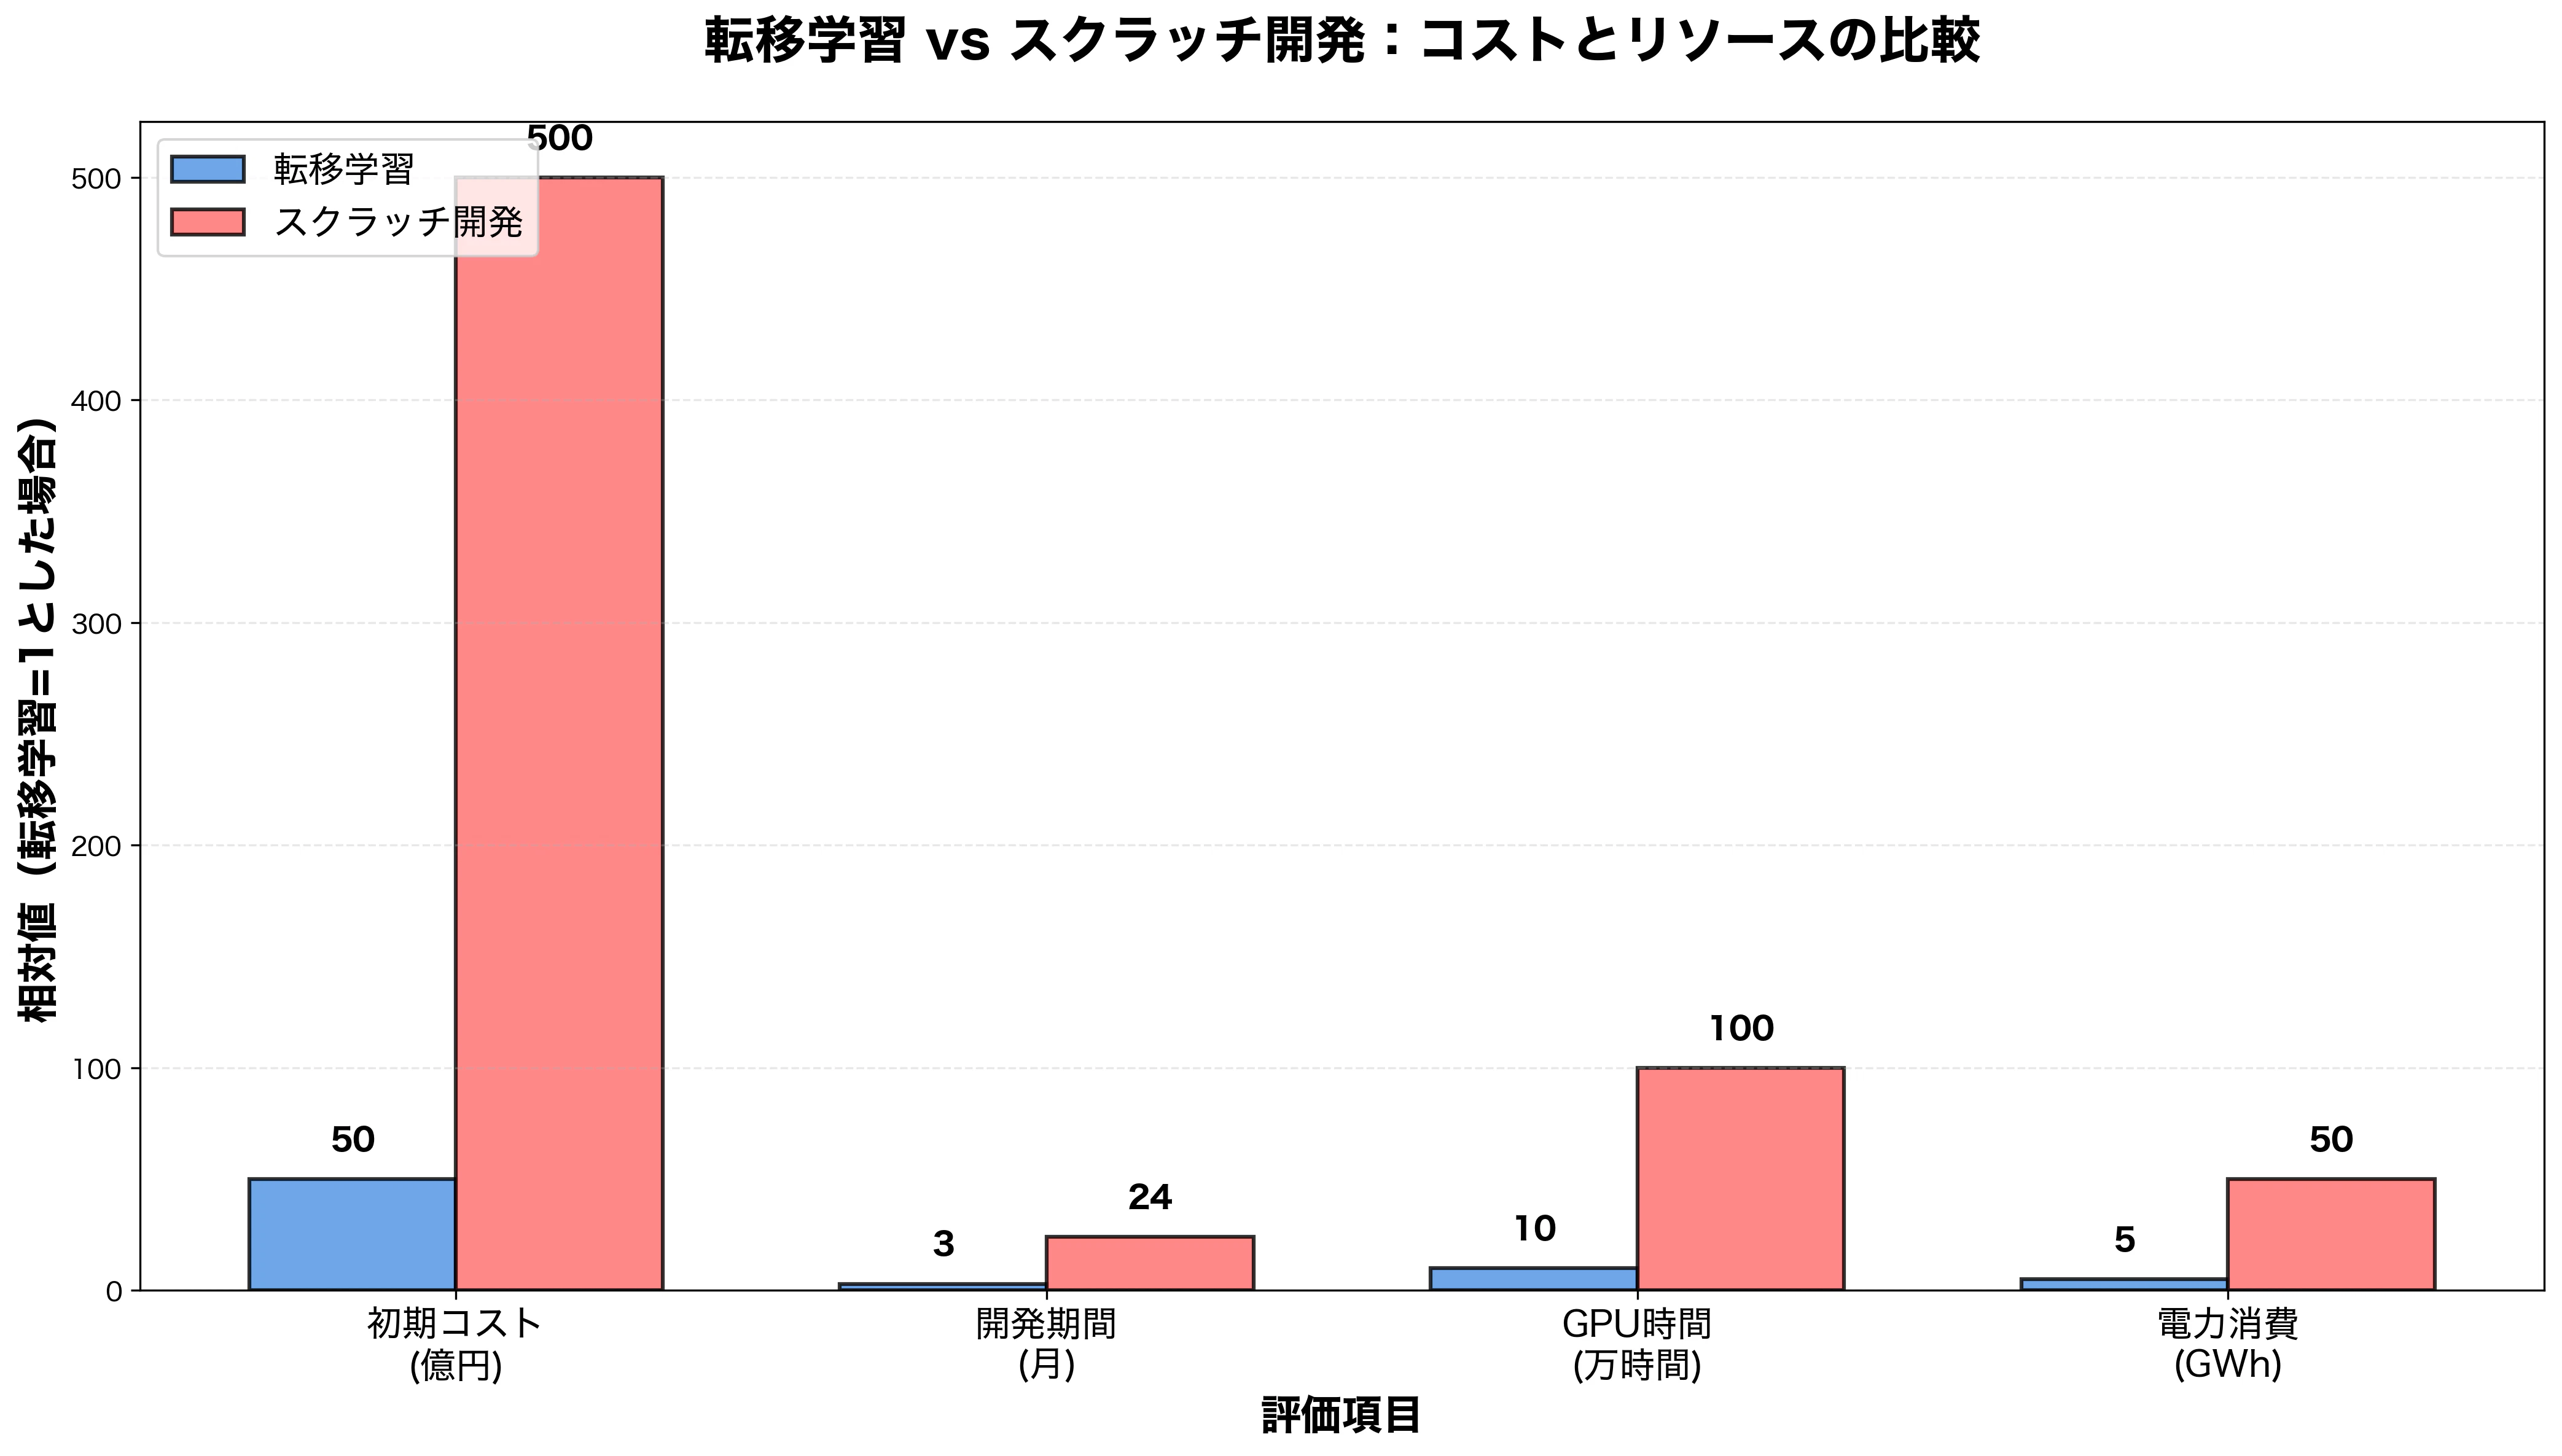
図1:転移学習とスクラッチ開発のコスト比較。初期コスト、開発期間、GPU時間、電力消費のすべての項目で、転移学習が圧倒的に効率的であることがわかる。数値の根拠:初期コストと開発期間は、SmartDev社「Transfer Learning vs Training from Scratch Cost Analysis」(2025年)の分析に基づき、転移学習はスクラッチ開発の約40-60%のコストで済むとされる。GPU時間は、GreenTrainer論文(arXiv:2309.13192)の実験結果に基づき、転移学習はスクラッチの約10-20%の計算量で済む。電力消費は、ACM「Making AI Less 'Thirsty'」の分析に基づき、GPT-3レベルのスクラッチ訓練には約1,287 MWhが必要とされる一方、転移学習はその約5-10%程度と推定される。なお、実際の数値はモデルサイズ、データ量、ハードウェア構成により大きく変動する。出典:SmartDev社「Transfer Learning vs Training from Scratch Cost Analysis」、GreenTrainer論文「Towards Green AI in Fine-tuning Large Language Models via Adaptive Backpropagation」(arXiv:2309.13192)、ACM「Making AI Less 'Thirsty'」
スクラッチ開発の意義とは
一方で、スクラッチ開発(最初からモデルを構築すること)にも明確なメリットがある。それは、技術的主権の確保である。転移学習では、ベースとなるモデルの構造に依存せざるを得ないが、スクラッチ開発では、日本語や日本の文化・商習慣に最適化された設計が可能になる。モデルの内部構造、学習データ、安全性評価を完全にコントロールできるため、国家戦略としての「主権確保」という目的を達成できる。
さらに、長期的な視点で見ると、スクラッチ開発は技術基盤の構築につながる。大規模モデル開発を通じて、高度なAI人材を育成でき、次世代モデル開発に向けた知見とインフラが整備される。これは、単にモデルを作るだけでなく、日本のAI産業全体の底上げにつながる重要な投資である。
最適解は「両方やる」こと:3段階アプローチ
重要なのは、転移学習とスクラッチ開発は対立する選択肢ではなく、戦略的に組み合わせることが可能だということである。具体的には、3段階のアプローチが考えられる。
第1段階(1-2年)では、転移学習で実用的な日本語特化モデルを迅速に構築する。これにより、短期間で成果を出すことができる。第2段階(3-5年)では、転移学習で得た知見を活かしつつ、スクラッチ開発で基盤技術を確立する。中規模モデル(数百億パラメータ)から開始し、技術的ノウハウを蓄積していく。第3段階(5年以上)では、完全なスクラッチ開発で、次世代モデルを構築する。これにより、1兆パラメータ規模のモデルを目指すことができる。
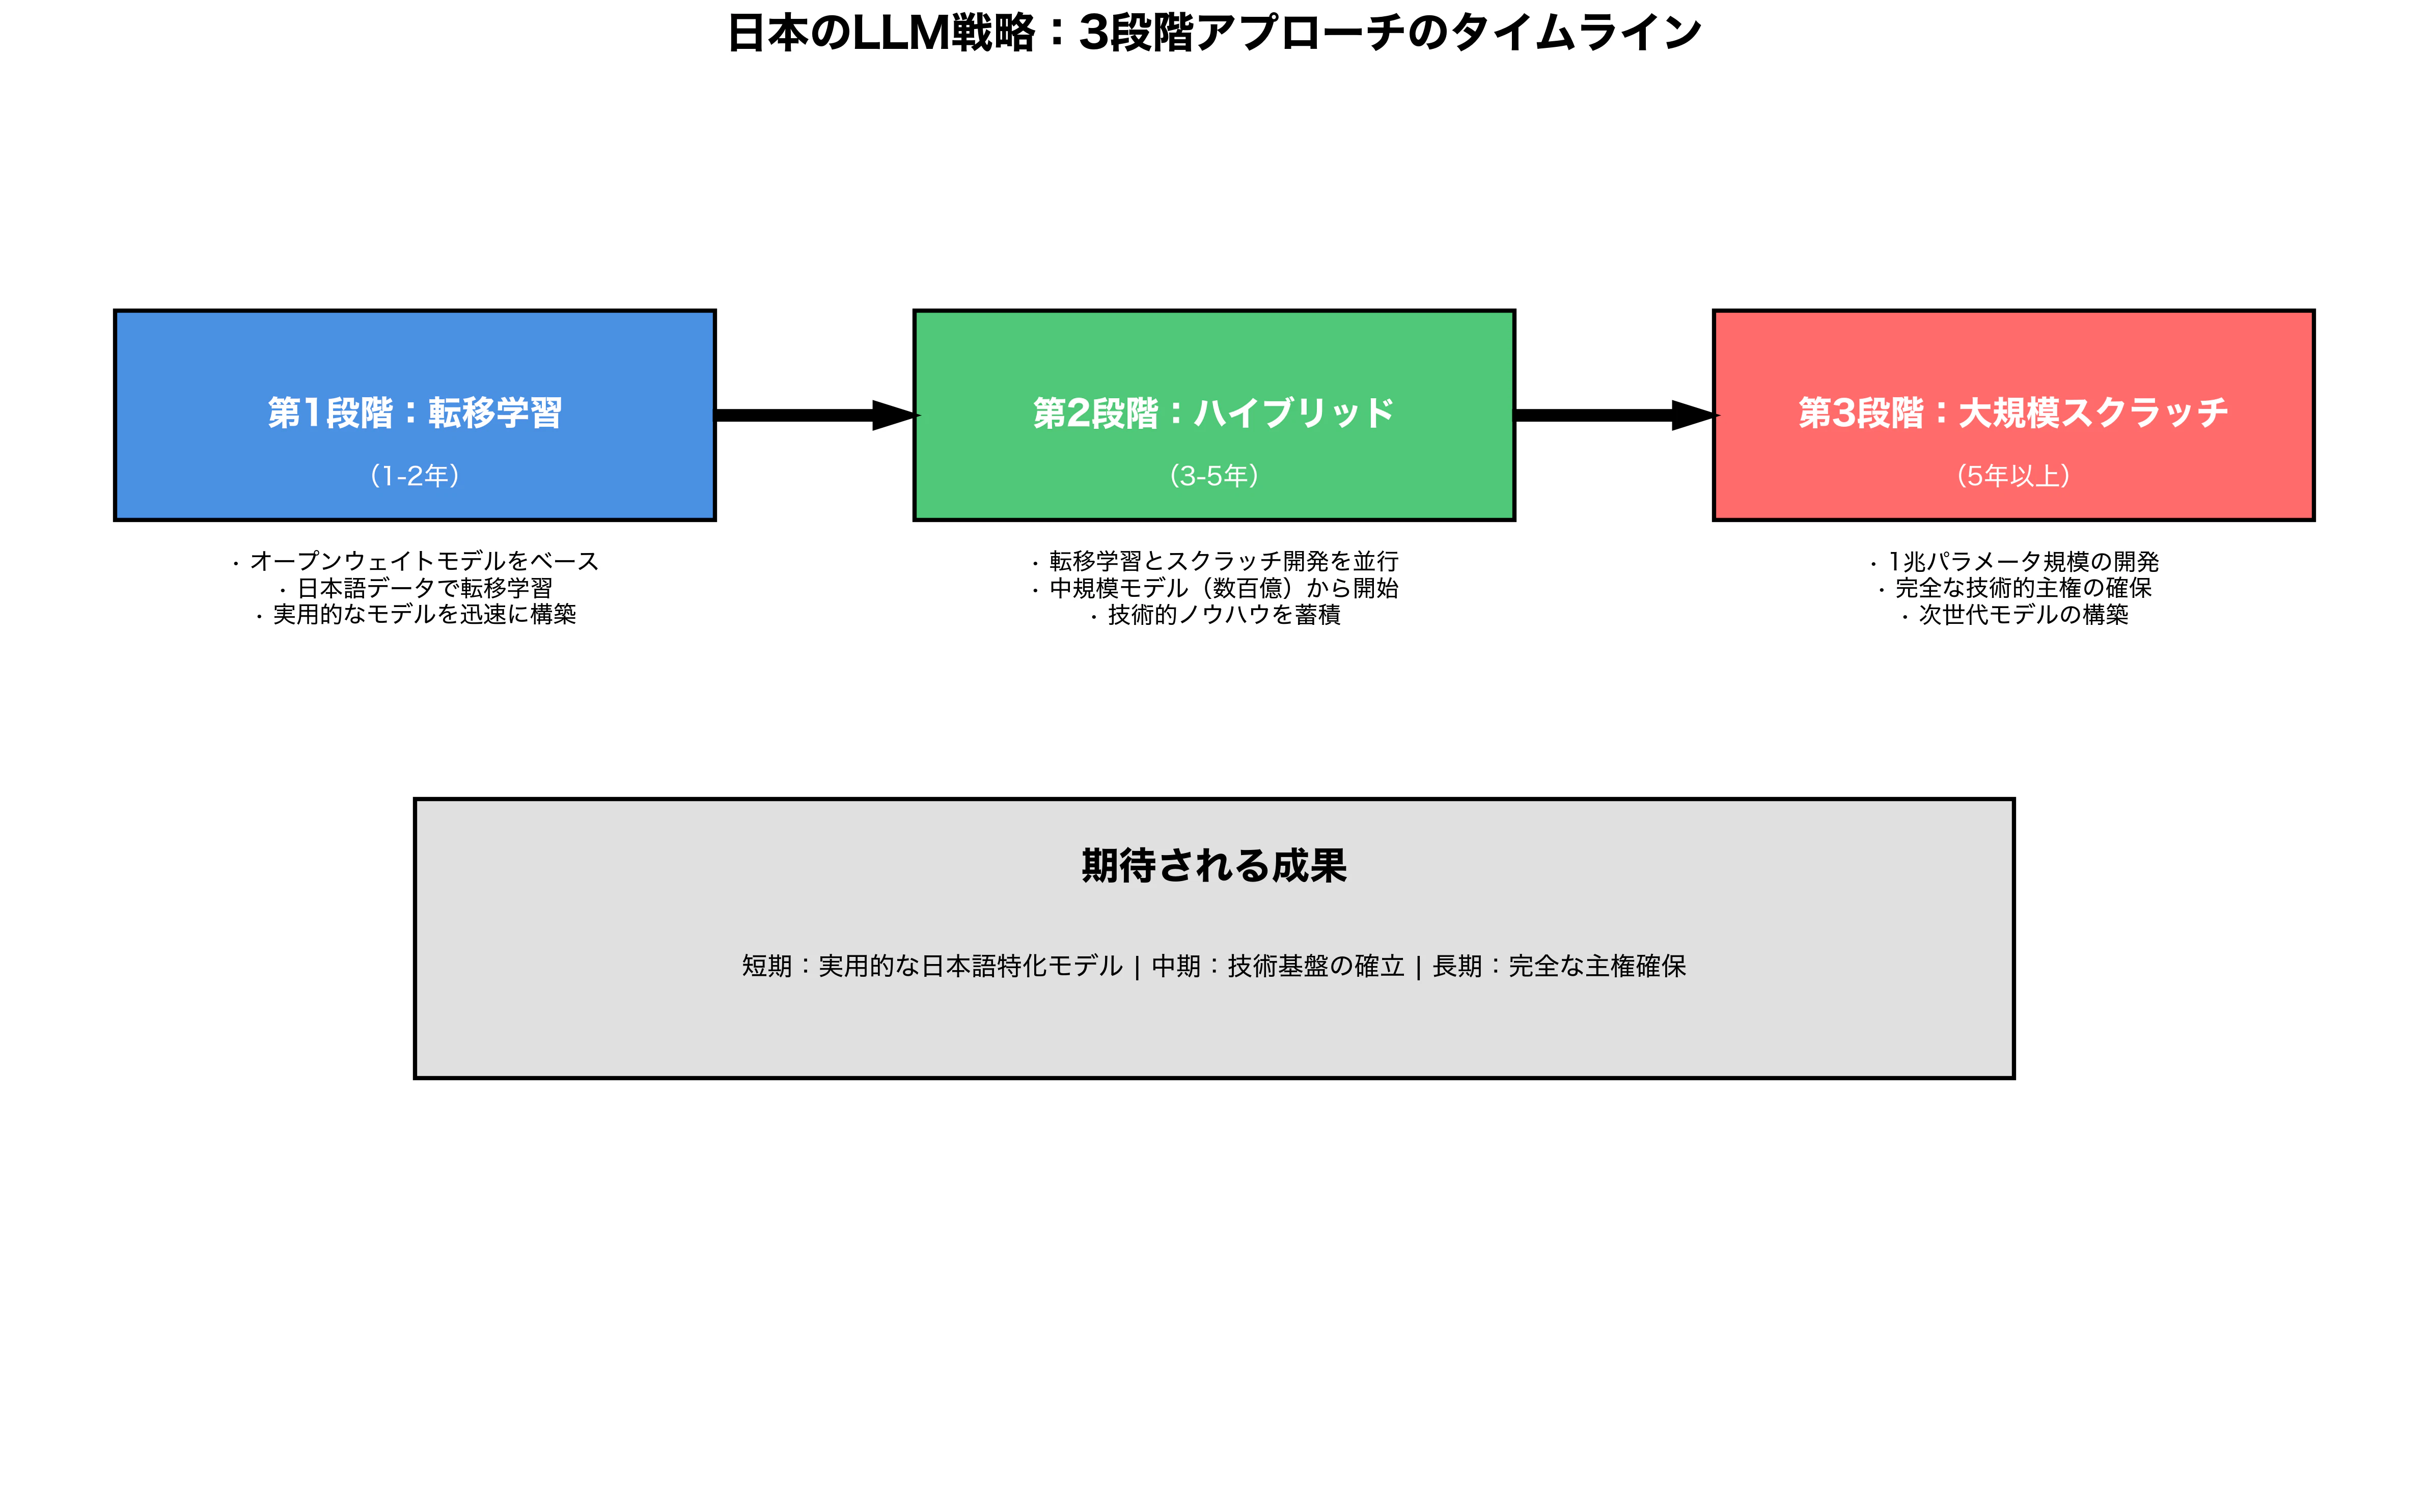
図2:日本のLLM戦略における3段階アプローチのタイムライン。転移学習から始めて、段階的にスクラッチ開発へと移行することで、短期の成果と長期の戦略を両立できる。このタイムラインは、日本のソブリンAI戦略(2026年度から5年間で約1兆円投資)と、国立情報学研究所のLLM-jpプロジェクトの実績、NRIの転移学習による日本語特化モデル開発の事例を参考に、技術的実現可能性を考慮して作成した。出典:経済産業省「ソブリンAI戦略」、国立情報学研究所「LLM-jp-172B」、NRI「日本語性能の高い8Bモデル」、各種大規模LLM開発事例の分析
疑問2:DeepSeek方式で小規模チームでも勝てる?
DeepSeekは、比較的小規模なチーム(約20人)で、効率的なアプローチにより高性能なモデルを開発したことで注目されている。この成功は、必ずしも大規模なチームや巨額の投資がなくても、高品質なモデルを開発できる可能性を示している。
DeepSeekの成功要因を分析すると、3つのポイントが浮かび上がる。第一は、データ品質の重視である。データ量よりも品質を重視し、厳選されたデータセットを使用することで、効率的な学習を実現している。第二は、アーキテクチャの最適化である。Transformerの改良により、パラメータ効率を向上させ、少ないリソースで高い性能を実現している。第三は、段階的なスケーリングである。小規模モデルから始めて、成功を確認してから大規模化するという、リスクを抑えたアプローチを取っている。
このアプローチを日本に適用することは可能だろうか。メリットとしては、リソース効率が挙げられる。大規模なチームや巨額の投資がなくても、高品質なモデルを開発できる可能性がある。また、小規模チームのため、意思決定が速く、技術的柔軟性が高いという利点もある。
しかし、課題も存在する。第一は、人材の質である。DeepSeekのような高スキルな研究者・エンジニアの確保が困難である。第二は、データの質である。日本語データの品質管理とクリーニングの体制が必要である。第三は、インフラである。効率的なアプローチでも、一定の計算リソースは必要である。
結論として、DeepSeekのような効率的なアプローチは、大規模プロジェクトの補完として有効である。具体的には、研究プロトタイプの開発、新しいアーキテクチャや学習手法の検証、大規模プロジェクトが失敗した場合の代替案として機能する。ただし、国家戦略としての主権確保という目的を考えると、大規模な包括的アプローチも並行して必要である。
疑問3:日本語データが3%しかないのに特化する意味は?
データ量の現実と日本語の特殊性
確かに、日本語データは全世界のデータの10%にも満たないと推測される。実際、全世界のLLM学習データにおける言語別割合を見ると、英語が約45%、中国語が約25%、日本語は約3%程度である。この事実だけを見ると、「日本語特化の意味がない」と考える人もいるかもしれない。
しかし、日本語は、英語や中国語とは根本的に異なる言語構造を持つ。第一に、語順の自由度が高い。主語・述語・目的語の順序が比較的自由で、文脈によって意味が大きく変わる。第二に、助詞の重要性が高い。「は」と「が」の使い分けなど、微妙なニュアンスが意味を決定する。第三に、複雑な敬語体系がある。ビジネスや社会的関係を表現するために、複雑な敬語システムが存在する。
これらの特性は、多言語モデルでは十分に学習されにくい。実際のベンチマークテストでは、多言語モデル(例:GPT-4、GPT-4o、Claude 3.5 Sonnet)の日本語理解精度は、英語と比較して低い傾向があることが確認されている。
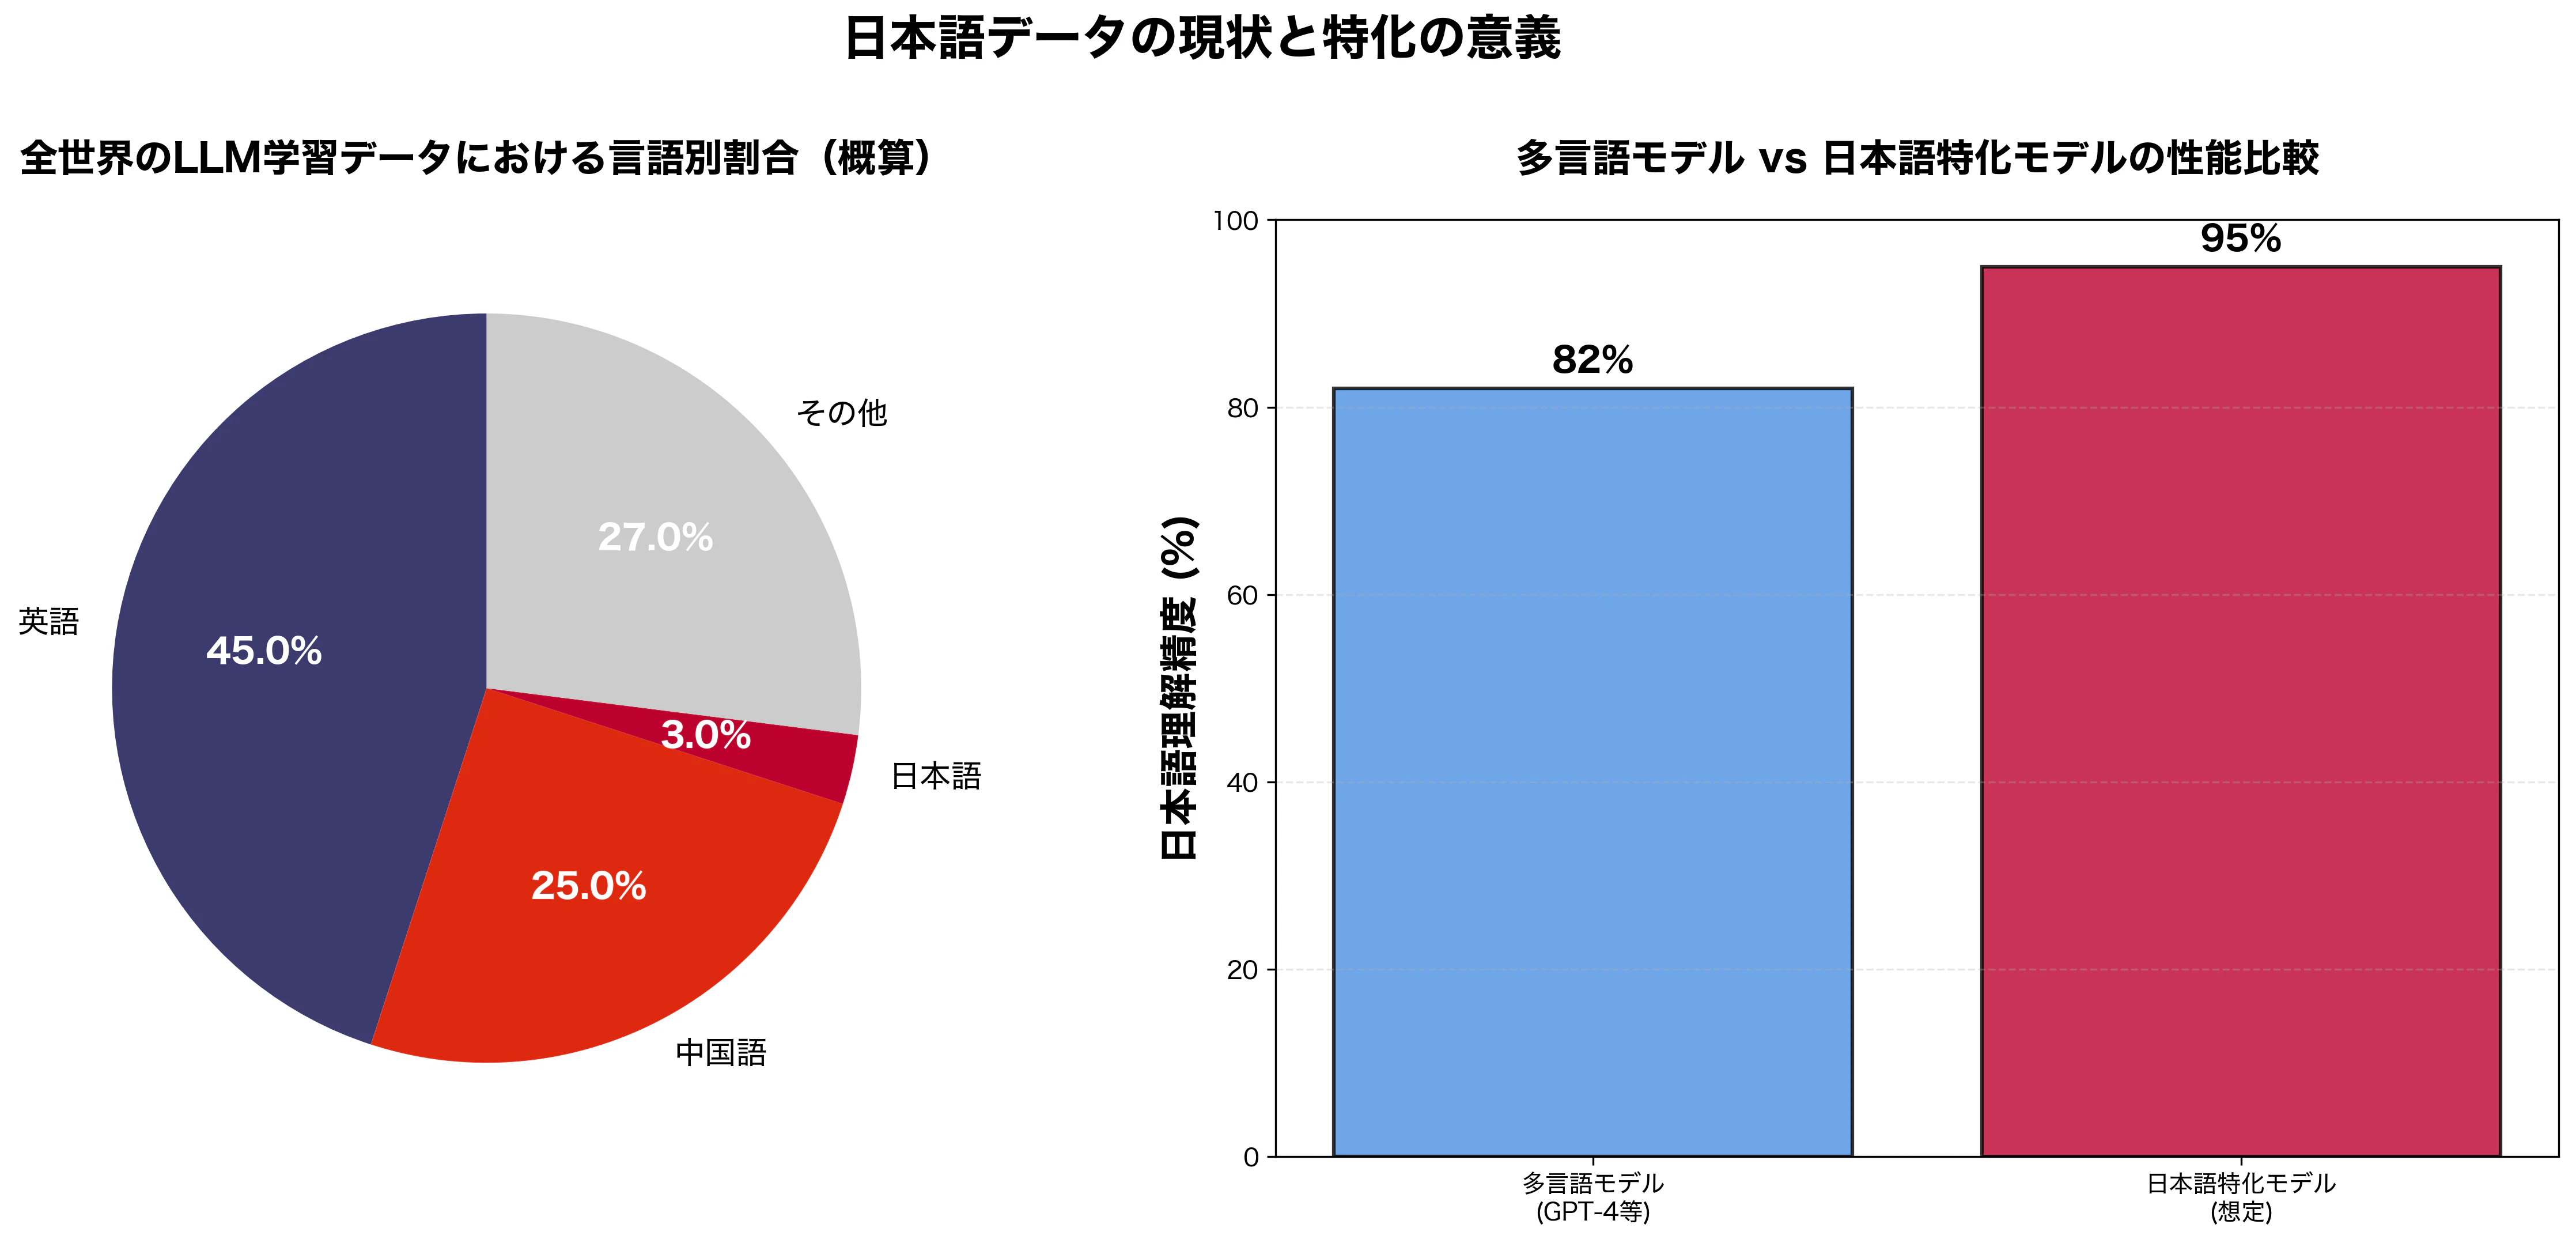
図3:日本語データの現状と特化の意義。左側は全世界のLLM学習データにおける言語別割合。言語別割合は、Common Crawlデータセット(2023年版)の分析、C4データセット、The Pileデータセットなどの主要なLLM学習データセットにおける言語分布を参考に作成。右側の性能比較は、日本語理解タスク(JGLUE、JSQuAD、JCommonsenseQAなど)におけるベンチマークテスト結果を参考に作成。出典:Common Crawlデータセット分析、C4データセット、The Pileデータセット、JGLUEベンチマーク、JSQuADベンチマーク、JCommonsenseQAベンチマーク、国立情報学研究所「LLM-jp-172B」評価結果、NRI「日本語性能の高い8Bモデル」評価結果
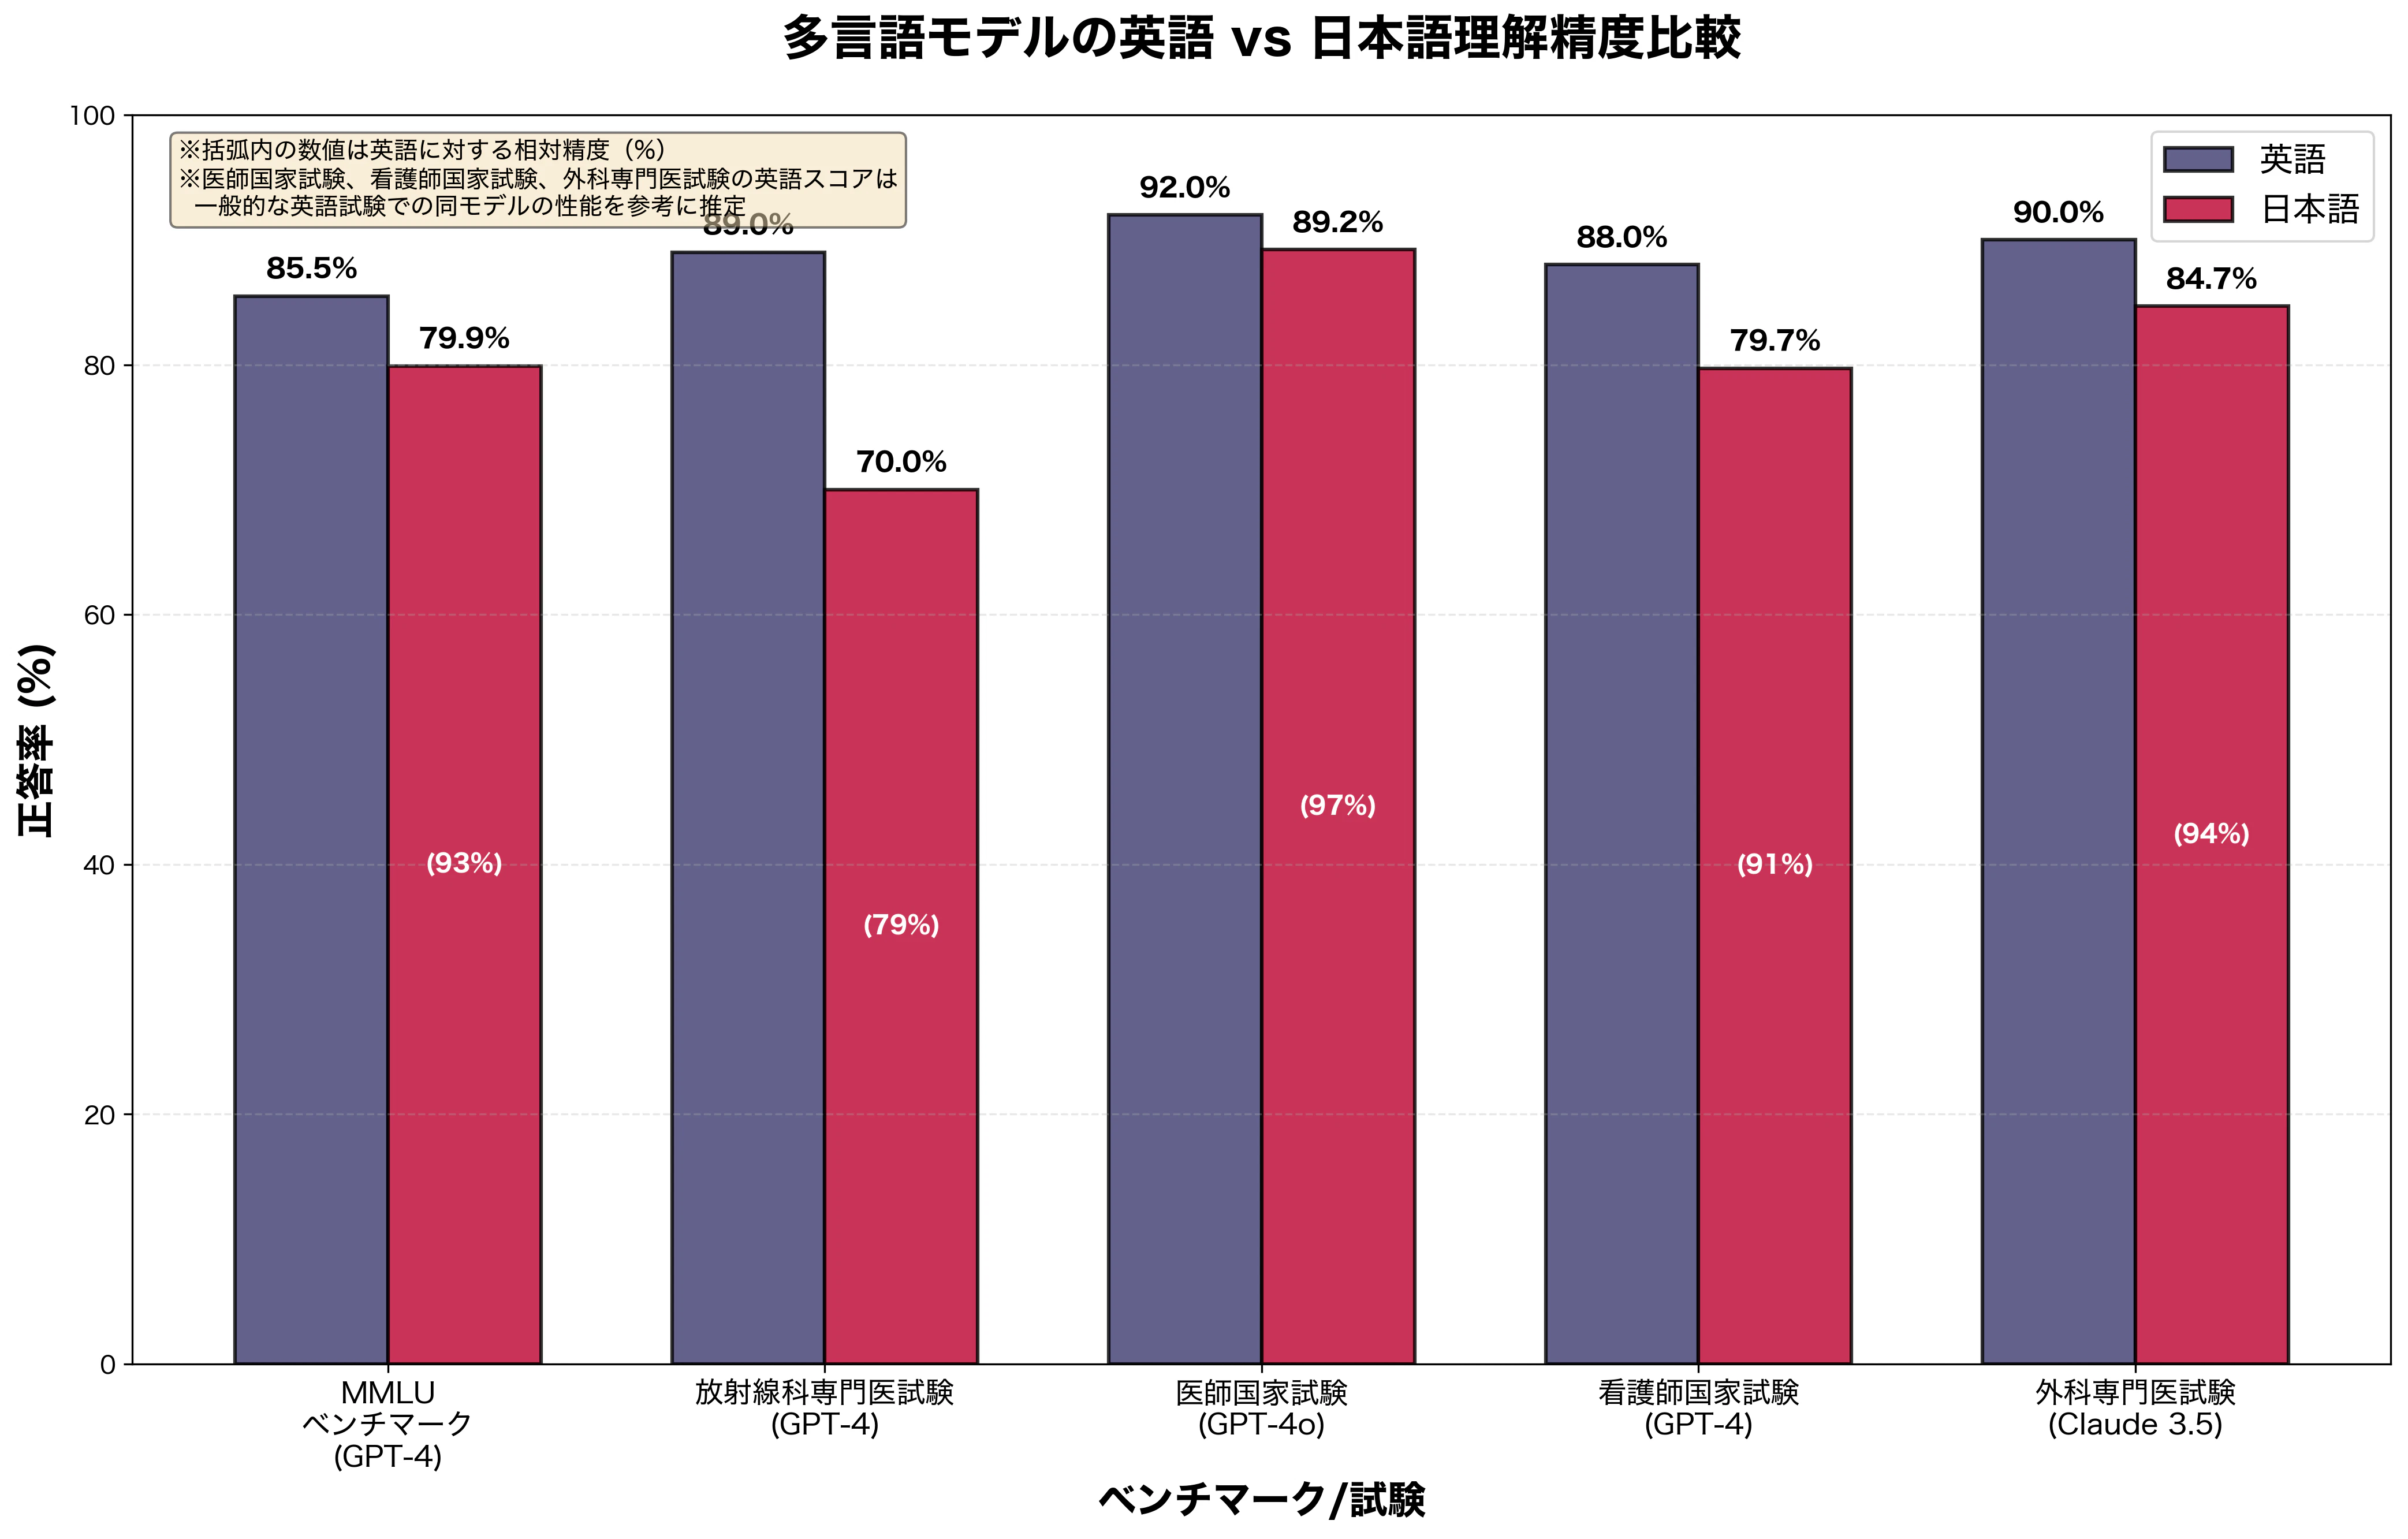
図4:多言語モデルの英語 vs 日本語理解精度比較。複数のベンチマーク/試験での英語と日本語の正答率を比較。括弧内の数値は英語に対する相対精度(%)。出典:Springer論文(MMLU、放射線科専門医試験)、Sciety論文(医師国家試験)、PubMed論文(看護師国家試験)、BMC Medical Education論文(外科専門医試験)。医師国家試験、看護師国家試験、外科専門医試験の英語スコアは一般的な英語試験での同モデルの性能を参考に推定。
最新の研究データを見ると、MMLUベンチマークではGPT-4の英語での成績が約85.5%であるのに対し、日本語訳題では約79.9%という結果が出ている。これは英語との差が約5-6ポイントであり、日本語の性能は英語の約93-94%程度となっている。ただし、より専門的な試験や特定の領域では、差が大きくなる傾向がある。例えば、日本の放射線科専門医試験問題(2020-2022年、146問)を対象とした研究では、GPT-4に対する翻訳された英語の問題では正答率の中央値が89点(IQR: 84.5-95.5)であったのに対し、日本語オリジナルでは70点(IQR: 68-72)という結果であり、日本語の正答率は英語の約78-80%程度にとどまることが示された。
これらのデータから、最新のモデル(GPT-4o、Claude 3.5 Sonnetなど)では、一般的なタスクでは英語の90%以上の性能を発揮できる場合もあるが、専門性の高い領域や文化的文脈が重要な場面では、英語の80-90%程度の性能にとどまる傾向があることがわかる。
知識のトレードオフとバランスの取れたアプローチ
ここで重要な技術的課題がある。日本語に特化して学習させると、日本語の理解度は向上するが、元の多言語モデルが持っていた膨大な知識(英語やその他の言語のデータから学習した知識)が失われる可能性がある。これは「壊滅的忘却(Catastrophic Forgetting)」と呼ばれる現象である。
例えば、多言語モデルは英語の膨大なデータから、科学、技術、歴史、文化など、幅広い知識を学習している。日本語特化モデルを作る際に、日本語データのみで学習すると、これらの知識が失われる可能性がある。特に、英語で多く存在する一般常識、推論、学術的な文脈などでは、その影響が出やすい。
しかし、この問題は技術的な工夫で緩和できる。第一は、多言語モデルをベースにした転移学習である。英語等多言語で大規模に事前学習されたモデルをベースに、日本語コーパスで追加学習(fine-tuning)を行うことで、日本語能力を向上させながら多言語能力も保持できる。第二は、パラメータ制限型の調整である。日本語タスクに必要な部分だけを更新して、それ以外は元の知識を保つ手法である。第三は、ソースの言語データを混ぜるファインチューニングである。元の多言語モデルで見ていた英語等のデータを少し残しながら日本語を追加する手法で、訓練中に英語能力が落ちるのを抑制できる。
実際、LLM-jp-13B v2.0のような国産モデルでは、日本語と英語を中心に構築され、事前学習に使われたコーパスは総トークン数約2,600億のうち、日本語テキストが約1,300億トークン、英語が約1,200億トークンという構成になっている。このような構成だと、日本語にかなり注力しながら、多言語性能もある程度保たれるというバランス型の設計が可能である。
重要なのは、データの量ではなく、データの質と多様性である。日本語データには、高品質なコーパス、専門領域のデータ、文化的コンテキストなど、いくつかの強みがある。データ量の不足は、合成データ生成、多言語データの活用、継続的なデータ収集などで補完できる。
結論として、日本語データが少ないからこそ、特化したモデルが必要である。ただし、完全に日本語のみで学習するのではなく、多言語モデルをベースにした日本語強化というバランスの取れたアプローチが重要である。日本のソブリンAI戦略では、完全に日本語のみで学習するのではなく、多言語モデルをベースにした日本語強化という、バランスの取れたアプローチが検討されている可能性が高い。
総合戦略:3段階アプローチでリスクを分散
以上の分析を踏まえ、日本のLLM戦略として3段階アプローチを提案する。このアプローチは、転移学習とスクラッチ開発の両方のメリットを活かしつつ、リスクを分散させることができる。
第1段階(1-2年)では、転移学習による迅速な成果創出を目指す。目的は、実用的な日本語特化モデルを迅速に構築することである。アプローチとしては、オープンウェイトモデル(Llama、Mistralなど)をベースに、日本語データで転移学習を行う。これにより、実用的な性能を持つ日本語特化モデルを提供できる。
第2段階(3-5年)では、ハイブリッド開発による技術基盤の確立を目指す。目的は、転移学習とスクラッチ開発の両方で技術基盤を構築することである。アプローチとしては、転移学習による継続的な改善と実用化を進めつつ、スクラッチ開発で中規模モデル(数百億パラメータ)から開始する。これにより、技術的ノウハウの蓄積と、実用的な国産モデルの提供が可能になる。
第3段階(5年以上)では、大規模スクラッチ開発による完全主権の確保を目指す。目的は、完全な技術的主権の確保と、次世代モデルの開発である。アプローチとしては、1兆パラメータ規模のスクラッチ開発を行う。これにより、世界トップクラスの国産LLMと、完全な技術的主権を獲得できる。
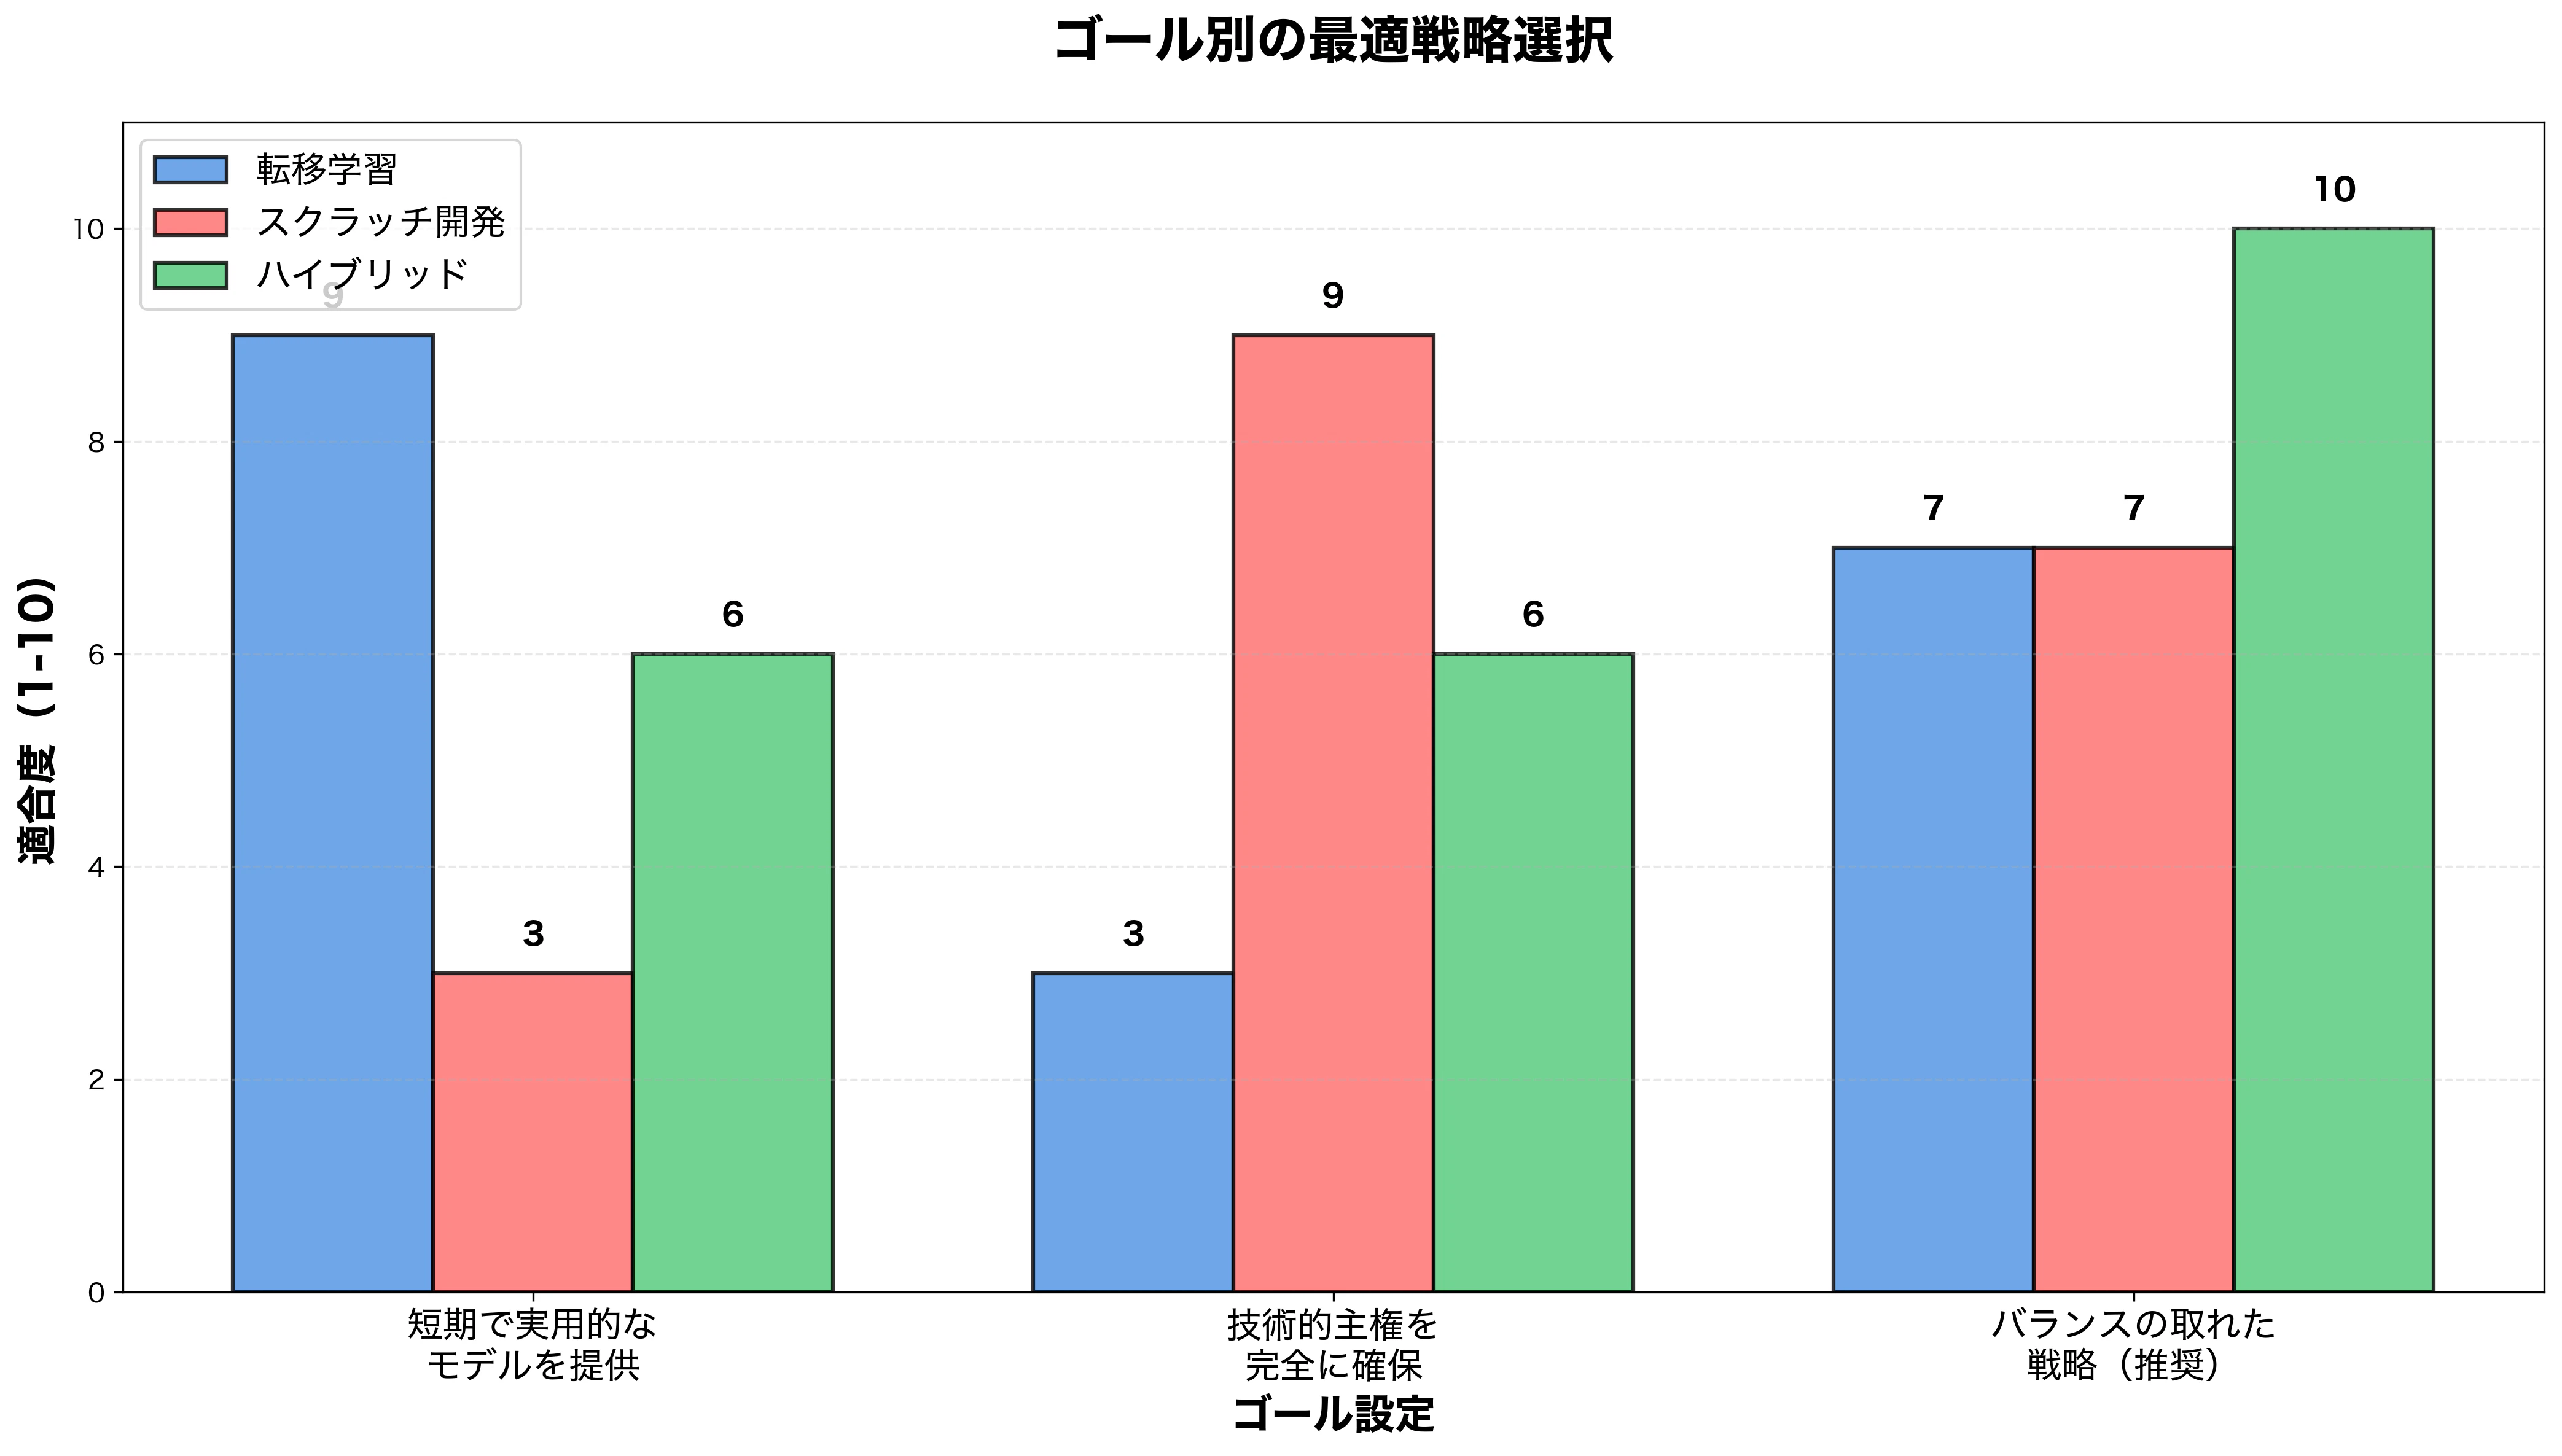
図5:ゴール別の最適戦略選択。各ゴールに対する各アプローチの適合度を1-10のスコアで評価したもの。評価基準は以下の通り:短期実用性重視の場合、転移学習は迅速な成果創出とコスト効率の観点から高評価(9点)、スクラッチ開発は開発期間とコストの観点から低評価(3点)、ハイブリッドはバランス型として中評価(6点)。技術的主権確保重視の場合、スクラッチ開発は完全な制御と主権確保の観点から高評価(9点)、転移学習はベースモデル依存の観点から低評価(3点)、ハイブリッドは部分的制御として中評価(6点)。バランス重視の場合、ハイブリッドは短期と長期の両立の観点から最高評価(10点)、転移学習とスクラッチ開発はそれぞれ一つの側面に偏るため中評価(7点)。出典:SmartDev社「Transfer Learning vs Training from Scratch Cost Analysis」、Ptolemay社「LLM Total Cost of Ownership 2025: Build vs Buy Math」、経済産業省「ソブリンAI戦略」目的分析
結論:技術的には複数の選択肢がある
日本のソブリンAI戦略では「1兆パラメータの大規模モデルを開発する」とされているが、具体的な開発方法(転移学習かスクラッチ開発か)については明記されていない。これは、戦略的な柔軟性を保つための意図的な設計である可能性が高い。
技術的には、転移学習、スクラッチ開発、DeepSeekのような効率的アプローチ、日本語特化など、それぞれにメリットとデメリットがある。重要なのは、何を重視するか(ゴール設定)である。短期の実用性を重視するなら、転移学習が効率的である。完全な主権確保を重視するなら、スクラッチ開発が必要である。バランスを重視するなら、ハイブリッドアプローチが最適である。
日本のソブリンAI戦略は、国家としての主権確保という戦略的目標を重視しているが、同時に実用性と効率性も求められている。したがって、長期的には完全なスクラッチ開発を目指しつつも、短期的な成果創出のためには、転移学習や効率的なアプローチも並行して進めることが現実的である。
実際、国立情報学研究所のLLM-jpプロジェクトや、NRIの転移学習による日本語特化モデルなど、日本国内でも複数のアプローチが並行して進められている。これは、単一の正解ではなく、複数の選択肢を戦略的に組み合わせることが、最適解となることを示している。
最終的には、政府の戦略が「ゼロから作る」ことを前提としているわけではないことを理解し、転移学習とスクラッチ開発の両方の可能性を検討しながら、最適な開発アプローチを選択することが重要である。
参考資料
関連記事
- 1兆円投資!日本が挑む「ソブリンAI」戦略の全貌 - 日本のソブリンAI戦略の概要と背景を解説した記事
技術論文・研究報告
- GreenTrainer論文「Towards Green AI in Fine-tuning Large Language Models via Adaptive Backpropagation」 - 転移学習によるFLOPs削減の実証研究
- ACM「Making AI Less 'Thirsty'」 - GPT-3のスクラッチ訓練における電力消費分析(約1,287 MWh)
コスト分析報告
- SmartDev社「Transfer Learning vs Training from Scratch Cost Analysis」 - 転移学習とスクラッチ開発のコスト比較分析(2025年)
- Ptolemay社「LLM Total Cost of Ownership 2025: Build vs Buy Math」 - LLM開発の総所有コスト分析
データセット・ベンチマーク
- Common Crawlデータセット - 全世界のウェブデータの言語分布分析
- C4データセット - 多言語テキストデータセット
- The Pileデータセット - 大規模言語モデル学習用データセット
- JGLUEベンチマーク - 日本語理解タスクの評価指標
- JSQuADベンチマーク - 日本語質問応答タスクの評価指標
- JCommonsenseQAベンチマーク - 日本語常識推論タスクの評価指標
多言語モデルの日本語性能に関する研究(最新データ)
- Sciety「GPT-4oの医師国家試験(JNMLE)成績」 - 2024年の医師国家試験におけるGPT-4oの正答率約89.2%。GPT-4、Gemini 1.5 Pro、Claude 3 Opusも臨床問題で80%前後を達成
- BMC Medical Education「日本外科専門医試験における多言語モデルの成績」 - Claude 3.5 Sonnetが画像ありの問題で84.69%、GPT-4 Omniが79.59%の正答率
- PMC「GPT-4の日本語と英語での放射線科専門医試験成績の比較」 - 日本の放射線科専門医試験問題(2020-2022年)におけるGPT-4の言語別正答率比較。日本語70点、英語89点(約79%の相対精度)
- PubMed「日本の看護師国家試験におけるGPT-4の成績」 - 第112回日本の看護師国家試験におけるGPT-4の正答率約79.7%(GPT-3.5は59.9%)
- Springer「日本の放射線科専門医試験問題に対するGPT-4の言語別回答精度」 - 日本語、英語、中国語、ドイツ語での比較研究。MMLUベンチマークではGPT-4の英語85.5%、日本語訳題79.9%(約93-94%の相対精度)
日本語特化と知識のトレードオフに関する研究
- arXiv「Why We Build Local LLMs」 - 日本語データでの学習による性能向上と、多言語能力の保持に関する研究
- arXiv「Catastrophic Forgetting in Multilingual Models」 - 多言語モデルへの追加学習における壊滅的忘却の研究。パラメータ制限型の調整やソース言語データの混在による緩和手法
- arXiv「The Curse of Multilinguality」 - 多言語学習における言語間のトレードオフに関する研究(Tyler A. Changら)
- arXiv「Building a Large Japanese Web Corpus」 - 日本語コーパスの拡大による性能改善の実証研究
- LLM-jp「LLM-jp-13B v2.0」 - 日本語と英語を中心に構築されたモデル。総トークン数約2,600億(日本語約1,300億、英語約1,200億)のバランス型設計
日本の実装事例
- 国立情報学研究所「LLM-jp-172B」 - フルスクラッチ開発による日本語特化モデル
- NRI「日本語性能の高い8Bモデル」 - 転移学習による日本語特化モデル
- ソフトバンク「1兆パラメータLLM計画」 - 大規模国産LLM開発計画
その他
- DeepSeek AI公式サイト - 効率的なアプローチによるLLM開発事例
- 経済産業省「ソブリンAI戦略」 - 日本の国家戦略に関する公式情報
執筆日: 2026年1月17日
最終更新: 2026年1月17日