
文章は自然なのに、中身は矛盾している
たとえば、設計レビューに、こんな文書が回ってきたとします。
「このシステムでは、すべての顧客情報を暗号化して保存する。検索を速くするため、検索対象の情報は暗号化せずに保存する。」
どちらも、日本語としては読めます。並べると、同じデータを暗号化し、かつ暗号化しない、という矛盾です。存在しない仕様や、古い版のAPIを根拠にするずれも起きます。
生成AIで設計書や手順を書く速度は上がりました。自然な文章であることと、内容が正しいことは、別の問題です。
この記事の問いは2つです。AIに何を作らせるか。作ったものの正しさを、どう保証するか。扱うのは、後者です。
材料は、2026年10月14日にGoogle Researchが公開したResearch@ 2026: 10 ways we're amplifying human ingenuityです。書き手は、Googleの副社長でGoogle ResearchのゼネラルマネージャーであるYossi Matiasです。場所はマウンテンビューです。発表から、動くソフトウェア、文書の検証、複数AIの連携、現実のデータの予測を取り上げ、システム開発のどこが変わるかを整理します。医療向けモデルや、ウェアラブル向けの省電力チップは、今回は扱いません。
別々の研究に、共通する変化がある
発表から、開発に近いものを6つに分けます。
Learning Interactivesは、教師の学習目標から操作できる教材を作り、Deep Reviewは論文や契約、財務文書の論理と根拠を確認します。Multi-agent Orchestratorは、既存の研究手法を再現し、別の課題へ適用する支援です。Google Earth AIは地理情報や衛星画像などを組み合わせてリスクの分析や予測につなぎ、Groundsourceはニュースなどの文章から学習データを作ります。Play with Puttyは、自然言語と共同編集で複数人が画面を試作する実験です。
対象も、公開の段階も違います。開発の工程に当てはめると、共通点があります。これらの研究は、文章を返すだけで終わっていません。操作できる仕組みを作り、その仕組みを実行して確認し、現実の判断に使おうとしています。
モデルの性能だけでは、この変化は説明できません。画面が動いたことと、業務の規則に合っていることを、同じ成功にしてしまうと、確認が抜けます。
この共通点を、画面、文書、複数のAI、予測データ、試作品の順に見ます。
動く画面を作り、実行して直す
少し前の頼み方は、こうでした。三角関数の教材なら、「角度を変えると、単位円上の点が動き、正弦のグラフが変わる」と開発者に伝えます。開発者の仕事は、画面設計と、JavaScriptなどによる実装です。生成AIのあとでもコードは書けますが、実行し、不具合を直し、操作を調整する作業は、人がやっていました。
Generative UI(生成的ユーザーインターフェース)は、自然言語の要求から、その場で操作できる画面を作る研究です。その前に公開された実装は、2025年11月18日のGenerative UI: A rich, custom, visual interactive user experience for any promptと、論文Generative UI: LLMs are Effective UI Generatorsにあります。実装は、Gemini 3 Proに3つを足したものです。画像生成や検索などのツール、目的や書式や失敗しやすい点を書いた詳細な指示、よくある不具合を直す後処理、の3つです。
選ばれやすいことと、内容が正しいことは別です。生成速度を除いた人手の比較では、標準的な文章やMarkdownより選ばれやすい、とブログは説明しています。論文のLMArena向け対比較では、Markdownに対して82.8%がGenerative UIを選んでいます。これは好みの割合です。選好の順位では、人の専門家が作ったサイトが上で、Generative UIはそれに次ぎます。論文が示す、専門家と少なくとも同等だった割合は50%です。生成に1分以上かかることと、出力が不正確になることは、同じブログが今後の課題として書いています。
教材では、目標、課題、ヒントまで生成する
教育向けの実験は、2026年9月17日のThe future of practice: Enabling teachers to create learning interactives with generative UIです。Research@ 2026では、この取り組みが10件の1つとして紹介されています。
教師が題材を出すと、学習目標の案が出ます。直して承認するのは、教師です。成果物には、段階的に難しくなる課題、ヒント、フィードバック、解説、公式の道具箱まで含まれます。公開ライブラリは、教師が確認した30件超の英語教材です。中学・高校の理科と数学が中心で、含まれる科目は生物、化学、コンピュータサイエンス、地球科学、数学、物理です。新しい教材がライブラリに入るのは、依頼した教師の確認と承認のあとだけです。学校向けパイロットの案内は、上の技術解説にあります。
正しさは、Chromeで操作して見る
この実験では、生成は1回で終わりません。自動の評価が見るのは、教育上の条件(各段階が学習目標を含み、難しくなっていくか)、操作(ボタンは動くか、その段階は解けるか)、見た目(操作の邪魔になる部品がないか)です。解けるかどうかは、Chromeを開いて利用者のように操作し、つまみを極端な値まで動かして確認します。条件を満たすまで、生成、実行、評価、修正を繰り返すので、完成までの時間はその分伸びます。
コードをファイルに書いて終わる生成とは、手順が違います。動く環境で実行し、失敗を戻し、直す手順が、生成の過程に含まれます。
この手順を通った教材を、教師がどう評価したかも発表されています。米国の教師12人が、それぞれ3種類の専用教材を依頼し、品質を10点満点で評価した初期調査では、平均は8点でした。これは教材の出来に対する教師の評価です。生徒の学力が上がった数字ではありません。英国のSTEM教師による40件の評価では、総合は良いまたは優秀で、物理と化学がシミュレーションに向きやすい、とブログは説明しています。詳しい結果は、技術報告にあります。教室での学習効果と、生徒がどの程度取り組んだかは、これから調べるとGoogleは書いています。8点を導入の根拠にする前に、その点数が何を測ったかを見ます。
教育の実験を、業務の画面に置き換えると、営業担当者が「今月、売上が落ちている顧客と、その原因を見たい」と頼む場面が考えられます。チャットが文章で説明するのに対し、Generative UIが目指すのは、条件を変えて比べられる操作画面です。ただし、この実験は、あらゆる業務画面を安全に自動生成できる証拠にはなりません。顧客データへの権限と、売上計算の正しさは、画面が作れることとは別です。
文書は増えても、人が確認できる件数は増えていない
画面の次は、文書の確認です。Deep Reviewは、2026年10月14日のAnalyzing technical documents with Deep Reviewで一般公開されました。複雑な文書の論理的な整合、事実の根拠、記述の明確さを確認する、エージェント型の仕組みです。論文の下書き支援として始まったPaper Assistant Tool(PAT)の後継です。
なぜこの仕組みが要るかは、確認する件数に出ています。AIの学会だけを見ても、件数は増えています。ICLR、NeurIPS、ICMLの3学会への投稿は、2023年が約23,000件、2024年が約32,000件、2025年が約45,000件、2026年が74,000件超です。数字は同ブログの説明です。2023年から2025年は概数です。図の2026年は、74,000として描いています。
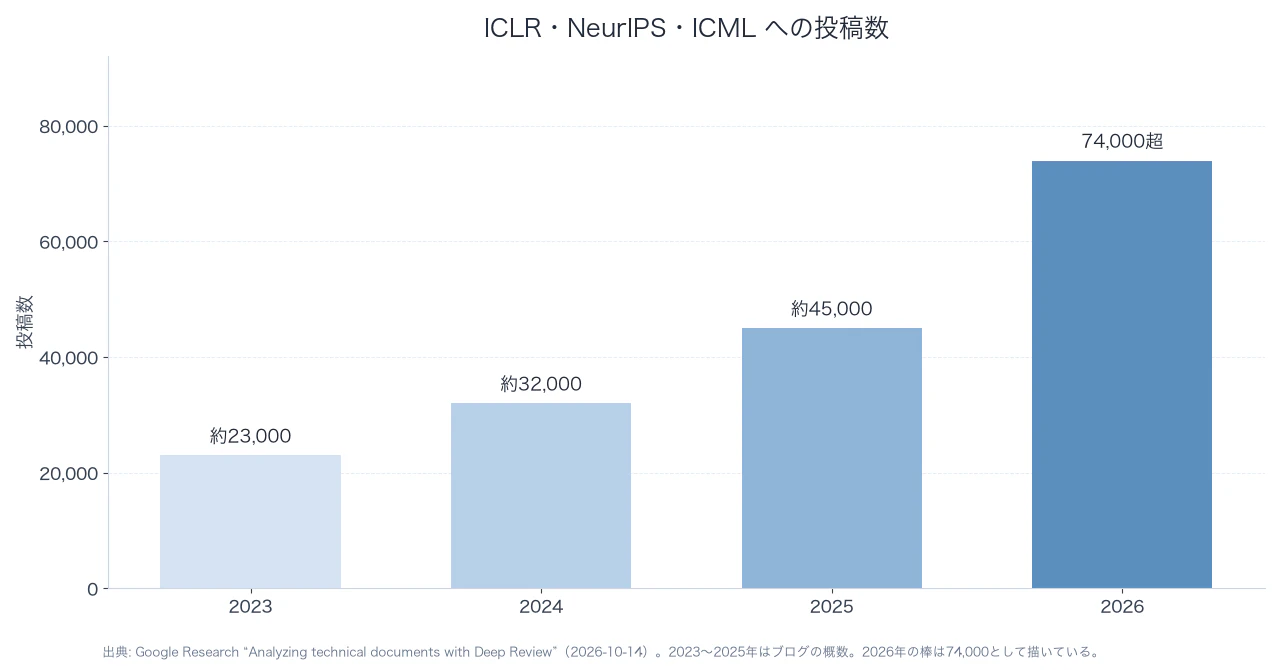
投稿が増えたことと、査読の質が保たれたことは、同じではありません。ブログが問題にしているのは、文書を作る速度に対して、人が厳密に読める件数がほとんど増えていないことです。
16,000件は、検出の精度ではない
PATは、STOC 2026、ICML 2026、NeurIPS 2026、ICLR 2027で、著者が希望した場合に、投稿前のフィードバックを返しました。対象は16,000件超の原稿です。公式の査読とは切り離され、学習には使わず、各プログラムの終了後に原稿は削除された、とあります。
16,000件は、使われた規模です。 誤りをどの程度の精度で見つけたかを示す数字ではありません。規模を精度のように読むと、導入の判断を誤ります。
件数とは別に、業務で使うときの条件も発表されています。公開版の入力は、PDFとプレーンテキストです。追加料金なしの確認は週2件で、量が多い作業はGemini APIキーを接続してAPIから呼び出せます。アップロードした文書は、モデルの学習や微調整には使わない、と説明されています。画面に再表示するため、保存期間は1年です。対象は設計書、プレゼン、契約、財務文書にも広がっています。複数ファイルを横断する確認は、これからです。Gemini 4 Argonへの対応で、PATの頃より確認の能力が上がった、とも書かれています。
社外の確認サービスへ設計書を出す前に、保存期間と、学習に使わないことを、契約と社内規則で見ます。
文書を節に分け、並列に確認する
長い文書を1回のプロンプトで採点すると、推論の枠を使い切り、離れた節の依存を見落とし、微妙な主張をそのまま通す、とブログは説明しています。Deep Reviewは4段です。
第1段では、セグメント担当のエージェントが、文書を重なりのある節のまとまりに分けます。文書の全体が、いずれかのまとまりに入ります。第2段では、情報の密度を見て計算量を割り当て、証明が密集した節は序論より多くの計算を受け取ります。第3段は、専門の推論エージェントによる節の並列確認です。各エージェントは全文を参照できますが、推論は担当節に集中させます。第4段の統合担当は、節ごとの報告をまとめ、節のあいだの矛盾を再確認し、外部の根拠をツールで調べます。存在しない引用や、誤った根拠を、外部の資料で止める工程です。
この4段に近い型は、開発ツールにも出ています。Antigravityでは、/teamwork-preview で文書レビューの型を呼べます。これは製品の操作名です。現場の設計そのものではありません。
開発に置き換えると、次の分担が考えられます。要件から設計書を作る処理。設計書と要件のずれを見る処理。設計から実装を出す処理。仕様と実装の差をテストで見る処理。最後に人が、指摘の採否を決めます。
作る側と確認する側を分けても、同じモデルが同じ誤解を共有していれば、独立した確認にはなりません。金額、権限、在庫のように、誤ると業務が壊れる処理は、形式的な仕様、テストデータ、実行結果、別の情報源を組み合わせます。出力の正しさを、スキーマやテストで機械的に見る原則は、「LLMに任せきり」が危ない理由——数学が示す限界と、設計で補う3つの原則で整理しています。この記事で特に書きたいのは、確認役を、作ったのと同じモデルの自己点検にしない、という点です。
人がすべての行を読む時間は、短くできる可能性があります。冒頭の設計書なら、その時間で決めるのは、矛盾をどう解消するかです。暗号化を優先するのか、検索速度を優先するのか。期限を延ばすのか、機能を狭めるのか。これは、技術的にどちらが書けるかだけでは決まりません。
最初の誤りが、後の工程に広がる
前の節では、作る処理と確認する処理を分けました。分けたあとも、前のAIの誤りが次のAIの前提になると、あとの処理が正しくても結論は誤ります。
Research@ 2026のMulti-agent Orchestratorは、この受け渡しを科学向けに作った仕組みです。既存の手法を再現し、別の設定へ適用する支援として紹介されています。例は、流体力学の逆設計を尿道カテーテルの設計へ適用し、シミュレーション上では細菌感染を抑えやすい形が得られた、というものです。患者での臨床効果を確認した、という意味ではありません。同じ発表には、コードの変種を数千並列で試すEmpirical Research Assistanceと、仮説を作るCo-Scientistもあります。ここでは、手法を再現して別の課題へ渡すオーケストレーターに絞ります。
企業の問い合わせ改善に置き換えてみます。履歴の分析、問題の分類、現行フローの確認、改善案、費用、テスト。役割の違うエージェントに分け、順番と依存を管理する構成は考えられます。そのオーケストレーターが、企業向け製品として公開された、という話ではありません。
設計で先に書くのは、受け渡す情報の形式、終了条件、失敗時の処理、実行してよい権限です。分析担当の誤った分類が、設計担当の前提になると、あとの工程は正しく動いても、全体の結論は誤ります。
問い合わせ履歴の分析から、業務システムの設定変更までを、人の確認なしに通す場合を考えてみます。各ステップの出力はそれらしいのに、会社の方針と違う変更が実施されることがあります。実行前の承認だけでは、途中で方針から外れた変更は止まりません。権限の上限、実行履歴、異常時の停止、戻し方が要ります。
処理内容が固定のワークフローと違い、エージェントは次の一手を事前に全部は書けません。先に書くべきなのは、実行時に止める条件です。モデルの外側に制約を置く考え方は、ハーネスエンジニアリングとは?——AIエージェントを「手綱」で導く設計思想にあります。動いているエージェントを止めずに制御する循環は、エージェンティックAI時代のセキュリティは防御から統制へ——「動くAI」を止めずに制御する設計へで扱っています。この記事では、研究の再現支援という発表を、受け渡す情報と停止条件の設計として説明します。何を自動化できるかと同時に決めるのは、どこまで自動化してよいかです。
予測は、入力データの品質で評価する
ここまでは、作った画面と文書、そしてAI同士の受け渡しでした。次は、予測に使うデータです。
物流や防災や出店は、場所、時刻、人口、天候、道路を同時に扱います。Google Earth AIは、地理空間のデータを扱う技術群です。今回の発表は、早期アクセスの実験的な機能が3つです。Google Earth上での詳しい地理分析、リスク評価とシナリオの予測エンジン、自社の処理へ組み込む実験的なエージェント間APIです。APIからは、衛星画像の解析、経路、人口統計の埋め込みなどを呼び出せます。
あわせて発表されたのは、公開データセットを1億件超から探すGoogle Dataset Searchと、時系列の現況推定と予測に使うTimesFMの連携です。使っているのは、70種類以上の地理空間ツールです。衛星画像のRemote Sensing Foundation Modelと、人口動態のPopulation Dynamics Foundation Modelを含みます。精度の検証は、同日のEarth AI Technical Reportに書いてある、とブログは説明しています。ブログ本文にない精度の数値は、この記事では使いません。
防災だけが対象ではありません。配送なら天候、道路、拠点、需要です。出店なら人口、交通、周辺施設、需要です。いずれも、過去の傾向を学習したモデルが、将来の社会の変化に合うとは限りません。
だから、予測を見た目の地図のまま経営判断にはしません。地域や対象で、精度は違いえます。入力の更新頻度、偏り、不確実性、その予測で何を決めるかを、セットで見ます。
ニュースを、学習できる表にする
洪水の予測は、データの出どころが具体的です。河川の洪水については、Natureで発表された全球の水文モデルが、影響の大きい河川洪水について、150か国超、20億人超に、最大7日前の予報を出している、とResearch@ 2026は説明しています。2026年10月の同じブログは、わずか1年前には、都市の急な洪水の予測は難しかった、と書いています。場所と時刻が揃った過去記録が不足していたためです。
Introducing Groundsource: Turning news reports into data with Gemini(2026年3月12日)は、Geminiでニュースを構造化する手法です。洪水を主に扱った記事を集め、Google Read Aloudのユーザーエージェントで80言語の本文を取り、Cloud Translation APIで英語に揃えます。Geminiの仕事は、実際の洪水の記事と、予報や政策の記事を分けることです。時刻は記事の日付を基準に「先週の火曜」のような相対表現を解消し、地区や通りはGoogle Maps Platformの領域へ対応させます。
できたデータセットは、150か国超、2000年以降の洪水イベント260万件超です。公開データはZenodoのGroundsourceにあります。人手の確認では、場所と時刻の両方が正確だったのは60%です。実務に使える精度(正しい行政区域、またはピークから1日以内)は82%でした。2020年から2026年にGDACSへ記録された深刻な洪水の85%から100%を、時空間の照合で捉えています。GDACSは、災害の国際的な警報の仕組みです。ニュースにない洪水は、データに入りません。メディアが報じていない洪水を誤検知と数えると、精度は実際より低く出ます。この点は、Protecting cities with AI-driven flash flood forecastingでも説明されています。
このデータで、都市部の急な洪水の可能性を、最大24時間前に出すモデルにつなげています。生成AIを、予測モデルそのものにはしていません。予測モデルを作るための、学習データの整備に使っています。
社内にも、同じ形の文章があります。障害報告、問い合わせ、保守記録、議事録です。発生日時、対象、原因、影響、復旧時間を抜き、表にすると、傾向や予防保守の材料になります。抜き出しには誤りと抜けがあります。短時間で大量に作れるほど、入れる前の検査が要ります。
次のコードは、抽出結果を分析に載せる前の、最低限の検査です。LLMは呼びません。事実が正しいことまでは見ていません。欠け、重複、出典の有無だけを落とします。
REQUIRED = ("occurred_at", "target", "cause", "source_url")


def accept_for_analysis(records: list[dict]) -> tuple[list[dict], list[str]]:
    """抽出JSONを分析に載せる前の検査。モデルの自己評価は見ない。"""
    accepted: list[dict] = []
    rejected: list[str] = []
    seen: set[tuple[str, str, str]] = set()
    for index, row in enumerate(records):
        missing = [key for key in REQUIRED if not row.get(key)]
        if missing:
            rejected.append(f"{index}: missing {', '.join(missing)}")
            continue
        key = (row["occurred_at"], row["target"], row["source_url"])
        if key in seen:
            rejected.append(f"{index}: duplicate")
            continue
        seen.add(key)
        accepted.append(row)
    return accepted, rejected
前提は、Python 3.11以降、ネットワークなし、各要素が辞書であることです。source_url を必須にすると、あとから原文へ戻れます。落ちた行は捨てず、rejected を標本として人が見ます。60%と82%の差が示しているのは、この検査のあとにも、その用途に十分かを人が定義する必要がある、ということです。
文章のモデルと、数値のモデルを混ぜない
上で地理の予測に使ったTimesFMは、時系列専用のモデルでもあります。同じResearch@ 2026は、表形式のTabFMも発表しています。言語モデルは文章に強いです。業務の判断は、数値にも依存します。TimesFMもTabFMも、利用者が追加で学習しなくても予測でき、それぞれの公開ベンチマークで上位だ、と説明されています。ベンチマークの名前は、確認したブログ本文には列挙されていません。Cloud BigQueryの利用者は、いま使えます。Gemini for businessへの組み込みは、これからだと発表されています。組み込み後は、販売や病床のように、組織の境界の中にデータを置いたまま、大量の行から傾向を見る、という使い方です。すべての業務チャットから、すでに呼べる状態として発表されたわけではありません。
システム設計に置き換えると、分け方は単純です。文章の理解は言語モデル、需要の予測は時系列モデル、画像は画像の基盤モデルを使います。全部を1つのLLMに通す必要はありません。Earth AIがTimesFMを地理の予測に使い、Groundsourceが言語モデルをデータ整備に限っているのは、この分け方の例です。
複数人で作る試作品は、本番に出せる状態ではない
画面や予測の次は、複数人で試作品を作る実験です。生成AIのプログラミング支援は、個人の速度から始まりました。開発は、利用部門、設計、実装、テストが揃わないと終わりません。
Play with Puttyは、自然言語で画面を作り、要素を選んで指示し、複数人で同時に編集する研究実験です。変更の履歴もたどれます。Googleは研究者向けの試作から始め、Google Earth AIの可視化などにも使った、とResearch@ 2026で説明しています。Google Labsではウェイトリストを開いています。
利用部門が「顧客ごとの過去3年の売上も見たい」と言うと、その場で画面が変わります。触ったあとで、「売上だけでは原因が分からない。問い合わせ件数も並べたい」と気づく、という進み方です。仕様書を閉じてから開発するのではなく、動く試作品で要件を見つけます。
試作品の見た目が完成に近いほど、本番に出せると誤解されやすいです。セキュリティ、性能、可用性、保守、監査は、試作の手順に入っていないことがあります。試作を速くするのは、品質の確認を省くためではありません。早い段階で、要件の食い違いに気づくためです。試作品と本番を分ける条件は、画面の完成度ではありません。権限、データ、停止、記録が入っているかです。
工程をつないでも、目的は途中で見直す
上の研究を、開発の工程に並べると、次のように読めます。これは、1つの統合開発環境が完成した、という意味ではありません。個々の研究から読める、工程ごとの変化です。
| 工程 | これまでの進め方 | 発表から読める変化 |
|---|---|---|
| 要件 | ヒアリングして文書にする | 動く試作品で要件を探す |
| 画面 | 設計者がUIを作る | 自然言語からUIを生成し、実行して直す |
| 実装 | 開発者がコードを書く | 生成と修正の支援を使う |
| テスト | 人がケースを作って確認する | 操作による確認や、別の系統の確認を加える |
| レビュー | 人が文書とコードを読む | 論理と根拠の一次確認をAIが担う |
| データ | 人手や専用処理で整える | 文章から項目を抜き、検査で落とす |
| 予測 | 個別のモデルを作る | 用途別のモデルとデータをつなぐ |
| 運用 | 決まった手順を実行する | 権限と停止を付けた作業の支援 |
ここで分かるのは、要件から試作品、試作品から設計、設計から実装、実装から検証へ、情報を渡しながら確認する形です。従来は、工程から次の工程へ渡すときに、意味が変わることがありました。その引き継ぎで確認すれば、意味の違いは減る可能性があります。
逆の問題もあります。誤った目的をそのまま実装すると、工程がつながっているほど、誤った目的のまま設計や実装まで速く進みます。先に決めるのは、最初の目的と、途中で目的を見直すタイミングです。
人が決めるのは、目的、止め方、採否
プログラミングやレビューの一部が、AIで短くなる可能性は高いです。そのとき、「AIにできない作業を人が担当する」と固定すると、AIの能力が変わったときに分け方が使えなくなります。要件の整理や改善案も、入力が揃えば、AIがかなりのところまで出せるようになるからです。今できることとできないことで役割を固定するより、システムの目的、品質、リスクを評価できる状態を作る方が、能力が変わっても同じ確認を続けられます。
集計の数字と、現場で起きていることを突き合わせる
AIは、与えられた目的への案を出せます。問い合わせ対応が長い、という集計から、時間を短くするシステムを提案するかもしれません。現場では、複雑な相談に時間をかけているだけ、ということがあります。時間だけを目標にすると、顧客の満足は下がります。
記録にない事実や、担当者がまだ説明していない不満がある前提で、調査の仕方を設計します。AIに現場の文章を渡すことと、何を観測するかを決めることは、別の作業です。
目視だけを、確認の最終手段にしない
エージェントが増えると、すべての処理を人が見るのは現実的でありません。金額の上限、重要な変更の追加承認、ログ、異常時の停止、戻し。従来の設計でも必要だったものが、実行内容が事前に固定されない分、実行のときに必要です。
Deep Reviewの4段も、Learning InteractivesのChromeでの操作も、人のレビューをなくす仕組みではありません。機械で見つけられる失敗を先に落とし、人は採用するかと、どう直すかを決めます。
作れることと、やる価値を分ける
完全に自動化できても、費用に対して業務量が小さければ、投資としては合いません。技術的には小さい変更でも、現場の負担が大きく減ることがあります。実現できる案の一覧と、事業上やる理由は、別にした方が判断しやすいです。
基礎の上に、確認の設計を学ぶ
プログラム、ネットワーク、データベース、セキュリティは、生成結果を疑うために要ります。その上で、理解を深めたいのは次の5つです。言語モデル、ツール、データ、API、エージェント、画面を、保守できる形に組むこと。出力が毎回同じでないシステムを、期待する振る舞い、異常入力、継続監視で評価すること。非構造化データから項目を抜き、出典と抜けを管理すること。権限、停止、復旧を先に書くこと。利用者の作業を見て、頼まれた機能の原因になっている課題を特定すること。
実装が易しくなるほど、何を作るかを決める作業が重要になります。
研究の発表を、本番の完成度として読まない
ここまでの注意を、研究ごとに置きます。Learning Interactivesは、教育向けの実験です。教師12人の8点は、学習効果ではありません。Deep Reviewの16,000件は、精度ではありません。Earth AIの予測は、地域と対象で違いえます。エージェントの自動化では、セキュリティ、誰が結果を説明するか、誤動作のあとの対応を、別に設計します。
開発も判断も、AIが自動でできるようになった、と理解するのは、発表の範囲を超えます。適用が広がるほど、先に決めるのは、品質と統制をシステム側にどう置くかです。
試す範囲は、大きい刷新でなくてよいです。今月、AIに作らせた設計書か画面を1つ選び、使う前に3行だけ書きます。何をもって正しいとするか。触ってよいデータと権限はどこまでか。失敗したとき、誰が止め、どこに記録するか。
この3行が書けない成果物は、まだ本番の候補ではありません。3行が書けてから、生成を速くすればよいです。
作成日: 2026-10-23