
📚 参考書籍
※この記事は書籍の一部をベースに再構成しています。もう少し踏み込んだ内容(設計や具体例)は書籍の中でまとめているので、気になる方はそちらもどうぞ。
####『ゼロから触ってわかった!AI Agent Observability入門― MLflow・Databricksで実践するAIエージェントの評価・監視・安全性・説明可能性』
本書は、AI Agentを「作って動かす」だけでなく、その品質をどう観測し、どう評価し、どう守り、どう説明可能にするかを体系的に学ぶための入門書です。
https://link.amazon/B04VaTlR3
📚 その他参考書籍一覧
※全書籍・全ブログ・週刊Databricksリリース情報
https://modern-tech-hub.mellow-launc-5442.chatgpt.site/books
⚡AI Agent Observability入門⚡ Trace・Log・Metric・Eventの違いとは?4つの監視情報の役割と使い分け~ Trace・Log・Metric・Eventの違い
ここまでの小節では、MLflow Tracingを使って、Agent全体の実行やRetriever、LLM、Tool CallをTraceとSpanとして記録する方法を見てきました。
ただし、AI Agent Observabilityで扱う情報はTraceだけではありません。実際の運用では、Log、Metric、Eventといった情報も組み合わせて利用します。
これらは似たような情報に見えますが、役割が異なります。重要なのは、すべてをTraceへ集約することではなく、何を知りたいかに応じて適切な情報形式を使い分けることです。
Traceは一連の処理経路を把握するための情報
Traceは、1回のAgent実行がどのような処理経路をたどったかを把握するための情報です。
たとえば、次のような処理を一続きで確認できます。
User Question
    ↓
Retriever
    ↓
LLM
    ↓
Tool Call
    ↓
Final Answer
さらに、それぞれをSpanとして記録することで、どの処理にどれだけ時間がかかったか、どのInputとOutputがあったか、どこでErrorが発生したかを確認できます。
Traceは特に、**「この1回のAgent実行で何が起きたのか」**を調査する際に有効です。
Logは個別の処理や出来事を記録する
Logは、アプリケーションやシステムで発生した処理内容を記録するための情報です。
たとえば、次のような内容があります。
INFO  Agent started
INFO  Retriever returned 5 documents
WARN  Tool response was empty
ERROR External API timeout
Traceが一連の処理構造を表すのに対し、Logは特定の時点で発生した出来事を詳細に残す用途に向いています。
たとえば、Tool内部で発生した細かな処理や、Retry理由、外部APIのError MessageなどはLogとして保持した方が扱いやすい場合があります。
Metricは状態を数値として継続観測する
Metricは、システムの状態や品質を数値として継続的に観測するための情報です。
AI Agentでは、次のようなMetricが考えられます。
- Latency
- Error Rate
- Token Usage
- Cost
- Tool Call回数
- Task Success Rate
- Guardrail Pass Rate
たとえば、1つのTraceを見れば「この実行は8秒かかった」と分かります。
一方、Metricとして集計すれば、
平均Latency: 3.2秒
P95 Latency: 7.8秒
Error Rate: 1.4%
のように、システム全体の傾向を把握できます。
つまり、Traceが個別調査に向いているのに対し、Metricは品質劣化や性能劣化の傾向を継続的に検知する用途に向いています。
Eventは重要な出来事を表す
Eventは、特定の重要な出来事が発生したことを表す情報です。
たとえば、AI Agentでは次のようなEventが考えられます。
- Guardrail Fail
- Permission Denied
- Prompt Injection検知
- Model切り替え
- Tool実行失敗
- Human Review要求
Logとの境界は実装によって異なる場合がありますが、Eventは「後から集計・検知したい意味のある出来事」として扱うと整理しやすくなります。
たとえば、単なるDebug情報ではなく、「GuardrailによってTool Callが拒否された」という出来事は、Security監視の対象としてEvent化する価値があります。
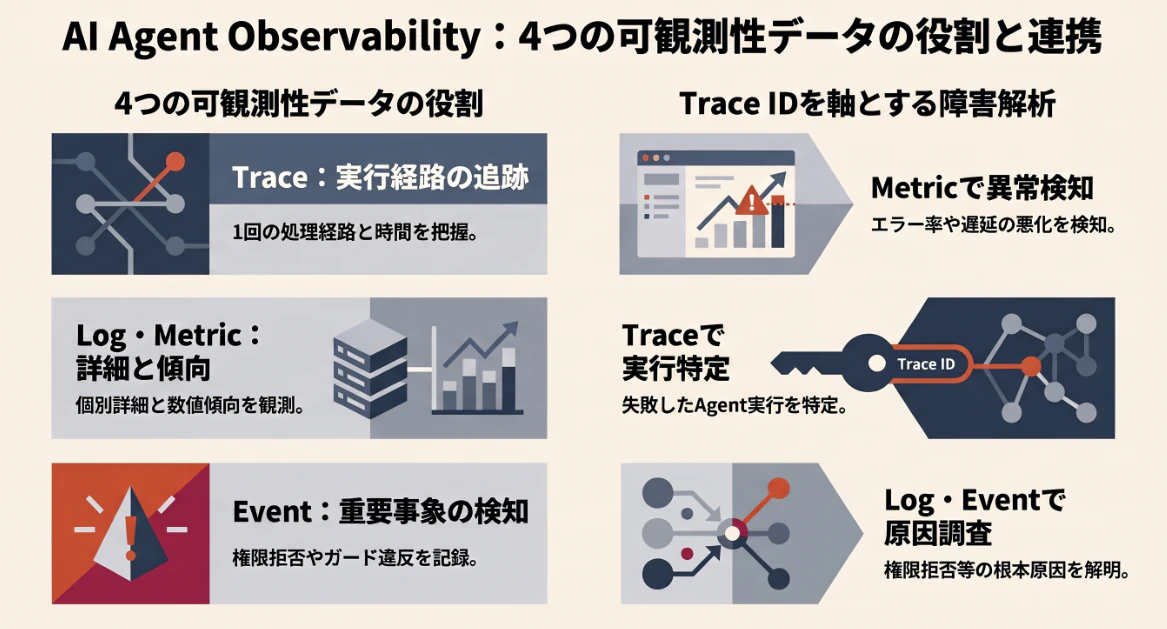
4つの情報は役割が異なる
それぞれの役割をまとめると、次のようになります。
| 種類 | 主な役割 | 代表的な確認内容 |
|---|---|---|
| Trace | 一連の実行経路を追跡する | Agentがどの処理をたどったか |
| Log | 個別処理の詳細を記録する | 何が出力され、どのErrorが発生したか |
| Metric | 数値の傾向を継続監視する | LatencyやError Rateが悪化していないか |
| Event | 重要な出来事を記録する | Guardrail FailやPermission Deniedが起きたか |
これらは競合するものではなく、互いに補完するものです。
Trace IDを軸に関連付ける
実務上重要なのは、Trace、Log、Metric、Eventを完全に別々の情報として扱わないことです。
たとえば、Monitoring DashboardでError Rateの上昇を検知した場合、そのMetricだけでは具体的な原因は分かりません。
そこで、問題が発生した時間帯のTraceを確認し、さらにTraceに関連するLogやEventを見ることで、原因を深掘りできます。
概念的には次のような流れです。
Metric
「Error Rateが上昇」
        ↓
Trace
「どのAgent実行が失敗したか」
        ↓
Span / Log
「どのToolで何が起きたか」
        ↓
Event
「Permission Deniedが発生」
このように、Metricで異常を発見し、Traceで対象実行を特定し、LogやEventで詳細を調査するという使い方ができます。
AI Agent Observabilityでは、Traceだけですべてを解決しようとするのではなく、Trace、Log、Metric、Eventをそれぞれの役割に応じて組み合わせることが重要です。
そして、これらを有効に活用するためには、そもそもTraceに何を残し、何を残さないかを設計する必要があります。
次節では、評価や障害解析に必要な情報と、PIIやSecretなど記録すべきではない情報の境界を整理します。