
スレッドの規格はCLの仕様書に含まれていない
common lispの規格が出来た頃は、まだマルチスレッドが普及する以前だったそうです。
マルチスレッドが普及した時期は 、以下のような経緯をたどっています。
WindowsやUnixなどのマルチスレッドの仕様が固まった時期
マルチスレッドの仕様やAPIがOSの標準として確立したのは、1990年代前半〜中頃です
マルチスレッドが一般的に使われるようになった時期
1990年代後半(言語による普及):OS側がスレッドをサポートしたことに加え、1995年に登場した Java が言語仕様レベルでマルチスレッドを強力にサポートしたため、プログラマの間でマルチ-スレッド・プログラミングが一気に身近なものになりました。
2000年代半ば(ハードウェアのマルチコア化による必須化)
2005年前後からIntelやAMDがマルチコアCPU(デュアルコア、クアッドコア)を一般向け市場に投入し始めました。これにより、PCの性能をフルに引き出すために「マルチスレッド対応」がすべてのソフトウェア開発者にとって必須の技術となった。
スレッド毎にダイナミック変数が別の値を持つ動き
【ダイナミック変数はスレッド毎に別々の値を持ちます】
「ダイナミック変数はスレッド固有のコールスタックに紐付ける(let などのバインディングはスレッド毎に独立させる)」 という挙動を定着させた代表的なLispベンダーおよびプロジェクトは以下の通りです。
| 組織 / 企業 | 代表的な処理系 | 特徴と歴史的背景 |
|---|---|---|
| Symbolics | Genera (ZetaLisp / Common Lisp) | Lispマシン(専用ハードウェア)の最大手。1980年代前半の段階でマルチタスクOSを持ち、ダイナミック変数のスレッドローカルバインディングの基礎的な概念を確立。 |
| Franz Inc. | Allegro Common Lisp (ACL) | Unix/Windows向け商用Common Lispの大手。mp:process-run-function などのマルチプロセスAPIをいち早く実装し、他社への仕様の参考にされた。 |
| Harlequin Group(現 LispWorks Ltd.) | LispWorks | GUIやマルチスレッドに強みを持つ商用ベンダー。他社と類似のマルチプロセス/スレッド API を提供。 |
| Lucid, Inc. | Lucid Common Lisp | 80〜90年代の主要商用ベンダーの一つ。ワークステーション向けにマルチスレッド実装を提供 |
| カーネギーメロン大学 (CMU) | CMUCL | オープンソース処理系。現在の SBCL (Steel Bank Common Lisp) のベースとなり、オープンソース側での標準的な挙動として引き継がれた。 |
CLの仕様書にはありませんが、当時Lispを作っていた代表的なメーカーたちによって、スレッドとダイナミック変数の動作が標準化されました。
なぜ「スレッド毎にバラバラの値を持つ」ようになったのか?
-
ダイナミック変数(Special Variable)の仕組み:
Common Lispにおけるダイナミック変数は、関数呼び出しのスタック枠組みに沿って一時的に値を変更し、抜けると元の値に戻る構造(スタックバインディング)を持っています。 -
スレッドの構造:
マルチスレッドとは「実行スタック(Call Stack)を複数持つ」ことです。 -
自然な合意:スタックがスレッドごとに分かれている以上、let や progv などによる「一時的なバインディング(ローカル値)」は各スレッドのスタックに積み上げられ、スレッドローカルになるのが構造上最も自然であり、安全な挙動でした。
もしこれが全スレッド共通で書き換わってしまうと、別スレッドの処理が途中で壊れてしまい、マルチスレッド環境でのダイナミック変数の存在意義(実行コンテキストの局所的な変更)が失われてしまうためです
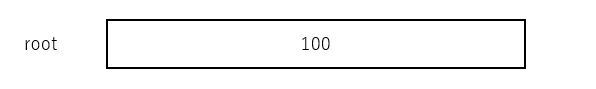
私の理解を図に示します
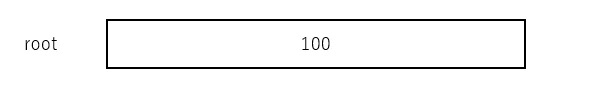
- ダイナミック変数が作られると、最初にrootという値を書き込むスロット(箱)が出来ます。
ここに100という値を入れています。
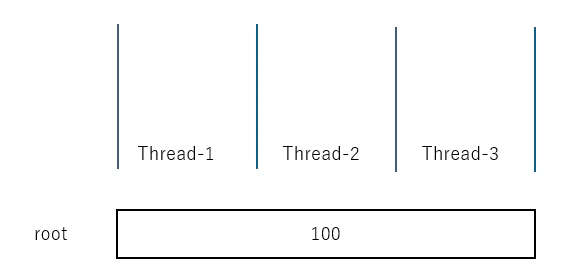
- ここでスレッドが3つ出来たとします。スレッドが出来ただけでは、何も変わりません。
3つのスレッドからダイナミック変数を参照すると、全てrootに入っている100が見えます。
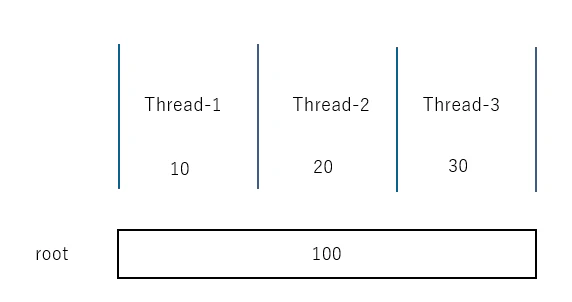
- まず、Thread-1が letやlet*によって、10という値を動的に束縛したとします。
この動的束縛は、スタックのように積みあがっていきます。ですから、一番上に置かれている値が各スレッドから見えるという動作をします。
以下の図の場合、Thread-1は、10という値を参照します。
しかし、Thread-2 と、Thread-3は、まだletやlet*で動的に束縛していない為、rootの値が見えています。(つまり100が見えます)

- Thread-2が20を、Thread-3が30を動的に束縛したとします。
この時、Thread-1からは、10が見える。
Thread-2からは、20が見える。
Thread-3からは、30が見える、という動作になります。
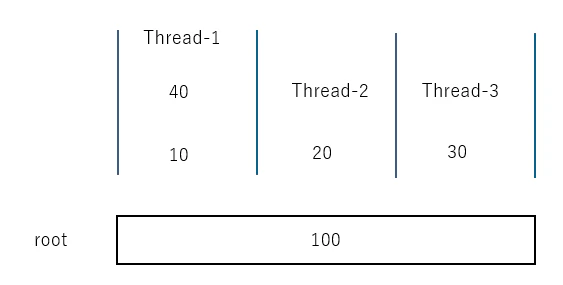
- Thread-1が再度、letやlet*によって、40を動的に束縛したとします。
この時、Thread-1からは、40が見える。
Thread-2からは、20が見える。
Thread-3からは、30が見える、という動作になります。
常にスタックの一番上に積みあがっている値が見える事に着目してください。
- letやlet*のbodyの処理が終わって、抜ける場合には、スタックはpopされていきます。
そして、全ての動的束縛がなくなった時、またrootの値がみえるようになります。
JavaでのOSスレッドでの実装
上に示すような、スレッド毎に値を持つ方法は、ThreadLocalというクラスによって実現されています。
話変わりますが、
C言語での実装方法をAIに聞いたところ、3つあるそうです。
C11規格以降であれば、標準で用意されている _Thread_local
C11以前の古い環境や、GCC、Clangなどをターゲットにする場合は、 __thread 指定子
LinuxなどのPOSIX環境では、pthreadsのAPIを使用
SBCL(common lisp)の実装方法
AIに聞いたところ、教えてくれました。
ちなみに、SBCLはC言語で書かれている訳ではありません。
SBCLは、SBCL自身のコンパイラによって、OSやCPU毎のバイナリー(機械語)を生成するそうです。
最近のC言語では、LLVMをバックエンドに使うケースも多いと聞きますが、SBCLはLLVMの機能もLISPで作っているんですね。
もう凄いとしか言いようがありません。
-
Cランタイム層:
スレッドごとの固有の状態(ダイナミック変数の値や束縛履歴)は、C言語で書かれたランタイム部分で管理されています。
src/runtime/thread.h および src/runtime/threads.c -
Lisp層:
ダイナミック変数として使用されるシンボル側も、スレッドローカルな値を効率的に引けるような管理情報を持っています。
- アーキテクチャ依存のコード生成
src/compiler/ 内の各アーキテクチャディレクトリ
clojureでの実装方法
Java上でのLisp である clojureでは、Varクラスの中で、この動作が実装されています。
非常に簡略化したコードを以下に示します。
package clojure.lang;

public final class Var extends ARef {

    volatile Object root;

    final public Object get(){
    	if(!threadBound.get())
    		return root;
    	return deref();
    }
    final public Object deref(){
    	TBox b = getThreadBinding();
    	if(b != null)
    		return b.val;
    	return root;
    }
}
「私の理解を図に示します」に示した事が、実装されている事がよくわかります。
なお、volatileは、C言語と、Javaで微妙に意味や動作が異なるそうなので、注意してください。
再び clojureのソースに戻ります。
static final ThreadLocal<Frame> dvals = new ThreadLocal<Frame>(){

	protected Frame initialValue(){
		return Frame.TOP;
	}
};
ここが、ThreadLocalを使っている場所なのですが、「なぜstaticを付けているのだろう?」というのが、私の長年の疑問でした。
ThreadLocalは、SpringFrameworkや、JSFなどでも普通使われている技術で、遅いという印象がありません。
普通に考えたら、staticにせず、Varクラスのメンバー変数にすれば良い筈です。
なぜ、clojureはこんな事をしているのか、AIに聞いたところ、理由を教えてくれました。
「どういう状況でThreadLocalが遅くなるか」
ThreadLocalそのものは非常に便利な仕組みですが、以下のような状況・使い方をするとパフォーマンス低下やトラブルを引き起こします。
- ThreadLocalの「数」が多すぎる場合(ThreadLocalMapの肥大化)
- ループ内やホットスポットで頻繁に get() / set() を呼ぶ場合
- スレッドプール環境での「クリーンアップ漏れ」によるメモリリークと肥大化
- 仮想スレッド(Project Loom)や、親子スレッド間で大量の値を継承する場合
4つの条件は、OR条件であり、どれか1つでも条件を満たすと、ThreadLocalは遅くなるそうです。
clojureでプログラムを作ると、clojure自身が定義している変数を含めて、軽く1000は超えるのではないかと想像しています。だから最初の「数」が多すぎる場合が、発生しますし、2番目のループ内で頻繁にアクセスも発生します。だからstaticにして、clojureが頑張ってコーディングしていたのですね(想像)
Spring が遅くならない理由:トランザクション層のAOPで、DBへのコネクションを生成します。
これをDAO層で、取り出すだけだから、遅くならない。
数は、アプリサーバーのスレッドプール数しか必要ありませんし、Webのリクエストが来るたびにThreadLocalを使うだけなので、「ループ内で変数アクセスして頻繁にgetする clojureのような事」は発生しない。
SILVER HAIRED LISPの実装
もちろん、Java25で追加された 「ScopedValue」という機能を使っています。
これはバーチャルスレッド用に開発された「ThreadLocal」の代替クラスです。
「ThreadLocal」より、「ScopedValue」の方が軽いという話なので、バンバン使っています。
Java25で使える、バーチャルスレッドと「ScopedValue」は、神としか言いようがありません。
さすがJavaです。
警告
とはいっても、defvarで定義た変数は、遅いです。
Lisp関数の引数で、処理できるなら、defvarは使うべきではありません。
とにかく、引数より、遅いです。
最後は、以下の言葉でしめさせていただきます。
Global Variables Considered Harmful