
「この問い合わせ、前にも来た気がする。あのとき何て返したっけ?」
こういう事ありますよね?
社内には、Googleスプレッドシートに蓄積したアプリレビューと返信のナレッジがあります。
検索しろよってはなしなんですが、
やりたかったのは、曖昧な言い回しでも似た事例を探し、過去の返信を一覧で見ることです。
そこで、スプレッドシートをCSVを読み込んでJeffで検索し、結果を画面に並べるだけの小さなツールをさっと作ってみました。
新しいレビューを貼ると、関連する過去のレビュー・返信・日付をまとめて表示します。
使ったのはローカルで動くJeff、Pythonの簡単なWeb画面です。
まず動くものを作り、出てくる候補を見ながら検索の精度を調整しました。
なぜJeffを使ったか
GoogleスプレッドシートのGeminiに探してもらう方法もありましたが、手元で試したときは結果が出るまで約10秒かかりました。
めちゃくちゃ遅いとは思わないですが、欲しい事例や表示形式を得るには、プロンプトを工夫する手間もあり、答えを得るのに時間がかかっていました。
もっと手早く、毎回同じ形で候補を出したくてJevを試そうとしました。
ただ、そのときは混雑で新規登録できず、Jevを使えませんでした。(流行りに乗り遅れていたのです)
そこで、無料でローカル実行できるOSSのJeffを使うことにしました。
Jevと同じリクエスト形式を使えて、手元で気軽に試せます。
使ったのは、Qwen3.5-0.8Bをファインチューンしたモデルです。
CSVを入れて、レビューを貼るだけ
今回は、Googleスプレッドシートから出力した465行のCSVを使いました。
レビュー本文・実際の返信・投稿日などが入っています。
レビューと返信の一部を抜粋すると、次のような内容です。
No.,投稿日,レビュー本文,返信文,回答の型
1,2025/01/26,機種変更後に家族として登録し直そうとするとコードが違うと出ます。コピーしても手入力でもだめでした。,一度招待を解除して再発行し届いた案内から登録し直してください。,招待の再発行
2,2025/07/08,家族を追加してから一人にしかお知らせが届かなくなりました。,同じ登録コードを使っていないか確認し利用者ごとに招待してください。,利用者ごとの招待
3,2026/09/15,通知音を変更できるようにしてほしいです。,ご要望は開発チームに共有し検討します。,機能要望の共有
もっと古く2022年以前のレビュー返信もありましたが、その時と対応が異なっていたり、機能そのものが違う可能性もあって2024年度以降の対応履歴のみ引っ張ってきています。
使い方は次の3ステップです。
- 手元のレビュー返信CSVを読み込ませる
- 新しいレビューや問い合わせを貼り、「Jeffで検索」を押す
- 似た過去事例と返信を、日付つきの一覧で確認する
こんな感じです。
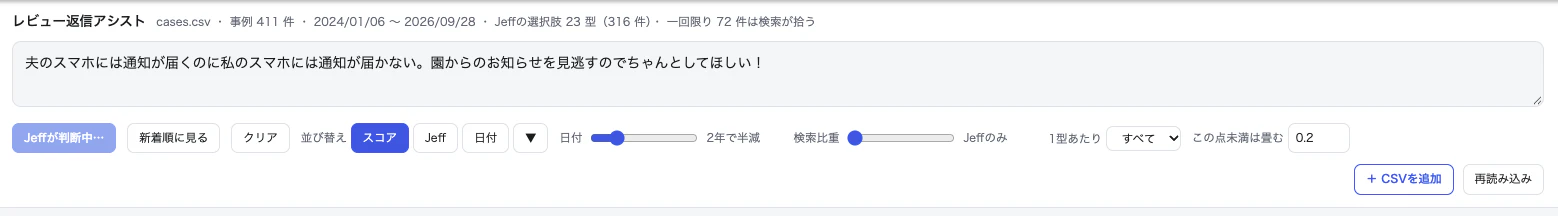
例えば「スマホを買い替えたら、家族用の登録が通らなくなった」と入力して、招待を発行し直すよう案内した事例を探します。単語が完全に一致しなくても、状況が近い事例を拾いたい、という使い方です。
表示するのは、過去に実際に返した文面です。 担当者はそれを参考に、新しい返信を書きます。
曖昧検索の仕組み
Jeffで状況の近さを判断し、文字の類似度で探すTF-IDF検索と組み合わせました。
新しいレビュー
  ↓
Jeffで「どの回答の型が合うか」を判定
  ↓
TF-IDF検索の類似度と合わせて順位付け
  ↓
過去のレビュー・返信・日付を表示
Jeffは選択肢ごとの確率を返すので、その値を順位付けに使えます。
ローカルで動かす
Apple SiliconのMacでは、MLXバックエンドで動かしました。
git clone https://github.com/firelex/jeff.git
cd jeff

uv sync --no-default-groups --extra mac

# モデルをダウンロード(約1.7GB)
uv run --no-default-groups hf download mstrasser/Jeff-Qwen3.5-0.8B \
  --local-dir checkpoints/jeff-0.8b

JEFF_BACKEND=mlx JEFF_CHECKPOINT=checkpoints/jeff-0.8b PORT=8765 \
  uv run --no-default-groups --extra mac jeff-serve
レビューをどの回答の型に振り分けるか、Jeffに聞くリクエストは次の形です。
curl -s localhost:8765/v1/systemone \
  -H 'content-type: application/json' -d '{
    "model": "jeff-latest",
    "state": "スマホを買い替えたら、家族用の登録が通らなくなりました。コードを入れてもエラーになります。",
    "questions": {
      "reply_type": {
        "type": "choice",
        "instructions": "このレビューに合う過去の回答の型はどれですか?",
        "criteria": {
          "招待の再発行": "機種変更や再登録の際に、招待された利用者のコードが通らない状況",
          "利用者ごとの招待": "家族など複数人で利用していて、一人にしかお知らせが届かない状況",
          "機能要望の共有": "今はない機能の追加や、使い勝手の改善を求めている状況",
          "その他": "上のどれにも当てはまらない"
        }
      }
    }
  }'
今回は日本語でも動作しました。ただし、Jeffの公式サポートは英語のテキストのみです。
精度を上げるために調整したこと
CSVを読み込むだけでは、期待した候補がうまく出ませんでした。まず7分類のタスクで比較すると、単純なTF-IDF検索のほうが良い結果でした。TF-IDFは文字N-gramのコサイン類似度を使っています。
| 方式 | 正解率 | 1件あたりの処理時間 |
|---|---|---|
| 最頻クラスを常に選ぶ | 37.1% | — |
| Jeff 0.8B | 44.2% | 1,498ms |
| TF-IDF | 51.5% | 19ms |
この時点では、検索のほうが速く、正解率も高い結果でした。
誤りを調べると、データと選択肢の作り方に問題がありました。
1. 回答の型が細かく分かれすぎていた
同じ回答文に複数のテンプレート名がついていたり、文末の一文だけ違う返信が別の型になっていたりしました。
定型の挨拶・締め・可変部分を正規化し、文字3-gramのJaccard係数0.5でまとめると、回答の型は180種から96種に減りました。
2. 選択肢を詰め込みすぎた
回答の型を180個まとめて渡したところ、上位5候補に正解が入る割合(recall@5)は15.6%でした。
別の実験で33択に絞ると、60.4%まで上がりました。
| 選択肢の数 | recall@1 | recall@5 | recall@10 |
|---|---|---|---|
| 180択 | 4.3% | 15.6% | 22.0% |
| 33択 | 25.3% | 60.4% | 78.0% |
渡せる数と、うまく選べる数は別でした。 この結果は今回のJeffとデータでの測定であり、Jevでも同じとは限りません。
3. 選択肢に返信文をそのまま入れていた
レビューを見て返信文を選ばせるより、その返信を使う状況を説明したほうがよいのではと考えました。
参考になったのは、Jev公式のChoiceドキュメントです。選択肢には短い説明を書き、混同する場合は対象・対象外・例を構造化して示す方法が紹介されています。選択肢で網羅できない入力がある場合には「その他」を用意することも推奨されています。
登録に関する型なら、次のように対象と対象外を分けて書きます。
criteria["招待の再発行"] = {
    "what": "招待された利用者が、機種変更や再登録の際に"
            "コードのエラーで登録できない状況",
    "not_for": "登録はできていて通知だけ届かない場合や、機能の追加要望",
    "examples": ["スマホを買い替えたら家族用の登録が通らなくなった"],
}
criteria["その他"] = "上のどれにも当てはまらない"
whatやnot_forは特別なAPI項目ではなく、説明用に選んだキーです。
説明を直した結果
同じテストセット80件で、返信文を選択肢にした場合と、状況の説明・構造化記述に直した場合を比較しました。
| 方式 | recall@1 | recall@3 | recall@5 | recall@10 |
|---|---|---|---|---|
| Jeff(返信文) | 40.0% | 65.0% | 72.5% | 92.5% |
| TF-IDF | 38.8% | 70.0% | 80.0% | 92.5% |
| Jeff(状況の説明+構造化) | 45.0% | 67.5% | 81.2% | 97.5% |
実際の評価では、通知に関する問い合わせで、正解の回答の型が12位から1位になったケースもありました。
ただし、80件での小さな差なので、TF-IDFより明確に優れているとは言えません。recall@3ではTF-IDFが上です。
実際のツールでは検索と併用した
別の91件の評価では、Jeffは語彙が重ならない言い換えに、TF-IDFは既出の言い回しに強い傾向がありました。
| 入力と過去事例の語彙 | 件数 | Jeff recall@5 | TF-IDF recall@5 |
|---|---|---|---|
| 重ならない | 45 | 66.7% | 57.8% |
| 重なる | 46 | 54.3% | 71.7% |
この評価でのrecall@5は、Jeff単独60.4%、検索単独64.8%、併用81.3%でした。
ツールでは両方の値と日付を使って並べています。
スコア = (Jeff一致度 + 検索類似度 × 比重)× 新しさの係数
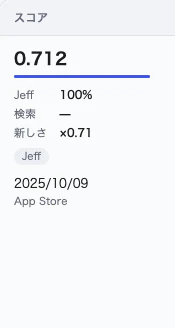
Jeffの確率は本文をキーにキャッシュします。比重や日付の設定変更では推論をやり直す必要がなく、再計算は約1.7秒から24msになりました。
まとめ
- 手元のCSVとJeff、簡単なWeb画面で、社内ナレッジを探すツールを作れた
- レビューを貼るだけで、似た過去事例と返信を一覧で確認できる
- 回答の型と説明文を整理し、文字検索も合わせると候補の精度が上がった
社内にあるレビュー返信CSVを使って、「似た問い合わせに、以前どう返したか」を手早く探せるツールを作れました。初期の分類実験ではJeffの処理時間は1件約1.5秒。検索との併用評価では、上位5候補に正解が入る割合は81.3%でした。
「CSVを入れて、以前どう返したかを探したい」くらいの用途なら、小さなツールから始められます。 今回もまず検索できる形をさっと作り、その後で回答の型や説明文を整えました。無料でローカル実行できるJeffは、手元のナレッジを使って気軽に試すのに便利でした。
環境
- MacBook(Apple Silicon)、MLXバックエンド
- Jeff-Qwen3.5-0.8B(モデル重み約1.7GB)