
この記事は、自社ブログの LYR Performance Note #017 に掲載したものの転載です。
AIがいちばん苦手な言語で、本当のボトルネックを見抜く——スコアの絶対値でなく「失敗の中身」を見る
AIがもっとも苦手な言語のひとつ、スワヒリ語。その翻訳の正答率が 0% → 30% になった。だが価値は、点数ではなく「失敗の中身が変わったこと」にあった。
「単語にすらなっていない文字列」(=その言語を持っていない)から「流暢だが意味がずれる」(=教師が悪い)へ。同じ低スコアでも、律速が容量から教師の側へ移ったという強い手がかりになる。
そして低資源では、巨大な教師が効くとは限らない。教師を3倍にしても差は出ず、低資源向けに設計された小さい教師のほうが勝った(9勝5敗)。1言語あたり約15ドルで「持っていない」から「使えるが粗い」へ跳ぶ。
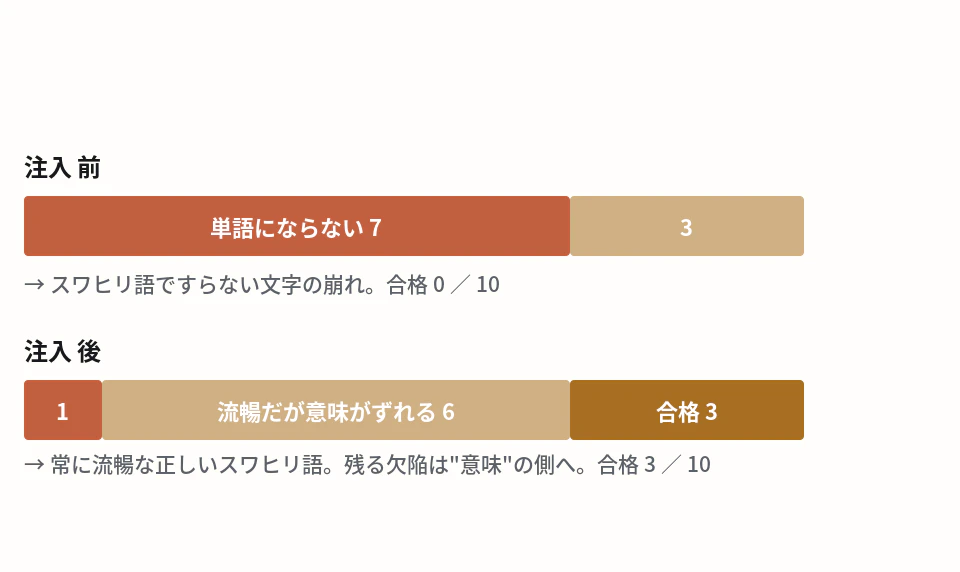
図1:スワヒリ語の、失敗の分布。基礎注入の前後で、合格数は0→3にしか動いていない。だが失敗の中身は、単語にすらなっていない文字列(=その言語を持っていない)から、流暢だが意味がずれる(=教師が悪い)へ入れ替わった。律速が容量から教師側へ移った合図だ。
注:n=10。点推定は"示唆"として読む。
翻訳AIには、得意な言語と、絶望的に苦手な言語がある。英語やスペイン語は易しい。ネット上に対訳が山ほどあるからだ。逆に、話者は1億人を超えるのに、AIがまるで訳せない言語がある。スワヒリ語が、その代表だ。
LYRの自前モデルにスワヒリ語を訳させると、正答率は0%だった。10問中、1問も通らない。ここで多くのチームは、こう結論する——「小さいモデルには荷が重い。大きくするか、諦めよう」と。
だが、この記事の主題はそこではない。スコアが0%だったことではなく、その0%が"どう間違えていたか"——失敗の中身を覗いたら、律速(ボトルネック)の正体が見えた、という話だ。
「0%」には、二種類ある
まず、素のモデルがスワヒリ語をどう間違えたかを見てほしい。訳そうとして出てきたのは、こういうものだった——「Kwa kari」「H,h...」。
これはスワヒリ語ですらない。単語ですらない、文字の崩れだ。モデルは、スワヒリ語という言語をそもそも持っていない。訳を間違えているのではなく、口から出せる語彙がない。赤ん坊に契約書を音読させるようなものだ。10問中、7問がこの「単語にすらなっていない文字列」で、3問がかろうじて言語の形をとる程度。合格は0。
ここで大事なのは、同じ0%でも、質がまるで違うということだ。「意味を取り違えて0%」なのか、「言語を持っていなくて0%」なのか。前者は磨けば直る。後者は、磨く以前の問題だ。スコアの数字は、この違いを教えてくれない。
基礎を、注ぎ込む
失敗の中身が「言語を持っていない」なら、打ち手は一つ。その言語の基礎を、モデルに注ぎ込む。
やり方は、翻訳を教える前に、スワヒリ語の文章そのものを大量に読ませることだ(継続事前学習=base に言語を後入れする)。ウェブから集めた綺麗なスワヒリ語を1億語ぶん、ただひたすら読ませる。このとき、スワヒリ語しか出力しなくなる(元の言語を忘れる)のを防ぐために、日本語と英語も4分の1混ぜておく。GPUを半日ほど回して、この読ませる工程(継続事前学習)そのものは約13ドル。そこに再量子化と、翻訳を仕込む工程(写経とCPO)まで足しても、1言語あたり合計で約15ドル——タクシー1回ぶんだ。
その上で、もう一度訳させた。正答率は、0% → 30%。
正直に言おう。30%は、出荷ラインの60%にはまだ遠い。数字だけ見れば「まだダメ」だ。ここで話を終える人は、この投資を「失敗」と呼ぶだろう。
だが、私が本当に見ていたのは、30%という数字ではなかった。
失敗の"形"が、変わった
冒頭の図1のとおり、数字(合格数)は0→3にしか動いていない。だが、失敗の"形"が丸ごと入れ替わった。
- 前:失敗の主犯は「単語にすらなっていない文字列」——その言語を持っていない。
- 後:単語にならない出力はほぼ消えた。日本語のまま返す、別言語を吐く、といった崩れもゼロ。出てくるのは、常に流暢な、正しいスワヒリ語だ。ただ、ときどき意味がずれる。「worthless(価値がない)」を「価値がある」と反転させたり、英単語が数語まぎれ込んだり。
これが、この投資の本当の成果だ。モデルは、スワヒリ語という言語を手に入れた。「壊れている」から「使えるが粗い」へ。失敗が、言語の層から意味の層へ移動した。
そして、この移動こそが診断になる。失敗の主犯が「単語にすらなっていない文字列」から「流暢だが意味がずれる」へ変わったということは——律速が、モデルの容量から、別のどこかへ移ったという意味だ。では、どこへ?
律速は、"教師"の側にあった
「流暢だが、意味がずれる」。この間違い方には、心当たりがあった。
小型モデルには、上位の大きなモデル(教師)が作った訳をお手本として写経させている(前回の蒸留だ)。生徒が流暢に、しかし意味を外して訳すなら——教師のお手本自体が、意味を外しているのではないか。
確かめ方は、対照実験だ。生徒(base)には一切手を触れず、教師の側だけを変える。もし成績が上がれば、律速は生徒でなく教師の側にある、という示唆になる。
ここで先に変えたのは、教師の"モデル"ではなく"作り方"だ。日本語→スワヒリ語を直接訳させると壊れるので、いったん英語を経由させた(日本語→英語→スワヒリ語)。英語という"広い道"を通すことで、読解が復旧する。
結果——この作り方の変更だけで、13件中9勝1敗(引分3)。生徒は1バイトも変えていない。ただし勝敗のついた非引分はわずか10件だから、「確定」とまでは言えない。それでも、律速が生徒の容量でなく、教師の"作り方"の側にある——という示唆はかなり強い。
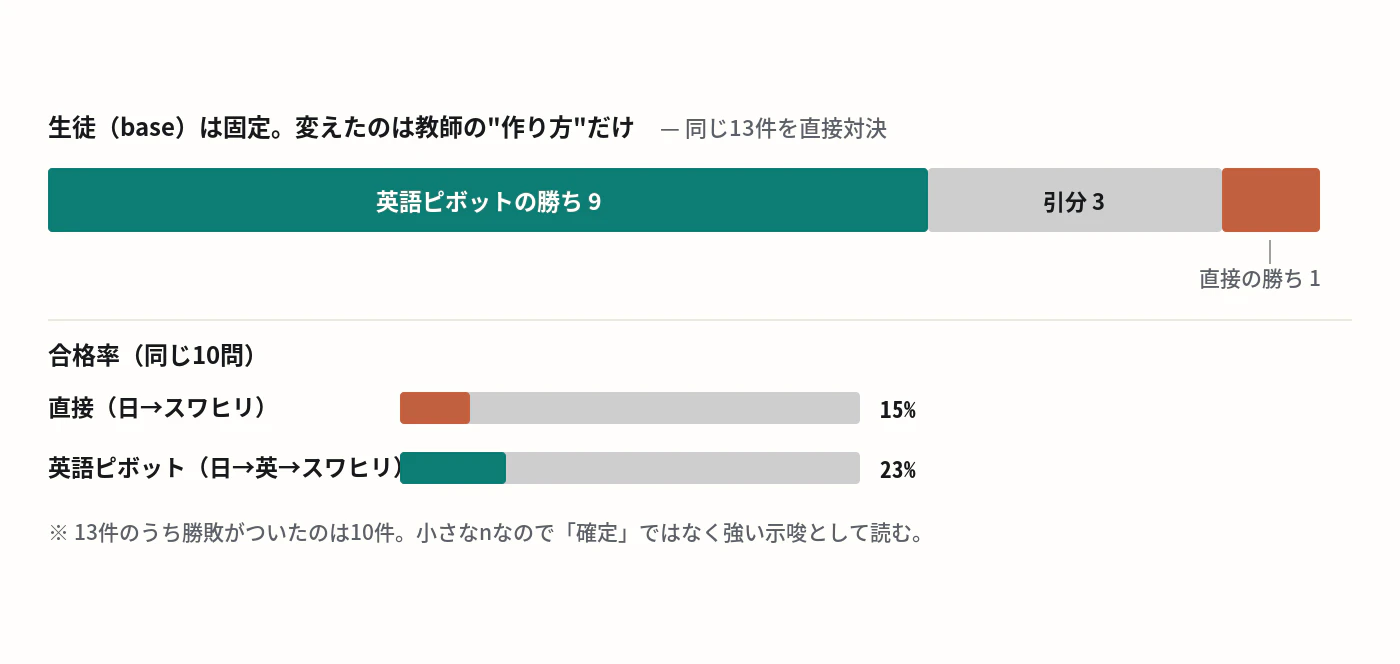
図2:教師の"作り方"だけを変えた対照実験。生徒(base)は1バイトも変えず、教師の生成経路だけを差し替えて同じ13件を直接対決させた。英語ピボットの勝ち9 / 引分3 / 直接の勝ち1で、合格率も 15% → 23% に上がる。生徒を固定しているので、この差は生徒の容量ではなく教師の側に律速があったことを指す。
注:勝敗がついたのは13件中10件。小さなnのため「確定」ではなく強い示唆。
もし私が最初のスコア「30%」だけを見て「モデルが小さすぎる」と結論していたら、容量を増やす(=モデルを大きくする、高い)方向へ投資していただろう。だが少なくともこの入り口(日本語→スワヒリ語)で効いたのは、教師の作り方(=安い)を変えることだった。診断を間違えれば、高いほうへ全力で走るところだった。
直感に反すること——"教師"も、この言語が苦手
ここで、もう一段の落とし穴がある。
「教師が律速なら、もっと大きくて賢い教師を連れてくればいい」——そう思うのが自然だ。写経元にしているのは、汎用の巨大モデルだ。あれは何でもできる。スワヒリ語くらい、と。
ところが、巨大な汎用モデルほど、低資源言語では驚くほど弱い。これは私の発見ではなく、文献で繰り返し実証されている事実だ。最高峰の汎用モデルですら、英語→他言語の翻訳で専用の翻訳モデルに勝てたのは5.5%という報告がある。別の調査では、汎用モデルは204言語のうち84%で、旧来の翻訳専用モデルに負けた。
万能に見える巨大モデルは、英語や主要言語という"広い舗装道路"の上でだけ万能なのだ。スワヒリ語のような未舗装路に入ると、専用の翻訳モデルにあっさり抜かれる。「大きいモデルに写経させれば安心」という反射は、ここでは効かない。
実際、教師を大きくしてみた。翻訳専用モデルを3B(30億)から10B(100億)へ、3倍以上に増やした。結果は——有意差なし(3勝3敗)。パラメータを増やしても、英単語の混入も意味の反転も、そのまま残った。効いたのは「大きさ」ではなく、低資源言語向けに設計された別系統のモデルのほうだった(英→スワヒリ語の合格が0/7→5/7へ)。ただしこの5/7も検証はわずか7件——「効いた」は断定でなく、3勝3敗と同じ物差しで読めば"強い示唆"だ。
"教師を大きくする"は、低資源言語では買えない。買えるのは、"その言語に合った教師を選ぶ"ことだ。
律速は、方向で違う
もう一つ、診断が教えてくれたことがある。ここで足をすくわれやすいのは、「教師をいじる」と一口に言っても二種類の介入があることだ。教師の"作り方"を変える(英語ピボット)のと、教師"モデル"そのものを大きく/強くする(teacher強化)のは、まったく別の打ち手だ。これを混ぜると、律速の帰属が反転して見える。教師まわりで試した4つを、介入の種類で並べ直す(すべて小n=「効いた/効かない」は断定でなく示唆として読む)。
| # | 介入 | 何を変えたか | 方向 | 結果(n) | 読み取れること |
|---|---|---|---|---|---|
| ① | 英語ピボット | 教師の作り方(日→英→スワヒリ) | 日→スワヒリ | 9勝1敗・引分3(計13、非引分10) | 読解が復旧=教師の出力が頭打ちだった |
| ② | 教師を3倍に | 教師モデルのサイズ(3B→10B・同設計) | スワヒリ語出力 | 3勝3敗・引分14(有意差なし) | サイズ増では差が出ない |
| ③ | 別系統の教師へ | 教師モデルの設計(低資源特化NLLBへ) | 英→スワヒリ | 合格0/7→5/7(n=7) | 設計が合えば伸びる |
| ④ | 別系統の教師へ | 教師モデルの設計(NLLBへ) | 日→スワヒリ | 引分(teacher非依存) | 強い教師でも伸びず |
表を"介入の種類"で読むと、方向ごとに律速の正体がはっきり分かれる。
- 英語→スワヒリ語:教師の"作り方"も"モデル"も、良くすれば伸びる(教師律速=③ 0/7→5/7)。出力側の"綴り方・言い回し"の問題だからだ。
- 日本語→スワヒリ語:"作り方"を変える英語ピボットは効く(① 9勝1敗)が、"モデル"をどれだけ大きく/強くしても頭打ち(②③④)。日本語の主語の省略や慣用句を"読み解く"深い理解は、モデルの器そのものを要求する(容量律速)。
つまり前節の「教師の"作り方"が律速」(① 日→スワヒリ)と、「教師モデルを強くしても伸びない」(④ 同じ日→スワヒリ)は、矛盾ではない。効くのは"作り方"、頭打ちなのは"モデル強化"——同じ方向でも、介入が違えば律速も違う。この二つを一つの「教師を差し替える」に丸めていたら、帰属を取り違えていた。一括りに「低資源だから難しい」で片付けていたら、この分岐は永久に見えなかった。
低資源は、"諦める尾"ではない
ここまでを、経営の言葉に翻訳しておく。
多くのチームにとって、低資源言語は「切り捨てる尾(ロングテール)」だ。ユーザーが少なく、AIが苦手で、コストに合わない。統計の端っこ。
だがLYRにとって、それは違う。「言語が壁で、そのコンテンツが見られない」——それを壊すのが、LYRの存在意義だ。世界で最も苦手とされる言語こそ、LYRが強くあるべき中心にある。
そして今回わかったのは、それが根性論ではなく、経済的に成立するということだ。1言語あたり約15ドルで、モデルはその言語を「持っていない」状態から「使えるが粗い」状態へ跳ねる。これは「$15 × 言語数」で素直に積み上がる——苦手言語を50並べても$750、100並べても$1,500。エンジニア1人日の人件費にすら満たない。あとは律速を診断して、正しいほうへ投資する。診断さえ間違えなければ、低資源言語は安く、順番にfirst-class(一級市民)へ格上げできる。
出発点は、いつも同じだった——スコアの数字でなく、失敗の中身を見ること。
教訓
-
スコアの絶対値でなく、失敗の"分布"を見る。 同じ「0%」でも、「言語を持っていない」のと「意味を取り違えた」のは別物だ。数字は同じでも、打ち手は正反対。失敗の中身を覗いて初めて、律速の正体がわかる。(マニフェスト第1原則「まず計測せよ」——ただし"何点か"でなく"どう外したか"を測る)
-
失敗の"形の変化"こそが診断になる。 基礎を注入して、失敗が「単語にすらなっていない文字列」から「流暢だが意味がずれる」へ移った。これは点数が伸びた以上に重要な情報だ——律速が、容量から教師の側(作り方・モデル選び)へ移ったという強い手がかりだから。伸び幅でなく、シフトを読む。
-
低資源では"大きな教師"が効くとは限らず、諦める尾でもない。 教師を3倍にしても差は出ず、低資源向けの設計が勝った。買うべきは"大きさ"でなく"その言語に合った設計"だ。1言語約15ドルで「持っていない」から「使えるが粗い」へ跳ぶ。あとは方向ごとに律速を切り分け、安いほう(教師選び)から潰す。
付録:生データ(実験ごと)
共通条件: 自前8Bモデル、スワヒリ語(INT4量子化で0% / BF16で10%=base律速確定済)。評価は本番デプロイの量子化のまま、同一judgeラウンドで前後を統制比較。判定はいずれも小n=点推定は"示唆"として読む。
| 実験 | 結果 | 条件・留保 |
|---|---|---|
| ① base注入(継続事前学習) | 合格 0.00 → 0.30。失敗が「単語にならない文字列 7/10」→「流暢だが意味がずれる」へシフト | n=10。mono ~100M tok + 日/英25% replay、~10.8時間。日本語echo・wrong-lang はゼロに |
| ①のコスト | CPT単体 ~$13、再量子化+翻訳SFT+CPO込みで 合計 ~$15/言語 | — |
| ② 教師の"作り方" | 直接(合格0.15・1勝)→ 英語ピボット(合格0.23・9勝) | base固定で生成経路だけ差替え。非引分 n=10 のため確定でなく強い示唆 |
| ③ 教師のサイズ | 専用MT 3B→10B で 3勝3敗・引分14=有意差なし | 英語leak・意味反転を10Bも同様に残す |
| ③ 教師の設計 | 低資源向け設計の別系統で 9勝5敗、en→sw 合格 0/7→5/7 | 優位はサイズでなく設計 |
| ④ 方向で律速が違う | en→sw は伸びる(teacher律速)/ja→sw は伸びない(容量律速) | 日本語の読解(主語省略・慣用句)は器を要求 |
| 文献(教師自体の弱さ) | 汎用最高峰でも en→xx で専用MT に勝率 5.5%、204言語中84%で劣後 | arxiv 2404.13813 / 2309.07423。低資源では「巨大モデルに蒸留」の反射が効かない |
関連: 蒸留とSFT/CPOの基礎は 小さなAIを1つの仕事の専門家に育てる。(注:スワヒリ語CPT baseは他言語を忘却するため、出荷は言語ごとのbase切替で分離。この serving 設計は別稿)
シリーズ「モデル — 小さく、速く、賢く」第7回の記事です。原文と続きは LYR Performance Note #017 / 記事一覧 にあります。