
この記事は、自社ブログの LYR Performance Note #016 に掲載したものの転載です。
最高の翻訳より、最悪を減らすほうが効いた——製品の価値は「天井」でなく「床」にある
最下位率を 64% → 24%(−40pt)へ大幅に削り、最上位率の低下は 24% → 12%(−12pt)の小幅に抑えた。 差し出した3件に対し、返上した最下位は10件だ(25件中)。
字幕製品でユーザー体験を壊すのは、平均でも最高でもなく、たった一度の最悪だ。だから狙う場所を、天井(最高品質)から床(最悪の一回)へ移した。天井を少し差し出して、床を買った。
平均一致率(89〜96%)は、この改善をまったく捉えない。問題がtailにあるなら、平均はそれを薄めるからだ。天井と床は、別々に動かせる——先に決めるべきは、どちらを動かすかだった。
測り方:難所25件を3構成(圧縮のみ/+rotation/圧縮前)で訳し、盲検で順位づけ。最下位率/最上位率=3構成のなかで最下位/最上位になった割合(それぞれ3構成の合計=100%)。最下位率は大事故の代理指標として使う——最下位に落ちた訳の大半が致命的な崩れであることは、目視で確認している。
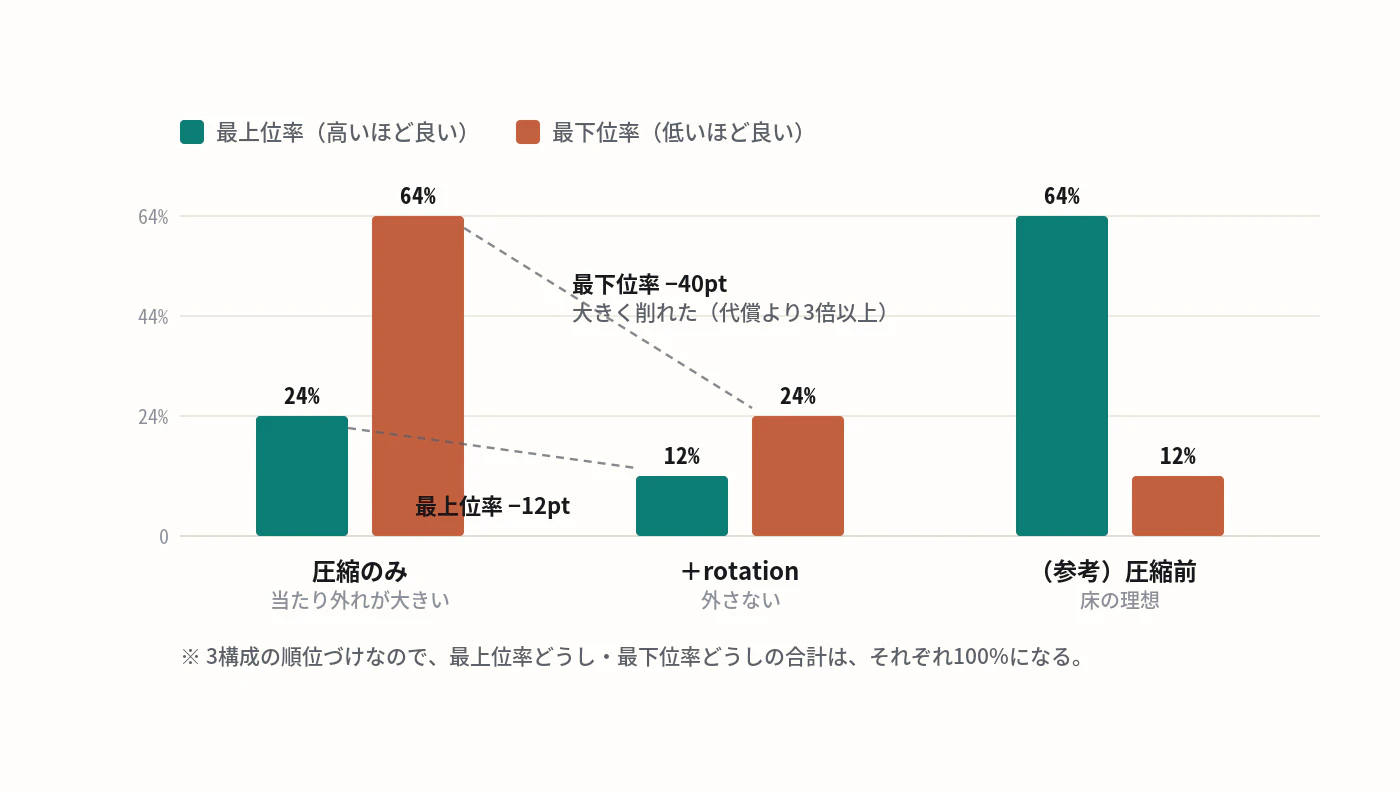
図1:最上位率と最下位率の比較。3構成のなかで最上位/最下位になった割合。rotationを入れると最下位率は 64% → 24%(−40pt)と大きく削れ、代償である最上位率の低下は 24% → 12%(−12pt)にとどまる。参考の圧縮前は、その裏返し(最上位率64% / 最下位率12%)。
注:held-out ドラマ 25 hard cases、盲検順位づけ。相対順位なので、最上位率どうし・最下位率どうしの合計はそれぞれ100%になる。
自前の小さなモデルを、4分の1に圧縮した(量子化)。速く、安くなった。品質も、平均で見ればほとんど落ちていない。数字の上では、文句のつけようがなかった。
ところが、実際に訳を並べて読むと、時々ぎょっとするものが混じっていた。日本語のセリフが、日本語のまま返ってくる。登場人物の性別が入れ替わる。固有名詞が別物に化ける。頻度は低い。だが、字幕でこれが一度起きると、没入は一瞬で壊れる。
平均は同じなのに、体験はまるで違う。この食い違いを詰めていったら、「品質」という言葉の使い方そのものを、作り直すことになった。製品に効いていたのは、天井(最高品質)ではなく、床(最悪の一回)だった。
平均で見ると、差が消える
まず、何が起きていたか。
強い圧縮(INT4=重みの数字を4ビットに丸める)をかけたモデルは、当たり外れが激しかった。わざと難しく選んだ25個のセリフ(held-outの難所)を、3つの構成で訳し、上位モデルに盲検で順位づけさせる。以下の数字はすべて、この25件のなかでの相対順位だ(本番全体の発生率ではない)。すると、こうなった。
- 圧縮モデルの最上位率(いちばん良い訳だった割合):6件/25 = 24%
- 圧縮モデルの最下位率(いちばん悪い訳だった割合):16件/25 = 64%
最高を出すこともあれば、最悪を出すことも多い。ばらつきが大きい——専門的にはbimodal(二峰性=良い山と悪い山に割れる)という。当たれば絶品、外すと事故。字幕として、これは使えない。
ところが、この危うさは平均を見ても出てこない。圧縮前と圧縮後で、生成トークンの一致率を測ると、こうだった。
| 指標 | 圧縮前 | 圧縮後(INT4) |
|---|---|---|
| 一致率(一般テキスト) | 89.5% | 89.8% |
| 一致率(日→英) | 95.6% | 95.3% |
差は、ほぼゼロ。この数字だけ見て「劣化なし」と結論していたら、事故を見逃していた。
なぜ平均が鈍いのか。圧縮の損失は、全体の1割強の"きわどい"判断にだけ集中する(第1回で書いた話だ)。残り9割は圧縮前と同じ答えを返すので、平均一致率はその9割に薄められる。平均は、tail(最悪の側)を希釈してしまう。 効いていたのは、平均に埋もれた1割強のほうだった。
たった一度のechoが、なぜ致命的か
なぜ「最悪の一回」をそこまで重く見るのか。
字幕翻訳の北極星は、「存在感のない字幕」だ。訳が自然に画面に溶けていて、ユーザーは翻訳されていることすら忘れている——それが最高の状態だ。ところが、日本語のセリフが日本語のまま出る(echo=訳さず原文をそのまま返す失敗)と、その瞬間に「あ、これ機械翻訳だ」と我に返る。没入は連続量ではない。一度切れたら、ゼロに戻る。
これはボトルネックの記事で書いた「致命的な崩れ」と同じ構造だ。100回のうち99回が完璧でも、1回のechoが体験全体の印象を決めてしまう。ユーザーは平均を体験しない。最悪を体験する。
だから、追うべき指標は平均品質ではなかった。床——最悪時の品質だ。事故率とは、この床を裏返して測ったもの(低いほど床が高い)にすぎない。
ではどう測るか。この記事の看板数字(64%→24%)は、上の難所25件で「3モデル中いちばん悪い訳=最下位を出した割合」——最下位率だ。相対順位なので、最下位=即致命的とは限らない(圧縮前ですら12%は最下位に回る)。ただし最下位に落ちた訳を1件ずつ目視すると、その大半が性別反転・固有名破壊・主客の取り違え・echoといった致命的な崩れだった。だから最下位率は、大事故の代理指標としてそのまま使える——以降の「大事故率」はこの意味だ。
天井は上げず、床だけを上げる
では、どうやって大事故を減らすか。
ここで効いたのが、rotation(回転)という補正だ。圧縮の前に、モデルの重みを数学的に"回転"させておくと、丸め誤差が一部の数字に集中せず、全体に薄く散る。きわどい判断が誤差でひっくり返りにくくなる——tailの崩れを、狙って抑える技術だ。
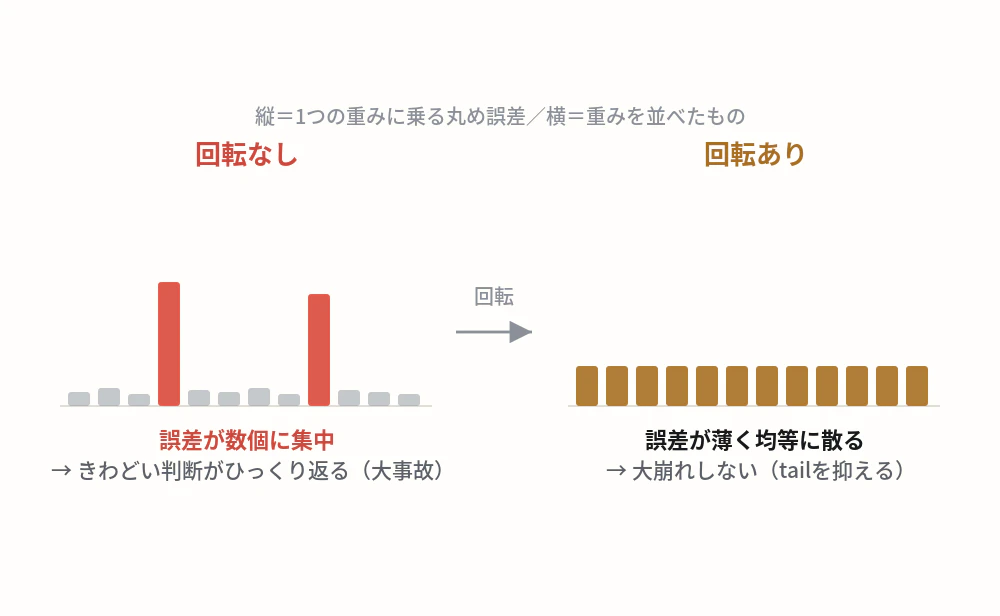
図2:rotation(回転)が、誤差に何をするか。回転なしでは丸め誤差が数個の重みに集中し、きわどい判断がひっくり返る。回転ありでは誤差が全体へ薄く均等に散り、大崩れしなくなる。
これを入れて、同じ25ケースを測り直した。
| 圧縮のみ | +rotation | (参考)圧縮前 | |
|---|---|---|---|
| echo残留 | 4回 | 0回 | 0回 |
| 最下位率(=大事故の代理) | 64%(16件) | 24%(6件) | 12%(3件) |
| 最上位率 | 24%(6件) | 12%(3件) | 64%(16件) |
読み方に注意がいる。最上位率は下がった(24%→12%)。rotationは、モデルを"最高に賢く"はしていない。だが最下位率は 64%→24% へ、ほぼ3分の1に落ちた(平均順位でも2.40→2.12)。下げ幅は −12pt に対して −40pt——差し出した分より、返ってきた分がはるかに大きい。echoに至っては4回から0回。最悪時の品質=床が、圧縮前(12%)に、ぐっと近づいた。
一般テキストの困惑度(ppl=モデルの"自信のなさ"の指標、低いほど良い)も、圧縮で10.65へ悪化していたのが、rotationで9.95まで下がって戻り、圧縮前(9.94)にほぼ並んだ。最上位率がわずかに下がる代わりに、崩れていた床——最悪側の品質——が回復したのだ。
製品としては、これで十分だった。最高の訳を1回増やすことより、最悪の訳を10回減らすことのほうが、字幕という製品には効く。天井を捨てて、床を選んだ。
(この「天井か床か」の選択そのものは、Paretoの記事で"操作点の選び方"として触れた。あそこでは方法A=圧縮のみ、方法B=rotationとして並べた。この記事は、その一点を測定の中身まで掘り下げたものだ。どちらが"優れている"かではなく、製品がどの軸を必要とするか、で座る場所が決まる。)
天井は戻らない。そして自動指標は、事故を隠す
まず、勝ち切ってはいない。rotationが戻すのは床であって、天井は戻らない——圧縮前(最上位率64%/平均順位1.48)には届かないままだ。圧縮で失った最高品質は、この補正では取り返せない。
そしてもう一つ。この一件で、いちばん怖かったのは技術の話ではない。最初に信じた指標が、事故を見えなくしていたことだ。
一致率89〜96%——立派な数字だ。これを合格基準にしていたら、圧縮モデルは「ほぼ無劣化」で通過し、echoを吐きながら本番に出ていた。指標が間違っていたのではない。そして「平均だからダメ」でもない——同じ平均でも、ppl(困惑度)は床の回復をちゃんと捉えた。問題は、その指標が何を薄めるかだ。トークン一致率は、事故の起きる少数を大多数の"問題ない部分"で薄めてしまい、いちばん知りたい最悪ケースが構造的に見えなくなっていた。tailが問題の場面では、使う平均が何を希釈するかを疑い、必要なら最悪ケースを直接数える。
結局、事故を捉えたのは、生成した訳を人手で読み、致命的な崩れを1件ずつ数える——という素朴な作業だった。ここは今も自動化できていない。自動指標が鈍いなら、tailを直接数えるしかない。measure(測る)対象を、平均から最悪へ、一段ずらす。それだけのことに、危うく気づかないところだった。
教訓
-
製品の価値は、天井でなく床にある。 一度の崩れが体験を壊す製品では、床がそのままKPIになる。受け入れ基準は「平均◯点以上」でなく「最悪ケース率◯%以下」で書く——ユーザーは平均を体験しない、最悪を体験する。
-
その平均指標が「何を薄めるか」を疑う。 すべての平均が悪いわけではない(pplは床の回復を捉えた)。だがトークン一致率89〜96%は、事故の起きる1割強を大多数の"問題ない部分"で薄めていた。問題がtailにあるなら、最悪ケースを直接数える指標に替える。
-
天井と床は、別々に動かせる。 最下位率を64%→24%(−40pt)へ大きく削り、最上位率の低下は24%→12%(−12pt)に抑えた。差し出した3件に対し、返上した最下位は10件だ。「全体を良くする」でなく「どの部分を良くしたいか」を先に決める。伸ばす場所を取り違えると、正しい技術でも空振りする。
マニフェストの3番目の原則——「ユーザー体験の代理指標を、正しく選ぶ」、なかでも「良い代理指標は平均でなく、最悪の一回(tail)を見る」——を、いちばん素朴な形で突きつけられたのがこの一件だった。速さでも品質でも、効いてくるのはいつも分布の端のほうだ。
付録:生データ
対象: 自前8Bモデル、held-outドラマ 25 hard cases、本番と同じ自由生成を上位モデルで盲検順位づけ。
| 指標 | 圧縮のみ → +rotation | 条件・留保 |
|---|---|---|
| 最下位率(大事故の代理) | 64% → 24% | 圧縮前BF16の12%に接近 |
| echo残留(原文丸写し) | 4回 → 0回 | — |
| 平均順位 / ppl | 2.40 → 2.12 / 10.65 → 9.95 | ppl は圧縮前BF16の9.94にほぼ一致 |
| 分布の形 | 1位6件・最下位16件(bimodal) → 1位3件・最下位6件 | 圧縮前BF16(1位16件・平均順位1.48)には及ばず=天井は戻らないが床は戻る |
| 平均指標の鈍さ | 一致率 一般 89.5→89.8%、日→英 95.6→95.3%(Δ≈0) | 直しているのは固有名・代名詞といったtailで、平均一致率はそれを希釈する=判定に使わない |
| rotation とは | 重みを回転させ量子化の丸め誤差を分散させる補正 | 天井でなく床を回復するための仕上げ |
一般則: 圧縮モデルの評価は必ず本番と同じ量子化・自由生成で、平均でなく最悪ケース率を主KPIに(量子化は微調整を削るの評価原則と同根)。
シリーズ「モデル — 小さく、速く、賢く」第6回の記事です。原文と続きは LYR Performance Note #016 / 記事一覧 にあります。