
この記事は、自社ブログの LYR Performance Note #021 に掲載したものの転載です。
1点でなく、曲線の形を見る——Sweepという習慣
閾値も解像度もバッチサイズも、たいていは勘で決められている。1つか2つ試して、良さそうな方を採る。
検証が安くなった時点で、その決め方をやめた。1点を選ぶ代わりに、範囲を端から端まで掃いて曲線の形を見る。sweet spotも、膝も、崖も、形を測って初めて見える——1点は、形を教えてくれない。
そして掃けるかどうかは、検証の安さで決まる。1回が高いと、人は勘に戻る。まず検証を安くするのが先だ。
エンジニアリングは、マジックナンバー(コードの中に、はっきりした根拠のないまま置かれている具体的な数値)だらけだ。閾値、画像解像度、バッチサイズ、タイムアウト。これらの値を、どうやって決めているだろう。正直に言えば——多くは、勘だ。せいぜい1つか2つ試して、良さそうな方を採る。
ハーネスで検証が桁違いに安くなったとき、私はこの決め方をやめた。1点を選ぶのではなく、範囲を端から端まで掃いて、曲線の形を見るようになった。これがSweepだ。
1点では見えないものが、曲線には見える
例として、OCRで文字を検出するときの画像解像度を挙げる。「高解像度ほど精度が高い」——直感はそう言う。だから勘で決めるなら、迷わず高い方を選ぶ。
だが、解像度を何通りも振って、精度(CER、低いほど良い)と速度を一緒に測ると、こういう曲線が見えた。
| 解像度 | 誤り率(CER, 低いほど良い) | 速度 |
|---|---|---|
| 960 | 9.4% | 75 ms |
| 736 | 10.7% | 40 ms |
| 480 | 35%(崩壊) | 18 ms |
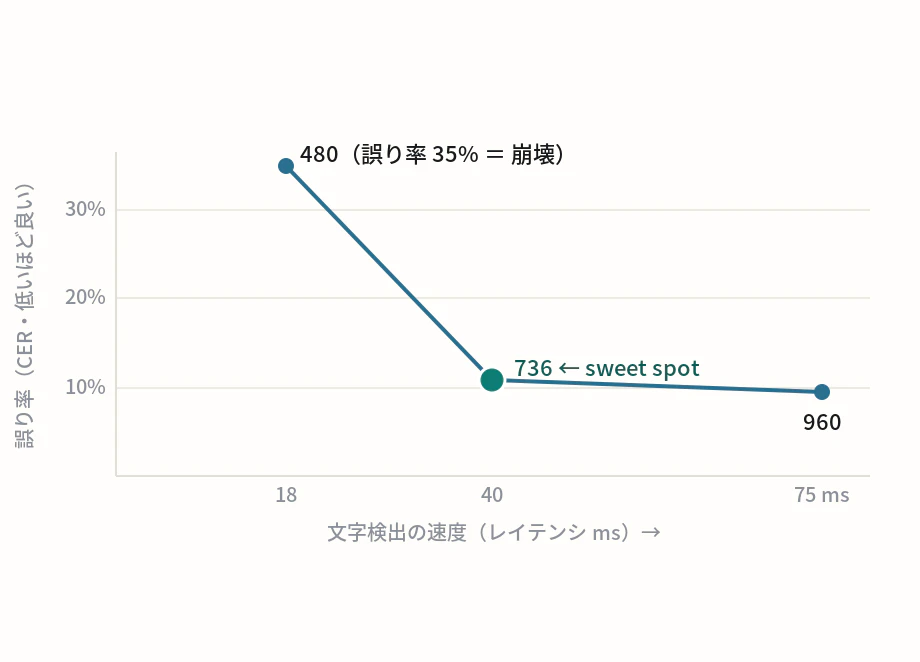
図1:OCR検出の解像度 sweep。横軸レイテンシ、縦軸 誤り率。736が速度と精度のsweet spotで、960に対し誤り率+1.3ptと引き換えに速度は半分。480まで落とすと誤り率が急増して崩壊する。
注:n=6の小サンプル=方向性の確認。
真ん中の736が、明らかな"sweet spot"だった。960に対して、誤り率はわずか1.3ポイント(9.4%→10.7%)上がるだけで、速度は半分になる。一方、480まで落とすと精度は崩壊する(誤り率が10.7%→35%へ、3倍以上に跳ねる)。グラフの折れ目(膝)が、まさに736にある。
もし勘で960を選んでいたら、ごくわずかな精度のために、倍の時間を払い続けていた。480を選んでいたら、そもそも読めない。この sweet spot は、両端と真ん中を測って、はじめて見えた。1点だけ測っていたら、絶対に見つからない。
曲線には「膝」がある
もうひとつ、曲線でしか見えないものがある。膝(knee)——それ以上やっても、ほとんど良くならなくなる折れ目だ。
学習データの量を増やしていくと品質がどう上がるかを掃いてみたとき、難しいケースの読解精度は、ある量(ごく少数)を超えると、そこから先はフラットだった。データをいくら足しても、難所は改善しない。膝の向こうは、投資しても無駄——別のレバー(モデルの容量)が要る、という合図だった。
これも、1点や2点では見えない。曲線を描いて初めて、「ここから先は効かない」という境界がわかる。
なぜ、いま掃けるのか
Sweepは、昔からある発想だ。だが、実務で徹底してやる人は、あまり多くないかもしれない。理由は単純で、高くつくからだ。閾値を11通り試すには、手作業なら11回の検証。正気を疑う回数になる。
変わったのは、ハーネスで検証から人手が要らなくなったことだ。一度フレーム列を焼けば、11通りの設定を並列に、手作業ゼロで流せる。かつては1通りごとに人が端末を持って録画していたのが、まとめて回せるようになった。検証が安くなった瞬間、「1点を勘で選ぶ」より「面で掃いて形を見る」ほうが、確実で割に合うようになった。Sweepは、ハーネスが生んだ余白の、最初の使い道だった。
教訓
- マジックナンバーを、勘で決めない。 閾値・解像度・バッチサイズ——その値がなぜその数字なのか、たいてい根拠がない。
- 1点でなく、範囲を掃いて曲線を見る。 sweet spotも、崖も、全体の形を測って初めて見える。とくに膝——「ここから先は効かない」という折れ目——は、別のレバーに移る合図だ。
- 掃けるかどうかは、検証の安さで決まる。 1回の検証が高いと、人は勘に戻る。まず検証を安くする。そうすれば、掃くのが当たり前になる。
次回は、この「掃いて得た点群」を、複数の目的(速さ×精度×コスト)で読むと何が見えるか——Paretoの話へ。掃くこと(Sweep)と、前線を読むこと(Pareto)は、同じコインの裏表だ。
付録:生データ
| Sweep | 結果 | 条件・留保 |
|---|---|---|
| OCR検出の解像度 | 960 = 誤り率 9.4% / 75ms、736 = 10.7% / 40ms(sweet spot)、480 = 35% / 18ms(枠検出が崩壊) | 縦持ち JA+EN、n=6 の小サンプル=方向性の確認 |
| 文字認識モデルの入力次元 | 128×480 が全データセットを通じて Pareto-best | 3データセット×7次元。他はちらつき or タイミング悪化 |
| データ量の膝 | 読解の難所は N≲25 を超えるとフラット | データ増でなく容量が律速。掃いたから膝が見えた |
| 前処理幅 | 短い字幕(Live)最適の幅を長い行(Page)に使うと崩壊 | 1つの固定値が別モードを壊す=最適値はモード依存 |
シリーズ「計測・調整 — 正しく測り、設定を合わせ込む」第1回の記事です。原文と続きは LYR Performance Note #021 / 記事一覧 にあります。