
この記事は、自社ブログの LYR Performance Note #030 に掲載したものの転載です。
4B-INT8 と 8B-INT4 は同じ速さだった——そして測り方を1つ間違えると、2.35倍が「差なし」に見える
同じGPUで測ると、4B-INT8(重み約4.0GB)と 8B-INT4(約4.3GB)はほぼ同じ速さだった。 1トークンあたり 5.98ms 対 6.50ms。パラメータ数は2倍違うのに、だ。
理由は単純で、1トークン生成するたびに、モデルの重みを全部読み出すから。決めているのは計算量でもパラメータ数でもなく、読み出すバイト数だった。だからGPUを選ぶときも、演算性能ではなくメモリ帯域を見る。
ただしこの法則には前提がある。実際、私は最初に測り方を間違えて「2倍速いはず」を 1.3倍 と誤読し、別の測り方では 2.35倍の差が消えたり、逆転したりした。
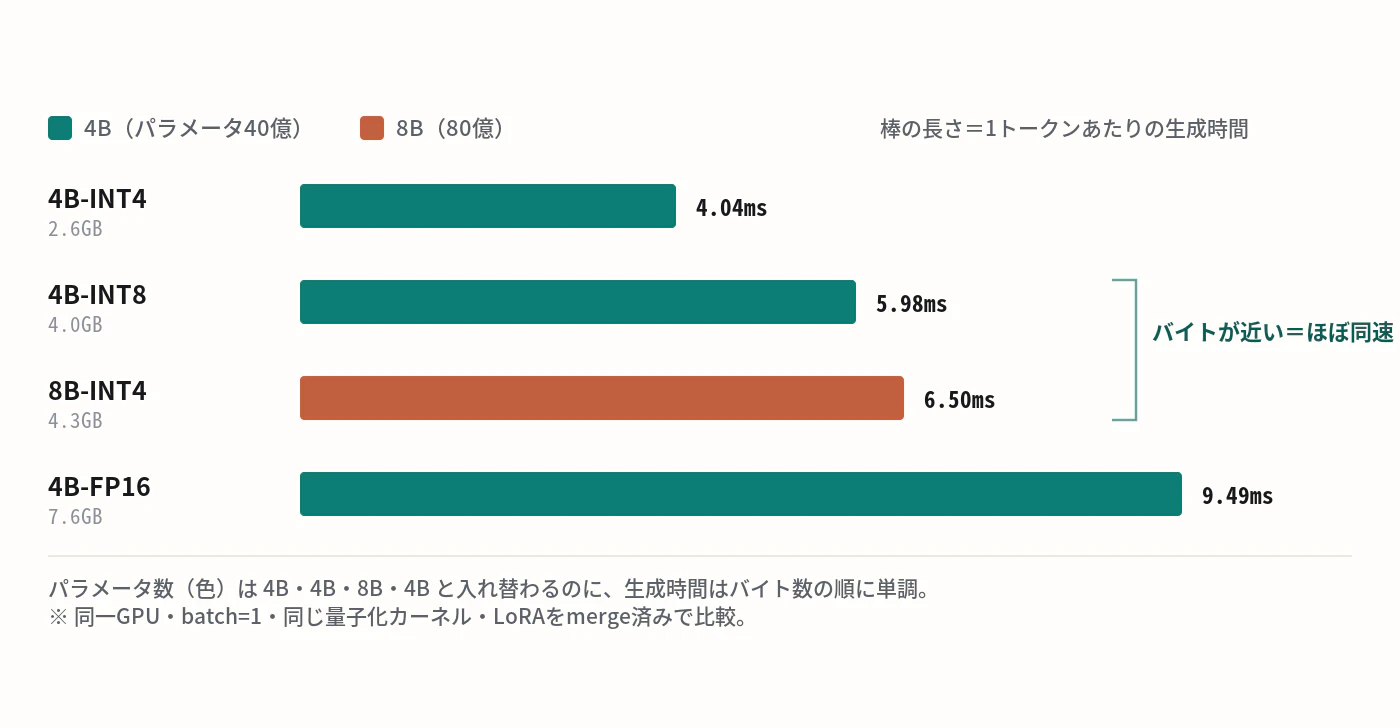
図1:重みのバイト数と、1トークンあたりの生成時間。色はパラメータ数(緑=4B、赤=8B)。並び順は 4B・4B・8B・4B と入れ替わるのに、生成時間はバイト数の順にきれいに単調だ。とくに 4B-INT8(4.0GB)と 8B-INT4(4.3GB)は、パラメータが2倍違うのにほぼ同速になる。
注:同一GPU・batch=1・同じ量子化カーネル・LoRAはmerge済みで揃えた比較。
「4Bなら2倍速いはず」が、1.3倍しか出なかった
最初の測定は、こうだった。8Bモデルを4Bに置き換えれば、読み出す重みが半分になるので2倍近く速くなるはず。ところが実測は 1.24〜1.36倍にとどまった。
「4Bにしても、思ったほど速くならない」——ここで結論を出していたら、モデルサイズの選定を丸ごと間違えていた。
原因はモデルではなく、測っていた構成が揃っていなかったことだった。4B側だけ、二重のハンデを背負っていた。
- 量子化カーネルが違う(片方は、そのGPU世代で展開効率の劣る方式だった)
- アダプタを外付けのまま動かしていた(生成のたびに小さな行列積が余分に乗る)
8B側と同じく、同じ量子化方式で、アダプタをモデル本体に統合してから測り直すと——2.3倍。最初から法則どおりだった。
比較する前に、serving構成を揃える。 揃っていない比較は、2倍を1.3倍に見せる。
1トークンごとに、重みを全部読む
なぜバイト数で決まるのか。仕組みは素朴だ。
言語モデルが1トークン生成するとき、モデルの重み全体に一度ずつ触る。だからbatch=1(一人分だけを生成している状態)では、演算よりメモリからの読み出しが支配する。読み出す量=重みのバイト数なので、生成速度はバイト数に反比例する。
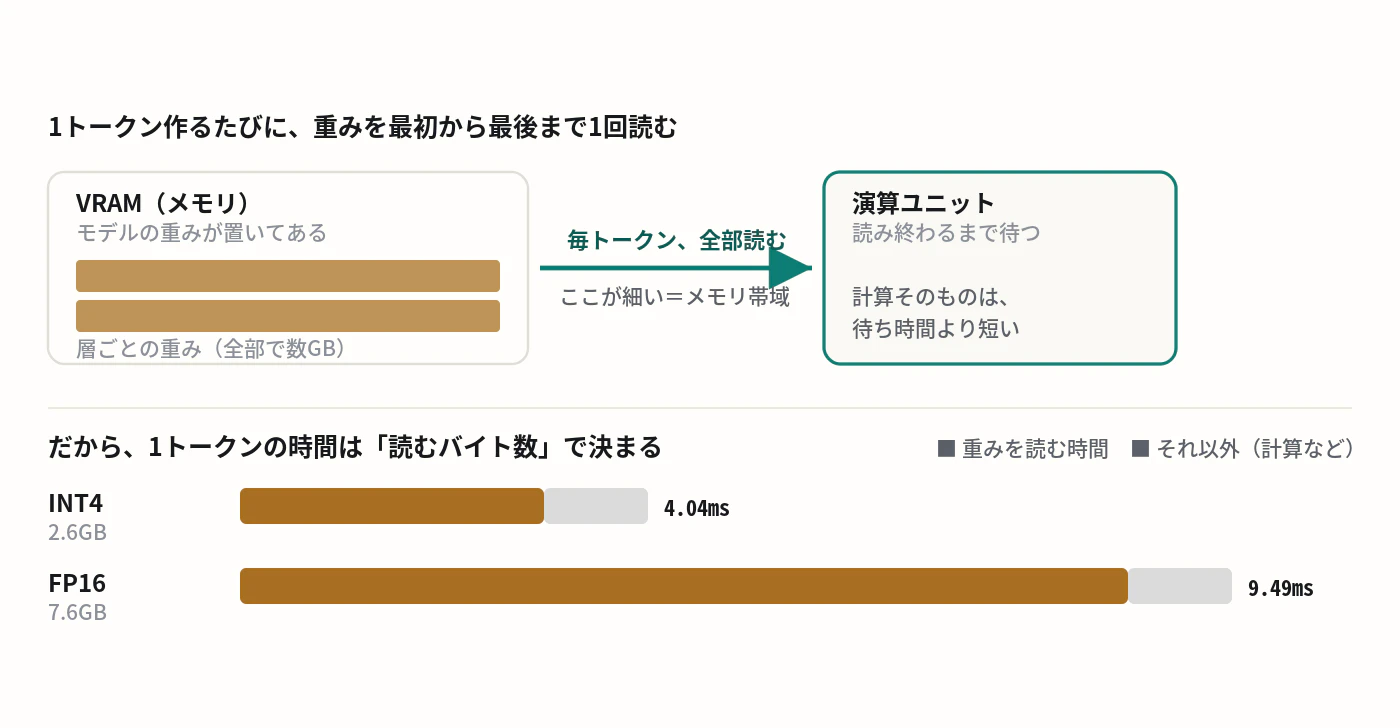
図2:なぜバイト数で決まるのか。1トークン作るたびに、VRAMに置かれた重みを最初から最後まで1回読み出す。演算ユニットは読み終わるのを待っている時間のほうが長く、律速しているのは計算力ではなくメモリ帯域だ。だから重みが 2.6GB(INT4)なら4.04ms、7.6GB(FP16)なら9.49ms——読む量に比例して時間が伸びる。
注:batch=1(一人分の生成)の場合。複数人をまとめて処理すると、1回の読み出しを分け合えるので事情が変わる。
同じ法則は、量子化のビット幅にもそのまま効く。ビット幅はバイト数だからだ。
| 精度 | 重みサイズ | 1トークンあたり | 対 FP16 |
|---|---|---|---|
| FP16 | 7.6GB | 9.49ms | 1.00x |
| INT8 | 4.3GB | 6.00ms | 1.58x |
| INT4 | 2.6GB | 4.04ms | 2.35x |
サイズ比は 2.92倍なのに実測は 2.35倍。差は、量子化されない部分(キャッシュや活性値の読み書き)が残るからだ。バイト数がすべてを決めるが、モデルの重み以外にも読み書きはある。
そして律速しているのがメモリ帯域である以上、GPU選定で見るべき数字も帯域になる。演算性能でもVRAM容量でもない。
測り方を1つ間違えると、2.35倍が消える
ここからが本題だ。同じモデル・同じGPUで、測り方だけを変えて3回測った。結果は3通りに割れた。
| 測り方 | FP16 | INT4 | 見え方 |
|---|---|---|---|
| 素の推論経路 | 40ms | 39ms | 横並び(差がない) |
| 推論サーバ(逐次実行) | 20.9ms | 22.2ms | 逆転(量子化すると遅い) |
| 推論サーバ(グラフ実行) | 9.49ms | 4.04ms | 2.35倍(正しい) |
1つ目は、高速な量子化カーネルが使われず、演算のほうが律速していた。2つ目は、1ステップごとの固定オーバーヘッドが支配して、そのうえ量子化の展開コストだけが乗った。3つ目でようやく、固定費が取り除かれて帯域律速の姿が出た。
量子化の速度は「高速カーネル × グラフ実行 × batch=1の帯域律速」が揃って、初めて現れる。 どれか1つ欠けると「効かない」どころか「逆効果」に見える。ベンチマークの数字を見るときは、この3つが揃っているかを先に確かめたほうがいい。
残課題:法則には、適用範囲がある
この法則は無条件ではない。外れる条件を2つ、実測で確認している。
1つ目は、複数人を同時にさばくとき。 生成をまとめて処理すると、1回の重み読み出しを複数のリクエストで分け合える。スループットは帯域で伸びるが、一人あたりの待ち時間はバイト数に比例したままだ。この記事の話は、あくまで「一人分の生成」の速さである。
2つ目は、重みが小さくなりすぎたとき。 小さいモデルを強く量子化して高速なGPUに載せると、重みの読み出しがあっという間に終わり、カーネル起動などの固定費のほうが支配的になる。実際、4B-INT4 は上位2世代のデータセンターGPUで 168 対 177 tok/s とほとんど差が出なかった——帯域は3.3倍あるのに、だ。同じ 8B-INT4 を一世代前のコンシューマGPUで測ると、4Bのちょうど半分の速さ(=素直に帯域律速)だった。
だから、GPUを跨いだ比較でこの法則を確かめてはいけない。片方が帯域律速、もう片方が固定費律速だと、同じ法則が成り立ったり成り立たなかったりする。
教訓
- 生成の速さは、パラメータ数でなく重みのバイト数で決まる。 4B-INT8 と 8B-INT4 はほぼ同速だった。だから「小さいモデル」でなく「軽いバイト数」で設計し、GPUは演算性能でなくメモリ帯域で選ぶ。
- 比較する前に、serving構成を揃える。 量子化カーネルとアダプタの扱いが違うだけで、2倍が1.3倍に化けた。差をモデルサイズに帰属させる前に、動かし方を揃える。
- 法則には適用範囲がある。 batch=1・帯域律速という前提を外れると、サイズも帯域も効かなくなる。GPUを跨いだ比較では、この前提ごと変わっていることを疑う。
これは マニフェストの1番目の原則——「まず計測せよ」——の、推論性能版だ。同じモデル・同じGPUでも、測り方ひとつで 2.35倍が「差なし」にも「逆転」にも見える。
付録:生データ
すべて batch=1(一人分の生成)の実測。TPOT=1トークンあたりの生成時間。
| 項目 | 実測 | 条件・留保 |
|---|---|---|
| バイト数と速度の単調性 | 4B-INT4 2.6GB / 4.04ms < 4B-INT8 4.0GB / 5.98ms ≈ 8B-INT4 4.3GB / 6.50ms < 4B-FP16 7.6GB / 9.49ms | 同一GPU・同じ量子化カーネル・アダプタはmerge済み。パラメータ数の順ではなくバイト数の順に単調 |
| パラメータ半減の効果 | 8B-INT4 76 tok/s → 4B-INT4 172 tok/s = 2.3倍 | 同一量子化・merge済みで揃えた場合。別GPUの 4B-INT4 166 tok/s とも整合 |
| 誤測(構成のズレ) | 4B を外付けアダプタ+別方式の量子化で serve → 91 tok/s = 8B比 1.24〜1.36倍 | 量子化カーネルの効率差+アダプタのオーバーヘッドの二重ハンデ。8B側も一部同条件のため非対称 |
| ビット幅の効果 | FP16 105 / INT8 167 / INT4 247 tok/s | サイズ比 2.92倍に対し実測 2.35倍。差は量子化されない読み書き(キャッシュ・活性値・埋め込み)とカーネル固定費 |
| 測り方の罠 | 素の経路 40 / 39ms(横並び)→ 逐次実行 20.9 / 22.2ms(逆転)→ グラフ実行 9.49 / 4.04ms(正) | 高速カーネル・グラフ実行・batch=1帯域律速が揃って初めて2.35倍が出る |
| 適用範囲の外(固定費律速) | 4B-INT4 は上位2世代のデータセンターGPUで 168 対 177 tok/s(帯域3.3倍でも無反応) | 重みが小さすぎてカーネル起動などの固定費が支配。8B-INT4 は一世代前のコンシューマGPUで素直に帯域律速 |
| 副産物 | 量子化方式を揃えたら、別言語の文字が混ざる不具合も消えた | 量子化スキームは速度だけでなく、出力の言語一貫性にも効くことがある |
シリーズ「モデル — 小さく、速く、賢く」第11回の記事です。原文と続きは LYR Performance Note #030 / 記事一覧 にあります。