
この記事は、自社ブログの LYR Performance Note #019 に掲載したものの転載です。
巨大モデルに真っ向勝負しない——1つのタスクに絞って磨けば、はるかに小さいモデルが引き分けにできる。ただしタダではない
約3分の1のサイズ(8B)が、現役最強クラス(27B)と引き分けた。ただし1つのタスク——Live字幕——に絞ったうえでの話だ。90→96で、教師と同点になった。
その引き分けには値札が付いていた。Liveを+6した代償に、PageとMangaが各−4崩れた。特化とは無料ランチではなく、配分の選択だ。
だから「特化するか」ではなく「どのモードを主戦場にし、他をどう扱うか」を先に決める必要がある。解消の道(混ぜ直し/モード別ルーティング/容量スケール)は、どれもコストの形が違う。
翻訳AIの世界には、暗黙の序列がある。パラメータが大きいほど賢い。だから最高品質が欲しければ、いちばん大きいモデルを使え——と。
LYRが本番で回している教師役のモデルは、270億パラメータ(27B)の汎用モデルだ。現役で最強クラスの一角。対して、LYRが自前で育てている専門家モデルは、その約3分の1、80億パラメータ(8B)しかない。
この8Bで、Live字幕——動画の下に流れる、1行ずつの字幕をリアルタイムに訳す仕事——を、どこまで押し上げられるか。それがこの記事の話だ。結論から言うと、8Bは27Bと引き分けた。だが、その引き分けには値札が付いていた。
思い込み——「小さいモデルは、大きいモデルに勝てない」
出発点の成績は、こうだった。Live字幕の「訳として通用する率」(overall=意味・自然さが実用に足る割合)を、モデル横並びで測る。
| モデル | Live | Page | Manga |
|---|---|---|---|
| 8B(汎用に磨いた版) | 90 | 93 | 92 |
| 27B(現役・教師) | 96 | 98 | 99 |
| Scout(前任) | 97 | 86 | 90 |
Liveで、8Bは90。27Bは96。6ポイントの差が開いていた。
素直に読めば「容量の差」に見える。8Bは器が小さいから、Liveの難所——慣用句や、主語の取り違え——を捌ききれない。ならば打ち手は一つ、モデルを大きくすることだ。そう考えたくなる。
だが、この6ポイントは本当に「容量の壁」なのか。それとも、磨き方の問題なのか。それを確かめずに大きいモデルへ走るのは、いちばん高い方向へ全力で走ることだ。まず、失敗の中身を見た。
計測——ギャップの正体は「容量」ではなかった
8BがLiveで落としている問題を1つずつ開くと、犯人は3種類だった。慣用句の直訳("isn't like you" を字面で訳す)、主語の取り違え、そして語の幻覚(元にない単語を足す)。
このうち慣用句と主語は、器の大きさの問題ではない。正しいお手本を十分な数だけ見せれば直る種類の間違いだ。つまり、8Bに足りなかったのは容量ではなく、Liveという仕事に特化した、質の高いお手本だったのではないか。
そこで二段構えで磨いた。
第一段:お手本を上質にする。 教師の27Bに、同じ一文をN通り訳させ、その中から品質推定(QE=訳文だけを見て良し悪しを自動採点する仕組み)で最良の1本を選ぶ。この「best-of-N QE」で選び抜いた訳を、8Bのお手本にする(→ AIに「正解より良い訳」を選ばせる)。慣用句と主語の教師データが、これで上質になる。
第二段:良い訳と悪い訳のペアで、選好を教える。 Live専用に「こちらの訳が良い/こちらが悪い」のペアを作り、CPO(良例・悪例の対比からモデルの好みを直接矯正する学習)で焼き込む。Liveのペアは良し悪しの差がくっきりしていて、学習の分離が最も強く効いた。
結果——
| モデル | Live | Page | Manga |
|---|---|---|---|
| 8B(汎用に磨いた版) | 90 | 93 | 92 |
| 8B(Live特化) | 96 | 89 | 88 |
| 27B(現役・教師) | 96 | 98 | 99 |
Liveは 90 → 96。27B(96)と同点、Scout(97)に肉薄した。 6ポイントの差は、ゼロになった。しかも語調の自然さ(register)も98で、27B級(99)を維持した。内訳を分けると、上質なお手本が+2、Live専用CPOが+4。ギャップを埋めたのは容量ではなく、Liveという1点への特化だった。
約3分の1のモデルが、現役最強と肩を並べた。ここで話が終われば、痛快な成功譚だ。だが、上の表には、見て見ぬふりのできない列がある。
特化はタダではない——それは「配分の選択」だ
Live特化版のPageとMangaを見てほしい。Page 93→89、Manga 92→88。どちらも−4、崩れている。
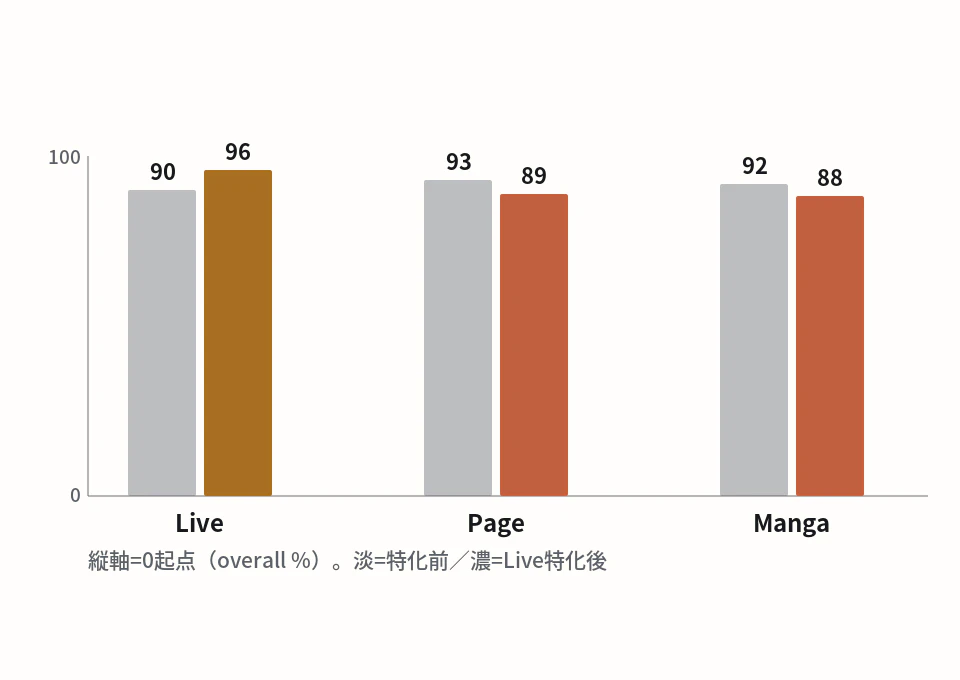
図1:Live特化の前後(3モードの overall %)。Liveは90→96へ上がるが、Page 93→89・Manga 92→88と逆側が下がる。ゼロ起点の縦軸で見ると3モードとも高水準に密集しており、変化は小さいが方向は逆だ。
注:縦軸はゼロ起点の overall %。同一評価セット上の点推定で、評価件数(n)は未記録。
Liveを+6する学習が、PageとMangaを−4引きずり下ろした。これは偶然の副作用ではない。8Bは1つのモデルで3モードを兼務していて、片方(Liveの1行ずつの単発字幕)に寄せると、塊でまとめ訳すPage/Mangaの分布が押しのけられる。同じ形の崩れ——regime shift(学習データの分布が片側に偏り、逆側のモードが崩れる現象)——を、Manga厚めのデータでも、文脈付きの学習でも繰り返し観測した。 モード混合そのものの機序と全数値は 一つのモードで測って満足しない に詳しい。本稿の Live 特化 −4 は、その一般則の一例だ。
だからLive 90→96は、正しくは「無から生まれた6ポイント」ではない。PageとMangaを削って、Liveに回した——配分の組み替えだ。しかも綺麗な等価交換ですらない(Live は+6、対してPage/Mangaは合わせて−8)。特化とは、無料ランチではない。限られた器の中で、どこに重みを置くかを選ぶこと。何かを上げたら、測っていないどこかが下がっている、と疑うのが正しい姿勢だ。
では、この−4をどう扱うか
トレードオフが見えれば、打ち手は「特化するか/しないか」の二択ではなくなる。配分を設計する問題になる。
- Live用データを一般データに混ぜ直して再学習する——単発を単発のまま足すのでなく、塊の分布を壊さない形で配合し、干渉を薄める。
- モードごとに機体を分ける——Liveは特化機、Page/Mangaは汎用機、と役割で切り替える。器を奪い合わせない。
- 容量を上げる——干渉を根本から消す唯一の無条件解はこれだが、それは「大きいほど賢い」の高い方向へ戻ることでもある。慣用句や主語のように磨けば直る問題を、いきなり容量で殴るのは、診断の放棄だ(一方、日本語の深い読解のように、そもそも器を要求する仕事もある——特化では届かない領域の見極めは いちばん苦手な言語で律速を見抜く に譲る)。
どれを選ぶにせよ、出発点は同じだった——ターゲットのモードだけを見て「勝った」と言わないこと。Liveの96だけを眺めていたら、PageとMangaの−4に気づかないまま「8Bが27Bに並んだ」と喧伝していただろう。それは事実の半分でしかない。
教訓
- 巨大モデルに真っ向勝負しなくていい。 汎用で270億に挑む代わりに、Live字幕という1点に80億を絞れば、成功率90→96で現役最強と引き分けにできる。器の約3分の1で、狙った一芸なら並べる。
- ただし特化は配分の選択で、無料ランチではない。 Liveを+6した同じ学習が、Page/Mangaを−4崩した。1つのモデルが複数の仕事を兼務する限り、上げた分は別のどこかを削って生まれている(しかも綺麗な等価交換とも限らない)。
- だから、狙った指標だけを見て勝敗を決めない。 特化の成否は、ターゲットの伸びと非ターゲットの犠牲を並べて初めて判定できる。片側だけの計測は、成功を偽装する。
付録:生データ
共通条件: 自前8Bモデル(270億の27B汎用モデルを教師とする蒸留系)。Live/Page/Manga の3モードを同一評価セットで横並び測定。数値は overall(=訳として実用に足る割合, %)/別掲は register(語調の自然さ, %)。判定は Claude(Max plan)による同一judgeラウンド。評価件数nは未記録=各%は点推定("示唆")として読む(有意水準での確定ではない。ただし−4の方向性は別モードの特化でも反復観測 → 一つのモードで測って満足しない)。
| 工程 | 内容 | 数量・条件 |
|---|---|---|
| L-1 | 8B(30k蒸留)をマージ | — |
| L-2 | Live追加SFT(best-of-N QEで選別したお手本で追加学習) | Live gold 522件、loss 0.34 / acc 0.95 |
| L-3 | Live-CPO(良例・悪例の対比で選好を直接矯正) | Liveペア 516件、rewards/acc 1.0=良悪の分離が最も明確 |
| L-4/L-5 | 評価 → judge | 同一評価セット・同一judgeラウンド |
主結果(overall / register, %, 同一セット):
| モデル | Live | Page | Manga |
|---|---|---|---|
| 8B-一般CPO | 90 / 100 | 93 / 98 | 92 / 98 |
| 8B-LiveSFT | 92 / 99 | 92 / 98 | 87 / 98 |
| 8B-LiveSFT+CPO | 96 / 98 | 89 / 100 | 88 / 100 |
| Scout(前任) | 97 / 98 | 86 / 91 | 90 / 96 |
| 27B(新・教師) | 96 / 99 | 98 / 100 | 99 / 100 |
| 論点 | 数字 | 条件・留保 |
|---|---|---|
| Live 90→96 | 27B(96)と同点、Scout(97)に肉薄 | 内訳=SFT-aug +2(慣用句/register改善)、Live-CPO +4(reweight)。register 98 は27B級(99)を維持 |
| 残存欠陥 | 語の幻覚は残る | 522件の小規模augの被覆外。慣用句/registerの改善が幻覚の残数を上回り overall 96 に到達 |
| トレードオフ | Page 93→89、Manga 92→88(各−4) | Live特化学習が学習分布をLive側へドリフトさせた |
モード混合の一般則(−4の regime shift、2026-07-14に3手で反復観測): Live特化に加え、Manga厚め・文脈付き学習でも同じ形の逆側劣化を観測。全数値と機序(entry-count/style の学習分布ドリフト)は 一つのモードで測って満足しない に委譲。本稿の Live 特化 −4 はその1手。
解消の方向: ①Liveデータを一般セットに分布を壊さず混ぜて再学習、②per-mode routing(Live=特化機/Page-Manga=汎用機)、③容量スケール(干渉を無条件に消す唯一解だが高コスト)。
シリーズ「モデル — 小さく、速く、賢く」第9回の記事です。原文と続きは LYR Performance Note #019 / 記事一覧 にあります。