
本記事は2025年12月5日時点の内容を元に作成しています。Strands Agentsは更新頻度が高く、今後の更新内容によっては記載と異なる部分が生じる可能性を考慮してください。
Strands Evals SDK
Strands Agentsに追加された評価を行うためのSDKです。re:Invent 2025で発表されたSDKで、LLM-as-a-Judgeを活用して評価するための仕組みが一通りそろっており、簡単にAIエージェントの評価を始めることが可能です。
今回はStrands Evals SDKを用いてAIエージェントの評価を試してみたいと思います。
Build-in Evaluator
LLM-as-a-Judgeでは、「どのように評価するか?」を設定するのが大変ですが、Strands Evals SDKでは事前に評価方法を設定したEvaluator(評価メトリクス)が定義されています。
下表はその一部です。提供されている評価メトリクス全体はこちら。
| 名称 | 概要 |
|---|---|
| OutputEvaluator | 自身が設定した評価基準に従い、AIエージェントの応答を評価する |
| TrajectoryEvaluatorLLM | AIエージェントの一連のツール利用が適切かを評価 |
| HelpfulnessEvaluator | ユーザー目線で、回答の有用性を7段階で評価 |
| GoalSuccessRateEvaluator | 会話全体を通して、ユーザーの目的が達成できたかをYes/Noで評価 |
| ToolSelectionAccuracyEvaluator | ある時点での利用ツールが適切かをYes/Noで評価 |
動かしてみる
セットアップ
今回はパッケージ管理にuvを利用します。ここからのコマンドはuv利用前提となっているので別のパッケージ管理ツールを利用される場合は置き換えてください。
まずプロジェクトを作成します。
uv init --python 3.13 agent-eval
次に必要なパッケージをインストールします。AIエージェントはStrands Agentsを用いて実装するため、Strands AgentsのパッケージとStrands Agent Evalsをインストールします。
cd agent-eval
uv add strands-agents strands-agents-tools strands-agents-evals
AIエージェントの実装
評価対象となるAIエージェントをStrands Agentsを用いて実装しましょう。
今回は四則演算を行う計算エージェントを作成します。計算エージェントは、足し算、引き算、掛け算、割り算の4つのツールを持ちます。こちらをuv initで作成されたmain.pyに記載します。
# main.py
from strands import Agent
from strands import tool

@tool
def add(a: int, b: int) -> int:
    """
    2つの整数を足し算して結果を返す
    Args:
        a: 第1の整数
        b: 第2の整数
    """
    return a + b

@tool
def sub(a: int, b: int) -> int:
    """
    第1の整数から第2の整数を引き算して結果を返す
    Args:
        a: 第1の整数
        b: 第2の整数
    """
    return a - b

@tool
def mul(a: int, b: int) -> int:
    """
    2つの整数を掛け算して結果を返す
    Args:
        a: 第1の整数
        b: 第2の整数
    """
    return a * b

@tool
def div(a: int, b: int) -> float:
    """
    第1の整数を第2の整数で割り算して結果を返す
    Args:
        a: 第1の整数
        b: 第2の整数
    """
    if b == 0:
        raise ZeroDivisionError("0で割ることはできません")
    return a / b

agent = Agent(
    name="計算エージェント",
    system_prompt="ツールを活用して、ユーザの質問に回答してください。結果だけ回答してください。",
    tools=[add, sub, mul, div],
    callback_handler=None,
)
AIエージェントの評価
先ほど実装したAIエージェントをStrands Evals SDKを使って評価してみます。EvaluatorはTrajectoryEvaluatorを用います
TrajectoryEvaluator
TrajectoryEvaluatorでは、AIエージェントのツール実行履歴を評価します。
AIエージェントがどのツールを、どの順序で使ったかは*軌跡(Trajectory)*と言います。このEvaluatorでは軌跡の妥当性を評価し、AIエージェントの行動選択の正確性を評価します。
どのように評価するか、評価スコアをどのように定義するかは自然言語で定義します。
軌跡評価を実現するために、3つのヘルパーツールが定義されています。評価方法を定義する際はこの3つのツールのうち、どれを使って評価するかを意識して記載するとよいでしょう。
| 名称 | 概要 |
|---|---|
| exact_match_scorer | 期待する軌跡とAIエージェントの軌跡が完全に一致するか確認する |
| in_order_match_scorer | 期待する軌跡が、順番通りに実施されたかを確認する(余分な行動があってもよい) |
| any_order_match_scorer | 期待する軌跡が、実施されたかを確認する(順序は気にしない) |
今回は、ツール利用の完全一致を確認したいため、以下のように定義します。
AIエージェントが期待した順番で抜け漏れなしにツールを利用して回答したか評価してください
期待する順番と異なっている、抜け漏れがある場合は失敗と判断してください
これをPythonコードで記載すると以下のようになります。
evaluator = TrajectoryEvaluator(
    rubric="""
    AIエージェントが期待した順番で抜け漏れなしにツールを利用して回答したか評価してください
    期待する順番と異なっている、抜け漏れがある場合は失敗と判断してください
    """,
    include_inputs=True
)
include_inputsはツールへの入力情報が正しさを評価するかを指定します。今回はTrueとしておきます。
テストケースの準備
ここまで評価対象となるAIエージェントと評価メトリクスを準備しました。
最後にテストケースを定義します。ここでのテストケースは「入力内容」「期待する軌跡」で構成されます。テストケース名やメタデータを付与して、管理しやすくすることもできます。
from strands_evals import Case

test_cases = [
    Case[str, str](
        name="calc trajectory evaluation",
        input="3 + 4 * 5 - 1 =",
        expected_trajectory=["mul", "add", "sub"],
    ),
]
AIエージェントへの入力は「3 + 4 * 5 - 1 =」とし、簡単な四則計算をするように記載しています。
期待する軌跡はexpected_trajectoryで指定します。今回は掛け算→足し算→引き算の順に実行することを正解としています。
AIエージェントの実行と結果の抽出
テストケースをもとに、AIエージェントを実行しその軌跡を抽出するためにget_response関数を定義します。軌跡抽出にはStrands Evals SDKが提供するヘルパー関数であるextract_agent_tools_used_from_messagesを使います。またextract_tools_descriptionも利用して、Evaluatorのツール説明の更新します。
get_response関数の定義は下記となります。
from strands_evals.extractors import tools_use_extractor

def get_response(case: Case) -> dict:
    response = agent(case.input)

    # Extract trajectory efficiently to prevent context overflow
    trajectory = tools_use_extractor.extract_agent_tools_used_from_messages(agent.messages)

    # Update evaluator with tool descriptions
    evaluator.update_trajectory_description(
        tools_use_extractor.extract_tools_description(agent, is_short=True)
    )

    return {"output": str(response), "trajectory": trajectory}
評価の実行
準備が整ったので、評価を実施しましょう。
テストケースとEvaluatorをまとめるExperimentを定義します。今回はテストケースもEvaluatorも1つずつしか定義していませんが、複数のテストケースを複数のEvaluatorで一度に評価することも可能です。
評価自体はrun_evaluations関数で実施します。
from strands_evals import  Experiment
experiment = Experiment[str, str](cases=test_cases, evaluators=[evaluator])
reports = experiment.run_evaluations(get_response)
reports[0].run_display()
Pythonスクリプトを実行しましょう。次のコマンドで実行できます。
uv run .\main.py
少し待つと実行結果が表示されます。
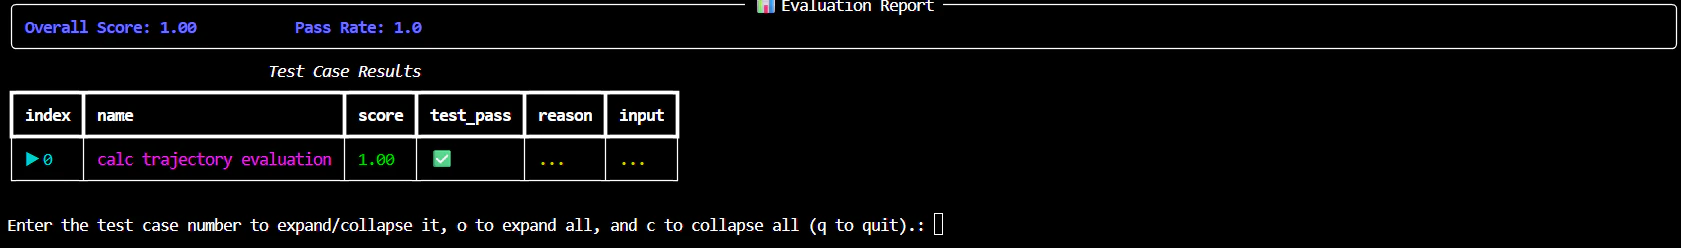
コンソール上から対話式で評価理由も確認できます。数字を入力してEnterキーを押すと対応するindexの評価詳細を、「o」を入力してEnterキーを押すと全結果の詳細を見られます。閉じる場合は「c」です。
実際に評価理由を表示した例が次の画像です。
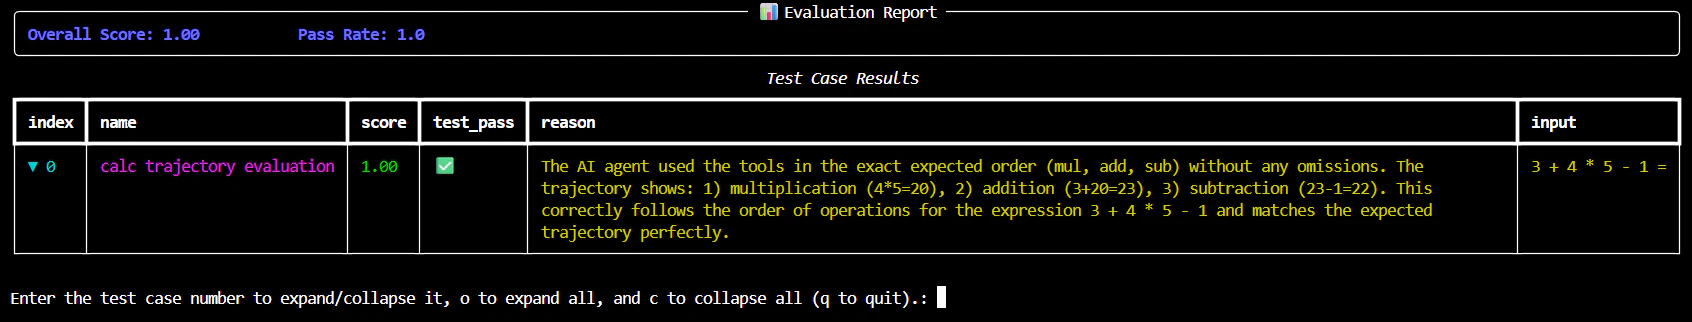
評価値が悪い場合は、この評価理由を確認することで改善に活かすことができます。
別のテストケースを試します。今回の入力「3 + 4 * 5 - 1 =」では掛け算を最初とする必要がありますが、計算自体は引き算→足し算の順でも変わりません(実際は左から右に、というルールがあったと思いますが)。
結果が変わらないため、少しひねくれて期待する軌跡を「掛け算→引き算→足し算」とします。
test_cases = [
    Case[str, str](
        name="calc trajectory evaluation",
        input="3 + 4 * 5 - 1 =",
        expected_trajectory=["mul", "sub", "add"],
    ),
]
再度実行します。
uv run .\main.py
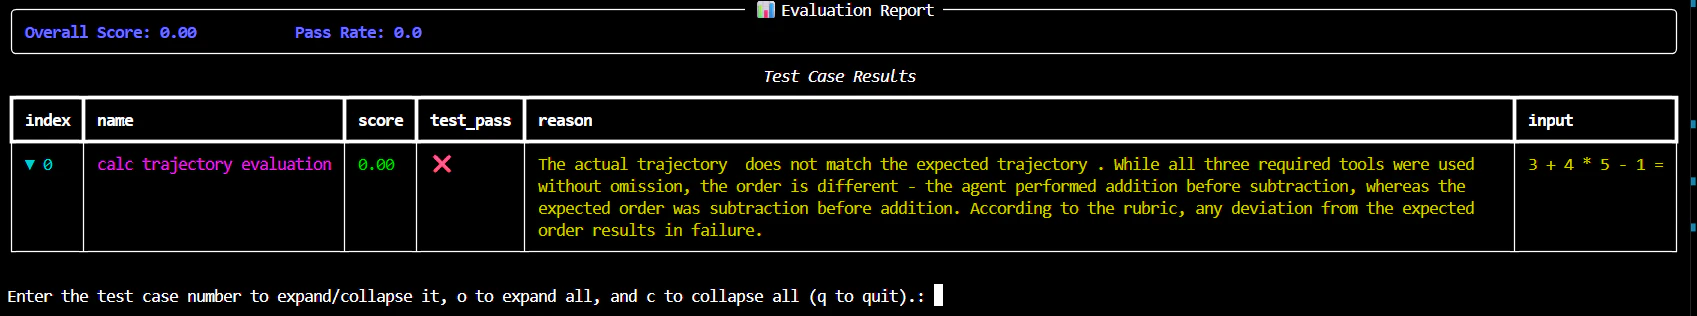
実行結果は以下のようになりました。AIエージェントの実行軌跡と期待する軌跡が一致しないため評価スコアは0となりました。
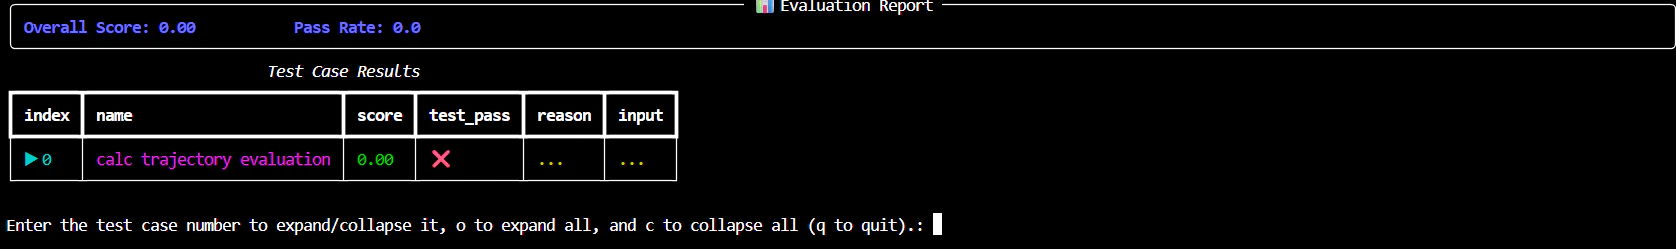
理由からも期待するツールが抜け漏れなく利用したが、順序が異なるため失敗と判断していることが分かります。
まとめ
今回はStrands Evals SDKでAIエージェントの軌跡評価を実施しました。Strands Evals SDKにはテストケース自動生成、評価基準であるルーブリック生成、Eval SOP、シミュレータなど評価するための様々な機能が備わっています。
盛りだくさんで詳細は確認できていませんが、今後も試していきたいと思います。