
はじめに
Amazon Textract(画像や PDF から文字・表を取り出す AWS の OCR サービス)に、2 つのアップデートが同時に来ました。
1 つは文字を読み取るモデルの更新で、日本語を含む 40 以上の言語に対応しました。
もう 1 つは東京リージョンへの展開です。
一方で「画像を読むだけなら Bedrock の生成 AI でもできるのでは」とも思ったので、同じ請求書を両方に読ませて比べてみました。
アップデートの内容
| 項目 | 内容 |
|---|---|
| モデルの更新 | 文字の検出(DetectDocumentText)と文書の分析(AnalyzeDocument)が対象。 API の変更は不要で、既存の呼び出しに自動で適用されます |
| 対応言語 | 日本語・中国語・韓国語・アラビア語などを含む 40 以上(対応言語の一覧。執筆時点では、一覧の表で DetectDocumentText が英語のみの区分に入ったままですが、実際に日本語を読めました) |
| 表の抽出 | 結合セル、傾いた・回転した表、一部が欠けた表の抽出精度が向上 |
| 新リージョン | 東京とチューリッヒ。 ただし請求書・領収書用の AnalyzeExpense、身分証用の AnalyzeId、ローン書類用の AnalyzeLending、カスタムクエリ(アダプター)は未対応 |
東京で使えるのは「文字の検出」と「文書の分析(表・フォーム・レイアウトなど)」の同期 API と非同期 API です。
ただし日本語に対応しているのは表・署名・レイアウトで、フォーム(項目名と値のペア)とクエリ(質問して値を取り出す機能)は日本語に対応していません。
請求書専用の AnalyzeExpense は英語の請求書向けの機能なので、日本語の請求書なら今回試す AnalyzeDocument の表抽出を使うことになりそうです。
やってみた
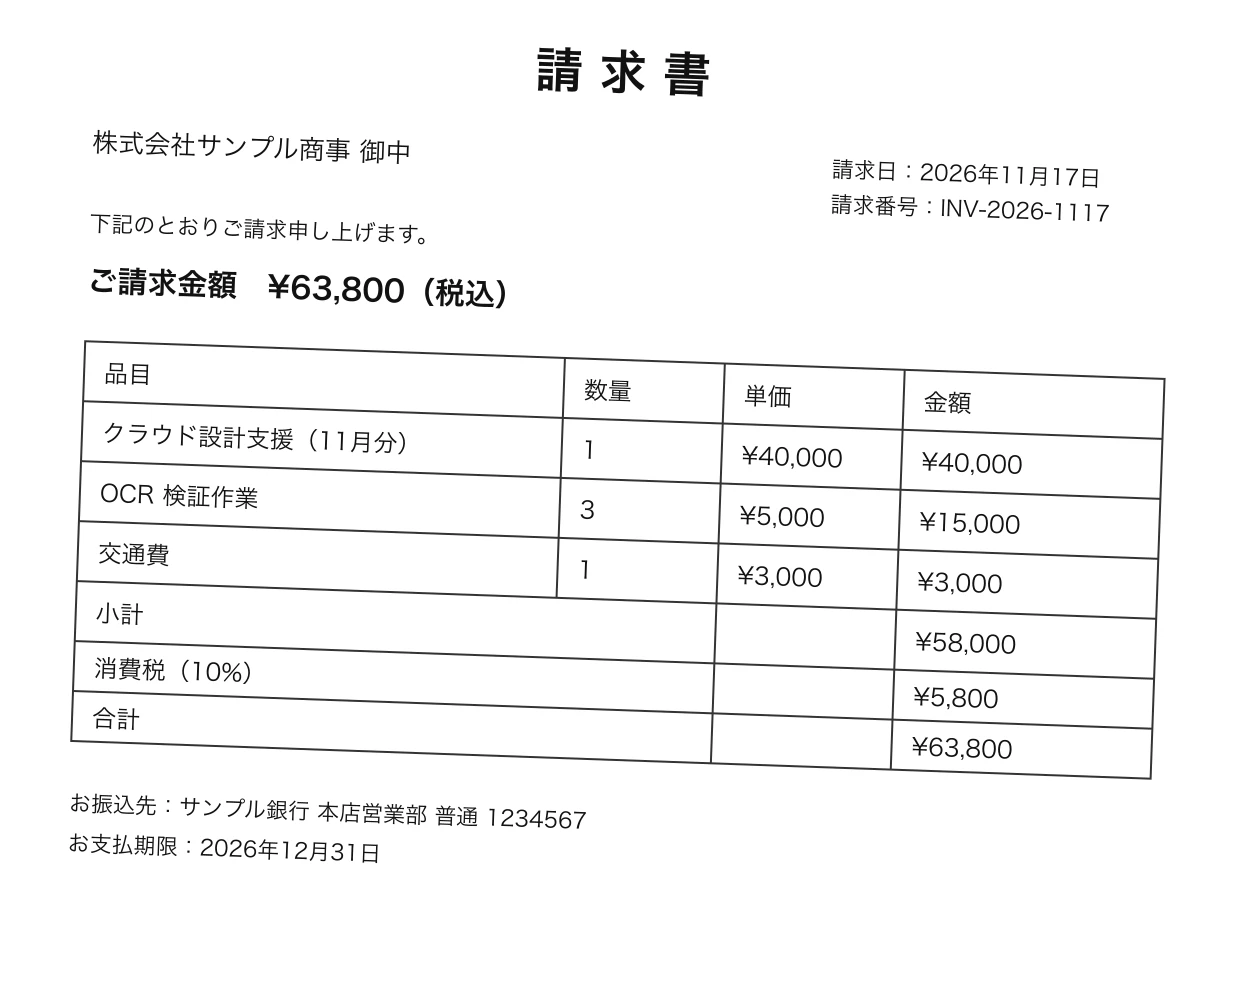
テスト用に、架空の請求書の画像を用意しました。表全体を 2 度傾け、「小計」「消費税」「合計」の行は品目と数量の列をまたぐ結合セルにしています。
手順 1: 文字を読み取る(DetectDocumentText)
文字の検出(DetectDocumentText)で、1 行ずつのテキストと信頼度を取り出します。信頼度は 0〜100 の範囲で、低いほど読み違えの可能性が高くなります。
aws textract detect-document-text \
  --region ap-northeast-1 \
  --document "Bytes=$(base64 -i invoice.png)" \
  --query "Blocks[?BlockType=='LINE'].[Text, Confidence]" \
  --output text
請求書	99.96014404296875
株式会社サンプル商事 御中	99.86048889160156
請求日: 2026年11月17日	96.67171478271484
...
クラウド設計支援 (11月分)	99.54161834716797
]	60.943878173828125
...
日本語の文字はすべて正しく読めました。誤りは数量の「1」を「]」と読んだ 2 か所だけで、その 2 か所は信頼度が 60 前後と低く出ていました(他の行は 96〜100)。
信頼度でしきい値を決めれば、人の確認に回す行を機械的に選べそうです。
手順 2: 表を取り出す(AnalyzeDocument TABLES)
結合セルを、何行目・何列目から何列分つながっているかで出してみます。
aws textract analyze-document \
  --region ap-northeast-1 \
  --feature-types TABLES \
  --document "Bytes=$(base64 -i invoice.png)" \
  --query "Blocks[?BlockType=='MERGED_CELL'].[RowIndex, ColumnIndex, ColumnSpan]" \
  --output text
5	1	2
6	1	2
7	1	2
傾いた表でも 4 列 × 7 行として取れ、5〜7 行目(小計・消費税・合計)の 1 列目から 2 列分の結合も正しく認識されました。
セルの中身を並べ直すと次のとおりです(数量の「1」の読み違いは手順 1 と同じです)。
| 行 | 品目 | 数量 | 単価 | 金額 |
|---|---|---|---|---|
| 2 | クラウド設計支援 (11月分) | ] | ¥40,000 | ¥40,000 |
| 3 | OCR 検証作業 | 3 | ¥5,000 | ¥15,000 |
| 5 | 小計(2 列結合) | ¥58,000 | ||
| 7 | 合計(2 列結合) | ¥63,800 |
手順 3: 同じ画像を Bedrock(Nova 2 Lite)に読ませる
Bedrock の Converse API(モデル共通の呼び出し API)に、画像と「1 行ずつそのまま書き起こして」という指示を渡します。
IMG=$(base64 -i invoice.png)

cat > msg.json <<EOF
[{"role":"user","content":[{"image":{"format":"png","source":{"bytes":"$IMG"}}},{"text":"この画像に書かれている文字を、上から順に 1 行ずつそのまま書き起こしてください。書き起こし以外は出力しないでください。"}]}]
EOF

aws bedrock-runtime converse \
  --region ap-northeast-1 \
  --model-id jp.amazon.nova-2-lite-v1:0 \
  --messages file://msg.json \
  --inference-config maxTokens=1000,temperature=0 \
  --query "output.message.content[0].text" \
  --output text
数量の「1」は正しく読めた一方で、それらしい別の言葉に置き換わる誤りが 5 か所ありました。
| 画像の文字 | Textract | Nova 2 Lite |
|---|---|---|
| クラウド設計支援 | クラウド設計支援 | クラウド設定支援 |
| INV-2026-1117 | INV-2026-1117 | INV-2026-11117 |
| 下記のとおりご請求 | 下記のとおりご請求 | 下記のとおりで請求 |
| 本店営業部 | 本店営業部 | 本店当行口座 |
| 普通 1234567 | 普通 1234567 | 番通 1234567 |
| 数量の 1 | ](信頼度 60) | 1 |
生成 AI の読み違いは信頼度が付かず、自然な日本語になってしまうので、出力だけ見ても気づきにくいのが気になるところです。
Textract と Bedrock の使い分け
東京リージョンのオンデマンド単価(Price List API で取得、100 万ページまで)で比べると次のとおりです。
| Textract | Bedrock Nova 2 Lite | |
|---|---|---|
| 1 ページの料金 | 文字の検出 $0.0015、表の抽出 $0.015 | 今回は約 $0.0007(入力約 300・出力約 190 トークン) |
| 返ってくるもの | 文字、位置(座標)、信頼度、表の行・列 | 指示した形式のテキスト |
| 今回の誤り | 2 か所(数量の 1 → ]、どちらも信頼度 60 前後) | 5 か所(もっともらしい書き換え) |
| 得意なこと | 原本どおりの書き起こし、帳票の数値の取り込み | 要約や「金額だけ JSON で」のような加工 |
金額や口座番号のように 1 文字の誤りも許されない書類は Textract、読んだ内容をそのまま要約・分類したいなら Bedrock、という分け方が良さそうです。
両方を組み合わせて、Textract で取り出したテキストを Bedrock に渡す構成も考えられます。
なお Bedrock には、書類から文字や表を取り出す専用の Bedrock Data Automation もあり、東京でも 1 ページ $0.01(標準出力)で使えます。
注意点
- 手書き文字: 対応は英語のみで、日本語の手書きは対象外のようです(FAQ)。
-
CLI でのファイル渡し:
fileb://は通らず、base64で文字列にして渡す必要がありました(5 MB まで)。 - 東京で使えない API: AnalyzeExpense / AnalyzeId / AnalyzeLending / アダプターは、引き続き対応リージョンで使う必要があります。
まとめ
日本語の書類を東京リージョンだけで Textract に読ませられるようになりました。傾いた表や結合セルも崩れずに取れ、読み違えた文字には低い信頼度が付くので、帳票の取り込みには安心して使えそうです。