
背景
2026年中盤現在、提唱されているRAG(Retrieval-Augmented Generation)アーキテクチャが山ほどあり、手法や複雑さの観点でも選択肢が多くて、どれがいいのかわからなくなることはありませんか?今回は、オープンソースのRAGソリューションとして有力な「RAGFlow」を改めて触ってみたので、少し共有します。
アーキテクチャ選定の一つの指標として、「EnterpriseRAG-Bench」というリーダーボードを見てみました。

上位の顔ぶれを確認すると、以下のような状況です。
- 1位: OpenClaw - こちらはRAGアーキテクチャというよりも完全にエージェントとしての性質が強いため、自分の研究対象からは外しました。
- 2位: OpenAI File Search - 非常に強力ですが、オンラインサービスゆえに様々な制限があり、細かなカスタマイズもできないため、こちらも除外です。
- 3位: RAGFlow - 4位以降もオンラインサービスが多い中、オープンソースソリューションとして堂々の上位に食い込んでいます。
この結果を見て、「オープンソースで選ぶならRAGFlow一択なのでは?」と感じました。
RAGFlow自体は2024年からリリースされています。当時の自分にとって一番印象的だったのは、PDFの中の表構造のデータもうまく認識でき、さらにOCR機能などともシームレスに統合されている点で、「かなり強いツールだな」と感じていました。それから1〜2年が経ち、さらに強力な機能が追加されていると思うので、今更ながらまたやってみることにしました。
やってみる
セットアップ
セットアップは非常に簡単です。リポジトリをcloneして、以下のコマンドを実行するだけです。
docker compose -f docker/docker-compose-base.yml up -d
1点注意してほしいのは、このコマンド1回で複数のコンテナが同時に起動されるため、マシンのリソースには少し余裕を持たせておいたほうが良いです。
無事に起動したら、ブラウザから http://localhost にアクセスすることで、RAGFlowの画面が開きます。
PDFインポートと抽出テスト
早速PDFをインポートして試してみました。
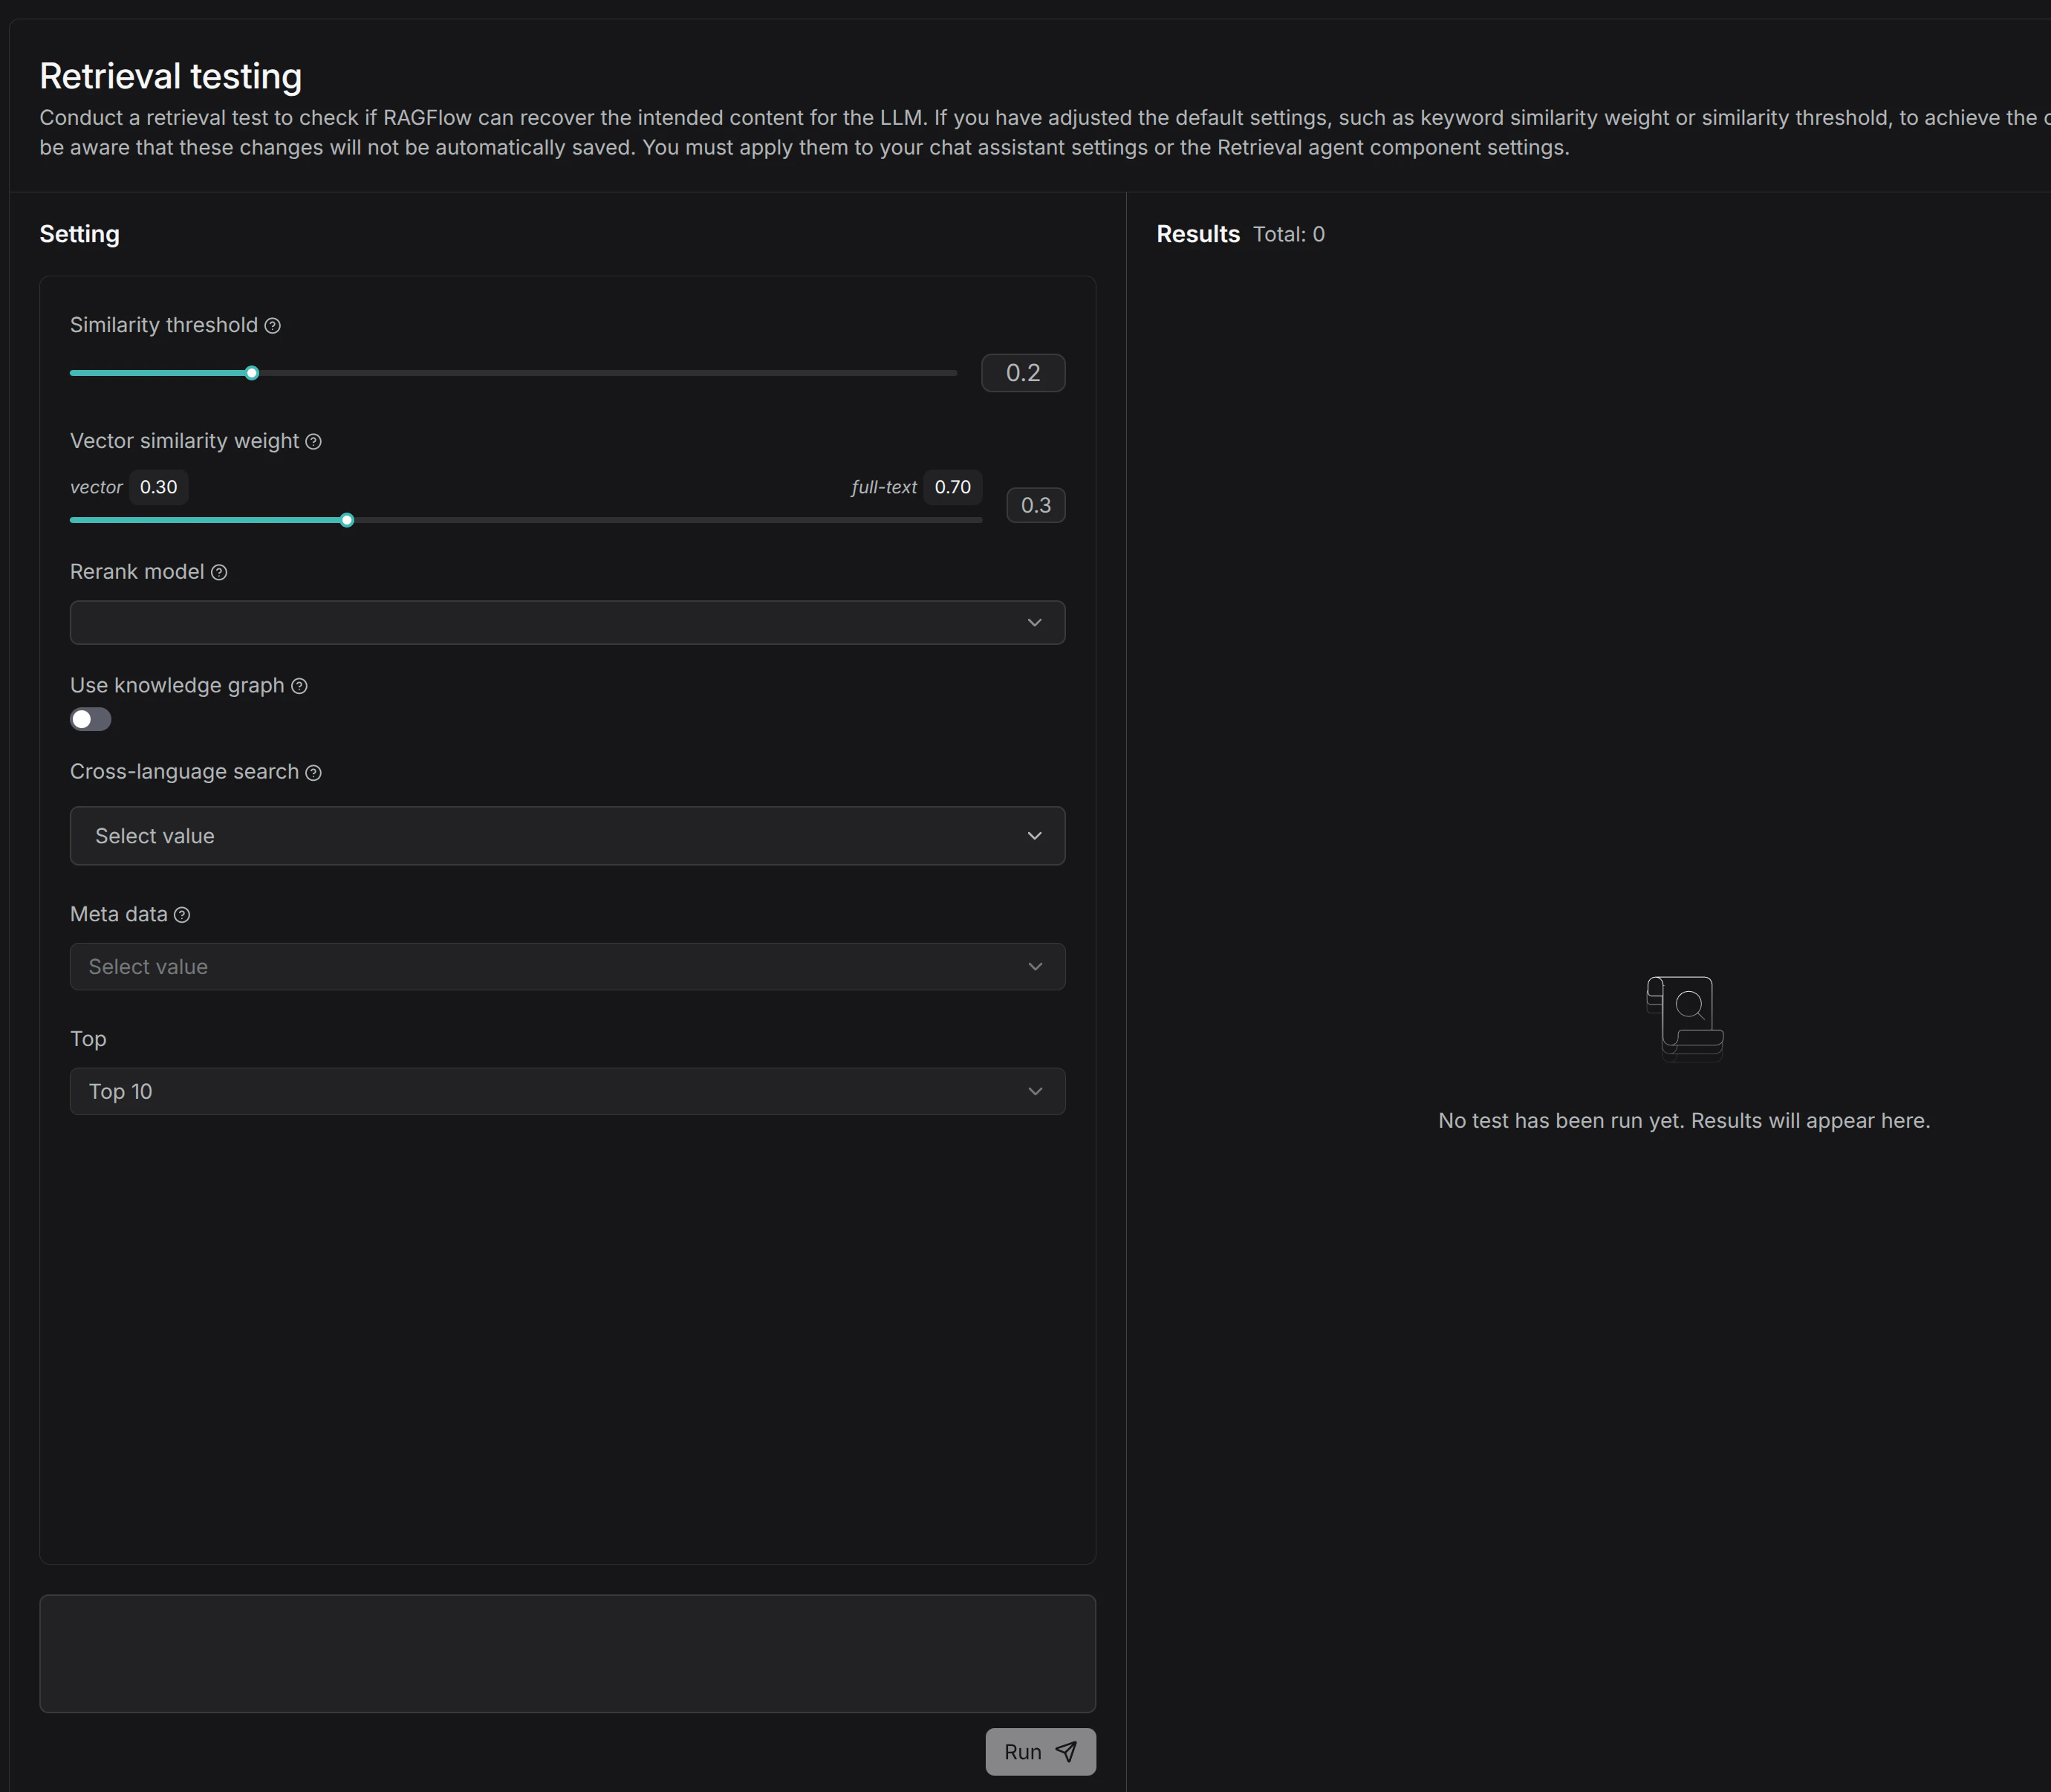
個人的に一番気になっていて便利だと思ったのは、抽出のテスト機能です。画面上でパラメータをいじりながら、すぐに抽出結果をプレビューして確認できるので、思い通りのデータ化ができているかどうかのPDCAが高速で回せます。
Langfuse連携
もう1つ重要なポイントがあります。やはりRAGやエージェントを本格的に組むとなると、ある程度のObservability(可観測性)が必要不可欠です。どんなコンテキストが抽出され、LLMがどう推論したかを追跡できないと、その後の改善策が考えにくいからです。
RAGFlowでは、設定画面でエンドポイントとAPIキーを入力するだけで、「Langfuse」との連携が簡単にできます。

もちろんLangfuseの機能自体はRAGFlowの中に組み込まれているわけではないため、ローカルで動かす場合は別のDockerコンテナを建てる必要がありますが、UIからサクッと統合できるのは非常にありがたい設計だと思います。
サマリー
今回はセットアップと基本的な動作確認のみなので、実際の検索精度や回答精度の検証は簡単にできず、まだなんとも言えません。ただ、セットアップの手軽さや抽出のプレビュー機能、そしてObservabilityへの配慮など、実践的なツールとしてかなり進化していると感じました。
まずは触ってみた段階ですが、今後はパラメーターの調整や、実際のファイルを使った精度チューニングなど、いろいろ探索していこうと思います。