
前回、猛暑の中で年代物のGPUを連続運転することを躊躇していましたが、少し涼しい日が続くとの予報が出たので再学習を最後までまわしました。
データセットのスクリーニング
涼しくなるのを待っている間、人力でデータセットのスクリーニングを行いました。
学習に不適な文字の削除
- 書き損じの訂正箇所を削除して行を分割(例1)
- 分割後の行が短い場合(おおむね2文字以下)は単に削除(例2)
- 人が判読可能な程度のなぞり書きはそのまま(例3、4)
| 例1 削除して分割 |
例2 削除 |
例3、4 削除しない |
|---|---|---|
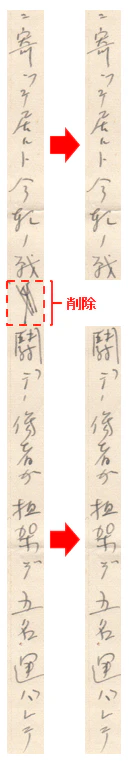 |
 |
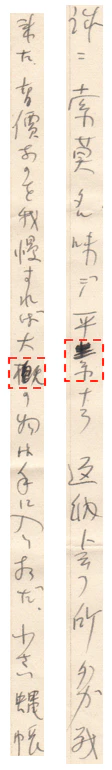 |
行の出力順不正への対応
NDL古典籍OCRから出力される行の並び順が不正な場合があります。前回の「カタカナ混じりの例」がそれで、6行目と7行目が逆順で出力されます。(下記画像参照。赤字が行番号)
1行データセットの画像と翻刻テキストの対応を入れ替えて対処しました。
データセット全体で並び順の不正はこの1件だけであり、まれな事象のようです。並び順が保証されない仕様なのか、レイアウト認識処理の問題なのかは未確認です。

このほか、未判読文字が含まれてデータセットから除外していた中に読めた(翻刻できた)ものがいくつかあり復活させました。
一連の作業の結果、1行データセットの件数は学習用409、評価用221になりました。
再学習、認識結果の比較
ローカル環境のGTX 1070で実行し4日と11時間かかりました。CERとLossの推移グラフは以下の通りです。
CERが前回より小さくなったのは、主に上記の「行の出力順不正への対応」が効いたのではないかと思います。(当該データは評価用に分配されている)

epochが100を超えたあたりからLossがサチってCERが漸増との推移です。
以下の5セットの文字列認識モデルの認識結果を比較してみました。
- CER最小 → A、B、C
- Lossが収束した中でCERが極小 → D
- (せっかく最後までまわしたので参考用に)CER最大 → E
| epoch | Loss | CER | 文字列認識モデル |
|---|---|---|---|
| 17 | 2.14E-01 | 0.25% | A |
| 22 | 1.49E-01 | 0.25% | B |
| 42 | 9.56E-02 | 0.25% | C |
| 118 | 1.59E-02 | 0.51% | D |
| 261 | 1.13E-02 | 4.80% | E |
カタカナ混じりの例(評価用に分配)
| $0$ | 画像 | 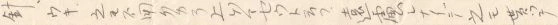 |
| 翻刻 | 針ウキ之モ不用ダカラ上ゲマセウト云フ遠慮シナイデ之モ貰ッテ | |
| A | 針ウキ之モ不甲ダカラ上ゲイ七ウト云フ遠慮シナイデ之モ貰ッテ | |
| B | 針ウキ之モ不甲ダカラ上ゲイ七ウト云フ遠慮シナイデ之モ貰ッテ | |
| C | 針ウキ之モゟ甲ダカラ上ゲモウト云フ遠慮シナイデ之モ貰ッテ | |
| D | 釘ヲケテ之モノダカラ上ゲテセウト云フ遠慮シナイデ之モ貰ッテ | |
| E | 貰ッタラヨイト之モニハ甲ダカラ之デはせウト云フ遠慮シナイデ之モ植ッテ | |
| $1$ | 画像 | 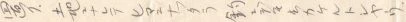 |
| 翻刻 | 置ク土地ニナレテヒマニナッタラ釣ニデモ出カケルトシヤウ | |
| A | 置ク土地ニナレテヒマニナッタラ釣ニデモ出カケルトシヤウ | |
| B | 置ク土地ニナレテヒマニナッタラ釣ンデモ出カケルトシヤウ | |
| C | 置イテ土地ニナレテヒマスナッタラ鉄ンデモ出カケルト云ヘバ | |
| D | 置イ土地ニナレテヒマニナッタラ鉄ニデモ出カケルトシヤウ | |
| E | 置イテ土地ニナレテヒマスナッタラ鉄ンデモ出カケルト云ヘバ | |
| $2$ | 画像 |  |
| 翻刻 | 二十七日 | |
| A | 二十七日 | |
| B | 二十七日 | |
| C | 二十七日 | |
| D | 二十七日 | |
| E | 二十七日 | |
| $3$ | 画像 |  |
| 翻刻 | 今日ハ又部隊長ノ随行デ先日行ッタ右ノ方ノ戦線ヘ行ク此ノ前ヨリモ | |
| A | 今日ハ又同様土ノ道行デ先日行ッタ右ノ方ノ戦線ヘ行ク此ノ前ヨリモ | |
| B | 今日ハ又同様セノ適行デ先日行ッタ右ノ方ノ戦線ヘ行ク此ノ前ヨリモ | |
| C | 十二日ハ又勿論等ノ適行デ先日待ッタ右ノ方ノ戦跡ハ行ク此ノ前ノモ | |
| D | 今日ハ又同様セノ適行デ先日行ッタ右ノ方ノ戦線ヘ行ク此ノ前ノモ | |
| E | 十二日ハ又勿論等ノ適行デ先日待ッタ右ノ方ノ戦跡ハ行ク此ノ前ノモ | |
| $4$ | 画像 |  |
| 翻刻 | モ一ツモノモノシイ護衛ノ下ニ望遠鏡デ見レバ敵兵ノ見ヘル所迄行ッタ | |
| A | モ一ツモノモノニイ護街ノ下ニ望遠鏡デ見レバ道具ノ見ヘル所迄何ッタ | |
| B | モ一ツモノモノナルイ護街ノ下ニ望遠鏡デセレバ這留ノ見ヘル所迄行ッタ | |
| C | ノ屋根ヲツケタモノダレーキ術ノ下ニ沿ヒ黄鏡デ見ルハ適具ノ見廻シテ | |
| D | モノモのモノでイ護街ノ下ニ盛鏡デ見レバ適足ノ見ヘル所迄行ッタ | |
| E | ノ屋根ヲツケタモノダレーキ術ノ下ニ沿ヒ黄鏡デ見ルハ適具ノ見廻シテ | |
| $5$ | 画像 |  |
| 翻刻 | ホントノ第一線ノ苦労ヲツクヅク気ノ毒ニ思フ一寸サガッテ野戦病院 | |
| A | ホントノ第一線ノ苦労タソク余ノ毒ニ思フ一寸サガッテ野戦痛体 | |
| B | ボントノ戸一統ノ苦労タソク気ノ書ニ思フ一寸サガッテ野戦病体 | |
| C | 一々手紙の苦労スワカズ気ノ毒思フ一寸サガッテ野戦病気 | |
| D | ホルトノ第一線ノ苦労タツク茶ノ毒ニ思フ一寸サガッテ野戦痛体 | |
| E | 一々手紙の苦労スワカズ気ノ毒思フ一寸サガッテ野戦病気 | |
| $6$ | 画像 |  |
| 翻刻 | 来タ一人重傷ガ居ル誠ニ御気ノ毒デアル | |
| A | 来タ一人筆侍ガ居ル誠ニ御兵米ノ毒デアル | |
| B | 来タ一人筆侍ガ居ル誠ニ御参詣毒デス | |
| C | 来タ一人乗済ガ居ル誠ニ御無事ノ事デアル | |
| D | 来タ一人筆約ガ居ル誠ニ御兵米ノ事デス | |
| E | 来タ一人乗済ガ居ル誠ニ御無事ノ事デアル | |
| $7$ | 画像 |  |
| 翻刻 | ニ寄ッテ居ルト今朝ノ戦闘デノ傷者ガ担架デ五名運バレテ | |
| A | ニ寄ッテ居ルト今朝ノ戦聞隊デノ傍者ガ租楽デ五名運バレテ | |
| B | ニ寄ッテ居ルト今朝ノ戦聞隊デノ傍者ガ租楽デ五名運バレテ | |
| C | ノ兵隊サン達ニハ今朝ノ戦ミ時デハ待着ガ植祭デ五名運バンデ | |
| D | ニ寄ッテ居ルト今朝ノ戦待デノ傍着ガ相楽デ五名運バレテ | |
| E | ノ兵隊サン達ニハ今朝ノ戦ミ時デハ待着ガ植祭デ五名運バンデ | |
| $8$ | 画像 |  |
| 翻刻 | 夕方カラ雨ニナッタノデ大変ニ涼シクナッタ嬉シヤ今夜ハヨク | |
| A | 夕方カラ雨ニナツタノデ大変ニ臨ムシクナッタ嬉シヤ今夜ハヨウ | |
| B | 夕方カラ雨ニナッタノデ大変ニ涼シクナック快シヤ今夜ハヨリ | |
| C | タカラナラ雨ニナラナカッタノデ大変ニ痛シタナッタ積シヤガ今夜ハ廻 | |
| D | 夕方カラ雨ニナツタノデ大変ニ臨ッシラナッタ快シヤヤ今夜ハナラ | |
| E | タカラナラ雨ニナラナカッタノデ大変ニ痛シタナッタ積シヤガ今夜ハ廻 | |
| $9$ | 画像 |  |
| 翻刻 | ムネレルゾ | |
| A | ムオレルブ | |
| B | ム亦レルプ | |
| C | ムネレルブ | |
| D | ひだレルプ | |
| E | ムネレルブ | |
| $10$ | 画像 |  |
| 翻刻 | 二十八日 | |
| A | 二十一日 | |
| B | 二十一日 | |
| C | 二十一日 | |
| D | 二十一日 | |
| E | 二十一日 | |
| $11$ | 画像 |  |
| 翻刻 | 伍長殿ニ依頼サレテ小サナ国旗ノ一端ニ一筆達筆ヲ振フ | |
| A | 但長殿ニ依頼サレテ小サ十国旗ノ一端ニ一季達ヲ事ヲ振フ | |
| B | 但長殿ニ依頼サレテ小サナ国旗ノ一端ニ一番達ヲ挙テ振フ | |
| C | ノ兵隊サン達ニ小サンノ小サナ固旗ハ一騎ニ一筆達ヲ振リ | |
| D | 但長殿ニ依頼サレテ小サ十回接ノ一端ニ一番達ヲ車ヲ振テ | |
| E | ノ兵隊サン達ニ小サンノ小サナ固旗ハ一騎ニ一筆達ヲ振リ | |
| $12$ | 画像 |  |
| 翻刻 | 二十九日 | |
| A | 二十九日 | |
| B | 二十九日 | |
| C | 二十九日 | |
| D | 二十九日 | |
| E | 二十九日 | |
| $13$ | 画像 | 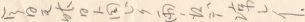 |
| 翻刻 | 今日モ昨日ト同ジク雨ノ後デ涼シイ | |
| A | 今日モ昨日ト同じク雨ノ後デシ | |
| B | 今日モ昨日ト同じク雨ノ後デ涼シイ | |
| C | 夕方モ昨日ト同じク雨ノ後デシイ | |
| D | 今日モ昨日ト同じク雨ノ後デシイ | |
| E | 夕方モ昨日ト同じク雨ノ後デシイ |
ひらがな混じりの例(評価用に分配)
| $0$ | 画像 |  |
| 翻刻 | 七月七日 | |
| A | 七月七日 | |
| B | 七月七日 | |
| C | 七月七日 | |
| D | 七月七日 | |
| E | 七月七日 | |
| $1$ | 画像 |  |
| 翻刻 | 午後南昌市内一帯の飲食店の衛生状況視察に出かける勿論自動 | |
| A | 午後南昌第四節の飲食店の衛生状祝祝察に出かける勿論自勤 | |
| B | 午後南昌慶一郎の飲食店の衛生状祝祝察に出かける勿論自勤 | |
| C | 午後南昌筆の飲食居の街生状祝察に出かける勿論自勤 | |
| D | 年後南昌慶一郎の飲食居の街生状祝祝楽に出かける勿論自勤 | |
| E | 十月五日は南昌慶一年の飲食居のは状況祝楽に出がける勿論 | |
| $2$ | 画像 |  |
| 翻刻 | 車で沢山の御供をつれてついでに他の店の状況まで視察する洗濯 | |
| A | 車で沢山の御供をつれてついでに他の店の状況まで祝楽する洗濯 | |
| B | 車で沢山の御供をつれてついでに他の店の状況まで祝楽する洗濯 | |
| C | 車で沢山の御供をつれてついでに他の店の状況まで視察するので | |
| D | 車で沢山の御供をつれてついです他の店の快況まで船楽する沈み | |
| E | をつけて沢山の御供をつれてついです他の広の鉄堤まで頑楽するもの | |
| $3$ | 画像 | 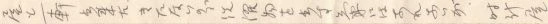 |
| 翻刻 | 屋も一軒出来たきたないので洗濯物を出す気にはなれないが時計屋 | |
| A | 屋も一軒出来たきたほいので洗物を出す気にはなれない時計尾 | |
| B | 屋も一軒出来たきたないので洗濯物を出す気にはなれないが時計尾 | |
| C | 屋も一軒出来たきたないので混物を出す気にはなれないが時分屋 | |
| D | 尾も一軒出来たきたないので沈物を出す気にはなれない時部屋 | |
| E | 居たが遂に一街出来たほいので混物を出す気にはなれない時分を | |
| $4$ | 画像 | 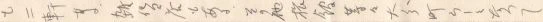 |
| 翻刻 | も二軒ある雑貨店もあるその他旅館等々大分町らしくなって | |
| A | も二軒ある観音店もあるその袖旅館等々大分町らしくなって | |
| B | も二軒ある朝代官もあるその袖旅館等々大分町らしくなって | |
| C | も二軒ある鯛仕間店もあるその袖旅館等々大分町らしてなって | |
| D | も二軒ある報諧喰もあるその他旅館等々大分町らくなって | |
| E | も二軒ある報化元もあるその他旅館等々大分時らくなって | |
| $5$ | 画像 |  |
| 翻刻 | 来た高価なのを我慢すれば大概の物は手に入り相だ小さい蝿帳 | |
| A | 来た有便なのを我慢すれば大概の物は手に入り相だ小さい蝋帳 | |
| B | 来た高価なのを我慢すれば大概の物は手に入り相だ小さい煉帳 | |
| C | 来た高便なのを我慢すれば大概の物は手に入り相だ小さい煉帳 | |
| D | まだに高便なのを我慢すれば大概の物は手に入り相だ小さい帳 | |
| E | が出来た間便なのを我慢すれば大概の物は手に入り相だ小きい様でせ | |
| $6$ | 画像 | 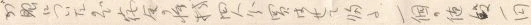 |
| 翻刻 | が眼についたので宿舎の将校四人分買はせて帰る一個の値段一円 | |
| A | が既についたので宿舎の将校四人分買はせて帰る一個の値酸一円 | |
| B | が既についたので宿舎の将校四人分買はせて帰る一個の随殿一同 | |
| C | が既についたので宿全の将校四人分買はせて帰る一の値一同 | |
| D | で外についたので宿全の将校四分買はせて帰る一の値毀一円 | |
| E | 中にはいたので宿舎の将校四人分買はせて帰る一の価毀して | |
| $7$ | 画像 | 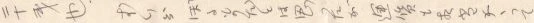 |
| 翻刻 | 二十銭也ずい分ぼるものだとは思ったが運賃も相当かかって | |
| A | 二十銭やずい分ぼるものだとは思ったが運鎮も相当かって | |
| B | 二十銭やずいだほるものだとは思ったが運賃も相当からて | |
| C | 二十銭也ずい分ぼるものだとは思った運賃も相当がって | |
| D | 二十銭也ずい分ぼるものだとは思ったが運賃も相当がて | |
| E | 二十銭や一寸いかほるものだとは思ったが遅晴も相当が下さい | |
| $8$ | 画像 |  |
| 翻刻 | 居る事だらうと仕方なしに我慢するでもお蔭で食事 | |
| A | 居る事だらうと仕方なしに我慢するでお蔭で食事 | |
| B | 居る事だらうと仕方なしに我慢するでもお蔭で食事 | |
| C | 居る事だらうと仕方なしに我慢するでもお蔭で食事 | |
| D | 居る事だらうと仕方なしに我慢するでお蔭で食事 | |
| E | 居る事だらうと仕方なしに我饅するでも前蔭で食事 | |
| $9$ | 画像 |  |
| 翻刻 | が安心して出来る有難い | |
| A | が安心して出来る有越い | |
| B | が安心して出来る有越い | |
| C | か安心して出来る有越い | |
| D | が安心して出来る有難い | |
| E | か安心して出来る有難い | |
| $10$ | 画像 |  |
| 翻刻 | 夕方から南の入道雲がぐんぐんのび上って遂に大雷雨の襲 | |
| A | 夕方かしい南の入道書がぐみぐのび上って遂に大雷雨の襲 | |
| B | 夕方かしい南の入道書がぐめぐのび上って遂に大雷雨の襲 | |
| C | 夕方かしら南の入道書がぐめぐのび上って遂に大雷雨の襲 | |
| D | 五方かしら南の入道書がぐめぐのび上って遂に大雷雨の襲 | |
| E | が出来たりかへて南の入道書がつめびたって遂に大雨の襲 | |
| $11$ | 画像 |  |
| 翻刻 | 来となったお蔭で涼しいしかしおそろしい程のすごさだ | |
| A | 来となったお蔭で集しいしかしおそろしい程のまごさだ | |
| B | 来となったお蔭で写しいしかしおそろしい程のまごさだ | |
| C | 来てなったお蔭でしいしかしおそろしい程のすごさだ | |
| D | 来たとなったお蔭で写しいしかしおそろしい程のまごた | |
| E | あるとなったお蔭で写しい之かしおそろしく程のまごた | |
| $12$ | 画像 | 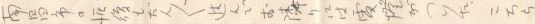 |
| 翻刻 | 南昌市の恢復もだんだん進んでお隣りには電燈がついたこちら | |
| A | 南昌市の復もだん進んでお隣りには震燈がっいたこちら | |
| B | 南昌市の復もだん進んでお隣りには処屋がついたこちら | |
| C | 南昌市の復もだん進んでお隣りには処焼がついたごちら | |
| D | 南昌市の復もだんで延んでお隣りには処焼がついたごちら | |
| E | にして見ると第十一信は頓とだんで延んでお請りには震動がついたごたして | |
| $13$ | 画像 |  |
| 翻刻 | は近く宿換引越する事になったのでつけて貰へないチェッ | |
| A | は近く宿換引越する事になったのでつけて貰へないチはッ | |
| B | は近く宿換引越する事になったのでつけて貰へないチはッ | |
| C | は近く宿換に引越する事になったのでつけて貰へない | |
| D | にして見ると宿換で引越する事になったのでつけて貰へない | |
| E | にして見ると煉は引越する事になったのでつけて貰へない |
従来のOCRでは距離値や尤度などの指標が学習の収束判断に用いられていましたが、それらにかわるものとしてLossやCERが利用できることを期待してモデルCやDが最善ではないかと予想しましたがそうはなりませんでした。Lossが最小のCよりもAやBのほうが翻刻文との文字単位の対応が良く、翻刻作業の支援用途に適しています。
従来のOCRでは学習の反復により(過学習が生じない限り)汎化が進んで良質な辞書が生成される(未学習データに対し高い性能が得られる)との経験則がありましたが、どうやらこのような古典的な捉え方はAI OCRには通用しないようです。また、CERは文字切り出しの機能を含まない個別文字認識OCRには有用な性能指標ですが、文字列認識OCRには不向きなのではないかと感じました。
ソースコード等
文字列認識モデルの再学習に用いたプログラム(src/text_kotenseki_recognition/train.py)の、リリース版との差分は以下の通りです。
- 1行データセットは、人手により訓練データとテストデータに分配して別々のフォルダに格納する(train_test_split関数による自動分配はしない)
- GeForce GTX 1070(RAM 8GB)で実行するため、BATCH_SIZEを24から20に変更
52,53c52,54
< ONE_LINE_DATASET_DIRECTORY="/root/honkoku_oneline/"
< PRETRAIN_MODEL=None
---
> ONE_LINE_DATASET_TRAIN="/shared/ndl/ndlkotenocr_cli/oneline_tb_train/"
> ONE_LINE_DATASET_TEST="/shared/ndl/ndlkotenocr_cli/oneline_tb_test/"
> #PRETRAIN_MODEL=None
55,57c56,58
< #PRETRAIN_MODEL="/root/kotenocr_cli/src/text_kotenseki_recognition/model-ver2/kotenseki-trocr-honkoku-ver2/"
< OUTPUT_DIR="/root/kotenocr_cli/src/text_kotenseki_recognition/"
< BATCH_SIZE=24
---
> PRETRAIN_MODEL="/root/kotenocr_cli/src/text_kotenseki_recognition/model-ver2/kotenseki-trocr-honkoku-ver2/"
> OUTPUT_DIR="/shared/ndl/ndlkotenocr_cli/out1/"
> BATCH_SIZE=20
64,66c65,67
<     inputfpathlist=[]
<     textlist=[]
<     for inputimgpath in tqdm(glob.glob(os.path.join(ONE_LINE_DATASET_DIRECTORY,"*"))):
---
>     inputfpathlist0=[]
>     textlist0=[]
>     for inputimgpath in tqdm(glob.glob(os.path.join(ONE_LINE_DATASET_TRAIN,"*.jpg"))):
70,72c71,73
<             inputfpathlist.append(inputimgpath)
<             textlist.append(text.replace("\n",""))
<     print(len(textlist))
---
>             inputfpathlist0.append(inputimgpath)
>             textlist0.append(text.replace("\n",""))
>     train_df=pd.DataFrame({"file_path":inputfpathlist0,"text":textlist0})
74,77c75,86
<     df=pd.DataFrame({"file_path":inputfpathlist,"text":textlist})
<     train_df, test_df = train_test_split(df, test_size=0.1,random_state=777)
<     train_df.reset_index(drop=True, inplace=True)
<     test_df.reset_index(drop=True, inplace=True)
---
>     inputfpathlist1=[]
>     textlist1=[]
>     for inputimgpath in tqdm(glob.glob(os.path.join(ONE_LINE_DATASET_TEST,"*.jpg"))):
>         inputtxtpath=inputimgpath.replace(".jpg",".txt")
>         with open(inputtxtpath,"r") as f:
>             text=f.read()
>             inputfpathlist1.append(inputimgpath)
>             textlist1.append(text.replace("\n",""))
>     test_df=pd.DataFrame({"file_path":inputfpathlist1,"text":textlist1})
>
>     print(train_df)
>     print(test_df)
1行データセットの作成には、OCR学習用データセット(みんなで翻刻) に同梱されているsrc/makeonelinedataset.pyをベースに、プレインテキストの翻刻データとNDL古典籍OCRの出力のjsonを入力出来るようにした以下のプログラムを用いました。
※jsonの行情報はプレインテキスト翻刻データと対応するものとします(しないと実行エラーになったりします...)
import sys
import os
import glob
import cv2
import json
if __name__ == '__main__':
    args = sys.argv

    outputdir = "oneline"
    os.makedirs(outputdir, exist_ok=True)
    for imgfilepath in glob.glob(os.path.join("img", "*.png")):
        print(imgfilepath)
        jsonfilepath = imgfilepath.replace("img", "json")
        jsonfilepath = jsonfilepath.replace(".png", ".json")
        print(jsonfilepath)
        txtfilepath = imgfilepath.replace("img", "txt")
        txtfilepath = txtfilepath.replace(".png", ".txt")
        print(txtfilepath)
        img = cv2.imread(imgfilepath)
        with open(jsonfilepath, "r", encoding="utf-8") as jsonfile_open:
            jsonfile_load = json.load(jsonfile_open)
            with open(txtfilepath, "r", encoding="utf-8") as rf:
                intext_lines = rf.readlines()
            for lines in jsonfile_load:
                for index, line in enumerate(lines):
                    print(index)
                    xmin = line[0]
                    ymin = line[1]
                    xmax = line[2]
                    ymax = line[3]
                    outtext = line[4]
                    outputimgpath = os.path.join(outputdir, "{}_{}.jpg".format(
                        os.path.basename(imgfilepath).split(".")[0],index))
                    outputtxtpath = outputimgpath.replace(".jpg", ".txt")
                    print(outputimgpath)
                    print(outputtxtpath)
                    cv2.imwrite(outputimgpath, img[ymin:ymax, xmin:xmax])
                    with open(outputtxtpath, "w", encoding="utf-8") as wf:
                        wf.write(intext_lines[index])