
ご先祖様の古い手紙を読んでみたいのですが、草書で書かれていて読めません。
幸い、国会図書館からNDL古典籍OCRというのが公開されていて試してみました。
従来のOCR技術では歯が立たなかったような対象がそこそこ読めたので感動しました。
良い時代になったものです。
NDL古典籍OCRについて
LinuxのDockerコンテナが公開されています。
DockerやLinuxについての知見が必要です。導入手順は明記されています。
ローカル環境の場合、GPUは必要ですが「NVIDIA DriverがLinuxの場合450.36.06以上、Windowsの場合520.06以上」とだけ書かれていて、古い低スペックのもので大丈夫だと思います。
古典研究者にDockerコンテナやGPUは敷居が高いということのようで、手軽に使えるNDL古典籍OCR-Liteが公開されました。
こちらはGPU不要でzipファイルを展開しexeを実行するだけ(インストール不要)で、簡単に使うことができます。
試した対象
とっかかりがないと、正しく読めたのかわかりません。
たまたま、ふりがながふられた手紙があり、ひとまずこれを対象にしました。

- 昭和19年4月13日付(前月病死した『御尊父』の葬儀に参列できなかったことへのお詫び)
- A4サイズ 150dpiで4回にわけてスキャンし、画像をつなぎあわせた
- 個人情報が書かれた行は削除
ちなみにふりがなは、手紙の受取人が家族に手紙を読ませるために書き込んだもので、正確さを期したものではありませんが、とても参考になりました。(もしなければ、そもそもこのような取り組みに至らなかったと思います)
ふりがなを元に(頑張って)翻刻しました。
謹啓
過日は御尊父様御病気
之為遂に御逝去被遊御
愁傷之亟に御座候其節は
差支ありて御伺いもふ致失
礼に打過ぎ爾後御訪問
申し上度存じな乍次々御
無沙汰にて申し訳なき次第
御容赦之程御願申し上候
実はこの冬は寒さの為臥って
仕舞い何方様へも不義
理を重ね居る有様にてふ
本意の亟に御座候右餘り遅
延致しては茲に乍略儀粗
状を以て御弔詞申し上度の儀に
御座候尚昨今気候殊に
ふ順の折柄皆様御用心被
遊度願上候敬具
追而甚だ失礼と覚え乍同
封の小為替御香料の印
迄に御受納被下度願上候
手作業でふりがなを消した画像を作成しました。

認識結果
以下はNDL古典籍OCR-Lite(v1.4.3)によるレイアウト認識結果(jsonの座標値)を入力画像上にプロットしたものです。
各行の外接矩形が上下方向に拡張されるようですが、先頭行は拡張しすぎてY座標が不正(-2)になっています。

以下はNDL古典籍OCR(ver.3)によるレイアウト認識結果です。
こちらは、外接矩形の上下拡張はないようです。

以下は、翻刻文と文字列認識結果を行ごとに並べたものです。右から翻刻文、NDL古典籍OCR-Lite、NDL古典籍OCRです。
NDL古典籍OCR-Liteは外接矩形を拡張したことによると思われる不正文字の混入(行頭の『一』)があります。先頭行の破綻はY座標不正によるものと思われます。

「F値の中央値は0.92程度」とのことですが、この手紙については少し苦戦気味でした。原因としては、古典籍OCRの学習対象は江戸期以前の古典籍資料が主体であるのに対し、こちらは明治以降、日常的にはペンなどの筆記具を用いていた人による筆づかいの傾向の相違などがあるように思います。古典籍にはあまりなさそうな『同封の小為替』や二重敬語的な『申し上度の儀に御座候』は読めておらず、特に内容を理解する上でカギになる『寒さの為臥って』などが読めていないのがつらいです。
再学習
NDL古典籍OCRでは、再学習のプログラムと手順もあわせて公開されています。
手紙の一部分、たかだか数行を(頑張って)翻刻することで、転移学習により「うちの手紙」用ファインチューニングが出来るといいなと思い、無茶を承知で文字列認識モデルの再学習を試みました。
まず、再学習対象の1行データセットを準備します。1行データは、1行分の画像を切り出したjpegファイルと、それに対応する翻刻文のテキストファイルのペアです。
1行データセットはscikit-learnのtrain_test_split関数により訓練データとテストデータへランダムに分割されますが、今回は非常に少ないデータセットで再学習しようとするので任意にコントロールして分割する必要があり、train_test_split関数は使わず訓練データとテストデータを別々のフォルダに格納するようにプログラムを修正し、行No. 0, 7~20をテストデータに設定しました。
なお、datasetsは2.2.1から2.21.0に更新する必要がありました。
以下は2行分(行No. 1, 2)だけを訓練データにした場合のCER(文字誤り率)とLoss(損失関数)の推移グラフです。さすがに少なすぎたようです。
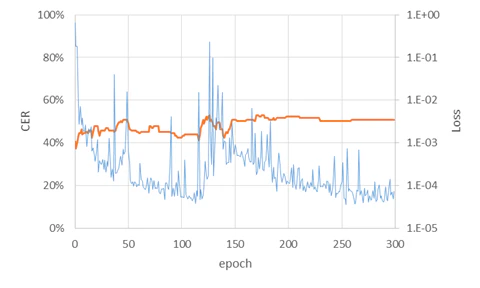
以下は4行分(行No. 1~4)を訓練データにした場合です。
CERはダメですが、Lossはそれらしい形になりました。

訓練データを6行分に増やしてもCERの傾向はあまり変わりませんでした。
そこで、訓練データ4行分でepoch数299の文字列認識モデルを用いて、手紙全体を認識させてみました。右から翻刻文、再学習なし、再学習ありです。
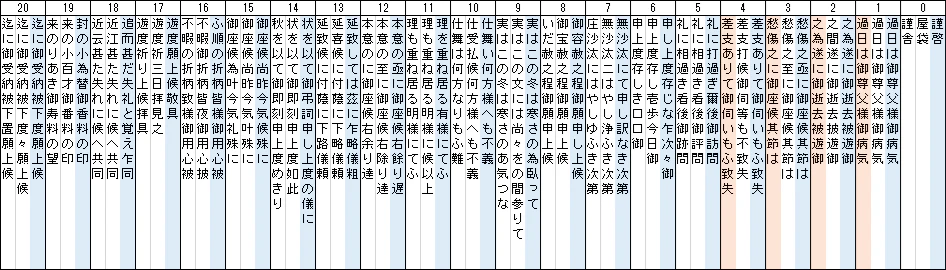
行No. 4が改善したのは再学習に用いたからと思われます。再学習に用いなかった行は一進一退(?)ですが、大幅な悪化はありませんでした。
引き続きいろいろ試してみたいと思います。