
はじめに:AI活用のボトルネックは技術ではない
ここ1〜2年、「AIを業務に導入したい」という相談を社内外で受ける機会が増えた。
要件を聞いて、プロンプトを設計して、RAGを組んで、デモを作る。技術的に「動くもの」を見せるところまでは、正直そこまで時間はかからない。ChatGPTのAPIを叩いて、それっぽいプロトタイプを作ること自体は、もはや特別なスキルではなくなっている。
しかし、そこから先——「本番運用」に至るプロジェクトが驚くほど少ない。
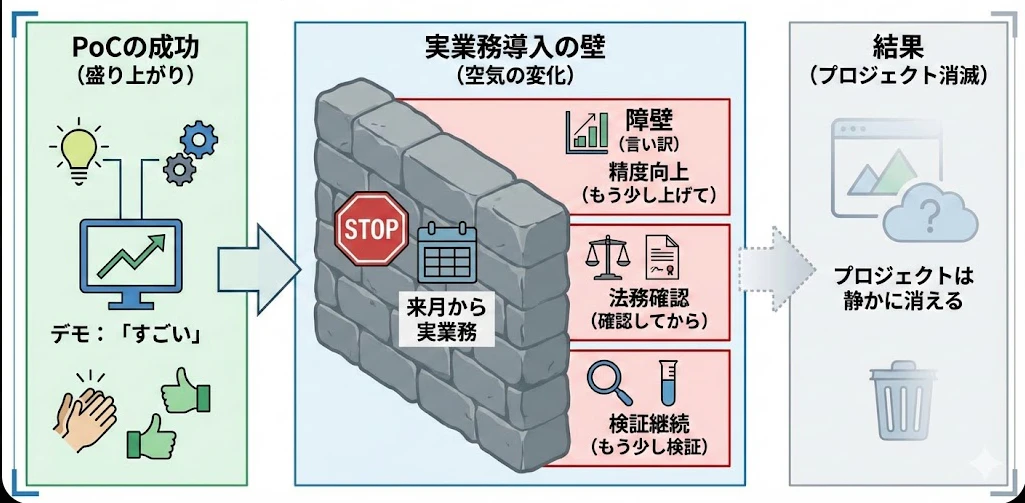
PoCは盛り上がる。デモを見せると「すごい」と言ってもらえる。
だが、いざ「じゃあ来月から実業務で使いましょう」という段になると、途端に空気が変わる。
「精度をもう少し上げてから」「法務に確認してから」「もう少し検証してから」。
こうしているうちに、プロジェクトは静かに消えていく。
何度かこの経験を繰り返して、ようやく気づいた。止まる理由はいつも同じだった。
「これ、使っていいんですか?」に、誰も答えられない。
技術の問題ではない。意思決定の問題だ。
AIは確率論である——再現性が担保されない世界
なぜ「使っていいんですか?」という問いが生まれるのか。その根本には、AIと従来のシステム開発の決定的な違いがある。
従来のシステム開発は、突き詰めれば if文の世界 だ。入力Aに対して出力Bが返る。もし想定外の出力が返ったら、それは「バグ」であり、コードを修正すれば直る。テストを書いて、期待値と一致することを確認すれば、品質は担保される。この世界では「100%正しく動くこと」がゴールであり、そのゴールは到達可能だ。
一方、LLMをベースにしたAIは 確率の世界 で動いている。同じプロンプトを投げても、出力は毎回微妙に異なる。temperatureを0に設定しても完全一致は保証されない。それは不具合ではなく、仕組みとしてそうなっている。次に出力するトークンを確率的に選択するというアーキテクチャそのものが、再現性を構造的に担保しないのだ。
よくある誤解として「プロンプトを工夫すれば精度100%になる」というものがあるが、これは原理的に難しい。プロンプトエンジニアリングやRAGは精度を上げる手段であって、不確実性をゼロにする手段ではない。
この「確率の世界」という性質を理解しないまま導入を進めると、必ずどこかで壁にぶつかる。「100%正しい出力」を前提にした業務フローにAIは組み込めない。そして多くの組織では、業務フローはまさに「100%正しいこと」を前提に設計されている。
ここにギャップがある。
「5%のハルシネーションを許容できるか」は技術の問いではなく経営の問い
もちろん、精度を上げる技術的努力には意味がある。95%を96%に、96%を97%にする工夫は重要だし、エンジニアとしてそこを追求するのは当然のことだ。
だが、もっと手前に、もっと大きな問いがある。
「95%の精度で、この業務に使うかどうか」を誰が決めるのか。
この問いに答えるのは、技術者の仕事ではない。それは事業判断であり、リスクの許容であり、つまるところ 経営の意思決定 だ。
「もし残りの5%で間違った出力が出て、それが顧客に届いたらどうするのか」「間違いが起きたとき、誰が責任を取るのか」「そもそもこの業務は、どの程度の間違いまでなら許容できるのか」。これらはプロンプトの書き方では解決しない問題だ。
そして、この意思決定がなされないことこそが、AI活用が進まない最大のボトルネックだと感じている。技術的には使えるのに、「使っていいかどうか」が決まらない。PoCフォルダだけが増えていく。
活用がうまくいったチームは「許容ライン」を先に決めていた
ここまで書くと「結局、組織の問題でしょう」で終わりそうだが、実際にうまくいっているチームもある。
あるチームでは、AI導入を検討する段階で、技術検証よりも先に 「用途ごとの許容ライン」 を明文化していた。具体的にはこんなルールだ。
| 用途 | AIの利用 | 運用ルール |
|---|---|---|
| 社外に出す文書(提案書・契約書等) | 禁止 | — |
| 社内ドキュメント(議事録・日報等) | AIドラフトOK | ファクトチェックは人間が行う |
| カスタマーサポートの一次回答 | AIに委任 | confidence scoreが低いものは人間にエスカレーション |
このテーブルを見て「当たり前じゃないか」と思う人もいるかもしれない。しかし、これを 技術検証の前に 、マネージャーが意思決定して明文化していたことが決定的に重要だった。
このチームのPoCから本番運用までの移行は、驚くほどスムーズだった。エンジニアは「許容ラインの範囲内で精度を最大化する」ことに集中できた。曖昧な要件を追いかける必要がなく、「社内文書ならここまでの品質でOK」「サポートならconfidence score 0.8以上は自動回答」と、明確なゴールラインがあったからだ。
逆に、この判断を後回しにしたチームは、「精度がもう少し上がったら本番に入れましょう」というループに入った。「もう少し」の基準が誰にもわからないので、永遠にPoCが終わらない。技術者が精度を1%上げるたびに「まだ足りない気がする」と言われる。足りないのは精度ではなく、判断だった。
ポイントは「AIの精度を上げてから許容ラインを決める」のではなく、「許容ラインを決めてから、その範囲でAIを使う」という順番にあった。
なぜこの意思決定は難しいのか
では、なぜ多くの組織でこの意思決定がなされないのか。
一番大きいのは、「不確実なものを業務に組み込む」という判断に前例がない ことだと思う。
従来のシステム導入は、要件定義書があり、テスト仕様書があり、「要件を満たしているか」のYes/Noで判断できた。合格ラインは明確で、達成すればリリースできる。この意思決定モデルに、組織は慣れている。
ところがAIは「だいたい合ってるけど、たまに間違える」という性質を持つ。この"たまに"をどう扱うか、既存の判断フレームワークにはない。稟議書のフォーマットにも「許容ハルシネーション率」という欄はない。
加えて、組織内での役割分担にも構造的な問題がある。経営層はAIの技術的特性を十分に理解していないことが多く、「精度100%にしてから持ってきて」と言いがちだ。一方、現場のエンジニアはAIの限界を理解しているが、「この精度で業務に使います」という意思決定権を持っていない。
結果として、技術がわかる人には決定権がなく、決定権がある人には技術がわからない、という空白地帯が生まれる。AI活用が停滞するのは、多くの場合この空白地帯においてだ。
エンジニアにできること——「問いの立て方」を変える
「組織の問題だから、エンジニアにはどうしようもない」——そう思いたくなる気持ちはわかる。しかし、実はエンジニアの側からできることは少なくない。
一つ目は、問いの立て方を変えることだ。
「精度95%です」と報告するのではなく、「この精度でこの業務に使った場合、100件中5件は間違った要約が生成されます。最悪のケースでは、社内会議の決定事項が誤って記録される可能性があります。それでも導入しますか?」と問う。技術の言葉をリスクの言葉に翻訳することで、意思決定者が判断できる材料に変わる。
二つ目は、小さく始めることだ。
いきなり基幹業務に導入しようとするから、意思決定のハードルが上がる。まずは影響範囲が小さい業務——たとえば社内の週報ドラフトや、チーム内のナレッジ検索など——から導入して、「AIが間違えたけど、別に大丈夫だった」という成功体験を組織に積ませる。この小さな実績が、次の意思決定を格段に楽にする。
三つ目は、判断材料を整えることだ。
用途・リスク・精度を整理したマトリクスや、「この業務でAIが間違えた場合の影響度」を可視化した資料を、エンジニアの側から提供する。意思決定者は「判断したくない」のではなく、「判断するための情報がない」だけであることも多い。
エンジニアの仕事は「精度を上げること」だけではない。「この精度で使える場所を見つけること」もまた、AI時代のエンジニアの重要な役割だ。
おわりに
プロンプトエンジニアリングの知見は日々蓄積されている。RAGの構築パターンも洗練されてきた。技術的には、AI活用のハードルは確実に下がっている。
しかし、「使っていいかどうか」を決められない組織では、どれだけ技術があっても活用は進まない。
AI活用を前に進めるために本当に必要なのは、技術の民主化ではなく、意思決定の民主化 だと思う。「不完全なものを、条件付きで受け入れる」という判断を、特定の誰かに押し付けるのではなく、組織として合意形成できる仕組みを作ること。そのためにエンジニアは、技術を磨くと同時に、技術とビジネスの間に立つ翻訳者としての役割を担う必要がある。
AIは確率の世界に生きている。その確率をどこまで許容するかを決めるのは、技術ではなく、意志だ。