
刚刚读完Toward Controlled Generation of Text这篇paper,然后花了两个小时一直在思考: 这个模型跟GAN的区别到底在哪里?为什么GAN如日中天,VAE还经久不衰?难道只要加入一个中间embedding z,就能算是VAE么?最重要的是,从GAN的角度来思考,能不能对模型的本质达到更深的理解?
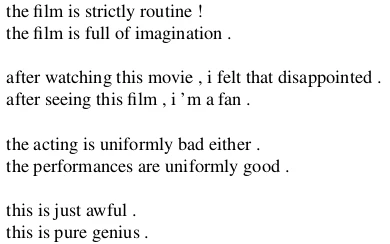
如上图所示,虽然比起2015年bowman的论文,确实算的上是一个不错的进展,但是,我们都知道图像到NLP领域就是降维打击——从论文引用数就能看出端倪,这样的成果实在不能说是惊人。
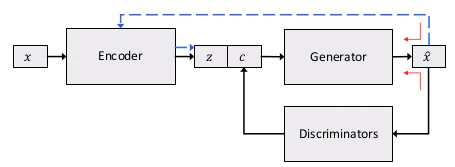
这是模型的结构。我们能看到潜在空间处多了一个c,然后还多了个Discriminators——注意这里的复数。
两个小时思考的结果是,一个简单的架构如下图——可行性未知,反正一定已经被人实验过了,只是我还没找到论文罢了。
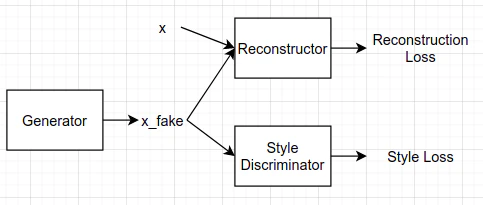
难道不行吗????????? 我决定实验一下,冲冲冲。