
こんにちは!
今回は,私が開発した新プログラミング言語「Quidra」の紹介になります!
みなさんの好きなプログラミング言語は何でしょうか?
私はC++ですかね!ヤバいものを作っているような,あの感覚が好きです笑
今回は,そんなプログラミング言語を私がゼロから作ってみました!
名前は「Quidra(クイドラ)」と言い,ラテン語の「Quidditas(本質)」が由来です.
名前の通り,余計なものを削ぎ落として「本質」だけを残す,つまり「曖昧性を排除しつつ,できるだけ短い構文を作る」ことを目標に,このプログラミング言語を作っています!
立ち位置としては,静的型付けのコンパイル型言語(LLVMでネイティブコードを生成)に分類されるかなと思います.
とはいえ,quidra main.qui の1コマンドでPythonのようにすぐ実行できますし,対話的に試せるREPL(中身はJITコンパイル)もあります.
目標
-
意味圧縮の性能が最も高いプログラミング言語
- これが今回の肝になります.この言語の一番の目標はこれを最大化することです.
- 具体的には「曖昧性を排除しつつ,できるだけ短い構文を作る」という考え方です.
- ただし,コードゴルフのように文字数を削ることが目的ではありません.意味のないトークンは削るけれど,意味のある区別は削らない(Fewer meaningless tokens, not fewer meaningful distinctions)というのがポイントです.
- スローガンは「1トークンあたりの意味最大化」(Maximum Meaning Per Token)
- 例えば,C++の
func(x)のxは参照渡しか値渡しかわかりません.したがって,それを知るには関数の定義部分を見るという手間があります.また,Pythonのy = x + 1はx・yの型が定まりません.型を知るには,前の行を遡ってみるか,printで表示してみる必要があります.よって,曖昧性が高いと見ることができます. - C++の
int mainは書かなくてもPythonのように上から順に実行する,という形式でも動きます.また,{}などもPythonのようにインデントで区別すれば不要です.よって,C++の構文は冗長性が高いと言えます. - これら既存のプログラミング言語の「曖昧性」や「冗長性」をできる限り無くしていくというのがQuidraの考え方です.
-
PythonやC++級の波及力を持つこと
- 単なる趣味言語では終わらず,最終的には他のプログラミング言語ぐらい有名な言語にしたいと思っています.
- 私だけではなくみんなで作っていきたいです! 設計理念・思想に共感できる人をコラボレーターとして募集しています!
-
人間・LLMにとって読みやすい
- まず,人間がよく使っている自然言語を使います.単に既存プログラミング言語と同じというわけではなく,
\nとか&&とかも無しです(&&の代わりにandを使いますし,printは自動で改行してくれます). - また,意味圧縮の副次効果として,LLMの入力・出力トークン消費量を削減する(短いコードであり,かつその1行を見るだけで処理を理解できる)ことも狙っています.よく使われる英単語は多くの場合1トークンで表現されるため,「自然言語でありながらLLMにも扱いやすい」は両立できると思っています.
- まず,人間がよく使っている自然言語を使います.単に既存プログラミング言語と同じというわけではなく,
-
新規参入者にとって学びやすい
- 例えば,Pythonは
y = x + 1で簡単に足し算が表現できます.つまり,初学者にとっては学びやすいです.しかし,より複雑な処理をやりたいと思うと,①型(それぞれの型における値の範囲),②アドレス参照(どこまでが値渡しでどこまで書き換えられるか),③ビット演算という部分まで学ぶ必要が出てきます.このように深く学ぼうとした時は,Pythonの例外的構文やブラックボックス性が理解しにくく,中期・長期の学習者にとっては逆に扱いにくいと考えています. - 一方,C++(というかC言語)は最初から型,アドレス参照,ビット演算を理解していないと,書けないような言語になっています.そういう点では,中期・長期の学習者にとっては理解しやすいかもしれません.しかし,ポインタ操作などの学習難易度高めなものを覚えないと,関数内での配列の値代入すらできません.そういう意味では,初期の学習者にとっては扱いにくいです.
- そこで,Quidraでは初期・中期・長期と幅広く扱えるような言語にしたいと思っています.具体的には,Pythonのように比較的儀式が少なく手軽に書けるが,型も残しつつ(内部で何しているかわかりやすい),複雑なポインタ操作はC++の参照渡しなどで代用する(しかしアドレスの概念は学べる),もちろんビット演算などもできる,といったような感じです.
- 配列やクラスの代入
a = bも原則値渡し(値が全部コピーされる)として,もし配列やクラスを参照したいだけならint[] &a = &bのように明示的に書くようにする(値渡しでも,コピーしてもしなくても結果が変わらない場面では,コンパイラが内部でコピーを省略できる設計になっている.例えば,引数を書き換えない関数に配列を渡すときは,現状でもコピーせずに参照している.つまりユーザ体験としては値渡しだが内部で最適化される.)など,私がプログラミングを学び始めた直後のことを想像し,より直感的な方で処理が行われるように工夫しました. - 最終的に,大学の講義とかで初プログラミングの授業としても使われてほしいなと思っています!
- 例えば,Pythonは
Quidraの概要
Quidraは「1トークンあたりの意味最大化」を第一目標としています.
実際に例を見ながら確認していきましょう!
この記事のコードは,Quidra 0.3.0で動作確認しています.
0.3.0 は最新のリリース版(v0.3.0)として公開しているので,リリースページのバイナリか main ブランチからのビルドで試せます.
インストール不要のPlaygroundでも,ブラウザ上で型チェックや整形を試せます.
プログラム例
学生の成績を扱うプログラムを実際に書いてみると,以下のようになります.
クラス,失敗するかもしれない関数,参照渡しなど,Quidraらしさを一通り詰め込んでみました!
class Student
    string name
    int[] scores

    construct(string student_name, int[] student_scores)
        name = student_name
        scores = student_scores

    float average()
        int total = 0
        for score in scores
            total += score
        return float(total) / float(len(scores)) // int → float は明示変換

// 失敗しうる関数は戻り値の型に error が入る
int | error parse_score(string text)
    int score = try int.parse(text) // 失敗なら error をそのまま呼び出し元へ
    if score < 0 or score > 100
        return error("out of range: {text}")
    return score

// int[] & = 呼び出し元の配列を書き換える権限をもらう
void add_bonus(int[] &scores, int bonus)
    for &score in scores
        score = math.min(score + bonus, 100)

Student alice = Student("Alice", [72, 85, 98])
Student backup = alice // 値コピー(alice を変えても backup は変わらない)
add_bonus(&alice.scores, 5) // & で「コピーではなく本体を渡す」ことを呼び出し側でも示す

print("{alice.name}: {alice.average():frac=1}")
print("backup: {backup.average():frac=1}")

for text in ["88", "abc", "120"]
    match parse_score(text) // int と error の両方を必ず処理する
        int score
            print("OK {score}")
        error problem
            print("NG {problem}")
Alice: 89.0
backup: 85.0
OK 88
NG numeric parse failed
NG out of range: 120
ポイントをいくつか挙げると,
-
int | errorのように,失敗するかもしれない関数は,戻り値の型にそう書きます.例外が裏でこっそり飛んでくることはありません. -
add_bonus(&alice.scores, 5)の&は,コピーではなく本体を渡しているという印です.逆に&が無い引数は,呼び出し先で絶対に書き換えられないと,呼び出し側だけで確定します. -
Student backup = aliceは値のコピーなので,aliceを変えてもbackupは変わりません. -
matchでは,intとerrorの両方を処理しないとコンパイルが通りません.
同じ処理をPythonとC++でも書いて,トークン数を比べてみました(コメントを除き,簡易的な字句解析器(レキサ)で計測.文字列リテラルは,埋め込み式も含めて1トークンと数えています).
| 言語 | 行数(空行・コメントを除く) | トークン数 |
|---|---|---|
| Quidra | 30 | 177 |
| Python(型ヒントなし) | 26 | 178 |
| Python(型ヒントあり) | 26 | 200 |
| C++ | 38 | 296 |
Quidraは,静的な型・書き換えの権限(&)・失敗の可能性(int | error)をすべて書いた上で,型ヒントなしのPythonとほぼ同じトークン数になっています!
C++と比べると,約3〜4割少ないです(文字列の埋め込み式 {…} の中身を数えるかどうかで変わります).
Python版・C++版のコード(クリックで展開)
import copy


class Student:
    def __init__(self, name: str, scores: list[int]):
        self.name = name
        self.scores = scores

    def average(self) -> float:
        return sum(self.scores) / len(self.scores)


def parse_score(text: str) -> int:
    score = int(text)
    if score < 0 or score > 100:
        raise ValueError(f"out of range: {text}")
    return score


def add_bonus(scores: list[int], bonus: int) -> None:
    for i in range(len(scores)):
        scores[i] = min(scores[i] + bonus, 100)


alice = Student("Alice", [72, 85, 98])
backup = copy.deepcopy(alice)
add_bonus(alice.scores, 5)

print(f"{alice.name}: {alice.average():.1f}")
print(f"backup: {backup.average():.1f}")

for text in ["88", "abc", "120"]:
    try:
        score = parse_score(text)
        print(f"OK {score}")
    except ValueError as problem:
        print(f"NG {problem}")
#include <algorithm>
#include <cstdio>
#include <stdexcept>
#include <string>
#include <vector>

struct Student {
    std::string name;
    std::vector<int> scores;

    double average() const {
        int total = 0;
        for (int score : scores) total += score;
        return static_cast<double>(total) / scores.size();
    }
};

int parse_score(const std::string& text) {
    int score = std::stoi(text);
    if (score < 0 || score > 100) throw std::out_of_range("out of range: " + text);
    return score;
}

void add_bonus(std::vector<int>& scores, int bonus) {
    for (int& score : scores) score = std::min(score + bonus, 100);
}

int main() {
    Student alice{"Alice", {72, 85, 98}};
    Student backup = alice;
    add_bonus(alice.scores, 5);

    std::printf("%s: %.1f\n", alice.name.c_str(), alice.average());
    std::printf("backup: %.1f\n", backup.average());

    for (std::string text : {"88", "abc", "120"}) {
        try {
            int score = parse_score(text);
            std::printf("OK %d\n", score);
        } catch (const std::exception& problem) {
            std::printf("NG %s\n", problem.what());
        }
    }
    return 0;
}
ちなみに,Python版で backup = copy.deepcopy(alice) の代わりに素直に backup = alice と書くと,backup も同じオブジェクトを指すので,2行目が backup: 89.0 になってしまいます.
曖昧性の排除
Quidraでは,1つの記号・キーワードには1つの意味だけを持たせています.
| 書き方 | 意味 |
|---|---|
= |
値のコピー(独立した値として代入) |
&x |
変数 x そのもの(コピーではなく本体)を扱うことを明示 |
T & |
書き換え可能な参照 |
const T & |
読み取り専用の参照 |
T | none |
「値がない」ことが型に含まれる |
T | error |
「失敗する」ことが型に含まれる |
try |
error を呼び出し元へ伝播する(それ以外の意味はない) |
T(value) |
明示的な型変換(T が数値型のとき.クラスの T(...) はコンストラクタ呼び出し) |
and / or / not
|
論理演算(bool専用) |
AND / OR / XOR / NOT / << / >>
|
ビット演算(固定幅の整数専用) |
match |
すべての場合を漏れなく処理する分岐 |
具体的に見ていきましょう.
参照渡しか値渡しか:f(x) と f(&x)
C++では,書き換える関数も書き換えない関数も,呼び出し側の見た目は同じです.
void add_one(int& value) { value += 1; }  // 書き換える
void show(int value) { /* ... */ }        // 書き換えない

add_one(count);  // 呼び出し側は
show(count);     // まったく同じ見た目
Quidraでは,関数が引数を書き換える場合は,呼び出し側にも & が必要です.
void add_one(int &value)
    value += 1

int count = 1
add_one(&count)
print(count)
2
& を付け忘れると,コンパイルエラーになります.
ref.qui:5:9: error[WRITE_CAPABILITY] Argument reference form must match parameter.
逆に,値渡しの関数に & を付けても同じエラーになります.
つまり,& が付いていない引数は,呼び出し先で絶対に書き換えられません.
また,読み取り専用の参照(const int &)を通して書き込もうとした場合も,コンパイルエラーになります.
代入は値のコピー,参照は & で明示
int[] a = [1, 2, 3]
int[] b = a
b[0] = 9
print("a[0] = {a[0]}, b[0] = {b[0]}")

int[] &c = &a
c[0] = 7
print("a[0] = {a[0]}, c[0] = {c[0]}")
a[0] = 1, b[0] = 9
a[0] = 7, c[0] = 7
b = a はコピーなので,b を書き換えても a は変わりません.
参照したいときだけ,int[] &c = &a のように型にも右辺にも & を付けて明示します.
Pythonの b = a は同じリストを共有するので,b[0] = 9 で a[0] も変わってしまいますね.
暗黙の型変換はしない
int big = 300
int8 small = big
error[TYPE_MISMATCH] Expected int8 but received int.
型を変えたいときは int8(big) のように明示します.
その場合も,値が範囲外なら実行時エラーで止まり,値が勝手に回り込むことはありません.
Quidra runtime error[NUMERIC_CAST_RANGE] at 2:14: numeric cast outside destination range
C++で同じことをすると,警告すら出ずにコンパイルが通り,こっそり値が変わります.
int big = 300;
int8_t small = big;  // -Wall -Wextra でも警告なし.small は 44 になる
ほかにも,int と float の足し算は float(i) + d のように明示しないとエラーですし,float から int への変換は math.round や math.floor のように丸め方まで明示する必要があります.
「失敗」と「値がない」を型で表す
int | error parse_twice(string text)
    int value = try int.parse(text)
    return value * 2

for text in ["21", "12abc"]
    match parse_twice(text)
        int doubled
            print(doubled)
        error problem
            print("NG: {problem}")
42
NG: numeric parse failed
try は error だけを呼び出し元に伝播します.
match で分岐を書き忘れると error[MATCH_EXHAUSTIVE] でコンパイルエラーになります.
また,match を使わずに int doubled = parse_twice(text) のように受け取った場合も,失敗が黙って無視されることはなく,その行で実行時エラーとして止まります.
ちなみにC++の std::stoi("12abc") は,黙って 12 を返します.
Pythonの int("12abc") は例外を投げてくれますが,関数の型を見ただけでは「例外が飛ぶかもしれない」ことはわかりません.
論理演算とビット演算を分ける
Quidraには && も || も ! もありません.
論理演算は and / or / not,ビット演算は大文字の AND / OR / XOR / NOT です.
uint8 can_read = 4
uint8 can_write = 2
uint8 can_run = 1

uint8 permission = can_read OR can_write
bool writable = (permission AND can_write) != 0
bool runnable = (permission AND can_run) != 0

print(bin(permission))
if writable and not runnable
    print("read/write only")
print(bin(permission << 1))
print(bin(NOT permission))
00000110
read/write only
00001100
11111001
uint8 に and を使ったり,bool に AND を使ったりすると型エラーになります.
また,if count のように整数をそのまま条件に使うこともできません(bool 以外は条件にならない).
名前の隠蔽(シャドーイング)を禁止
int total = 0
for i in range(3)
    int total = i
error[SHADOWING] Name is already visible or reserved.
外側の名前を内側で隠すことはできません.
なので,後から近くにコードを書き足しても,前に書いた名前の参照先がこっそり変わることがありません.
冗長性の排除
まずはお決まりのHello Worldです.
print("Hello, World!")
| 言語 | 行数(空行を除く) | トークン数 |
|---|---|---|
| Quidra | 1 | 4 |
| Python | 1 | 4 |
| C++ | 5 | 20 |
| Java | 5 | 26 |
C++やJavaのような main 関数も,#include も,クラスも要りません.
その他にも,以下のような「書かなくていいもの」があります.
-
mainは不要:上から順に実行されます(むしろmainという名前の関数を作るとエラーです). -
{}も;も不要:ブロックはインデントで表します.インデントはスペース4つに固定で,タブや2スペースはエラーになるので,書き方の「揺れ」も起きません. -
printは自動で改行:改行したくないときはwriteを使います.\nのようなエスケープはなく,バックスラッシュはただの文字なので,Windowsのパスもそのまま書けます.改行文字が必要なときは{ENTER}と書きます. -
selfやthisは不要:メソッドの中では,フィールドを直接読み書きできます. -
型推論
auto:auto doubled = count * 2のように,型が決まる式から推論できます.
print("1行目")
print("2行目")
write("改行なし")
write("で続く")
print("")
print("first{ENTER}second")
print("C:\Users\quidra\notes.txt")
1行目
2行目
改行なしで続く
first
second
C:\Users\quidra\notes.txt
ちなみに,auto count = 3 はエラーになります.
3 が int なのか int8 なのかを勝手に決めない,というのも曖昧性の排除ですね.
ベンチマーク
既存のプログラミング言語も用いて,ベンチマークを実施してみました.
比較した言語は,Python(3.12.3),C++(Clang 18.1.3),Rust(1.95.0),Go(1.26.3),Java(26.0.1),TypeScript(7.0.2),Kotlin(2.3.21),Swift(6.2.3),Zig(0.16.0),Quidra(0.3.0)の10言語です.
評価は,次の5つの観点で行いました.
| 評価 | ざっくり言うと |
|---|---|
| 意味圧縮性能 | 1トークンあたりに,どれだけ確かな意味を詰め込めるか |
| 言語品質 | 実行速度・ファイルサイズ・安全性・言語設計 |
| LLM学習容易性 | 仕様を渡されたLLMが,その言語のルールを学んで使えるか |
| LLM実用性 | LLMが何も見ずに,実用的なプログラムを書けるか |
| エコシステム | ライブラリ・ツール・コミュニティの充実度 |
実行速度やファイルサイズ,安全性テスト,LLMが書いたコードのコンパイル・テストなど,決定論的に評価できる部分は機械(シェル実行・Python実行)に任せ,コードの意味の注釈や言語設計の評価など非決定論的な部分や,エコシステムの調査のように検索が必要な部分,そしてLLMがその言語を扱えるかを測る目的の項目はLLMに任せています.
スコアの集計・正規化・順位付けはスクリプトで行っています(ただし,LLM学習容易性の各条件のスコアと,LLM実用性の18指標のうち2つ(存在しない構文を書かないか,仕様どおりか)は,LLMが採点基準に沿って付けた値をそのまま使っています).
また,5つの評価は性質がまったく違うので,全部を足し合わせた「総合順位」はあえて作っていません.
LLMには主にClaude Sonnet 5を使用しました.
もちろんですが,他のセッションを覗き見しないようにAPIを利用しています.
具体的には,LLMのワーカー(評価作業を担当するLLMのセッション)1つが担当するのは基本的に1言語だけで,ネットワークを切ったDockerコンテナの中で動かしているので,他の言語の結果や過去の実行結果は見られません(エコシステムの調査だけはWeb検索ありです).
(ベンチマークやりたかっただけなのに,数万円使ってしまった...泣)
また,Quidraに有利な評価にならないよう,次のようなルールで設計しています.
- 指標・重み・課題は,測定の前に固定する(途中の試行で見つかった不具合で,0〜100点への換算方法などを直した部分はあります.修正後の方法論・設定・採点スクリプトは,すべて
benchmark/template/で公開しています) - Quidraの構文や機能をもとに課題を作らない.Quidraにできない機能も課題から外さない
- Quidra専用の指標は作らず,10言語すべてに同じルールを適用する
ベンチマークの方法や結果の詳細(各指標のスコアの内訳や,LLMの判断理由を含む)は,リポジトリの benchmark/ ディレクトリ(今回の結果は benchmark/2026-09-27-38b7137-gh31/)で公開しています.
結果のサマリー
先に結果をまとめると,次のようになりました.
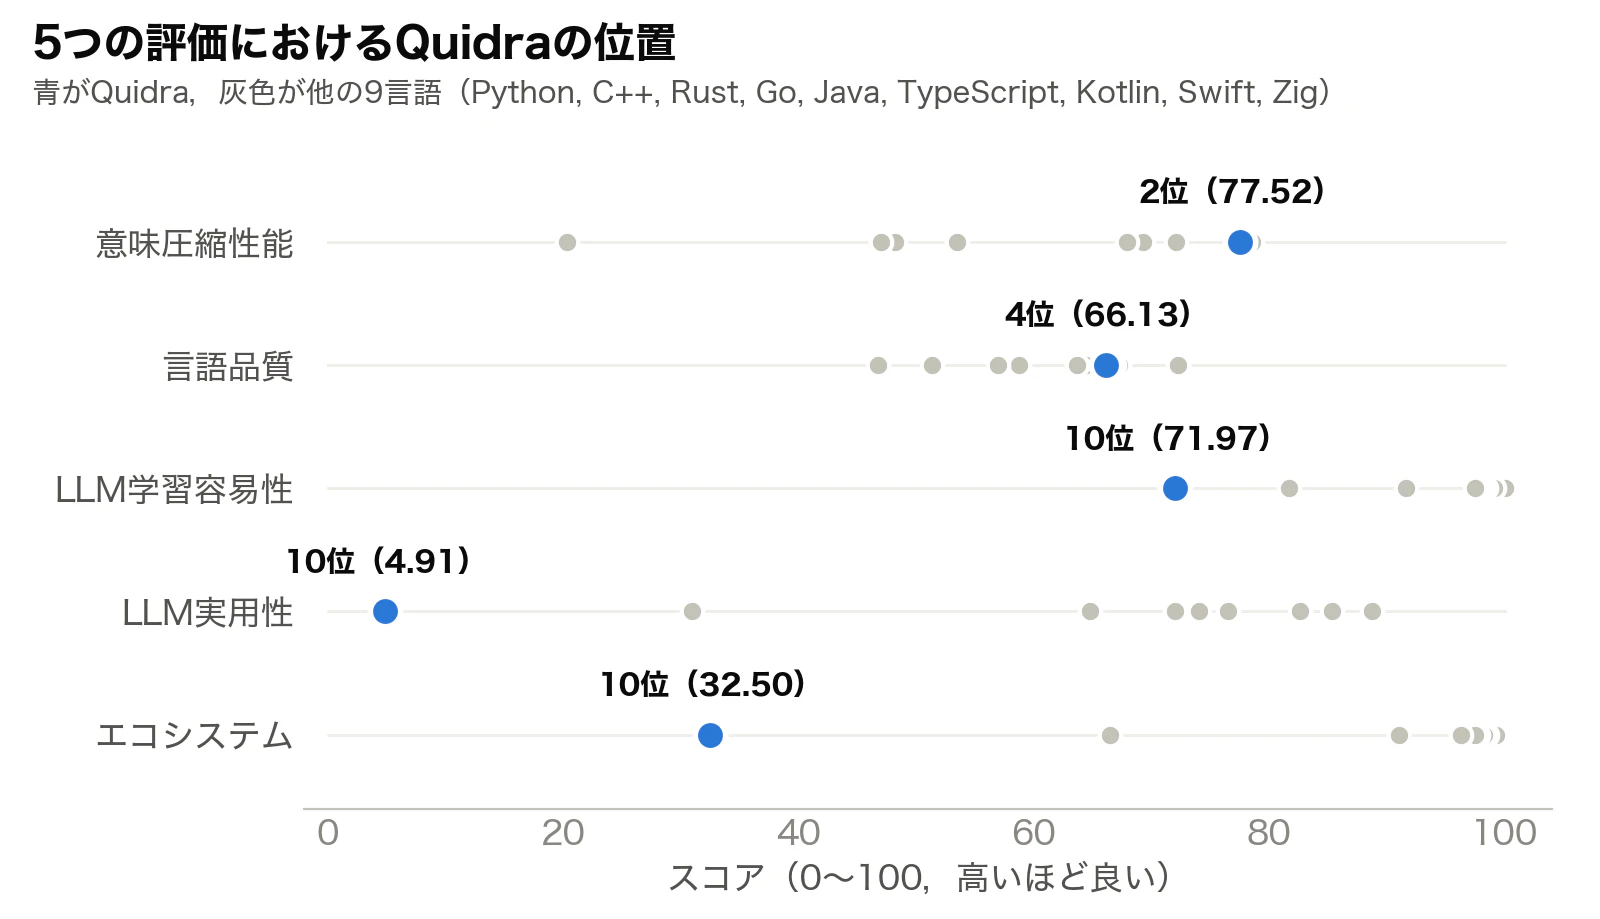
| 評価 | Quidraのスコア | 順位 | 1位 |
|---|---|---|---|
| 意味圧縮性能 | 77.52 | 2位 | Zig(78.48) |
| 言語品質 | 66.13 | 4位 | Rust(72.24) |
| LLM学習容易性 | 71.97 | 10位 | Swift(100.00) |
| LLM実用性 | 4.91 | 10位 | Python(88.68) |
| エコシステム | 32.50 | 10位 | Java(99.25) |
ざっくり言うと,言語そのものの中身(意味圧縮・言語品質)は上位,LLMとの相性やエコシステムはまだまだ(3つとも10位),という結果です.
では,実際に性能を見ていきましょう.
意味圧縮性能
今回一番の目玉になります!
意味圧縮性能は,変数の宣言,参照,オーバーフロー,エラー処理,ジェネリクス,並行処理,FFI(他の言語の関数の呼び出し)など,20分野・44個の課題を用意し,10言語それぞれでLLMに最小限のコード断片を書かせて測っています.
そのコード断片に対して,「どんな意味が,その場で確定しているか」「解釈が何通り残るか」などをLLMが注釈し,その数をスクリプトで集計しています.
指標は次の6つです.
網羅性以外の5つの指標(以下,品質指標)は,10言語の中で最も良い言語を100,最も悪い言語を0として正規化しています(相対評価です).
| 指標 | 何を見るか | 重み | Quidra |
|---|---|---|---|
| 意味密度 | 1トークンあたり,その場で確定する意味の数 | 20% | 100(1位) |
| 一意性(意味の確定性) | その1行だけを見て,解釈が何通り残るか | 25% | 100(1位) |
| 局所性 | 意味を確定するのに,他の場所を何回見に行く必要があるか | 20% | 34.45(5位) |
| 隠れた意味コスト | 書いていないのに起きること(暗黙の変換など)の数 | 20% | 81.48(2位) |
| 機能効率 | 機能1つあたりに必要なルールの数 | 15% | 36.46(7位) |
| 網羅性 | 44課題のうち,標準の機能で書ける割合 | 調和平均 | 81.82(9位) |
意味密度
1トークンあたりに,その場で(他の場所を見ずに)確定する意味がいくつあるか,です.
例えば const int n = 7 からは,「値である」「再代入できない」「初期化済み」「int 型」といった意味がその場で読み取れます.
こういった「その場で確定する意味」の数を,トークン数で割ったものです.
全言語で書けた31課題で比較すると,次のようになりました.
| 言語 | 確定した意味 / トークン数 | 意味密度 | スコア |
|---|---|---|---|
| Quidra | 133 / 808 | 0.1646 | 100 |
| Swift | 108 / 751 | 0.1438 | 70.49 |
| Zig | 121 / 893 | 0.1355 | 58.69 |
| Kotlin | 106 / 783 | 0.1354 | 58.52 |
| Go | 109 / 863 | 0.1263 | 45.65 |
| Rust | 117 / 1015 | 0.1153 | 29.99 |
| Python | 79 / 714 | 0.1106 | 23.42 |
| TypeScript | 90 / 884 | 0.1018 | 10.88 |
| C++ | 95 / 973 | 0.0976 | 4.96 |
| Java | 98 / 1041 | 0.0941 | 0 |
Quidraが意味密度1位です!
面白いのはPythonで,トークン数は最少(714)ですが,その場で確定する意味も最少(79)なので,密度は低くなっています.
短ければ良いわけではない,というのがよくわかりますね.
※ トークン数はLLMが数えていますが,念のため全言語共通の簡易レキサ(正規表現)で数え直しても,Quidraが1位なのは変わりませんでした.なお,空白やインデントは数えないルールなので,インデントでブロックを表すQuidraやPythonは,{} の分だけ少し有利です.
一意性(意味の確定性)
その1行だけを見たときに,意味(書き換えるのか,コピーされるのか,失敗の仕方,型変換の仕方など)の解釈が何通り残るか,です.
1通りに決まれば満点です.
Quidraは,全言語で書けた31課題すべてで,解釈が1通りに決まった唯一の言語でした!
冒頭で書いたC++の func(x) の例も,実際にベンチマークで測っています.
配列 x を作って f(x) を呼び,その後 x[0] を読むとき,呼び出し側だけを見て「読むだけ?書き換える?サイズを変える?参照を持ち続ける?コピーされた?」などの候補が何通り残るかを数えたものです.
| 言語 | 残る解釈の数 |
|---|---|
| Quidra | 1 |
| Rust | 1 |
| Swift | 2 |
| Python | 3 |
| Go / Java / TypeScript | 4 |
| C++ / Kotlin / Zig | 6 |
Quidraは & が無いので「値渡しで,呼び出し先からは書き換えられない」と1通りに確定します.
一方でC++は,値渡し・参照渡し・const参照渡しのどれでも呼び出しの見た目が同じなので,候補がすべて残ります.
※ この数はLLMワーカーの注釈そのままです.言語ごとに別のワーカーが数えているので,JavaとKotlinのように似た仕組みの言語でも数え方がぶれている所があります.
また,x += 1 のオーバーフローも,Quidraは常に実行時エラーで止まる(1通り)のに対し,RustやZigはビルドモードによって挙動が変わる(2通り),C++は未定義動作,と判定されました.
局所性・隠れた意味コスト・機能効率
残りの3つの指標では1位を取れませんでした(特に局所性と機能効率は伸び悩みました).
-
局所性(5位,34.45):意味を確定するために,他の場所(関数の宣言,型の定義,import先,標準ライブラリの仕様など)を何回見に行く必要があるか,です.Quidraで数えられた17回のうち11回は,「課題文で別の場所に宣言済みとされた変数」の宣言を見に行く分で,残りは「ファイルは自動でクローズされる」「
task.allは結果の順序を保つ」のような標準ライブラリの約束事などでした.ただ,この「宣言済みの変数」を数えるかどうかはワーカーごとにバラバラ(Goは数えず,Swiftは変数ごとに数える)なので,ここの差は少し割り引いて見てください.1位はZigです. - 隠れた意味コスト(2位,81.48):暗黙の型変換や見えない書き換えなど,「書いていないのに起きること」の数です.Quidraで数えられたのは,ほぼ「オーバーフローや範囲外アクセスで実行時エラーになることが,構文からは見えない」というものでした.1位はZigです.
-
機能効率(7位,36.46):機能1つあたりに必要なルール(構文の種類・暗黙のルール・例外的なルールなど)の数です.Quidraは,オーバーフロー検査や値のコピーといった言語全体の暗黙のルールや,「
privateはクラスのメンバーにしか付けられない」のような例外的なルールがカウントされ,1点(1課題=2点)あたり約1.8個でした(1位のSwiftは約0.95個).
網羅性
int a = 5
print(a)
もしも,上記のように型もintしかないし,関数もprintしかないなら,当然意味圧縮の性能は高いです.
大事なのは,意味圧縮の性能を保ったまま,どれだけ多くのことを書けるかです.
そこで,44課題(1課題2点,88点満点)のうち,標準の機能だけで書ける割合を「網羅性」として測りました.
書けない課題も分母に残るので,機能が少ない言語ほど低くなります.
| 言語 | 網羅性 |
|---|---|
| C++ | 98.86 |
| Rust | 98.86 |
| Swift | 97.73 |
| Zig | 94.32 |
| Go | 90.91 |
| Java | 90.91 |
| Kotlin | 90.91 |
| TypeScript | 82.95 |
| Quidra | 81.82 |
| Python | 77.27 |
Quidraは81.82で9位でした.
正直,ここが一番の弱点です...
書けなかった(または一部しか書けなかった)のは,次の課題です.
- ローカル変数をキャプチャするクロージャ
- 継承やインターフェースによる,実行時のディスパッチ(2課題)
- 配列のスライス
- 比較関数を指定したソート(降順ソート)
- ユーザ定義のデストラクタ
- C言語から呼べる関数のエクスポート
- (一部だけ)オプショナル値を
ifやmatchなしで変換する操作,モジュールの中だけで使えるprivateな関数
逆に,参照・オーバーフロー・エラー処理・並行処理・C言語の関数の呼び出しなどは満点でした.
ちなみに,品質Qはそのままであと1課題でも書けるようになれば,計算上はZigをわずかに上回って意味圧縮性能1位になります笑
とはいえ0.05点差という僅差なので,順位そのものより「品質Qは1位,網羅性が課題」という傾向を見てもらえると嬉しいです.
伸びしろですね!
総合評価
5つの品質指標の加重平均を品質Qとして,品質Qと網羅性Cの調和平均をとり,機能が充実しつつも意味圧縮を実現できているかの指標を出してみました.
\text{総合スコア} = \frac{2 \times Q \times C}{Q + C}
調和平均は,片方だけが高くても全体が上がりにくい平均です.
例えばC++は網羅性が98.86(1位タイ)ですが,品質Qが11.36なので,総合は20.38(最下位)になります.
結論として,Quidraが2位でした.(1位はZig)
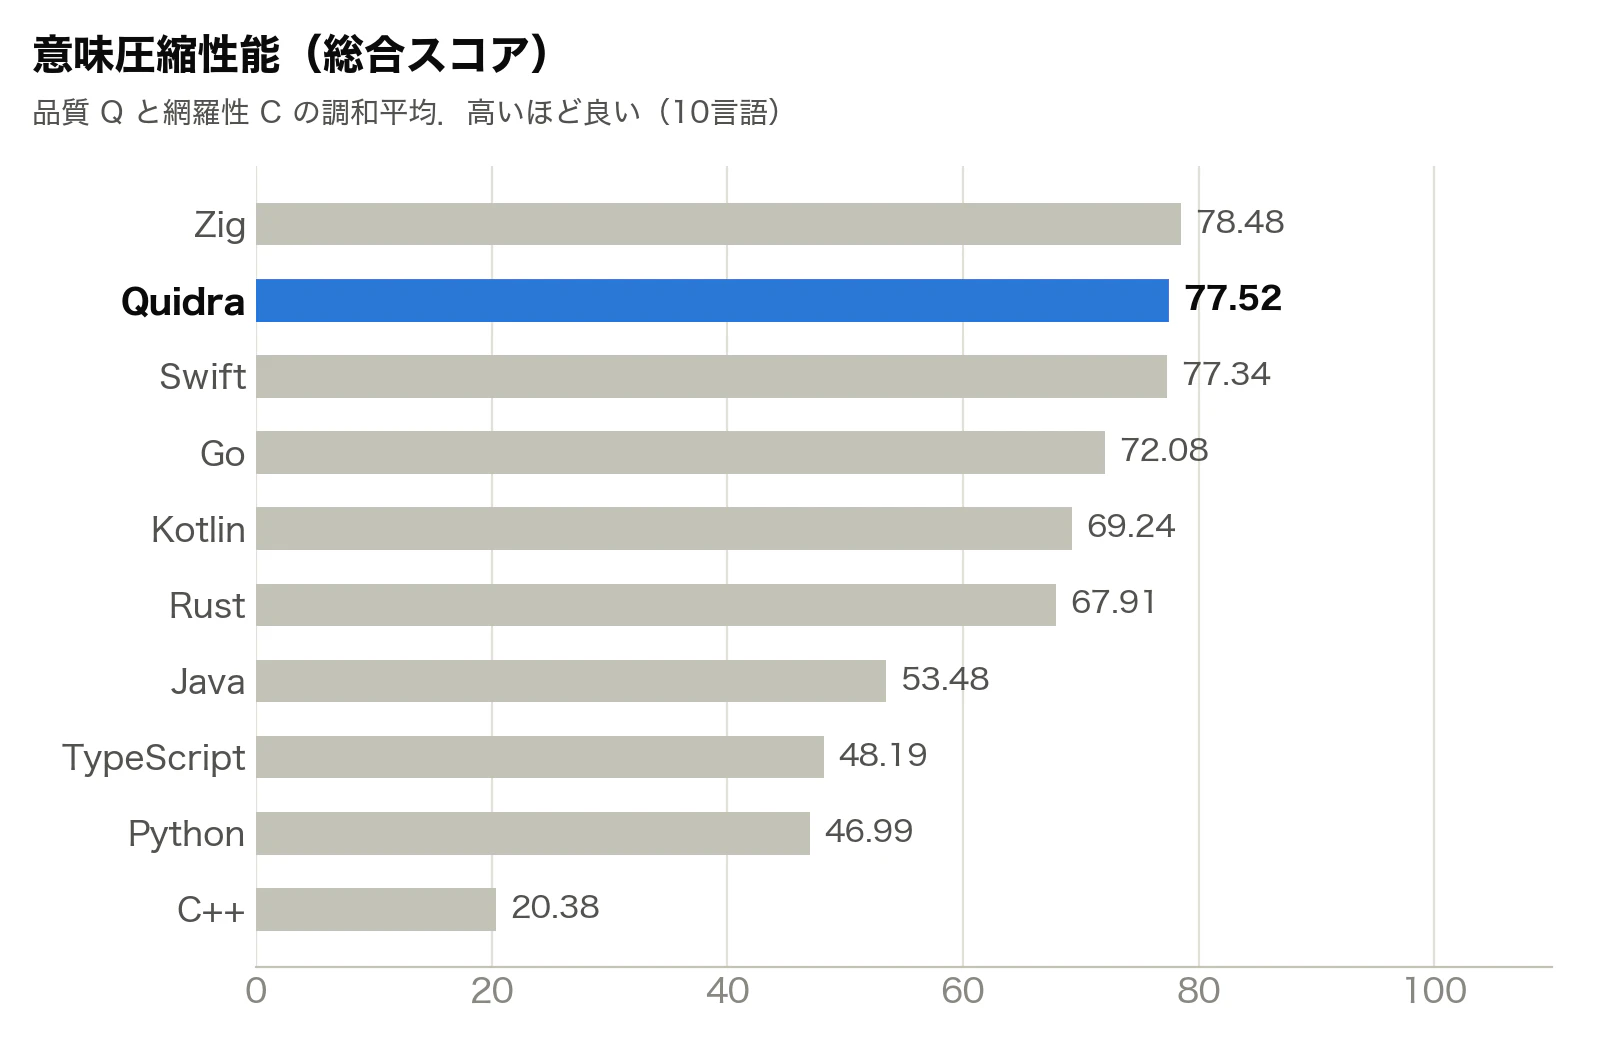
| 順位 | 言語 | 品質Q | 網羅性C | 総合 |
|---|---|---|---|---|
| 1 | Zig | 67.19 | 94.32 | 78.48 |
| 2 | Quidra | 73.66 | 81.82 | 77.52 |
| 3 | Swift | 63.99 | 97.73 | 77.34 |
| 4 | Go | 59.71 | 90.91 | 72.08 |
| 5 | Kotlin | 55.91 | 90.91 | 69.24 |
| 6 | Rust | 51.72 | 98.86 | 67.91 |
| 7 | Java | 37.88 | 90.91 | 53.48 |
| 8 | TypeScript | 33.96 | 82.95 | 48.19 |
| 9 | Python | 33.76 | 77.27 | 46.99 |
| 10 | C++ | 11.36 | 98.86 | 20.38 |
注目してほしいのは品質Qで,Quidraは品質Qで10言語中1位(73.66)です!
一方で網羅性が足を引っ張り,総合では2位になりました.
品質Qと網羅性Cの関係を図にすると,こんな感じです.
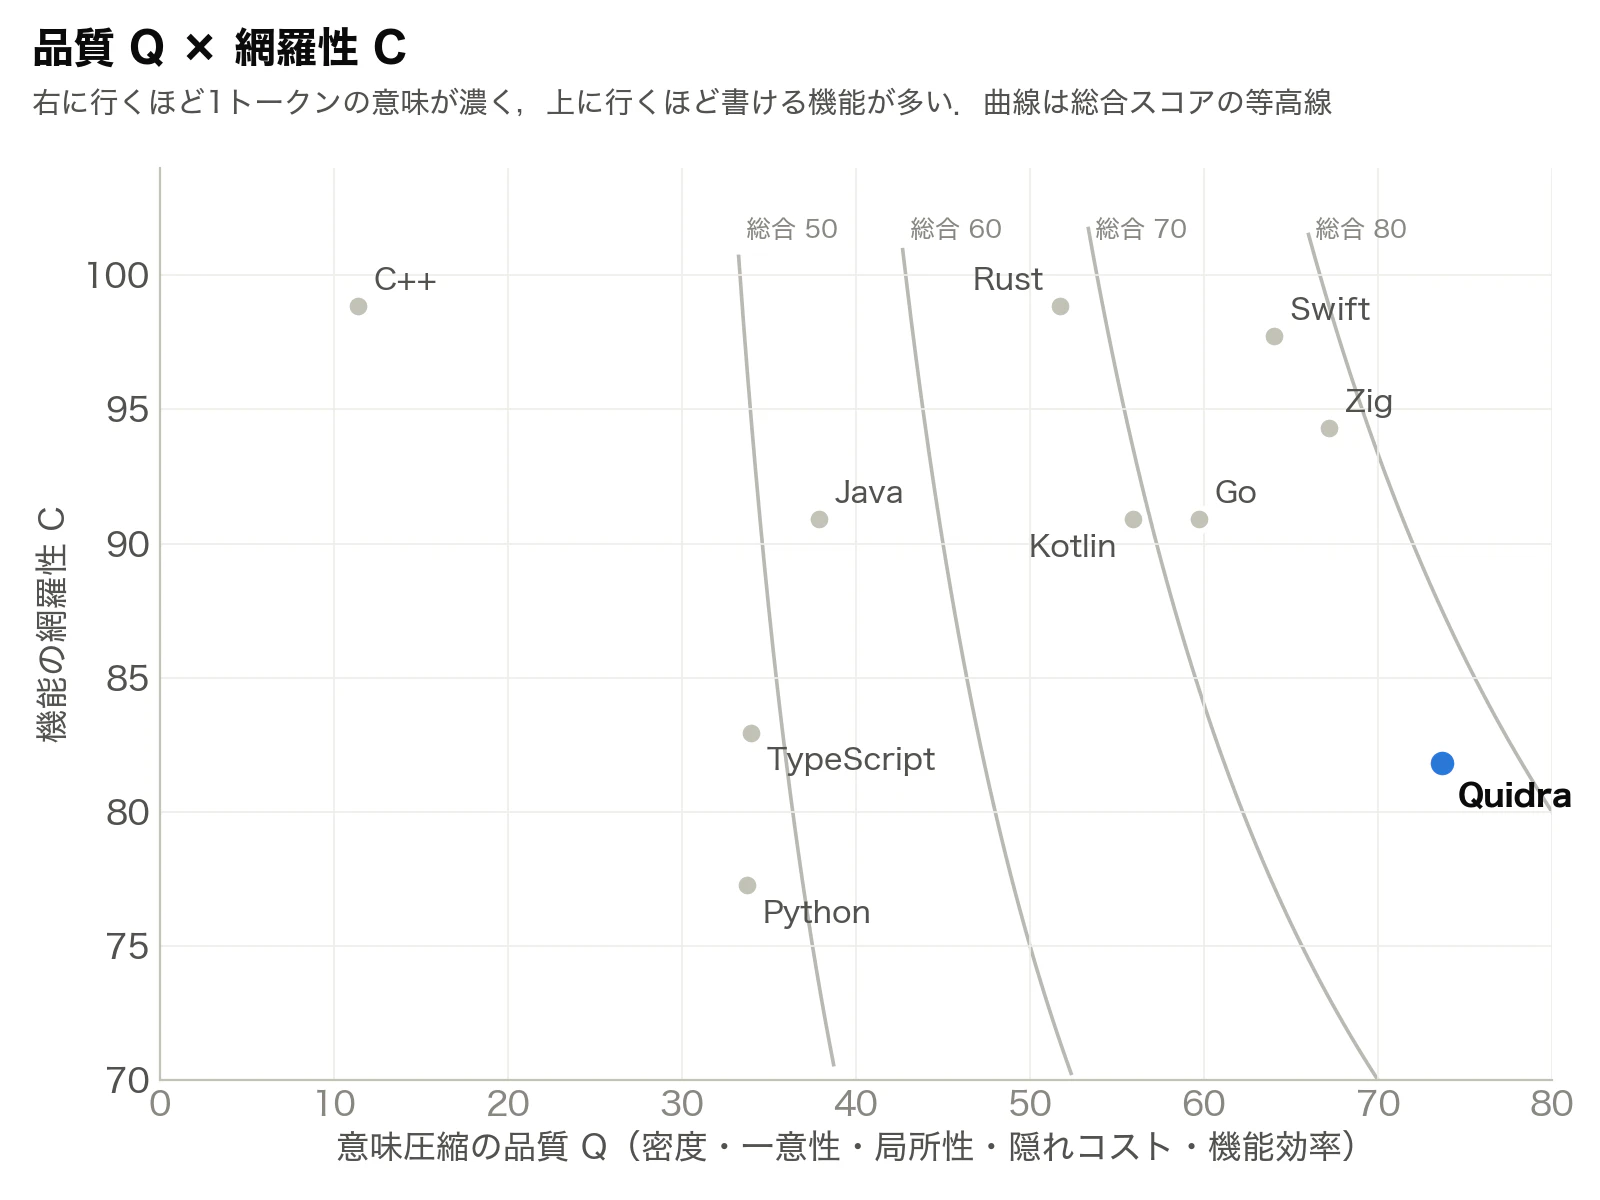
なお,2位のQuidraと3位のSwiftの差は0.18点,1位のZigとも約1点差なので,上位3言語はほぼ横並びと見るのが妥当かなと思います.
言語品質
言語品質は,実行性能(25%)・リソース(18.75%)・言語設計(25%)・安全性(31.25%)の4カテゴリで評価しています.
実行性能・リソース・安全性は機械で計測し,言語設計だけLLMが固定の採点基準(ルーブリック)で判定しています.
結果は,Quidraが66.13で4位でした.
1位はRust(72.24),2位はGo(67.22),3位はZig(66.76)で,Zigとは0.63点差です.
| カテゴリ | 重み | Quidra | 順位 | 1位 |
|---|---|---|---|---|
| 実行性能 | 25% | 47.38 | 5位 | Zig(73.08) |
| リソース | 18.75% | 67.30 | 5位 | Python(89.92) |
| 安全性 | 31.25% | 64.85 | 5位 | Java(69.85) |
| 言語設計 | 25% | 85.62 | 4位 | Swift(93.12) |
実行速度(実行性能)
フィボナッチ・階乗・整数演算・浮動小数点演算・内積・行列積・マージソート・文字列処理・統計・ファイルI/O・コレクションの11種類の処理を,全言語で同じアルゴリズム・同じ入力で実装し,出力が正しいことを確認してから時間を計っています.
各処理はウォームアップ2回のあと5回計測し,その中央値を使いました(GitHub Actions上のDockerコンテナで計測).
| 処理 | Quidra | C++ | Rust | Go | Zig | Python |
|---|---|---|---|---|---|---|
| フィボナッチ | 0.323 | 0.159 | 0.159 | 0.363 | 0.159 | 9.022 |
| 階乗 | 0.904 | 0.903 | 0.903 | 0.874 | 0.935 | 10.802 |
| 整数演算 | 0.835 | 0.774 | 0.860 | 0.861 | 0.667 | 40.958 |
| 浮動小数点演算 | 1.274 | 1.222 | 1.272 | 1.310 | 1.266 | 58.243 |
| 内積 | 0.802 | 0.795 | 0.794 | 0.793 | 0.792 | 53.574 |
| 行列積 | 1.212 | 1.338 | 1.345 | 1.999 | 1.359 | 48.128 |
| マージソート | 1.519 | 0.567 | 0.776 | 0.787 | 0.575 | 36.322 |
| 文字列処理 | 1.145 | 0.736 | 0.781 | 0.808 | 0.775 | 21.814 |
| 統計 | 0.620 | 0.466 | 0.497 | 0.333 | 0.324 | 26.865 |
| ファイルI/O | 12.492 | 0.428 | 0.563 | 0.629 | 0.278 | 3.089 |
| コレクション | 1.311 | 0.521 | 0.344 | 0.476 | 0.302 | 3.387 |
(単位は秒.プロセスの起動から終了までの時間)
10言語すべての結果(クリックで展開)
| 処理 | Quidra | Python | C++ | Rust | Go | Java | TypeScript | Kotlin | Swift | Zig |
|---|---|---|---|---|---|---|---|---|---|---|
| フィボナッチ | 0.323 | 9.022 | 0.159 | 0.159 | 0.363 | 0.286 | 0.731 | 0.302 | 0.325 | 0.159 |
| 階乗 | 0.904 | 10.802 | 0.903 | 0.903 | 0.874 | 0.913 | 3.858 | 0.929 | 0.906 | 0.935 |
| 整数演算 | 0.835 | 40.958 | 0.774 | 0.860 | 0.861 | 0.773 | 6.175 | 0.781 | 0.840 | 0.667 |
| 浮動小数点演算 | 1.274 | 58.243 | 1.222 | 1.272 | 1.310 | 1.324 | 1.247 | 1.337 | 1.217 | 1.266 |
| 内積 | 0.802 | 53.574 | 0.795 | 0.794 | 0.793 | 0.873 | 0.926 | 0.880 | 0.799 | 0.792 |
| 行列積 | 1.212 | 48.128 | 1.338 | 1.345 | 1.999 | 3.141 | 1.143 | 3.159 | 1.351 | 1.359 |
| マージソート | 1.519 | 36.322 | 0.567 | 0.776 | 0.787 | 1.152 | 2.302 | 1.129 | 0.900 | 0.575 |
| 文字列処理 | 1.145 | 21.814 | 0.736 | 0.781 | 0.808 | 1.056 | 3.639 | 1.052 | 1.652 | 0.775 |
| 統計 | 0.620 | 26.865 | 0.466 | 0.497 | 0.333 | 0.810 | 0.891 | 0.845 | 0.520 | 0.324 |
| ファイルI/O | 12.492 | 3.089 | 0.428 | 0.563 | 0.629 | 0.676 | 1.650 | 0.766 | 0.645 | 0.278 |
| コレクション | 1.311 | 3.387 | 0.521 | 0.344 | 0.476 | 0.873 | 1.097 | 0.948 | 0.498 | 0.302 |
結果をまとめると,こんな感じです.
- 行列積では,C++・Rust・Zigより速い!(Quidra 1.212秒,C++ 1.338秒,Rust 1.345秒,Zig 1.359秒)
- 階乗・浮動小数点演算・内積は,C++とほぼ同じ速さ(差は5%以内)
- 11処理の幾何平均で見ると,Pythonより約16.5倍速い
- 一方で,C++と比べると幾何平均で約1.85倍遅い(ファイルI/Oを除くと約1.4倍)
- ファイルI/Oは12.49秒で,Zigの約45倍遅い...メモリも約1.6GB使っていて明らかにおかしいので,ここは完全に要改善です泣
なお,Quidraは整数オーバーフローや配列の範囲外アクセスのチェックを常にONにしたまま計測しています.
C++(-O2)はもともとこうした検査がなく,Rust(-O)とZig(ReleaseFast)もオーバーフロー検査が外れた設定なので,その分のハンデはあります.
一方で,Quidraは内部でClangの -O3 を使っていて,C++の -O2 より最適化は強めなので,行列積の差などはそのあたりも効いているかもしれません.
起動時間(Hello Worldの実行時間)は,Quidraが約1.95ミリ秒で,C++(約1.98ミリ秒)やGo(約1.93ミリ秒)と同じくらいでした.
JVMを使うJava(約30.8ミリ秒)やKotlin(約50.1ミリ秒)と比べると,かなり速く起動できます.
ビルド時間も,ほとんどのプログラムで0.13〜0.21秒と,コンパイルが必要な言語の中ではGo(約0.13秒)に次ぐ速さでした.
ちなみにC++は1.3〜1.8秒,Zigは約15秒でした.
(スコア上は,ビルド不要のPythonが満点になり,コンパイルが必要な言語は全員ほぼ0点になる計算式なので,ここは生の時間で見るのが良さそうです.)
ファイルサイズ(リソース)
同じ11本のプログラムの,ソースコードの合計サイズ(コメント込みのバイト数)です.
| 言語 | ソースコードの合計 |
|---|---|
| Python | 24,671 |
| Go | 25,232 |
| Quidra | 26,002 |
| Kotlin | 28,210 |
| Rust | 29,337 |
| Java | 31,674 |
| Swift | 33,802 |
| C++ | 36,021 |
| Zig | 37,365 |
| TypeScript | 38,356 |
スコア(プログラムごとのサイズ比の平均)では,Pythonに次ぐ2位(92.32)でした(合計のバイト数ではGoの方がわずかに小さいです).
静的型付けの言語なのに,Pythonとほぼ同じ量で書けています!
実行ファイルのサイズは,次のようになりました.
| 言語 | 成果物 | サイズ |
|---|---|---|
| C++ | 実行ファイル | 16〜37KB |
| Swift | 実行ファイル | 27〜51KB |
| Quidra | 実行ファイル | 227〜288KB |
| Go | 実行ファイル | 2.4〜2.5MB |
| Zig | 実行ファイル | 3.6〜3.7MB |
| Rust | 実行ファイル | 4.4MB |
| Kotlin | .jar(ランタイム込み) | 5.5MB |
| Java | .class(別途JVMが必要) | 1.5〜5.9KB |
| TypeScript | .js(別途Node.jsが必要) | 1.6〜5.2KB |
| Python | なし(ソースのまま実行) | 0 |
Quidraは,ネイティブの実行ファイルを作る言語の中では,C++・Swiftに次いで3番目に小さいサイズでした.
ただし,スコアは1.70(6位)です.
これは成果物が0バイトのPythonを基準にスコアを計算しているためで,ネイティブの実行ファイルを作る言語は,いちばん小さいC++でも17点ほど,数MBあるGo・Zig・Rustは1点未満になっています(どの言語もstripなし・リンク方法もデフォルトのままなので,サイズは目安として見てください).
安全性
37個の「意地悪なプログラム」(整数オーバーフロー,縮小変換,配列の範囲外アクセス,ゼロ除算,NaN,無限再帰,壊れた入力など)を全言語で実行し,問題を「コンパイル時に検出」「実行時に検出して停止」「クラッシュ」「未定義動作」「気づかずに間違った結果を出す(サイレントバグ)」のどの段階で捕まえられたかを,機械的に判定しています.
| 指標 | Quidra | 順位 |
|---|---|---|
| 型安全性 | 74.58 | 1位 |
| サイレントバグ耐性 | 91.18 | 1位 |
| デバッグのしやすさ | 66.67 | 2位 |
| 境界値の安全性 | 54.55 | 3位 |
| 早期のエラー検出 | 59.81 | 5位 |
| 実行時の安全性 | 41.67 | 5位 |
| メモリ安全性 | 44.44 | 7位 |
| 悪意ある入力への耐性 | 50.71 | 8位 |
型安全性とサイレントバグ耐性は1位でした!
37個のプログラムのうち,Quidraのサイレントバグは3件,未定義動作は0件です(C++は未定義動作15件,サイレントバグ11件).
また,整数オーバーフローと縮小変換を,実行時の入力のパターンまで含めて,すべてエラーメッセージ付きで止められたのはQuidraだけでした.
ただし,RustとZigはここでもリリースビルド(-O・ReleaseFast)で測っていてオーバーフロー検査が外れているので,Rustのデバッグビルドや Zig の ReleaseSafe なら同じように止まります.ここは言語の差というより,測定条件の差も大きいです.
ただ,メモリ安全性や実行時の安全性は低めでした.
原因は配列の範囲外アクセスや無限再帰のケースで,Quidraはこれらをエラーコード付きで止めているのですが,
Quidra runtime error[INDEX_BOUNDS] at 5:15: index -1 outside length 5
このメッセージが判定用の正規表現(out of bounds など)に一致せず,「クラッシュ」扱いになってしまいました.
とはいえ,一般的な言い回しに寄せるのは読む人にとっても親切なので,改善したいと思います.
言語設計
言語設計は,LLMが指標ごとに固定の採点基準(5項目×0〜4段階)で判定しています.
なお,この8指標は,Sonnet 5が以前に集めた根拠をもとに,別のモデル(GPT-5.6 Sol)が現行の採点基準で判定し直したものです.
| 指標 | Quidra | 順位 |
|---|---|---|
| 可読性 | 95 | 1位(Goと同率) |
| 診断(エラーメッセージ) | 100 | 1位(Rustと同率) |
| 依存関係のシンプルさ | 100 | 1位(Rust・Goと同率) |
| 簡潔さ | 90 | 3位(Python・TypeScriptと同率) |
| 移植性 | 90 | 5位(Python・Rustと同率) |
| 表現力 | 85 | 7位(Javaと同率) |
| 他言語との連携(FFI) | 70 | 7位(Pythonと同率) |
| 並行処理 | 55 | 10位 |
可読性は「型・書き換え可能な参照(&)・制御フロー・エラーの伝播が,少ない記号で明示されている」,エラーメッセージは「安定したエラーコード,位置情報,JSON出力がある」と評価されました.
逆に並行処理は,task.all と atomic.Counter くらいしかなく,キャンセルやチャネルなどが無い点で最下位でした.
LLM適性
LLMにとって扱いやすい言語かどうかを,2つの評価で測りました.
学習しやすさ(LLM学習容易性)
LLMに言語の仕様(ルールの抜粋)を渡して,その場で学んで正しく書けるかを測る評価です.
事前に知っている言語が有利にならないよう,キーワードを glim や fenta のような意味のない単語に置き換えたり,架空のルールを追加したりします.
| 条件 | 内容 | 重み | Quidra |
|---|---|---|---|
| I1 | キーワードを架空の単語に置き換える | 20% | 96 |
| I2 | 標準ライブラリの名前も置き換える | 20% | 57.33 |
| I3 | 区切り記号などの,見た目の文法を変える | 15% | 100 |
| I4 | 架空の新ルールを,仕様から学んで使う | 20% | 100 |
| I5 | 別々に教えたルールを,組み合わせて使う | 15% | 34 |
| I6 | なじみのある単語に,普段と違う意味を持たせる(例:for と while を入れ替える) |
10% | 12 |
結果は71.97で10位でした.
I1・I3・I4(特にI3・I4は満点)では健闘したものの,I2・I5・I6の3つは10言語中最下位でした.
特にI2は,3回とも最初のコードがコンパイルに通らず,修正を1〜2回してようやく正解できたので,57.33にとどまっています.
失敗の中身を見ると,波かっこ・セミコロン・for (int v : values)・void main() のようなC言語系の構文や,Python風の行末のコロン,values.append(x) のようなメソッド呼び出しを関数呼び出しの形で書いてしまうなど,他の言語の書き方に引きずられてしまったものがほとんどでした.
I5・I6の課題はLLMのワーカーが言語ごとに作る方式で,他の多くの言語(Python・C++・Goなど)では「おもちゃの言語のルールを,よく知っている言語で実装する」課題だったのに対し,Quidraは「Quidra自身の構文を組み合わせて書く」課題になっていました.Quidraには少し厳しい条件だったので,この点は差し引いて見てもらえると嬉しいです.
実用性(LLM実用性)
こちらは,LLMに何も資料を渡さずに,実用的なプログラムを書かせる評価です.
課題は,SVM(サポートベクターマシン)・GMM(混合ガウスモデル)・自動微分の3つで,それぞれ「仕様から実装」と「C++の参照実装から移植」の2パターン×3試行,計18試行です.
コンパイルエラーやテストの失敗があれば,その内容を返して最大3回まで修正させます.
正解の判定には,LLMに見せない隠しテストも使っています.
なお,モデルに渡したQuidraの情報は「言語名」と「ビルドコマンド」だけです.
結果は4.91で10位でした.
18試行すべてで最初のコードがコンパイルに通らず,修正を含めた72回の生成でも,テストに通るプログラムは1本も書けませんでした.
失敗の多くは,他の言語の書き方を持ち込んだもので,例えばこんな感じです.
| LLMが書いてしまいがちなもの | Quidraコンパイラの反応 |
|---|---|
int main() を定義する |
error[RESERVED_MAIN] Function name 'main' is reserved. |
import math と書く |
error[STANDARD_NAMESPACE_IMPORT] Standard namespace 'math' is always available and cannot be imported. |
Rust風に fn add(a: i64, b: i64) -> i64 と書く |
error[PARSE_ERROR] fn requires '<Result>' before its parameter list. |
C風に { でブロックを書く |
error[LEX_ERROR] Unexpected character in source. |
当然ですが,Quidraは公開されてまだ間もない言語で,Claude Sonnet 5はQuidraを未学習なので,何も見ずに書かせると動くプログラムが1本も書けない,となるのは妥当な結果です.
面白いのは,Zigも5.24(9位)で,同じく1本も書けなかったことです.
Zigの失敗は,最新版(0.16)の標準ライブラリのAPIが,モデルの記憶と食い違っていたことが原因でした.
つまりこの評価は,「言語の書きやすさ」よりも「モデルがその言語(の最新版)をどれだけ知っているか」を強く反映しています.
ちなみに,QuidraとZigは,正しさに関わる指標がどちらも全部0点で,差がついたのは,APIが記録したトークン数からスクリプトで計算する「トークン効率」の2指標(重みは各3%)だけでした.
どちらも72回の生成を使い切って失敗しているので,これは実質「失敗するまでに何トークン使ったか」の比較です.
Quidraは回答が長くなりがちで(72回中5回は出力上限の16,384トークンで打ち切り),18試行で使ったトークンの合計もZigの約1.5倍だったため,0.33点差でZigが上になりました.
なので,書く力としては実質的に同点と見てもらえればと思います.
実は,Quidraの失敗のほとんどは,LLM向けのガイド(docs/spec/llm-guide.md)や言語仕様に書いてあるルール(トップレベルの文がエントリポイントになる,標準の名前空間はimportしない,ブロックは4スペースのインデントで書く,戻り値の型を先に書く)に反するものでした.
今後は,ガイドを渡した条件でも測ってみたいと思います.
エコシステム
最後に,ライブラリ・ツール・コミュニティなどの充実度です.
LLMがWeb検索で調べた結果を,固定の基準で採点しています.
結果は,Quidraが32.50で10位でした(外部のエコシステム 9.0,ツールチェーン 56.0).
リリースからまだ間もない言語なので,サードパーティ製のライブラリや本番での採用実績,Q&Aサイトの情報などはほぼゼロです.
当然の最下位ですね笑
それでも,公式ドキュメントやブラウザで動くPlayground,フォーマッタ・REPL,依存関係を固定するロックファイル(SHA-256のハッシュ付き)など,ツールチェーン自体は一定の評価をもらえました.
ここはまさに,みなさんの力が必要なところです!
ベンチマークの注意点
- 順位は今回の測定結果をそのまま並べたもので,統計的な優劣を主張するものではありません.
- 意味圧縮性能のコード断片と注釈はLLMによるもので,コンパイルでの確認まではしていません.また,言語ごとに別々のワーカーが注釈していて数え方も少しずつ違うので,特に上位3言語(Zig・Quidra・Swift)は,注釈1か所で順位が入れ替わる程度の接戦です.
- 実行速度はGitHub Actionsの共有ランナー上での計測なので,絶対的な速さではなく,同じ環境での比較として見てください.
- 言語品質で使ったプログラム(10言語×11本)は,Quidra版も含めて筆者側で用意したものです(全言語で同じアルゴリズム・同じ入力にそろえ,出力の正しさは機械的に検証しています).
- LLM適性の結果は,使ったモデル(Claude Sonnet 5)とその知識に強く依存します.
今後やりたいこと
今回のベンチマークで,Quidraの伸びしろがはっきり見えました.
- 網羅性を上げる:クロージャ,インターフェース(実行時のディスパッチ),配列のスライス,比較関数付きのソートなど
- ファイルI/Oの高速化:Zigの45倍遅いのは,さすがに...
-
LLMにやさしいエラーメッセージ:
&&と書かれたら「andを使ってください」と教えてあげる,など - エコシステムを育てる:ライブラリやエディタの拡張機能など
特に網羅性は,1課題増やすだけで意味圧縮性能1位に並ぶ計算なので,まずはここから攻めていきたいと思っています!
まとめ
「1トークンあたりの意味最大化」を目的としたQuidraという言語を開発しました.
10言語でベンチマークを行ったところ,意味圧縮性能は2位(網羅性を除いた品質Qだけなら1位),言語品質は4位という結果になりました.
一方で,LLMの事前知識やエコシステムはまだまだで,ここはこれからみんなで育てていきたい部分です.
ぜひ,使ってみてください!
- GitHub:https://github.com/quidra-lang/quidra
- Playground(インストール不要.ブラウザで型チェックや整形を試せます.実行はローカル環境で):https://quidra-lang.github.io/playground/
コラボレーターも絶賛募集中です! スターやIssue,PRもお待ちしています!
最後まで読んでいただき,ありがとうございました!