
はじめに
生成AIを使った開発が広がる中で、Claude CodeやCodex、Cursor、GitHub Copilotなどを活用した「AI駆動開発」に興味を持つようになりました。
ただ、実際にAI駆動開発を行う場合、
- AIにどこまで実装を任せられるのか
- 人間はどこで判断する必要があるのか
- AIが生成したコードをどのようにレビューするのか
- 設計からテストまでAIを活用できるのか
といった点が気になりました。
そこで今回は、Claude Codeを開発パートナーとして活用し、1日でRAG(Retrieval-Augmented Generation)アプリのMVPを設計・実装・テスト・GitHub公開まで行いました。
この記事では、RAGそのものの技術だけではなく、
AI駆動開発において、AIに何を任せ、人間が何を判断したのか
という点を中心に振り返ります。
今回作ったもの
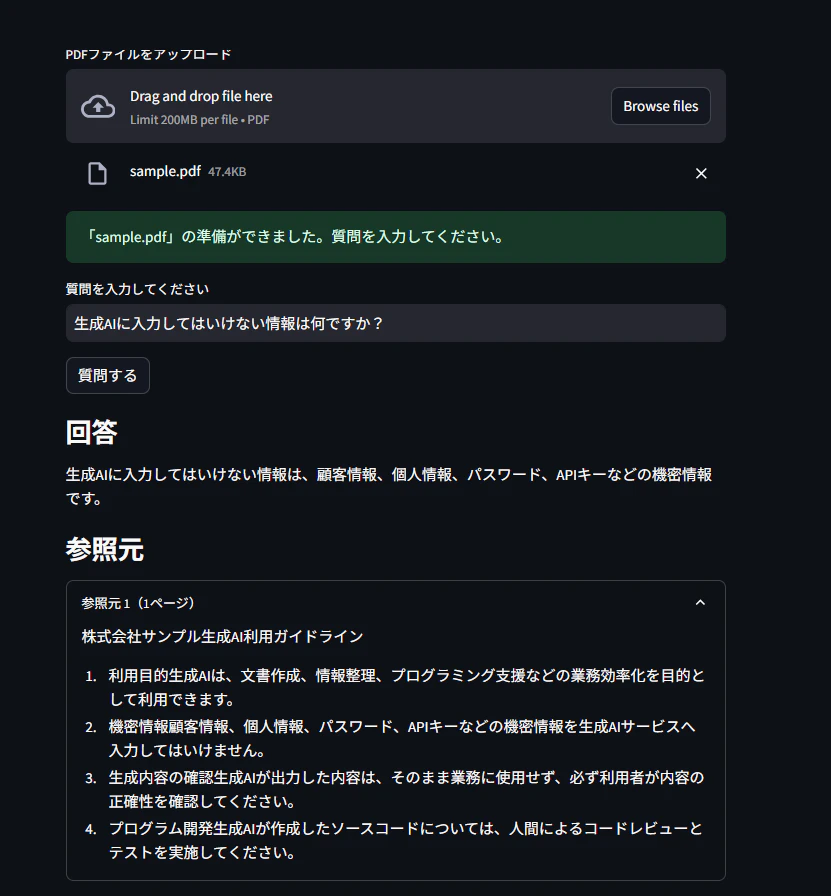
今回作成したのは、PDFをアップロードして、その内容について自然言語で質問できるRAGアプリです。
例えば、社内規程やマニュアルをPDFとしてアップロードして、
生成AIに入力してはいけない情報は何ですか?
と質問すると、PDFの内容を検索したうえで回答を生成します。
さらに、回答だけではなく、
- 根拠となったPDF本文
- ページ番号
も表示するようにしました。
主な機能
- PDFファイルのアップロード
- PDFからのテキスト抽出
- PDF内容に対する自然言語での質問
- RAGによる回答生成
- 回答の根拠となった本文・ページ番号の表示
実行画面
以下のように、PDFをアップロードして質問すると、回答と参照元を確認できます。
なぜRAGアプリにしたのか
今回想定した業務課題は、
社内マニュアルや規程、技術資料から必要な情報を探すのに時間がかかる
というものです。
通常、長いPDFから必要な情報を探す場合、人間が目視で資料を確認したり、キーワード検索したりする必要があります。
そこで、
質問
 ↓
質問に関連するPDFの文章を検索
 ↓
検索した文章をLLMへ渡す
 ↓
PDFの内容を踏まえて回答
というRAGを利用することで、必要な情報を自然言語で取得できるようにしました。
また、LLMの回答だけを表示すると「その回答の根拠はどこなのか」が分かりません。
そのため今回は、回答と合わせて参照した本文とページ番号も表示することにしました。
使用技術
今回使用した主な技術は以下です。
| 技術 | 用途 |
|---|---|
| Python | アプリケーション実装 |
| Streamlit | Web UI |
| LangChain | RAGパイプライン |
| PyPDF | PDFテキスト抽出 |
| OpenAI API | Embedding・回答生成 |
| text-embedding-3-small | Embeddingモデル |
| gpt-4o-mini | 回答生成 |
| FAISS | ベクトル検索 |
| pytest | テスト |
| Claude Code | AI駆動開発 |
今回は1日でMVPを完成させることを重要な制約としました。
そのため、FastAPI、React、データベース、認証、クラウドへのデプロイなどは対象外とし、RAGのコア部分に集中しています。
システム構成
全体の処理フローは以下です。
ユーザー
  │
  ▼
Streamlit
  │
  │ PDFアップロード
  ▼
PyPDFLoader
  │
  │ ページ単位でテキスト抽出
  ▼
RecursiveCharacterTextSplitter
  │
  │ チャンク分割
  ▼
OpenAI Embeddings
(text-embedding-3-small)
  │
  │ ベクトル化
  ▼
FAISS
  │
  │ 類似検索
  ▼
Retriever
  │
  │ 関連チャンク
  ▼
LLM
(gpt-4o-mini)
  │
  ▼
回答 + 参照元本文 + ページ番号
RAGの処理を簡単に理解する
今回、自分自身の理解を深める意味でも、RAGが何をしているのか整理しました。
1. PDFから文章を取得する
まず、アップロードされたPDFから文章を抽出します。
ただし、PDF全体をそのままLLMに渡すのではなく、文章を一定の大きさに分割します。
これがチャンク分割です。
今回は以下の設定としました。
chunk_size = 1000
chunk_overlap = 200
chunk_overlap を設定することで、チャンクの境界部分で文脈が完全に切れてしまうことをある程度防ぎます。
2. 文章をEmbeddingする
次に、それぞれのチャンクをEmbeddingモデルによってベクトル化します。
今回使用したモデルは以下です。
text-embedding-3-small
Embeddingによって、文章を意味的な特徴を持つ数値ベクトルとして扱えるようになります。
例えば、
「生成AIに入力してはいけない情報は?」
という質問と、
「顧客情報、個人情報、パスワード、APIキーなどの
機密情報を生成AIサービスへ入力してはいけません。」
という文章は意味的に近いため、Embeddingによって意味の近さを数値的に扱えるようになります。
3. FAISSで類似文章を検索する
EmbeddingしたチャンクはFAISSに登録します。
ユーザーの質問についてもEmbeddingを行い、質問のベクトルと類似するチャンクを検索します。
イメージとしては以下です。
質問
「生成AIに入力してはいけない情報は?」

        ↓ Embedding

質問ベクトル

        ↓ FAISSで類似検索

関連度の高いPDFチャンク
今回、FAISSは永続化せず、メモリ上のみで保持する構成にしました。
本番システムであれば永続化や外部ベクトルDBなども検討対象になります。
しかし今回は、
- 1日で作る
- 単一PDF
- 単一ユーザー
- ポートフォリオ用途
という条件だったため、シンプルさを優先しました。
4. 検索結果をLLMに渡す
FAISSが回答そのものを作っているわけではありません。
FAISSの役割は、質問に関係しそうな文章を探すことです。
検索した文章とユーザーの質問をLLMに渡します。
質問
+
FAISSで取得した関連文章
        ↓
      LLM
        ↓
      回答
今回の回答生成には gpt-4o-mini を使用しました。
この、
検索(Retrieval)+生成(Generation)
を組み合わせているのがRAGです。
Claude Codeを使ったAI駆動開発
ここからが、今回一番試したかった部分です。
今回、Claude Codeには単純に、
「RAGアプリを全部作って」
とは依頼しませんでした。
AIを実装担当兼開発パートナーとして利用し、重要な意思決定は人間が行う方針にしました。
基本的な流れは以下です。
人間
  │
  │ 要件・制約を提示
  ▼
Claude Code
  │
  │ 設計案・選択肢を提示
  ▼
人間
  │
  │ レビュー・判断
  ▼
Claude Code
  │
  │ 実装
  ▼
人間
  │
  │ 動作確認
  ▼
Claude Code
  │
  │ テスト・エラー分析・修正
  ▼
人間
  │
  │ 最終レビュー
  ▼
GitHub公開
最初からコードを書かせなかった
最初にClaude Codeへ依頼したのは実装ではなく、実装計画の作成です。
例えば、
- 使用するEmbeddingモデル
- 使用するLLM
- ベクトルストア
- 永続化するか
- 参照元をどう表示するか
- APIテストをどうするか
などを整理してもらいました。
そのうえで、人間側で内容を確認してから実装へ進みました。
この進め方にした理由は、AIがコードを高速に生成できたとしても、
「なぜその構成なのか」までAI任せにしてしまうと、自分自身が設計を説明できなくなる
と考えたためです。
AIの提案を人間が修正した例
今回、AI駆動開発で特に印象に残ったのが、AIの出力を人間がレビューする重要性です。
設計段階でClaude Codeに計画を作成してもらった際、まだ人間側で承認していない技術選定について、AIが「承認済み」と記載してしまう場面がありました。
しかし、実際の流れは以下です。
Claude Codeが選択肢を提示
        ↓
人間が内容を確認
        ↓
人間が技術選定
        ↓
計画を確定
そこで、人間側から誤りを指摘し、計画書を修正してもらいました。
小さな表現の違いにも見えますが、AI駆動開発では非常に重要だと感じました。
AIが生成したドキュメントを無条件に正しいものとして扱うと、
実際には行っていない意思決定が、あたかも行われたかのように記録される
可能性があります。
コードだけでなく、設計書や開発記録についても人間によるレビューが必要だと実感しました。
エラー対応もClaude Codeと行った
実装後は実際にブラウザから動作確認を行いました。
その中で、いくつかエラーにも遭遇しました。
Windowsパスの違いによるFileNotFoundError
動作確認用PDFを生成する際、
FileNotFoundError
が発生しました。
原因は、
- Bashが扱うPOSIX形式のパス
- WindowsネイティブPythonが扱うパス
の違いでした。
Claude Codeがエラー内容を解析し、Windows側で扱えるパスへ修正したうえで再実行しました。
その後、PDFの読み込みまで正常に確認できました。
ここで興味深かったのは、
AIがコードを書くところだけではなく、実行結果を確認し、エラーを解析し、修正して再検証するところまで利用できる
という点です。
OpenAI APIのクレジット不足
もう1つ詰まったのがOpenAI APIでした。
PDFアップロードとテキスト抽出までは成功したものの、その後のEmbedding生成で処理が進みませんでした。
処理を整理すると以下になります。
PDFアップロード
      ↓
PDFテキスト抽出
      ↓
チャンク分割
      ↓
Embedding ← ここでOpenAI APIを利用
      ↓
FAISS
      ↓
LLM ← ここでもOpenAI APIを利用
原因を確認した結果、コードやアーキテクチャではなく、OpenAI API側のクレジット不足でした。
クレジット追加後に再度実行すると、
PDFアップロード
→ テキスト抽出
→ 質問
→ RAG回答
→ 参照元表示
まで正常に動作しました。
この経験から、エラーが発生した際にはすぐコードを変更するのではなく、
コードの問題なのか、設定なのか、外部サービスなのか
を切り分けることが重要だと改めて感じました。
テストではOpenAI APIをモック化
テストには pytest を使用しました。
最終的に8件のテストを作成し、すべてPASSしました。
8 passed
また、テストのたびにOpenAI APIを実際に呼び出す構成にはしませんでした。
API呼び出し部分をモック化することで、
- APIキーがなくてもテストできる
- API料金を発生させずにテストできる
- 外部APIの状態にテスト結果が左右されにくい
という構成にしました。
一方、最終的な動作確認についてはモックではなく、実際のOpenAI APIを利用してブラウザから確認しています。
実際にどこまでAIに任せたのか
今回の役割分担を整理すると以下のようになりました。
| 項目 | Claude Code | 人間 |
|---|---|---|
| 要件・目的 | - | 決定 |
| 実装計画 | 作成 | レビュー |
| 技術選択肢 | 提案 | 最終決定 |
| コーディング | 主に担当 | レビュー |
| テストコード | 作成 | 方針確認 |
| エラー分析 | 主に担当 | 結果確認 |
| 動作確認 | 支援 | 最終確認 |
| README | 作成・修正 | 内容確認 |
| GitHub公開 | 操作支援 | 公開判断 |
実際にやってみて、AI駆動開発は、
AIにすべてを任せる開発
というより、
AIによって実装・調査・修正の速度を上げながら、人間が要件・設計・品質に責任を持つ開発
と考える方がしっくりきました。
AI駆動開発で特に効果を感じたところ
今回特に効果を感じたのは、以下の3点です。
1. 実装速度
プロジェクト構成からRAGパイプライン、Streamlit UI、テストまで、一連の実装を短時間で進めることができました。
人間は細かなコードを一行ずつ書くことより、
「この構成で要件を満たせるか?」
という確認に時間を使えました。
2. エラー調査
エラー内容をClaude Code自身が確認できるため、
エラー発生
 ↓
原因分析
 ↓
修正
 ↓
再実行
というサイクルを高速に回せました。
3. ドキュメント作成
実装内容をもとに、
- README
- アーキテクチャ説明
- セットアップ方法
- AI駆動開発記録
まで作成できました。
実装とドキュメントの乖離を減らしやすいのもメリットだと感じました。
一方で、人間が必要だと感じたところ
今回最も大きな学びだったのは、
AIが高速になればなるほど、人間の判断が不要になるわけではない
ということです。
むしろAIが高速に大量のコードやドキュメントを生成できるため、
- 要件を満たしているか
- 不要な機能を作っていないか
- 設計として妥当か
- AIの説明に誤りがないか
- 秘密情報を公開していないか
- どこまでを今回のスコープとするか
といった判断が重要になりました。
今回もGitHubへ公開する前に、
-
.envがGit管理対象外であること - APIキーが公開ファイルに含まれていないこと
.venv__pycache__.pytest_cache
などがGitの追跡対象になっていないことを確認してから公開しました。
特にAI駆動開発では、
「AIができるか」ではなく「AIに何を任せ、人間がどこをレビューするか」を設計する
ことも開発の一部になると感じました。
1日で完成させるために「やらないこと」を決めた
今回、意外と重要だったのがスコープ管理でした。
途中で、
- FastAPI
- React
- Docker
- CI/CD
- 認証
- データベース
- 複数PDF
- チャット履歴
- 高度なEvaluation
- クラウドデプロイ
などを追加することもできました。
しかし今回は、あえて実装しませんでした。
目的は、
高機能なRAGシステムを作ることではなく、AI駆動開発でRAGのMVPを1日で完成させること
だったためです。
AIを使うと機能追加自体は簡単になるため、逆に**「どこで完成とするか」**を人間が決めることが重要だと感じました。
今後改善したいこと
今回は1日でMVPを完成させることを優先したため、まだ改善できる部分があります。
例えば、
- 複数PDFへの対応
- ベクトルストアの永続化
- RAG Evaluationの導入
- 回答品質の定量評価
- 認証・認可
- Docker化
- CI/CD
- クラウドへのデプロイ
- Observability
- プロンプトや検索パラメータの評価
などです。
特に次のステップでは、
「動くRAG」から「品質を評価・改善できるRAG」へ
発展させてみたいと考えています。
まとめ
今回、Claude Codeを活用して、RAGアプリのMVPを1日で設計・実装・テスト・GitHub公開まで行いました。
実際に使ってみて感じたのは、AI駆動開発は単なる「AIによるコード生成」ではないということです。
AI
・設計案の提示
・コード生成
・テスト作成
・エラー分析
・修正
・ドキュメント作成

        ×

人間
・目的を決める
・スコープを決める
・技術選定を判断する
・AIの出力をレビューする
・品質を確認する
・最終的な責任を持つ
この組み合わせによって、短時間でも開発サイクル全体を回すことができました。
一方で、AIが生成した計画に誤りが含まれていたことや、実行時エラー、APIクレジットの問題なども経験しました。
そのため今回の経験からは、
AI駆動開発で重要なのは、AIに全部任せることではなく、AIに任せる部分と人間が判断する部分を明確にすること
だと感じています。
今後はRAGのEvaluationやObservabilityなどにも取り組み、単に「生成AIを使ったアプリを作れる」だけではなく、生成AIシステムの設計・評価・改善まで考えられるようになることを目指したいと思います。