
📝 はじめに

S3Vectorsが全文検索に対応しました。
この記事では全文検索の定番であるOpenSearchとS3Vectorsを比べてみました。
👀 対象読者
- OpenSearch全文検索のコストが高すぎてヒィヒィ言ってる方
- 小さめの全文検索機能を安く作りたい方
 アップデートの中身
2026年11月17日にS3Vectorsがハイブリッド検索に対応しました。
アップデートに関する詳細はこちらの記事が神速でまとめられていたのでご参照ください。
公式ドキュメント読むと...これ...全文検索エンジンとして使えるのでは ?
と、いうことでハイブリット検索ではなく全文検索検証やってみました‼️
⛏️ 早速やってみる

LambdaからサクッとS3Vectorsを呼んでみましょう。インデックスを作るときにtextSearchConfigurationsで本文のキーを指定してアナライザーは日本語(ja)にしています。
Lambdaのコード全体
import boto3

BUCKET = "s3v-fts-test-20261117"
INDEX = "idx-ja-lambda"

# 全文検索だけ使いたいがベクトルは必須なので1次元のダミーを入れる
DUMMY = {"float32": [1.0]}

s3v = boto3.client("s3vectors")


def setup():
    # インデックスを作る。ベクトルは使わないので1次元にしておく
    s3v.create_index(
        vectorBucketName=BUCKET, indexName=INDEX, dataType="float32",
        dimension=1, distanceMetric="cosine",
        metadataConfiguration={
            # 本文はフィルタに使わないので対象外にする(2KBの上限を避ける)
            "nonFilterableMetadataKeys": ["body"],
            # bodyを全文検索の対象にして、アナライザーは日本語にする
            "textSearchConfigurations": [{"metadataKey": "body", "language": "ja"}],
        },
    )


def put(docs):
    # データを入れる。本文はメタデータのbodyに入れ、ベクトルは全件同じダミー
    vecs = [{"key": k, "data": DUMMY, "metadata": {"body": t}} for k, t in docs]
    s3v.put_vectors(vectorBucketName=BUCKET, indexName=INDEX, vectors=vecs)


def search(text):
    # queryVectorを渡さずqueryTextsだけにすると全文検索(BM25)だけになる
    r = s3v.query_vectors(
        vectorBucketName=BUCKET, indexName=INDEX, topK=15,
        queryTexts=[{"text": text, "metadataKey": "body"}],
        returnScores=True,    # BM25のスコアも返してもらう
        returnMetadata=True,  # 本文も一緒に返してもらう
    )
    # スコアはscores.bm25Scores[0].scoreに入っている
    return [
        (v["key"], v["scores"]["bm25Scores"][0]["score"], v["metadata"]["body"])
        for v in r["vectors"]
    ]


def lambda_handler(event, context):
    action = event["action"]
    if action == "setup":
        return setup()
    if action == "put":
        return put(DOCS)  # DOCSは15件の短文(省略)
    if action == "search":
        return search(event["text"])
全文検索ではベクトルは使いませんが書き込み(PutVectors)ではベクトルが必須です。なのでベクトルは1次元の[1.0]というダミー値にしました。
日本語の短文15件を入れて検索してみると「京都」で「東京都」が引っかからず「食べる」では活用形まで拾ってくれました。
🔍 機能を比べる
| S3Vectors | OpenSearch | |
|---|---|---|
| レイテンシー(公式) | ウォーム約100ms/コールド1秒未満 | 数十msも狙える |
| 日本語 |
ja(中身はいじれない) |
kuromoji(フィルターの組み合わせを自分で決められる) |
| 複数語の検索 | ORだけ | AND/OR/フレーズ/あいまい検索 |
| 並べ替え | スコア順だけ | 好きな項目で |
| ハイライト | なし | あり |
| ファセット/集計 | なし | あり |
| 書き込み | ダミーのベクトルが必要 | テキストだけでOK |
| 準備の手間 | ほぼゼロ(バケットとインデックスを作るだけ) | 少し(ポリシー3つとコレクショングループ) |
S3VectorsはBM25で上位K件を返すだけのシンプルな検索です。ファセットや並べ替えまで作り込むならOpenSearchのほうが機能がそろっています。
🧪 実機で比べてみた

ここからは実際に同じデータを両方に入れて比べます。相手はOpenSearchServerlessの新世代(NextGen)で、計測はus-east-1に置いたLambdaから行いました。
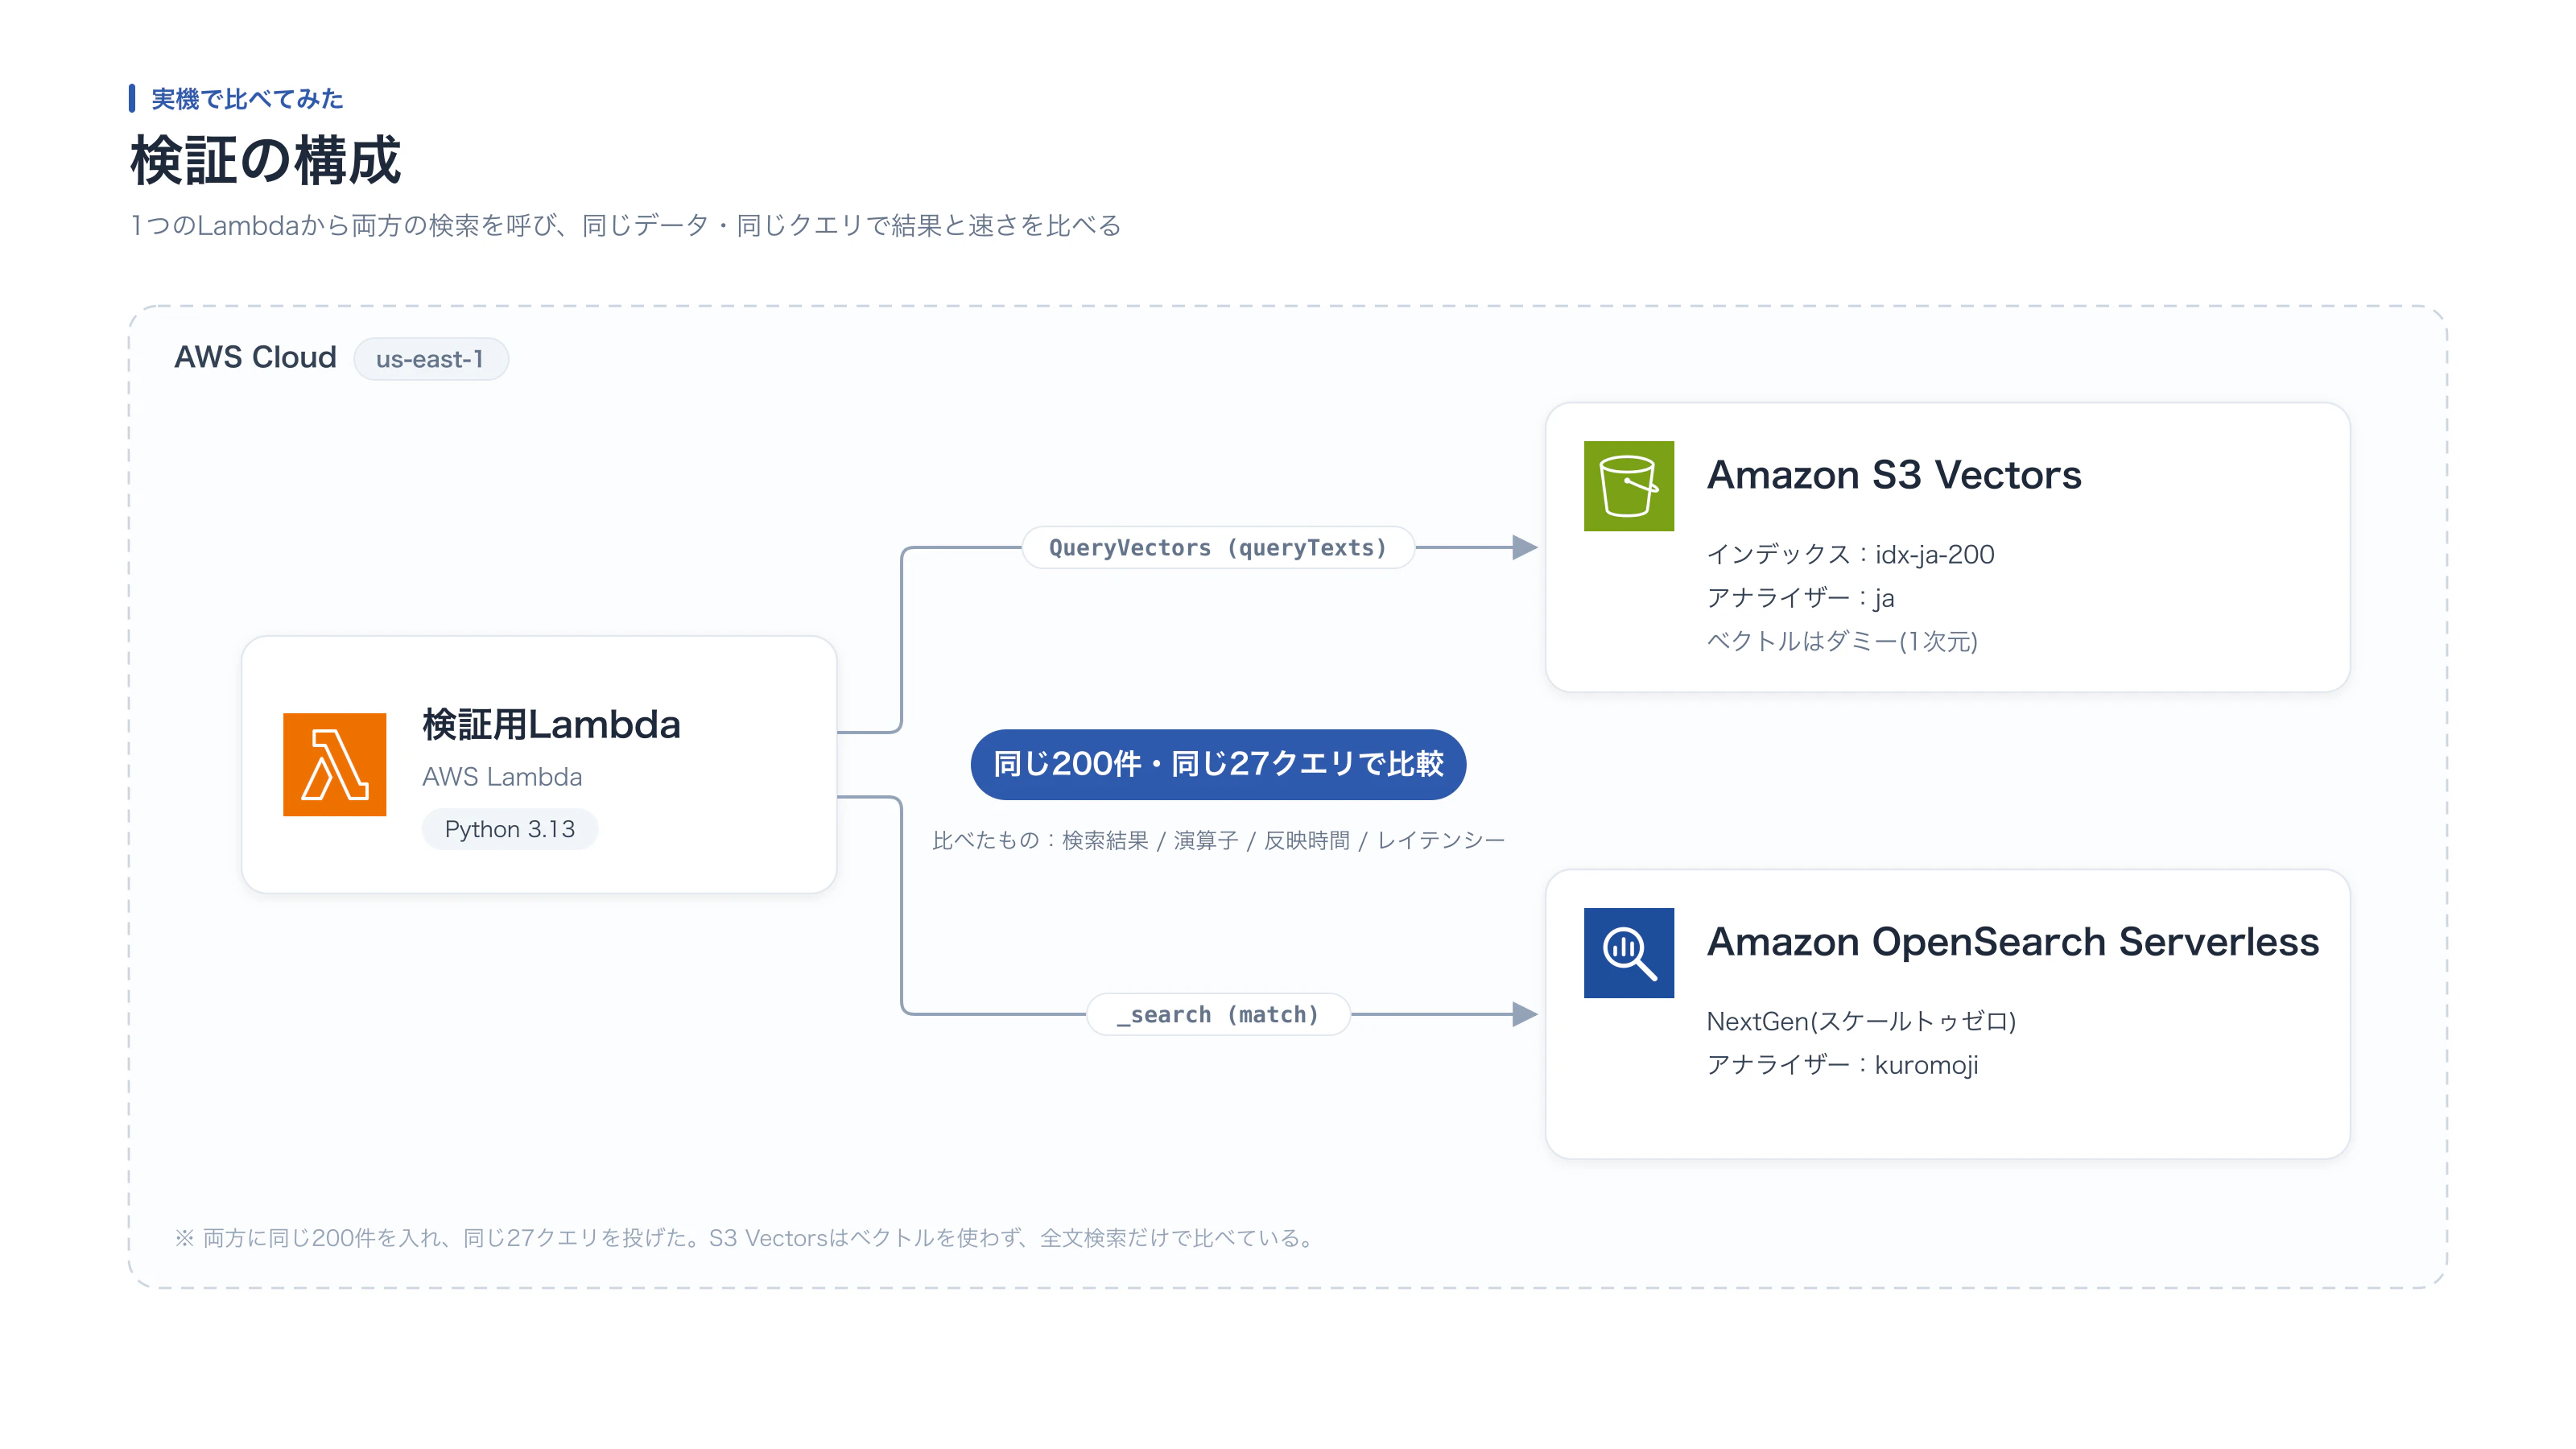
データは日本語の短文200件とクエリ27件で、表記ゆれ・活用・複合語・似た地名・英数字・語順・記号入りの文を混ぜています。
コールドスタートを避けるため1回空打ちしてから計測しています。
🔎 検索結果の違い
27クエリ中22クエリはヒットした文書が同じで、違ったのは順位だけでした。差が出たのはサーバーとABC-100の2つで、どちらも日本語の切り方の違いによるものです(後述します)。大体の検索ではkuromojiとほぼ同じ結果と言ってよさそうです。
🧮 演算子は効くのか?
S3Vectorsの公式ドキュメントには演算子についての説明がありません。クエリの文字列は本文と同じアナライザーで単語に切られると書かれているだけです。効かないだろうなぁ...とは思いつつ一応試してみました。
| クエリ | 確かめたいこと | S3Vectors | OpenSearch(DSL) |
|---|---|---|---|
"東京から大阪" |
フレーズ検索 | クォートなしと同じ | match_phraseで4件(「東京と大阪」も当たる) |
検* |
前方一致 | ヒットなし | prefixで上限の10件まで当たる(「定期検診」も) |
猫 AND 窓 |
AND | 猫か窓のどちらか | bool mustで1件(猫が窓を開けてほしいと…) |
猫 -ネコ |
除外 | ネコの文も出る | bool must_notで6件 |
スマホ OR スマートフォン |
OR | スマホの文もスマートフォンの文も出る | bool shouldで3件 |
S3Vectorsでは演算子は使えませんでした(そりゃそうか...)
⚡ 速さ
検索の速さと1件書き込んでから検索に出るまでの時間を計りました。
| S3Vectors | OpenSearch | |
|---|---|---|
| 検索 | 約60ms | 約30ms |
| 書き込んでから検索に出るまで | すぐ(直後の検索で見つかる) | 1〜5秒ほど |
検索はOpenSearchのほうが2倍ほど速い結果でした(200件での計測)。一方で書き込みの反映はS3Vectorsが速く、書いた直後の検索でもう見つかります。OpenSearchServerlessは書いてすぐ検索したい用途だと数秒の待ちを見込む必要があります。
💰 コスト(公式料金表から算出)

【前提】
- 24時間稼働、us-east-1
- 本文は日本語で1件あたり平均1KB、月1回全件を入れ替える
- データとアクセスは「1万件・1分に1クエリ」と「10万件・1秒に1クエリ」の2パターン
OpenSearchServerlessの新世代(NextGen)には10分アクセスがないとゼロまで縮むスケールゼロの機能があります。今回は24時間稼働で常にアクセスがある前提なのでゼロまでスケールしないものとして計算しています。
| S3Vectors | OpenSearchServerless | |
|---|---|---|
| 1万件・1分に1クエリ | 約$0.1/月 | 約$175〜350/月 |
| 10万件・1秒に1クエリ | 約$7/月 | 同上 |
| 課金の形 | 使った分だけ | OCUの起動時間 |
S3Vectorsは固定費がなくほぼクエリ1回ごとの料金だけです(100万クエリで約$2.5)。OpenSearchServerlessはOCUが起きている時間で課金されるので、前提のように常にアクセスがあると検索用のOCUが動き続けて実質固定費になります。アクセスがよほど多くない限りコストだけならS3Vectorsの圧勝です。
✂️ 日本語の切り方の違い

日本語は英語と違って単語の間にスペースがありません。「東京都」を「東京/都」と切るか「東/京都」と切るかで「京都」で当たるかが変わるので、全文検索の精度は切り方しだいです。
| 語 | S3Vectors | OpenSearch | kuromojiの切り方 | 何が起きているか |
|---|---|---|---|---|
| 京都 | 東京 / 都(「東京都」の場合) | どちらも「東京都」の文には当たらない | ||
| サーバー | 2件 | 3件 | サーバ | OpenSearchだけ長音をそろえるので「サーバ」の文も当たる |
| ABC-100 | 1件 | 2件 | abc / 100 | S3Vectorsはハイフンでは切るが「ABC100」は1語のまま扱うので当たらない |
| AWS | 5件 | 5件 | aws | どちらも半角のawsと同じ扱い |
| C++ | 2件 | 2件 | c | どちらも「++」が消えて「c」だけで検索されるのでC++の文にもC言語の文にも当たる |
| 猫 | 7件 | 7件 | 猫 | どちらも「ネコ」「ねこ」だけの文は当たらない |
大きな違いは長音と英字・数字の境目の2つで、どちらもkuromojiのほうが多めに拾ってくれました。それ以外の単語の切り方・原形化・全角半角の正規化はS3Vectorsのjaもkuromojiと同じように動いています。
🧭 S3VectorsとOpenSearchどっちを選ぶ?

| ユースケース | おすすめ | 理由 |
|---|---|---|
| 社内ドキュメントのキーワード検索(数万件程度) | S3Vectors | 上位数件が出れば十分で月十数円で済む |
| テナントごとに分かれた検索 | S3Vectors | インデックスを分けても固定費が増えない |
| ECサイトの商品検索 | OpenSearch | 絞り込み・並べ替え・ハイライトが必須 |
| 表記ゆれが多い文章の検索 | OpenSearch | 長音(サーバ/サーバー)や英字と数字の境目(ABC100/ABC-100)の揺れも拾う |
| アクセスが多く常に速さが要る | OpenSearch | 検索は約2倍速く、一定以上のアクセスがあるならコストも安くなる |
ざっくり分けると小さく手軽に始めたいならS3Vectors、検索の細かいところまでこだわりたいならOpenSearchという感じです。
🍜 締め
今回のアップデートの主役はハイブリッド検索でしたがこの記事ではハイブリッドを差し置いて全文検索ばかりしていました。S3Vectorsからすると「そういう使い方を想定していたわけじゃない‼️」と怒ってるかもしれません(ベクトルdummyで入れてるし)
個人的には日本語アナライザーが最初から入っていてコストもこれだけ安いなら全文検索のデータストアとして単体で使うのも十分ありだと思っています。演算子もファセットもありませんがシンプルな全文検索ならS3Vectorsでも全然いけます。
これまで全文検索をやろうとするとほぼOpenSearch一択でコストが悩みの種でした。そこに月十数円から使える選択肢が出てきたのはとても良いことだと思います