
RAG の回答を LLM Judge(採点役の LLM)で全件チェックすると、費用がかさみます。なので、どこかで間引きたくなります。
RAG 評価の記事に、こんなコメントをもらいました。「Judge は高いので、もっともらしさのスコアが 0.7 を超えた回答にだけ回している。呼び出しは 60% 減って、重大な失敗の検出は落ちていない」。
怖い作り話はもっともらしいほうだから、そこにだけお金をかける。筋の通った工夫です。手元で測ってみました。
結果は、私の測り方では、もっともらしさで絞るのは無作為に間引くのとほぼ同じでした。Judge の呼び出しは減りますが、減ったぶんだけ見逃しが増えます。

| 回し方 | 作り話の検出率 | Judge 呼び出し |
|---|---|---|
| ① 全件に Judge | 85.6% | 100% |
| ② もっともらしさ(9b) > 0.7 だけ | 35.6% | 50% |
| 参考: 無作為に 40% だけ | 34.2% (期待値) | 40% |
| ③ 安い照合が割れたものだけ | 93.1% | 58% |
データは人手で作り話のラベルが付いた公開データセット RAGTruth の QA 320件、モデルはすべて手元の Ollama(Qwen 3.5)です。前提と限界は末尾の「測定条件」にまとめています。
コラム: RAGTruth とは
RAG の回答のうち「どこが作り話か」に、人が印を付けた公開データセットです(GitHub、MIT ライセンス)。
イメージは、赤ペンの入った答案の束です。資料を渡して GPT-4 や Llama-2 などに答えさせた回答が約1.8万件あり、人が「ここは資料に書いていない」「ここは資料と食い違う」と書き込んでいます。
よく使われるのは、RAG の作り話を見つける仕組みの学習や性能比べです(LettuceDetect などの検出器も、このデータで学習して比べています)。私も今回のように、RAG の精度をチェックする指標の1つとして使っています。
この記事では質問応答の回答だけを使い、赤ペンが1つでも入った回答を「作り話あり」としました。正解が人の目で付いているので、Judge やもっともらしさのスコアが作り話を当てられたかを、別の LLM の判定に頼らずに数えられます。
比べた3つの回し方
| 構成 | Judge を回す対象 | 残りの扱い |
|---|---|---|
| ① 全件 | すべて | なし(基準) |
| ② もっともらしさで絞る | もっともらしさ > しきい値 | 「問題なし」とみなす |
| ③ 段階的にふるう | 1文照合と固有名詞の照合で判定が割れたもの | 1文照合の判定を使う |
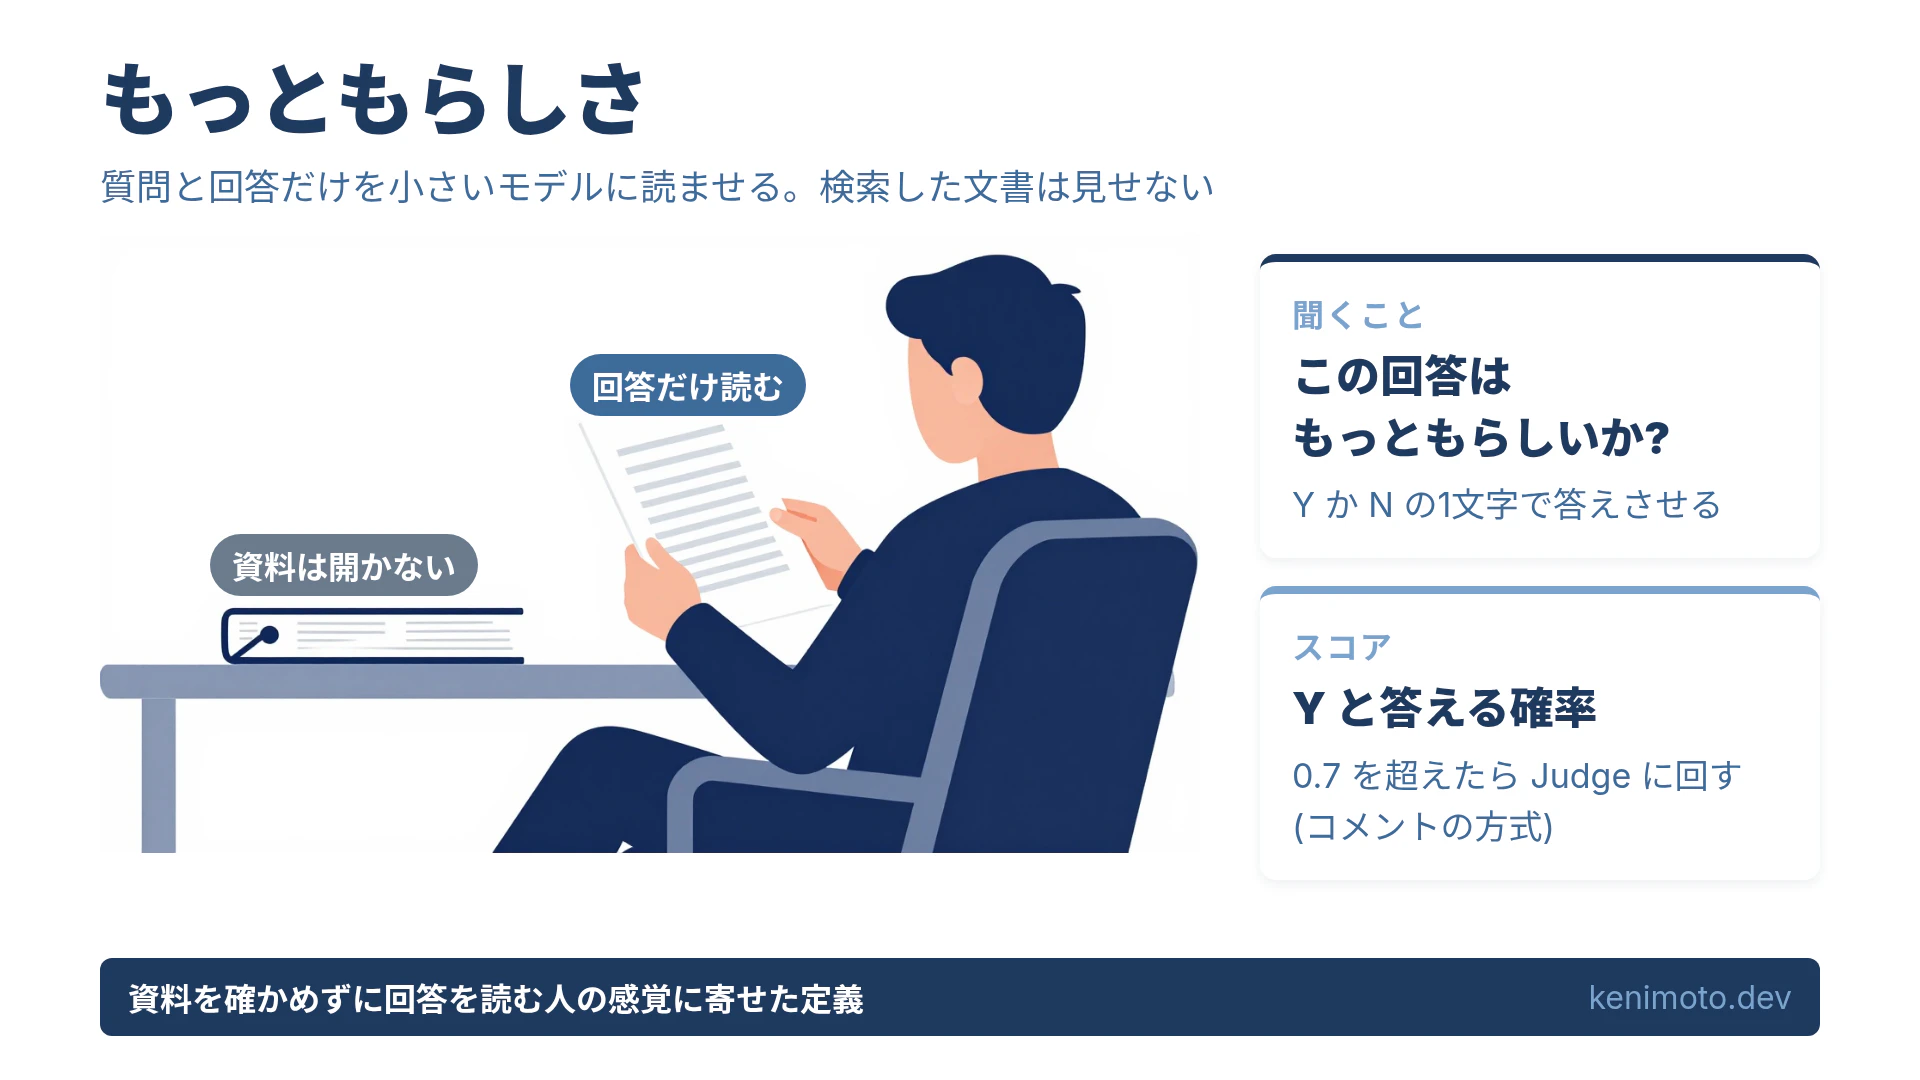
コメントには「もっともらしさ」の定義が書かれていなかったので、こちらで決めました。質問と回答だけを小さいモデルに見せて(文書は見せない)、「この回答はもっともらしいか」を Y か N の1文字で答えさせ、Y の確率を取る。資料を確かめずに回答を読む人の感覚に寄せた定義です。コメント主と同じものを測れているとは限りません。
ほかの部品は次のとおりです。
- 1文照合: 回答を文に分け、1文ずつ「文書から言えるか」を Y/N で答えさせる。一番低い確率を回答のスコアにする(qwen3.5:4b)
- 固有名詞の照合: 回答に出てくる数字と固有名詞のうち、文書に出てくる割合。モデルは使わない
- Judge: 文書・質問・回答を見せ、「回答はすべて文書に裏付けられるか」を Y/N で答えさせる(qwen3.5:9b)
確率は Ollama の logprobs から取っています。1トークンだけ出させて、Y と N の確率を正規化する方式です。
もっともらしさは、作り話の有無と関係がなかった
まず、もっともらしさのスコアが作り話をどれだけ上に並べられるかを AUROC で見ました。0.5 なら偶然と同じ、1.0 なら完全に分けられます。
コラム: AUROC とは
「作り話の回答を、普通の回答より怪しいと並べられるか」を、0〜1 の1つの数で表したものです。
イメージは、くじ引きです。作り話の回答と普通の回答を1件ずつ引いて、スコアが作り話のほうを「怪しい」と当てられた割合が AUROC です。1.0 なら毎回当たり、0.5 ならコイン投げと同じです。
しきい値(0.7 など)をどこに置くかに左右されないので、「そもそもこのスコアに見分ける力があるか」を確かめるのに向いています。
| 部品 | AUROC |
|---|---|
| もっともらしさ (qwen3.5:2b) | 0.491 |
| もっともらしさ (qwen3.5:4b) | 0.499 |
| もっともらしさ (qwen3.5:9b) | 0.549 |
| 1文照合 (4b) | 0.792 |
| 固有名詞の照合 | 0.592 |
| Judge (9b) | 0.869 |
3つのモデルとも 0.49〜0.55 です。文書を見ずに読む限り、作り話の回答は普通の回答と同じくらいもっともらしく見えます。
考えてみると当然で、RAG の作り話は「文書に書いていないことを、それらしく書く」ものです。文書を見なければ、それらしさしか判断材料がありません。
なので②は、Judge に回す対象を無作為に選ぶのとほぼ同じになりました。9b で 0.7 を超えたのが半分(Judge 50%)で、検出率は 35.6%。上位 40% に絞ると 28.1%。無作為に 40% を選んだときの期待値 34.2% と変わりません。
0.7 の意味は、モデルで変わる
同じ「0.7 超」でも、モデルによって Judge に回る量がまったく違いました。
| もっともらしさのモデル | 0.7 超の件数 | 検出率 |
|---|---|---|
| qwen3.5:2b | 175 (55%) | 45.6% |
| qwen3.5:4b | 6 (2%) | 2.5% |
| qwen3.5:9b | 159 (50%) | 35.6% |
4b は全体に辛口で、もっともらしさの中央値が 0.13 でした。0.7 を超えるのは320件中6件だけで、Judge にはほとんど何も回りません。しきい値の数字は、使うモデルとプロンプトの組でしか意味を持ちません。他人の「0.7」をそのまま持ち込むと、こうなります。
もっともらしくない作り話は、全部素通りした
コメントを読んで最初に気になったのは、もっともらしくない作り話は素通りしないか、という点でした。
| もっともらしさ (9b) | 件数 | うち作り話 | ① で検出 | ② (> 0.7) で検出 |
|---|---|---|---|---|
| 0.0〜0.3 | 60 | 37 | 36 | 0 |
| 0.3〜0.7 | 101 | 49 | 44 | 0 |
| 0.7〜1.0 | 159 | 74 | 57 | 57 |
0.7 以下の作り話は 86件あり、全件に Judge を回せば 80件拾えました。② ではその全部が素通りします。もっともらしさが低い回答は人間が勝手に疑ってくれる、という前提が立つなら許せる見逃しですが、自動の評価パイプラインでは誰も読んでいません。
段階的にふるう方式は、拾えるが安くない
③は、安い照合2つ(1文照合と固有名詞の照合)の判定が割れたものだけを Judge に回す方式です。検出率は 93.1% で、全件に Judge を回した① (85.6%) より高くなりました。1文照合が Judge と違うところで作り話を拾うためです。ただし誤検知も 30.0% から 43.8% に増えます。
問題は費用でした。「安い照合」のはずの1文照合が、Judge より高くついています。
| 部品 | 呼び出し数 | 合計秒 | 入力トークン |
|---|---|---|---|
| もっともらしさ (4b) | 320 | 307 | 79,083 |
| 1文照合 (4b) | 2,564 | 1,364 | 1,058,277 |
| Judge (9b) | 320 | 473 | 181,219 |
1文照合は文の数だけ呼び出し、そのたびに文書を送り直します。入力トークンは Judge 全件の 5.8倍でした。③の合計は 1,637秒・約116万トークンで、① の 3.5倍の時間、6.4倍のトークンです。
モデルが小さくても、呼び出し回数と送る量が増えれば安くなりません。段階的にふるって節約したいなら、1文照合には NLI(含意関係の判定)専用の小さいモデルのような、本当に安い部品が要ります。この実験ではそこまでは試していません。
Judge のコストは、そもそも大きいのか
今回の Judge 1件の入力は平均 566トークンでした。これを Claude API の Judge に置き換えた場合の目安です。Qwen のトークン数で計算しているので、数え方の違いの分だけずれます。
| Judge のモデル | 入力 / 出力 ($/1M トークン) | 320件 | 1,000件あたり |
|---|---|---|---|
| Claude Haiku 4.5 | 1 / 5 | $0.183 | $0.571 |
| Claude Sonnet 5 | 2 / 10 | $0.366 | $1.143 |
| Claude Opus 5.5 | 4 / 20 | $0.731 | $2.285 |
文書が短い QA なら、Haiku で1,000件 0.6ドルほどです。社内文書のように1回の文脈が数千トークンになると、ここが数倍から十数倍になります。間引きたくなるのはそういう規模の話で、そのときに「もっともらしさで絞る」と、費用と一緒に検出率も同じ割合で落ちます。
私ならどうするか
測った範囲から言えることは3つです。
- 間引くなら、抜き取り検査だと割り切る。もっともらしさで絞っても無作為と同じなら、無作為に抜くほうが「見逃し率もそのぶん増える」と説明しやすい
- しきい値は自分のモデルで決め直す。0.7 のような数字は、どのモデルにどう聞いたかとセットでしか意味がない
- 安い照合は、本当に安いもので組む。LLM を文の数だけ呼ぶと、Judge 1回より高くつく
コメント主の環境(機密データ、別の定義のもっともらしさ)では効いていた可能性もあります。この記事は「その方法が間違い」という話ではありません。少なくとも、もっともらしさを「文書を見ずに読んだ印象」で測ると絞り込みの役に立たなかった、という記録です。
測定条件
- 環境: RTX 4070 12GB、Ollama(Qwen 3.5 の 2b / 4b / 9b)
- データ: RAGTruth の質問応答 320件(作り話あり 160 / なし 160。生成モデルの内訳はそろえた)
- 英語の短い文書だけで測っています。日本語の RAG や長い社内文書にそのまま当てはまるとは言えません
- Judge は qwen3.5:9b の1つだけです。Judge 自体も誤検知が 30% あり、正解ではありません
Faithfulness(回答が文書に基づいているか)を他の評価軸の2倍の重みで見る理由と、正解データなしで測る方法は、こちらに書いています。
RAG・MCP・ローカルLLM を実際に動かして測った記事を書いています。続きが気になる方は Qiita でフォロー してもらえると、次の記事が届きます。
評価の3軸と、Faithfulness を測る3つの手法の組み合わせは、拙著の「エンタープライズRAG」の章にまとめています。