
GraphRAG を自分の案件に入れたい方へ。「ベクトル RAG より賢い」と期待している前提は、小さい実装では成立しないかもしれません。日本語マルチホップ QA のベンチマーク JEMHopQA dev 120 問を、9B モデルと自作簡易 GraphRAG で通したら、包含評価で vector 73.3% / graph 61.7% でした。差は 11.6 ポイントで、自作 GraphRAG がベクトル検索に負けました。構築に 3.2 時間、LLM 呼び出し 2,382 回を使っての結果です。
本記事は、JEMHopQA 120問 × 自作簡易 GraphRAG × qwen3.5:9b の 1 回通しの記録です。Microsoft GraphRAG の実装ではなく、コミュニティ要約もエンティティ解決もない「素の自作」で、どこで負けたのかを数字で見ます。公開ベンチマークに通したときの、再現可能な数字を残すのが狙いです。
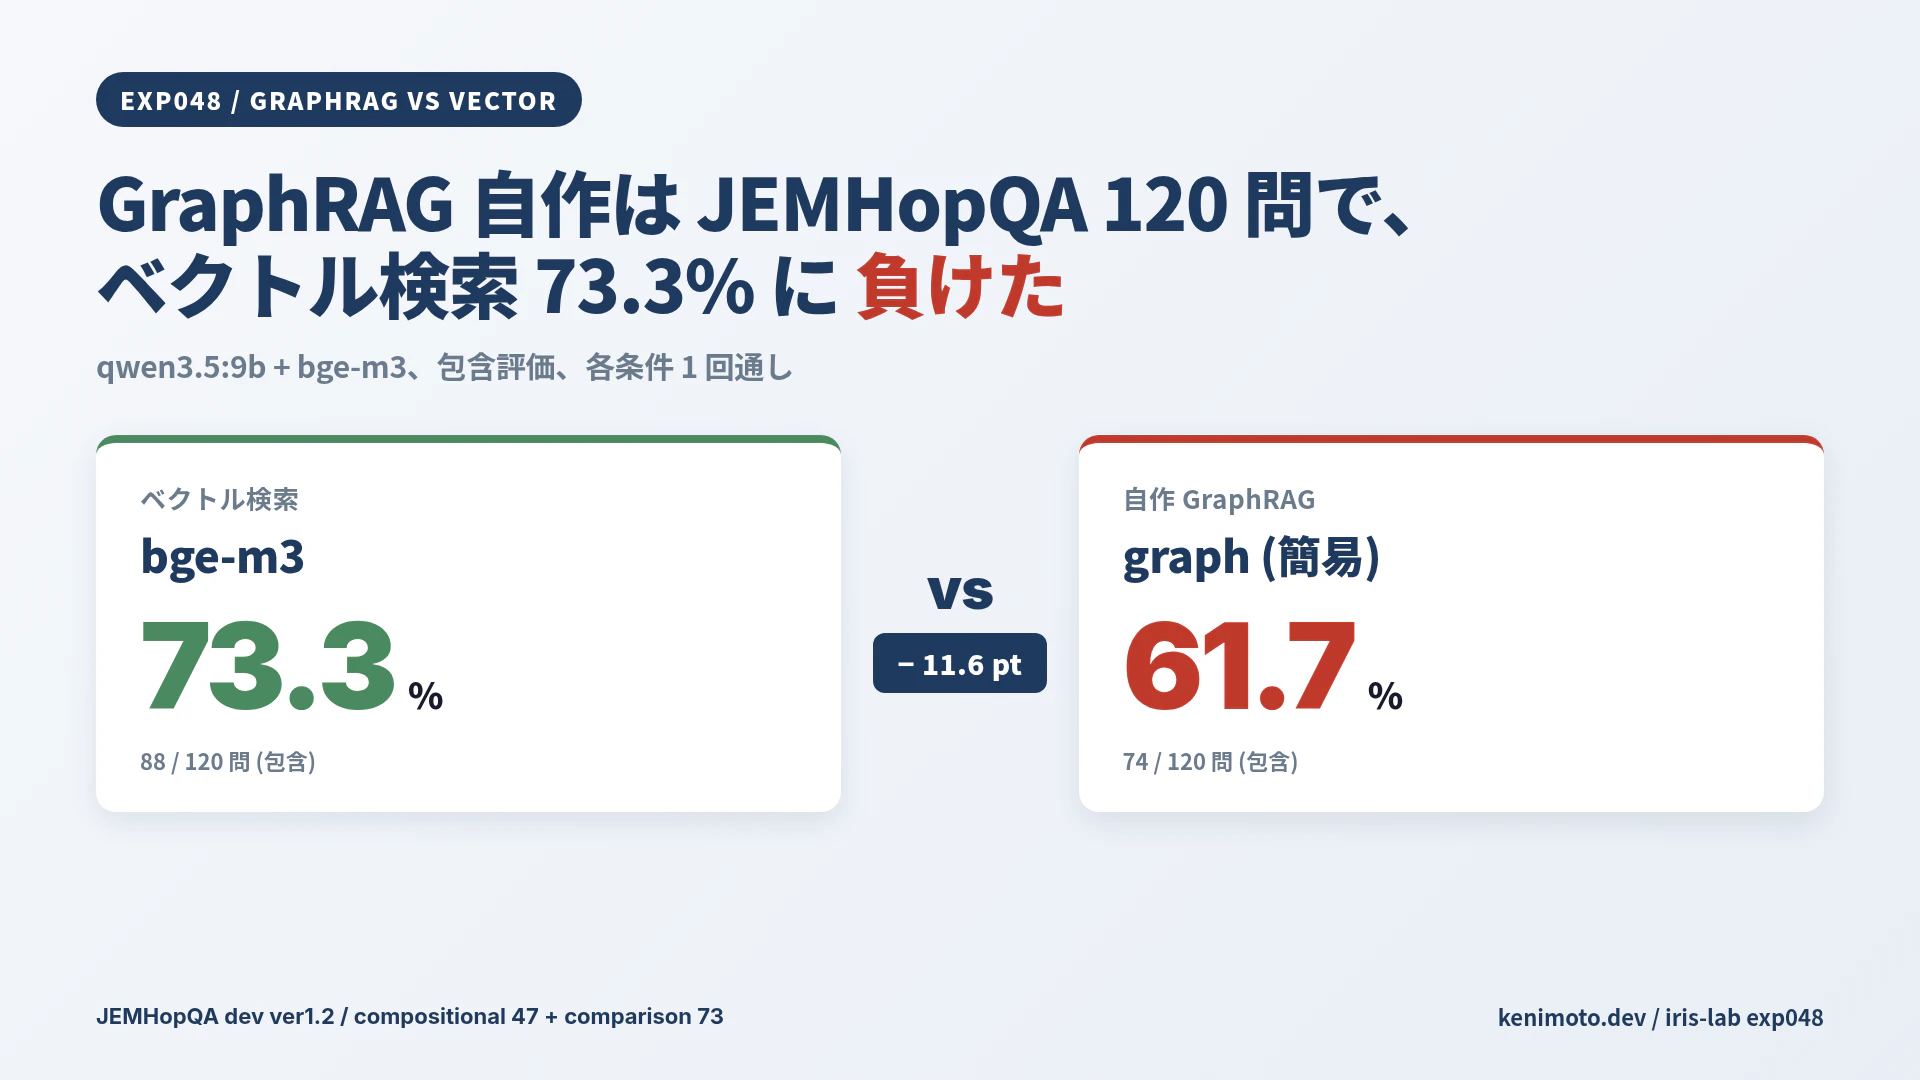
6 条件 × 120 問、包含で vector 73.3% / graph 61.7%
まず結果を置きます。条件は、コンテキストなし (none)、ベクトル検索のみ (vector)、自作簡易 GraphRAG (graph)、両者の混合 (hybrid)、トリプルの並べ替えを加えた変種 (graph_rk、hybrid_rk) の 6 つ。120 問を各 1 回、温度 0 で回しました。
| 条件 | n | 完全一致 | 包含 |
|---|---|---|---|
| none | 120 | 46 (38.3%) | 47 (39.2%) |
| vector | 120 | 86 (71.7%) | 88 (73.3%) |
| graph | 120 | 73 (60.8%) | 74 (61.7%) |
| hybrid | 120 | 78 (65.0%) | 79 (65.8%) |
| graph_rk | 120 | 69 (57.5%) | 71 (59.2%) |
| hybrid_rk | 120 | 76 (63.3%) | 78 (65.0%) |
包含は「正解文字列が回答に含まれる」の判定です。vector 73.3% と graph 61.7% は、11.6 ポイント差。hybrid でも 65.8% で、ベクトル単独に届きません。両者の包含を突き合わせると、両方正解 64 / vector だけ 24 / graph だけ 10 / 両方誤り 22 で、「graph だけが拾えた問題」も 10 問はあるものの、全体では vector に負けています。
型別に見ると、compositional の 15 ポイント差が主因
JEMHopQA は問題を 2 型 (compositional 47 問 + comparison 73 問) に分けています。compositional は 2 記事を跨いで答えを合成する型、comparison は 2 つの事実を比べる型です。
| 条件 | compositional 包含 | comparison 包含 |
|---|---|---|
| none | 2/47 (4.3%) | 45/73 (61.6%) |
| vector | 21/47 (44.7%) | 67/73 (91.8%) |
| graph | 14/47 (29.8%) | 60/73 (82.2%) |
| hybrid | 18/47 (38.3%) | 61/73 (83.6%) |
compositional で vector 44.7% vs graph 29.8%。差は 15 ポイントで、全体の負けはここで決まりました。comparison は YES / NO 答えが多く、none でも 60% は当たります。差が付きにくい型です。
compositional は「東條英機が死没した施設は、何という戦争の後に設置されましたか?」のような、2 記事 (東條英機と巣鴨拘置所) をまたいで答える型です。GraphRAG が本来、強いとされるのはこの型のはずなのに、ここで一番負けました。
97.1% のトリプルが「1 ホップ目」で予算を使い切っていた
生ログを読むと、graph の失敗には明確な型があります。「2 記事目に届かない」です。
近傍探索は、質問から抽出したエンティティのノードから出発し、1 ホップ目、2 ホップ目のトリプルを集めてコンテキスト上限 (3,000 文字、トリプル行は 1,000 文字まで) に詰めます。実測では、全 120 問の graph のトリプル行のうち 97.1% (4,691/4,829) が、シード (質問エンティティ) に直接つながる 1 ホップ目の行でした。2 ホップ目の、橋渡し先の記事に由来するトリプルが、ほぼ入っていません。
compositional の問題で、2 記事とも文章チャンクが入ったのは、graph で 19/47 問、vector で 27/47 問。vector のほうが、両方の記事を同時に見られています。
具体例が記録にあります。「東條英機が死没した施設は何という戦争の後に設置されましたか?」で、近傍候補は 309 件、入ったトリプル 33 行はすべて東條英機側の行。巣鴨拘置所の記事に属するトリプルは 1 行も入りませんでした。
表記ゆれで、ノードがつながらない
もう1つの型は、「表記寄せの粗さでノードが分断する」でした。同じ問いで、東條英機の死没地のノードは「日本・東京都豊島区西巣鴨一丁目(巣鴨拘置所)」という 1 つの長い文字列のまま入り、巣鴨拘置所の記事から抽出された「巣鴨拘置所」ノードとは別物として扱われました。正規化は NFKC と記号除去だけで、同義性の寄せ (エンティティ解決) をしていないためです。
Microsoft GraphRAG の論文実装は、エンティティ抽出・コミュニティ検出・コミュニティ要約の 3 段を持ちます。本測定の自作は、どれもありません。「GraphRAG」という括りが広すぎて、同じ名前でも含まれる機能で結果が大きく変わります。本記事の数字は「素の自作」での値です。
構築コストは 3.2 時間、LLM 呼び出し 2,382 回
参考までに、構築側のコストも並べます。チャンクは 2,382 個 (平均 351.8 文字、合計 833,713 文字)。1 チャンクに付き qwen3.5:9b でトリプルを 1 回抽出させています。
| 項目 | 値 |
|---|---|
| トリプル抽出の LLM 呼び出し | 2,382 回 |
| JSON パース失敗 (num_predict 1,024 で打ち切り) | 11 |
| 抽出の入力トークン合計 | 1,123,947 |
| 抽出の出力トークン合計 | 691,277 |
| 抽出の壁時計合計 | 11,478.7 秒 (約 3.2 時間) |
| 抽出トリプル (自己ループ除く) | 33,762 |
| ノード / エッジ | 26,988 / 33,762 |
| 埋め込み (bge-m3、2,382 チャンク) | 571,652 トークン、43.3 秒 |
ベクトル側は、チャンク埋め込み 43 秒で終わります。3.2 時間 vs 43 秒、組み立てコストに 300 倍近い開きがあって、その上で精度が負けました。並べ替え変種 _rk を入れても、シード直結の行は 92.3% に下がった程度で、包含は 59.2% と逆に少し落ちました。
どう使うか
結果だけ見れば「GraphRAG を 9B で簡易実装するな」で終わる話ですが、実務での示唆は 3 つあると思っています。
- GraphRAG を名乗る実装の仕様を、1 段深く見てから採用する。コミュニティ要約・エンティティ解決の有無で、同じ名前でも結果はまるで違います
- ベクトル検索を外す理由を、ベンチマークで裏取りする。「GraphRAG のほうが賢い」は、実装と対象型に強く依存します。公開ベンチマーク (JEMHopQA、HotpotQA 等) で、自社の実装が勝てるのかを 100 問規模で先に見ておくべきです
- 2 ホップ目を素通ししない設計を入れる。シード 1 ホップでトリプル予算を埋めず、「橋渡し先」のチャンクを別枠で確保する実装 (例: 近傍から 2 ホップ目のノードに属する元チャンクを明示的に 1 件入れる) が、自作で勝つ最低条件に見えます
実測範囲と限界
- 自作の簡易 GraphRAG であって、Microsoft GraphRAG や LightRAG などの実装ではありません
- モデルは qwen3.5:9b (Q4_K_M) の 1 種類のみ。大きいモデルでは抽出の質も読解も変わる可能性があります
- Wikipedia 記事は冒頭 4,000 文字で打ち切り。219 記事中 193 記事が打ち切られました
- 120 問 × 各 1 回、温度 0。条件間の差について検定はしていません
- Wikipedia の版は 2026-10-24 時点の現行版で、JEMHopQA の前提 (2021 年版) とはずれています
- 採点は文字列ベースで、表記ゆれは誤答扱いです。JEMHopQA 公式の
evaluate.py(類義語辞書つき) とは別採点なので、公式スコアとは比べられません
まとめ
- JEMHopQA dev 120 問で、包含評価は vector 73.3% / 自作 graph 61.7% / hybrid 65.8%。自作 GraphRAG が 11.6 ポイント負けました
- 負けの主因は compositional 型の 15 ポイント差 (vector 44.7% vs graph 29.8%)
- 失敗の型は「シード 1 ホップで予算を使い切り、2 記事目に届かない」「表記寄せが粗くノードが分断する」の 2 つが中心でした
- 構築に 3.2 時間 / 2,382 回の LLM 呼び出しを掛けて、ベクトル検索単独に負けました
- 本記事は自作簡易 GraphRAG の値です。Microsoft GraphRAG の論文実装や LightRAG とは比較していません
測定条件
本記事は iris-lab/experiments/048-graphrag-vs-vector-jemhopqa/README.md の実測結果と、JEMHopQA 公式および Microsoft GraphRAG 公式論文の再構成です。新規実測は行っていません。GraphRAG の構築コストを別軸で扱った既出記事や、自分のドキュメント 1 万件での比較記事とは別の、公開ベンチマーク上での再現可能な数字を残す位置付けです。
- 計測日: 2026-10-24〜25
- データ: JEMHopQA dev ver1.2、120 問 (compositional 47 + comparison 73)、
github.com/aiishii/JEMHopQAcommitfed5024f、CC BY-SA 4.0 - コーパス: ja.wikipedia API で 2026-10-24 取得、219 記事、冒頭 4,000 文字打ち切り、2,382 チャンク (最大 400 文字)
- LLM: qwen3.5:9b (Ollama、Q4_K_M、digest
6488c96fa5fa)、temperature 0、think=false - 埋め込み: bge-m3 (Ollama、F16、digest
790764642607、1024 次元) - 実行環境: RTX 4070 12GB、Ollama 経由
- コンテキスト上限: 全条件 3,000 文字、トリプル行最大 1,000 文字
- 採点: NFKC・小文字化・記号除去による決定的採点。類義語辞書は未使用
続きはこちら
GraphRAG を「組んで測る」側ではなく、「どのステップに時間を割くか」の設計側に関心がある方は、7 ステップに分解した整理記事があります。
RAG・MCP・ローカルLLM を実際に動かして測った記事を書いています。続きが気になる方は Qiita でフォロー してもらえると、次の記事が届きます。
本書では、知識グラフを「どう組むか」「どこで効くか」を 7 ステップに分けて、実装側の判断材料をまとめました。