
この記事の目的
2026/9/15 の TypeSafe の Jev リリース以降、OpenAI, Gemini も 同じ方向性の機能 Decisions をそれぞれ、1か月後、2か月後にリリースしました。
Gemini の Decisions では、入力に映像も使えるようなので、そちらを使用して
- 動画による判定の可否
- TOKEN/料金
- 速度
を調べてみます。
Decision Models(意思決定モデル/判断特化モデル)
TypeSafe の Jev(System One model) 、OpenAI および Gemini の Decisions と直近リリースされている 意思決定モデル/判断特化モデル をここでは、Decision Models と呼びます。
各モデルの比較
比較整理
| 比較軸 | Jev(TypeSafe) | Gemini Decisions | OpenAI Decisions |
|---|---|---|---|
| 使用モデル | Jev 1.13/1.14 | Gemini Decision 1 | GPT-6 Luna |
| 入力 | テキスト・画像。画像は実験的対応 | テキスト・画像・動画・音声・PDF | テキスト・画像・JSON |
| 特有の機能 | Box:画像内の位置を返す(1.14) | 動画・音声を直接評価 | 会話・ツール実行履歴の評価、GPT-Live連携 |
| 入力100万トークンの基本料金 | $0.042 | $0.10 | $0.10 |
| 出力課金 | なし | なし | なし |
| 1リクエストの質問数 | 固定の件数制限なし。コンテキスト制限内 | 最大1,000問 | 最大400問 |
| キャッシュ | 今回確認した資料では比較未確定 | コンテキストキャッシュ非対応 | プロンプトキャッシュ対応 |
それぞれの特徴
Jevは、先行者で基本料金自体は他社の半分以下。OpenAI は、GPT-Live から Native で連携可能。Gemini は、動画・音声を直接評価可能という特徴があります。
今回の実験では、動画がサポートできるという点から Gemini の Decisions を実験してみます。
Jev/OpenAI でも アプリ側で動画のフレームを適度に抜き出して実施することで同様の目的は果たせるかもしれません。
動画の直接処理
実験内容
今回の検証には、料理の作業手順とその誤りを収録した公開データセットCaptainCook4Dを使用しました。正しい手順で作業した動画と、意図的に誤りを含めた動画があり、工程ごとの正誤やエラー内容が注釈されています。
今回は、マグケーキを作る際の「生地をダマがなくなるまで泡立て器で混ぜる」工程から、次の2本を切り出しました。
| 動画 | 録画ID | 内容 | 公式注釈 |
|---|---|---|---|
| 正常例(約70秒) | 26_4 |
泡立て器で生地を混ぜる | 対象工程にエラーなし |
| 異常例(約48秒) | 26_36 |
泡立て器の代わりにスプーンで生地を混ぜる | 道具の使用誤り(Preparation Error) |
ここでの「誤り」は、指定された作業手順への不適合を意味します。スプーンではマグケーキを作れない、という意味ではありません。また、異常例に付いている公式ラベルは道具の誤りであり、生地にダマが残っていることを示すものではありません。
検証用の動画は、公開されている360pの映像から対象工程の前後を含めて切り出し、音声を除去したMP4です。2本は異なる人物・場所で撮影されており、撮影条件を統一した比較ではありません。
出典:Peddi et al., CaptainCook4D: A Dataset for Understanding Errors in Procedural Activities, NeurIPS 2024。データセットは Apache License 2.0 で公開されています。正誤とエラー内容は公式アノテーションを参照しました。
実装
判断する内容
CaptainCook4D の 動画 26_36 では、「泡立て器の代わりにスプーンを使用」という注釈があり、まずはこの見極めができるかどうか試してみます。
何を使って生地を混ぜているか
- 泡立て器
- スプーン
- その他(手など)
- 映像から判別できない
近くに置いてある道具ではなく、実際に混ぜている道具を確認します。指定の手順では泡立て器が正解です。
実装コード
import base64
import time
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

VIDEO_DIR = "videos"
VIDEOS = [f"{VIDEO_DIR}/sample_A.mp4", f"{VIDEO_DIR}/sample_B.mp4"]
THRESHOLD = 0.8

QUESTIONS = {
    "mixing_tool": {
        "type": "choice",
        "instructions": (
            "動画内で、ボウルのマグケーキ生地を実際に混ぜている道具は何ですか。"
            "近くに置いてあるだけの道具は無視し、見えない部分を推測しないでください。"
        ),
        "criteria": {
            "whisk": "針金やループ状の複数の線を持つ泡立て器で生地を混ぜている。",
            "spoon": "くぼんださじ部分を持つスプーンで生地を混ぜている。",
            "other": "手など、泡立て器とスプーン以外を使って生地を混ぜている。",
            "unobservable": "遮蔽や画質のため道具を識別できない、または混ぜる動作がない。",
        },
    },
}


def main():
    for path in VIDEOS:
        print(f"Evaluating {path} ...")
        with open(path, "rb") as f:
            encoded = base64.b64encode(f.read()).decode("ascii")

        started = time.perf_counter()
        result = client.decisions.create(
            model="gemini-decision-1",
            input=[{"type": "video", "data": encoded, "mime_type": "video/mp4"}],
            questions=QUESTIONS,
        )
        seconds = time.perf_counter() - started

        tool = result.answers["mixing_tool"]

        if tool.confidence < THRESHOLD or tool.choice == "unobservable":
            verdict = "要確認"
        elif tool.choice == "whisk":
            verdict = "適合"
        else:
            verdict = "不適合"

        print(f"  tool={tool.choice} confidence={tool.confidence:.3f} compliance={verdict}")

        usage = result.usage
        by_modality = ", ".join(f"{m.modality}={m.tokens}" for m in usage.input_tokens_by_modality)
        print(f"  tokens: total={usage.total_tokens} input={usage.total_input_tokens} "
              f"output={usage.total_output_tokens} ({by_modality})")
        print(f"  time={seconds:.3f}s")

if __name__ == "__main__":
    main()
時間はAPI呼び出しの前後で測定した値で、動画データの送信・通信・サーバー処理を含みます。掲載した各条件は1回の測定結果であり、応答時間の傾向や、質問数による速度差までは評価していません。
実行時に SDK 3.2以降と GEMINI の API キーが必要になります。
python -m pip install -U "google-genai>=3.2"
export GEMINI_API_KEY="取得したAPIキー"
python gemini_decisions.py
動画は CaptainCook4D の
公開データから取得しました。
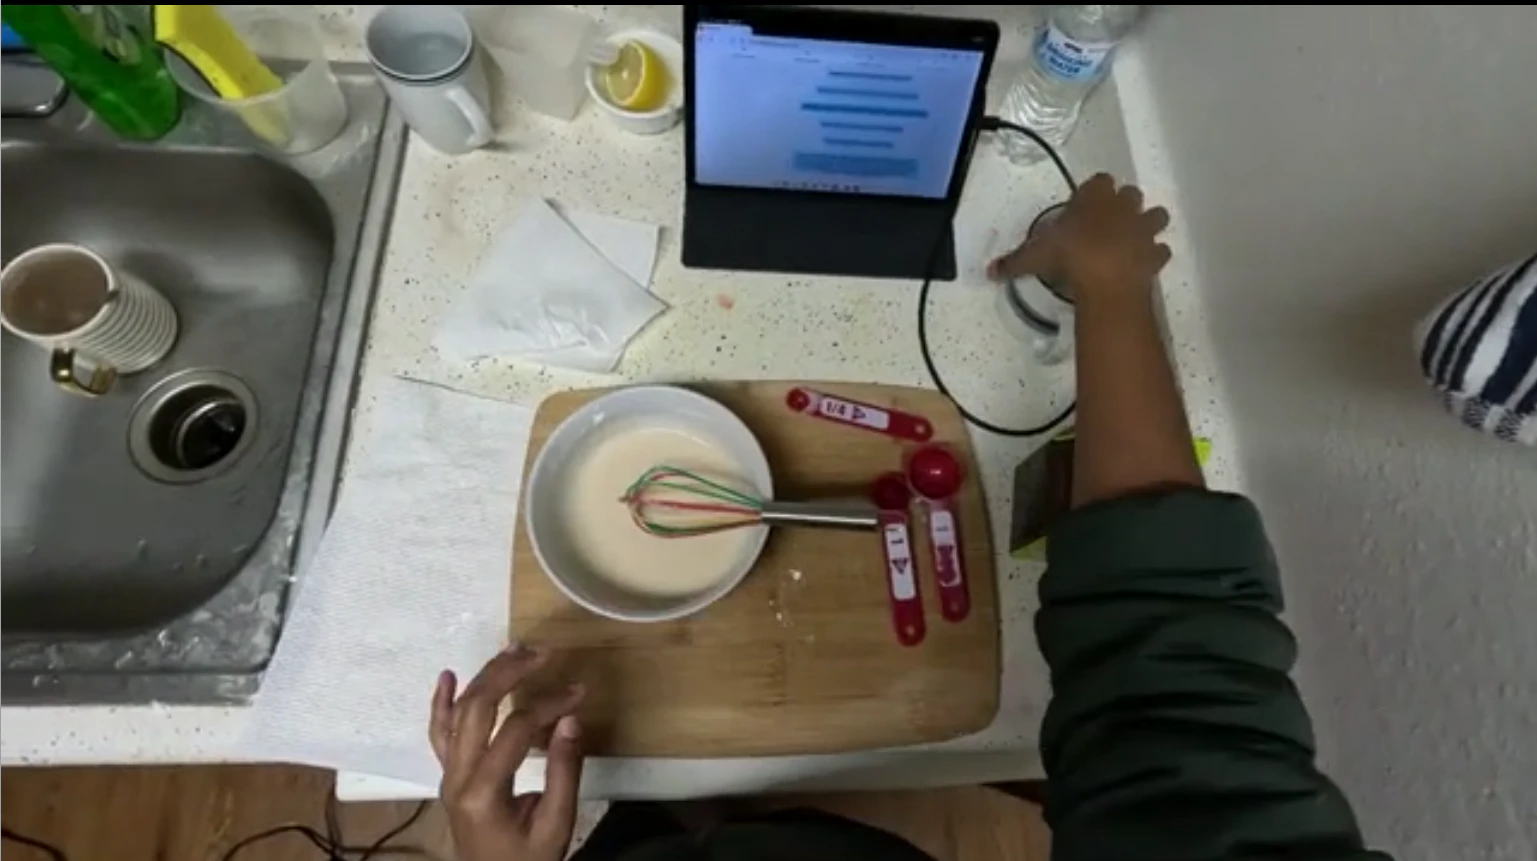
ちゃんとした泡立ての機材を使ってきれいに混ざってますね。
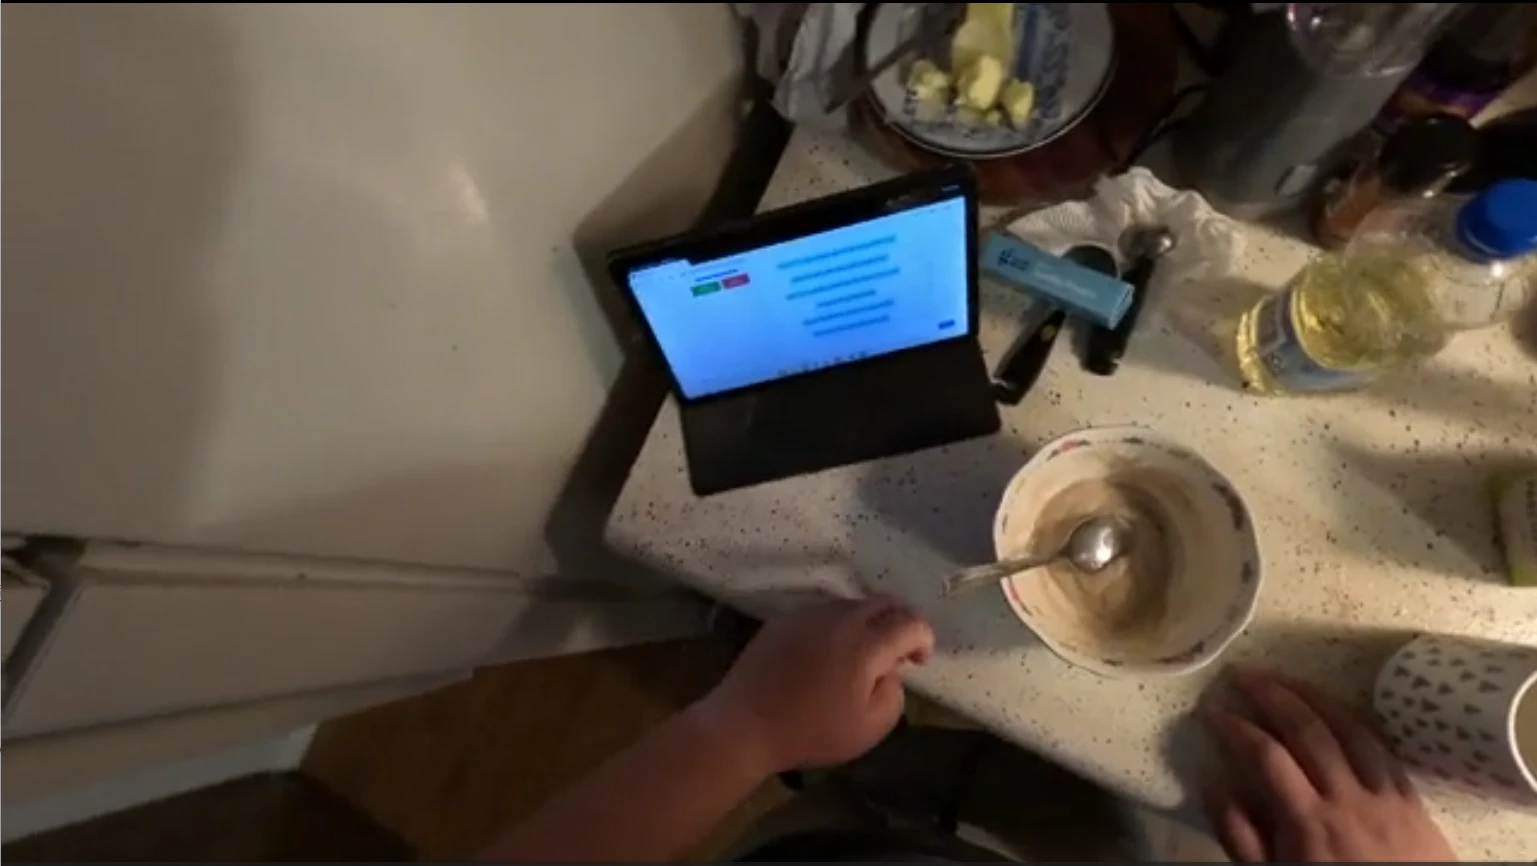
スプーンでかき混ぜたみたいです。
上記はレシピ全体の元動画です。本検証では、それぞれの
「生地を泡立て器で混ぜる」工程を切り出し、音声トラックを除去して使用しました。
| ファイル | 元動画 | 切り出し区間 |
|---|---|---|
sample_A.mp4 |
26_4 |
491.526秒から70.432秒間 |
sample_B.mp4 |
26_36 |
392.714秒から48.131秒間 |
取得元:公式ダウンロードリンク一覧
正誤情報:公式アノテーション
データのライセンス:Apache License 2.0
今回は、実行ファイルを動作させるフォルダ直下に ./videos というフォルダを作りその下にビデオを配置しています。適宜、コード上のパスを置き換えてください。
実行結果
sample_A.mp4(26_4) は whisk を使用しており 適合、 sample_B.mp4(26_36)は、spoonを使用しているため不適合 という判定になるのが期待値です。
Evaluating videos/sample_A.mp4 ...
  tool=whisk confidence=0.973 compliance=適合
  tokens: total=5305 input=5305 output=0 (text=335, image=4620, audio=350)
  time=8.844s
Evaluating videos/sample_B.mp4 ...
  tool=spoon confidence=0.871 compliance=不適合
  tokens: total=3699 input=3699 output=0 (text=291, image=3168, audio=240)
  time=2.194s
期待値に沿った結果になりましたね。
それぞれ、料金はどうでしょうか?
| 動画 | 入力トークン | 料金 | 円換算※ |
|---|---|---|---|
| A | 5,305 | $0.0005305 | 約0.080円 |
| B | 3,699 | $0.0003699 | 約0.055円 |
| 合計 | 9,004 | $0.0009004 | 約0.135円 |
※ 1ドル=150円と仮定。無料枠の範囲内なら $0 です。
※ 仕様・料金は2026年11月16日時点です。
クライテリアを追加
先ほどの実装時のクライテリアに加えて、最後に見える生地の状態を判定してみます。
- ダマがなく、均一に混ざっている
- 粉やダマが残っている
- 画質や遮蔽で確認できない
1回のリクエストで、同じ動画に対する複数の質問をまとめて評価できます。
実装コード2
import base64
import time
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

VIDEO_DIR = "videos"
VIDEOS = [f"{VIDEO_DIR}/sample_A.mp4", f"{VIDEO_DIR}/sample_B.mp4"]
THRESHOLD = 0.8

QUESTIONS = {
    "mixing_tool": {
        "type": "choice",
        "instructions": (
            "動画内で、ボウルのマグケーキ生地を実際に混ぜている道具は何ですか。"
            "近くに置いてあるだけの道具は無視し、見えない部分を推測しないでください。"
        ),
        "criteria": {
            "whisk": "針金やループ状の複数の線を持つ泡立て器で生地を混ぜている。",
            "spoon": "くぼんださじ部分を持つスプーンで生地を混ぜている。",
            "other": "手など、泡立て器とスプーン以外を使って生地を混ぜている。",
            "unobservable": "遮蔽や画質のため道具を識別できない、または混ぜる動作がない。",
        },
    },
    "batter_texture": {
        "type": "choice",
        "instructions": (
            "動画内で最後に確認できるボウルのマグケーキ生地は、ダマのない状態ですか。"
            "道具の種類や混ぜた時間から推測せず、生地そのものの見た目で評価してください。"
        ),
        "criteria": {
            "smooth": "生地が十分に見え、目立つダマがなく均一であると確認できる。",
            "lumpy": "生地に混ざっていない粉や目立つダマが見える。",
            "unobservable": "画質や遮蔽などにより、ダマの有無を確認できない。",
        },
    },
}


def main():
    for path in VIDEOS:
        print(f"Evaluating {path} ...")
        with open(path, "rb") as f:
            encoded = base64.b64encode(f.read()).decode("ascii")

        started = time.perf_counter()
        result = client.decisions.create(
            model="gemini-decision-1",
            input=[{"type": "video", "data": encoded, "mime_type": "video/mp4"}],
            questions=QUESTIONS,
        )
        seconds = time.perf_counter() - started

        tool = result.answers["mixing_tool"]
        texture = result.answers["batter_texture"]

        if tool.confidence < THRESHOLD or tool.choice == "unobservable":
            verdict = "要確認"
        elif tool.choice == "whisk":
            verdict = "適合"
        else:
            verdict = "不適合"

        print(f"  tool={tool.choice} confidence={tool.confidence:.3f} compliance={verdict}")
        print(f"  texture={texture.choice} confidence={texture.confidence:.3f}")

        usage = result.usage
        by_modality = ", ".join(f"{m.modality}={m.tokens}" for m in usage.input_tokens_by_modality)
        print(f"  tokens: total={usage.total_tokens} input={usage.total_input_tokens} "
              f"output={usage.total_output_tokens} ({by_modality})")
        print(f"  time={seconds:.3f}s")


if __name__ == "__main__":
    main()
実行結果2
Evaluating videos/sample_A.mp4 ...
  tool=whisk confidence=0.970 compliance=適合
  texture=smooth confidence=0.781
  tokens: total=5434 input=5434 output=0 (text=464, image=4620, audio=350)
  time=8.063s
Evaluating videos/sample_B.mp4 ...
  tool=spoon confidence=0.830 compliance=不適合
  texture=smooth confidence=0.583
  tokens: total=3828 input=3828 output=0 (text=420, image=3168, audio=240)
  time=1.722s
適合・不適合に関しては、confidence が変わっていますが、期待値に沿っています。
生地の状態は、どちらも smooth が選ばれました。ただし、confidence はAが0.781、Bが0.583で、Bの判定はより不確かでした。今回は生地の状態に関する正解データとの照合をしていないため、この結果だけで判定精度は評価できません。Aが78% smoothで、Bが58% smooth という smooth 差の度合いとして扱うこともできません。
なお、compliance は引き続き道具の判定結果だけから算出しています。生地の状態は別項目として出力し、適合・不適合には反映していません。閾値の0.8は、今回試すために置いた仮の値です。
質問を1問から2問に増やしても、画像・音声の入力トークン数は変わらず、各動画でテキストが129トークン増えました。2本の合計料金は、有料枠の単価で約0.135円から約0.139円になりました(1ドル=150円換算)。
まとめ
今回は、動画での判定を試してみるということを目的に実験を行いました。
実際の判定結果をどう取り扱うかは、アプリ側の閾値を調整しながら対応していくのが実践的な方法だと考えます。
また、入力時のテキスト(プロンプト)は、A も B も同じですが、実験1では、335/291 と差が出ています。これに関しては、textの内訳は「共通部分195+動画秒数×2」、audioは「動画秒数×5」と一致しました。動画の長さに応じた情報が計上されている可能性がありますが、内訳の生成理由は公式資料で確認できていません。
実際のアプリへの組み込みの実用性に関しては、それぞれのユースケースや入力条件・予算によると思いますが、今回の結果が参考になればと思います。