
はじめに
C# を CUDA C++ に変換して GPU で動かすコンパイラ G#(Henicos)を、AI に作らせています。人間はコードを一行も書かず、差分もほとんど読みません。
| AI(Claude / Gemini) | 人間 |
|---|---|
| 設計 | 論点ページを見て選ぶ |
| 実装 | 抜き取った PR を確認(1 本 10 分) |
| レビュー | 崩れた体裁をまとめて直させる |
| バグの調査 | 利用料を払う(月約 6 万円) |
それでも 1 日に約 40 本の PR がマージされ、その過程で AI は MSVC と NVIDIA ドライバのバグまで特定してきました。この記事は、そこまで任せられるようになった仕組み(ハーネス)の紹介です。
数字で見る現状
| 項目 | 値 |
|---|---|
| 期間 | 2026-08-22 〜 2026-11-11(81 日) |
| コミット / マージした PR | 4,713 / 617 |
| 製品コード / テストコード(C#) | 約 14.4 万行 / 約 20.3 万行 |
| AI の利用料 | 月約 6 万円(定額。Claude Ultra 200 ドル、Claude Max 100 ドル、Google AI Ultra 14,500 円) |
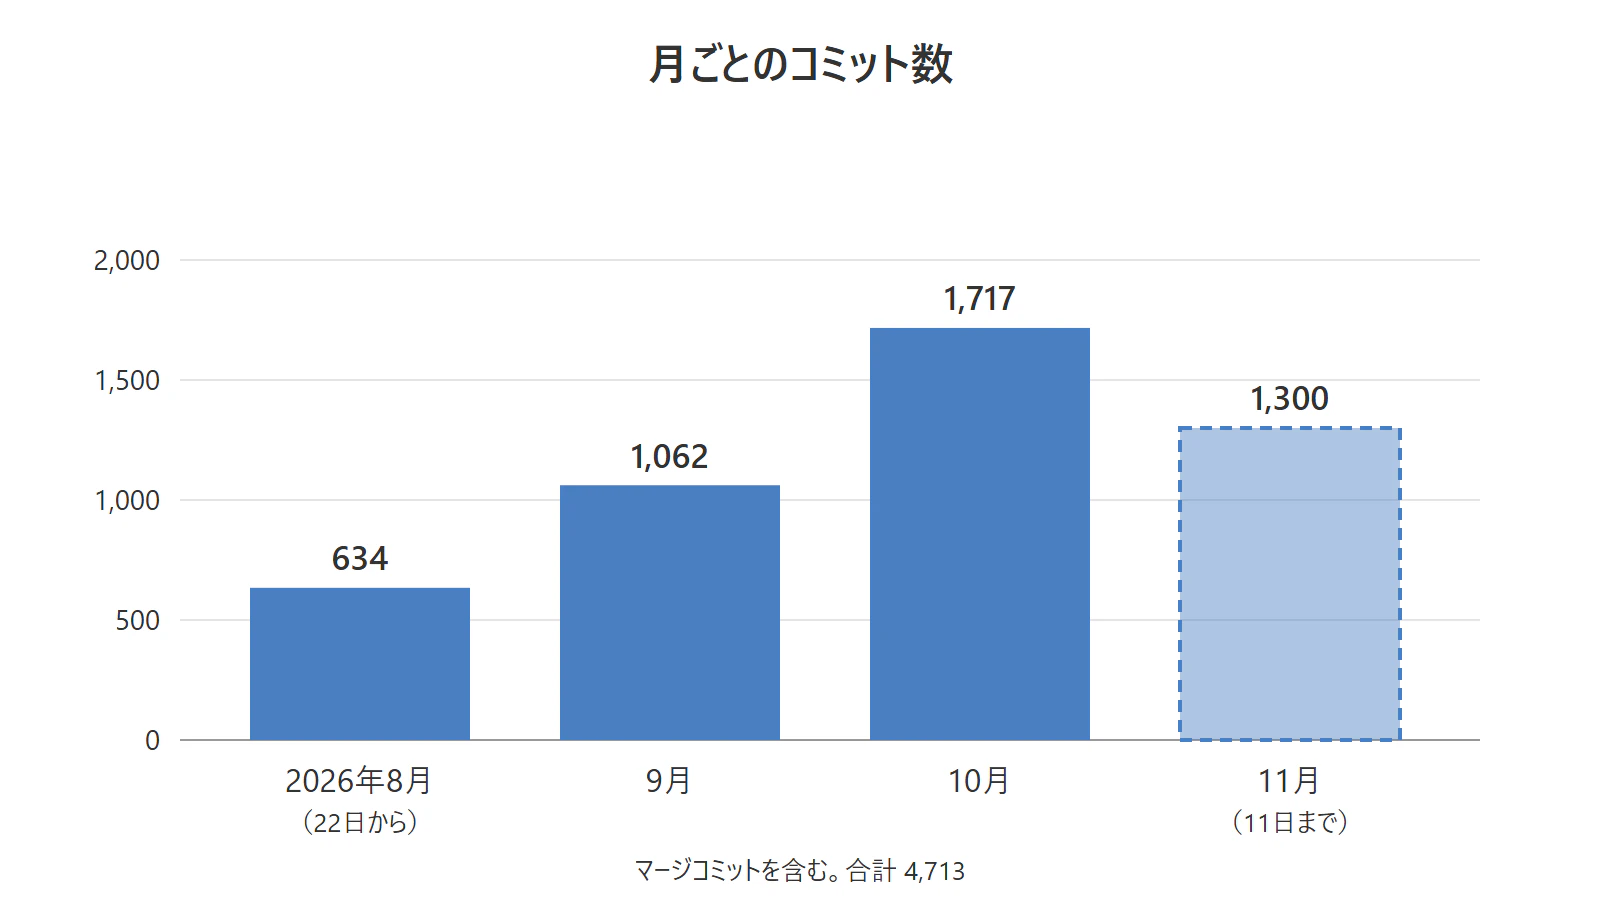
レビューのやり方を変えた前後で、PR の流量が 5 倍になりました。
ただし目を離せるわけではありません。人間は起きている間ずっと AI の相手をしていて、完全に放っておけるのは 1 時間ほどです。手を放したのは「コードを書く」と「差分を読む」だけです。
なぜコンパイラ開発でこれができたのか
正解の拠り所が外にあるので、食い違いを「どの仕様に従うか」で決められます。一般の Web アプリでは仕様が自分たちの頭の中にしかないので、そのままでは使えない部分があります。持ち帰れる部分は最後にまとめます。
意味の憲章:AI に「正解」を選ばせない
憲章ができる前
G# には同じカーネルを実行する経路が 4 つあります。10 月の終わりまで、AI は経路やフォルダごとに、その場でもっともらしい意味を選んでいました。
例えば、符号付きオーバーフローが C++ の規則に従っていた、Math.Max が NaN を無視していた、範囲外の添字が検査されていなかった、など。誰も間違えようとはしていません。基準がなかっただけです。
憲章の中身
食い違ったときにどれに従うかを決めた「意味の憲章」を作りました。原則は 4 つです。
- GPU が目標。CPU の経路は GPU の結果を検証するためにある
- 書いたとおりに動く。暗黙に処理や同期を足さない
- 余分な意味には印が要る。ユーザーが書いた API や属性があるときだけ
- 未定義動作はエラー。G# が勝手に結果を選ばない
どれに従うかは、次の順で決まります。
そして、後で効いてくる一文があります。
CPU の経路がたまたま出した値を、正解として扱わない。CPU と GPU が違ったら、まず未定義動作を疑う。
憲章ができてから、その下の規則が一気に書けるようになりました。AI 向けのルールと手順書を変えたコミットは、8〜9 月の 33 件に対して、10 月は 338 件と生産性が10倍になりました。レビューにかかる時間が圧倒的に減ったためです。
憲章の下にあるハーネス
| 層 | 中身 |
|---|---|
| 規則 | ルール 12 ファイル、手順書 28 個。Claude と Gemini が同じ文書を読む |
| 機械による強制 | アナライザ、禁止 API の一覧、Git フック、CI。違反するとビルドが通らない |
| 検証 | テスト 4,697 件、4 経路の差分テスト、ファザー、連続実行、メモリ上限 |
| 人間 | 論点ページで選ぶ、抜き取り検査 |
機械で止めているものの例です。どれもビルドエラーになります。
- assert を一つも呼ばないテスト
- シードを指定しない乱数
- 例外を握りつぶす
catch
スナップショットの期待値を AI が書き換えてテストを通すことも禁止しています。テストを「通るように直して」終わらせる逃げ道をふさぐためです。
人間がコードを見なくなった理由:決定的なスクリプト
一番効いたのは、code smell を毎回同じ結果で探すスクリプトでした。
体裁の崩れはスクリプトに変える
AI に任せていると、PR や issue の体裁が少しずつ崩れます。人間はまとめて指摘して直させ、直させたことはスクリプトに足します。
preflight.js はレビューの前に、ベースとの衝突、CI、長いメソッドや大きな switch、新しく増えた smell、PR 本文の見出しをまとめて検査します。
スクリプトで探し、スクリプトで判定する
スクリプトは直す場所を探すだけでなく、終わったかの判定にも使います。判定が機械でできるので、簡単な作業は安いモデルに任せられます。
機械的に拾えるもの(長さ、ネスト、重複、体裁)はスクリプトが拾い、AI はスクリプトで拾えない設計や意味の誤りだけを探します。この掛け合わせがよく効きました。Gemini 向けの引き継ぎ文書 13 件のうち 8 件が、smell スクリプトを起点か完了条件に使っています。
人間の確認は抜き取り検査に
抜き取りは始めたばかりで、まだ 1 ロット 14 本です。見逃しは 0 件でした。人間が判断すべきことは、AI が論点と選択肢を 1 枚のページにまとめ、人間はそれを見て選びます。
このハーネスが見つけたもの 1:MSVC の誤コンパイル
差分ファザーが、ネイティブ CPU 経路だけ結果が違うカーネルを見つけました。INT_MIN の符号反転を 2 で割ると、正しくは -0x40000000 のところ +0x40000000 が返ります。
コンパイラのバグは滅多にないので、普通はまず自分が出力した C++ を疑います。憲章もそう指示しています。AI はその手順どおりに、候補を一つずつ消していきました。
- 4 経路を比べる。C#、マネージド、CUDA の 3 つは一致していて、ネイティブ CPU だけが違う。問題はネイティブのビルドにある
-
未定義動作がないことを証明する。同じ関数を
constexprにしてstatic_assertで値を確かめる。定数式の中で未定義動作が起きると C++ はコンパイルエラーにするので、これが通れば未定義動作はないとコンパイラ自身が保証したことになる。残る候補はコンパイラだけ -
最適化オプションを絞る。
/O2を構成するオプションに分解して 31 通り試し、/Og(グローバル最適化)とインライン展開がそろったときだけ間違えると特定する -
アセンブリを読む。
(int)(0u - (unsigned)x) / 2が-(x / 2)に変形されていた。符号反転がオーバーフローしないときにしか成り立たない変形 - バージョンを並べる。新しいコンパイラでも直っていないことを確かめ、Microsoft に報告した
同じ系統の誤コンパイルが 3 パターンあり、1 件は新規として報告、2 件は既知か修正済みでした。どれも現行の VS 2022 では誤った値を返します。G# 側は /O2 から /Og だけを除いて回避しました(整数ループで約 12% 遅くなるが、コンパイル時間は半分)。
このハーネスが見つけたもの 2:GPU 障害のたびに漏れるカーネルメモリ
ある日、開発マシン(Windows 11、RTX 3070 Ti、メモリ 64 GB)でメモリが足りなくなりました。ところが、プロセスのメモリを全部足しても使用量に届きません。
ここで効いたのが、テストのプロセスごとにメモリのピークを記録する仕組みです。プロセスの合計と実際の使用量が合わないことが、数字ではっきり見えました。パフォーマンスカウンタでカーネルのメモリプールを見ると、合計 19.4 GB まで膨らんでいました(普段は約 4 GB)。
GPU 障害(trap)だけを起こす小さな CUDA プログラムを 200 回実行して測ると、1 回の障害につき約 8 MB のカーネルメモリが漏れ、プロセスが終了しても戻らないことが分かりました。解放されるのは再起動したときだけです。NVIDIA には報告済みで、回答を待っています。
再現コードと測定スクリプトの詳細は、NVIDIA の回答待ちのため割愛します。回答があり次第、追記します。
数千回の GPU 障害を起こしていたのは、自分たちのテストでした。GPU のエラー報告を確かめるために本物の障害を起こすテストを、AI が連続実行で何日も回していたのです。検証の量が目立たないリークを表に出し、同時にその原因でもありました。今は、そのテストは専用のコマンドからしか実行しません。
持ち帰れること
コンパイラ開発には、外に決まった仕様があるという有利さがあります。それを差し引いても、次の 5 つは一般の開発にも使えると思います。
1. 食い違ったときにどれに従うかを、表で決める
G# では C#、GPU、CPU のどれに従うかを決めました。Web アプリなら、仕様書、既存の挙動、法令、ユーザーの期待のどれを優先するか、になるはずです。基準がないと、AI は場所ごとにその場でもっともらしい答えを選び、コードベースの中で意味がぶれていきます。
2. 決まっていないことを AI に選ばせない
G# では、どの定義も結果を決めていないもの(未定義動作)をエラーにしています。アプリ開発なら、人間への質問にするのが近いと思います。AI が黙って一つを選ぶと、それが既成事実になります。
3. 基準を決めたら、既存のコードを洗い出す
基準ができる前に書かれたコードには、ぶれが残っています。放っておくと、AI はそのぶれを手本にして真似し、広げます。G# では基準を決めた直後に洗い出し、1 日で約 25 件の issue にしました。
4. 探すのも、終わったかの判定も、スクリプトにする
直す場所を探すのも、作業が終わったかを判定するのも、毎回同じ結果を出すスクリプトにします。判定が機械でできれば、安いモデルにも任せられ、人間も中身を見なくて済みます。AI には、スクリプトで拾えない設計や意味の誤りだけを探させます。
5. 人間は判断と抜き取りだけにして、見逃しは仕組みに戻す
人間は全部を読まず、判断と抜き取り検査に集中します。抜き取りで見逃しが見つかったら、その場で直して終わりにせず、AI の手順やスクリプトに戻します。そうすると、同じ種類の見逃しが起きにくくなります。
注記
- コンパイラ開発は外に権威ある仕様があるので有利です
- 事例は 2 件で、比較実験ではありません
- 抜き取り検査はまだ 1 ロットです
- ハーネスの維持にもコストがかかります(ルールと手順書で約 5,200 行)
- 検証の量が、NVIDIA のリークの原因にもなりました
おわりに
設計も実装もレビューも、コンパイラやドライバのバグ探しまで、AI がやってくれるようになりました。人間に残った仕事は、判断と抜き取りと、毎月の利用料の支払いです。
ここまで全自動にできたのだから、最後の一つも引き受けてほしい。AI の利用料は、AI が自分で稼いで払ってくれないでしょうか……w