
はじめに
音声AIの会話システムには長らく二律背反がありました。
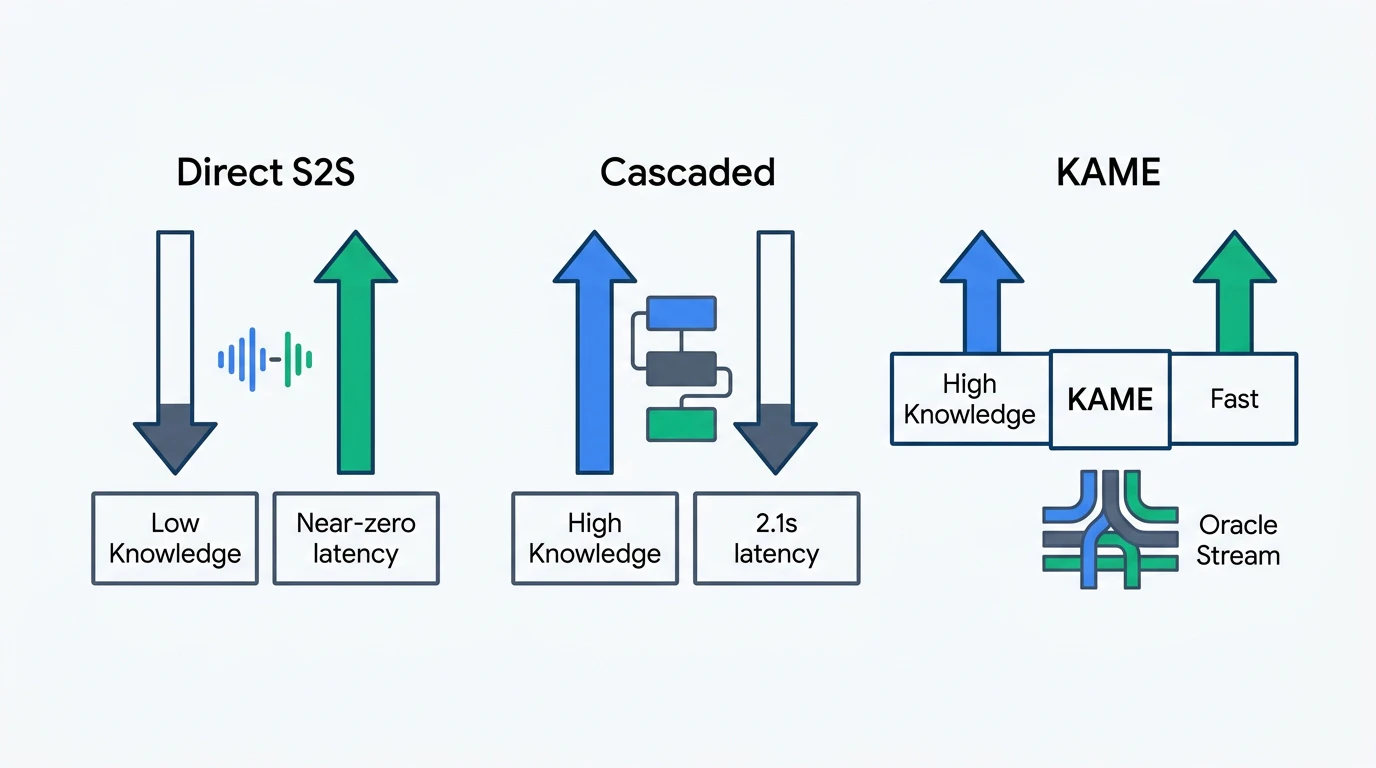
- 直接S2Sモデル(Direct Speech-to-Speech): 即座に応答できるが、知識が浅く回答品質が低い
- カスケード型(ASR → LLM → TTS): 知識豊富で高品質だが、2秒超の遅延で会話が不自然になる
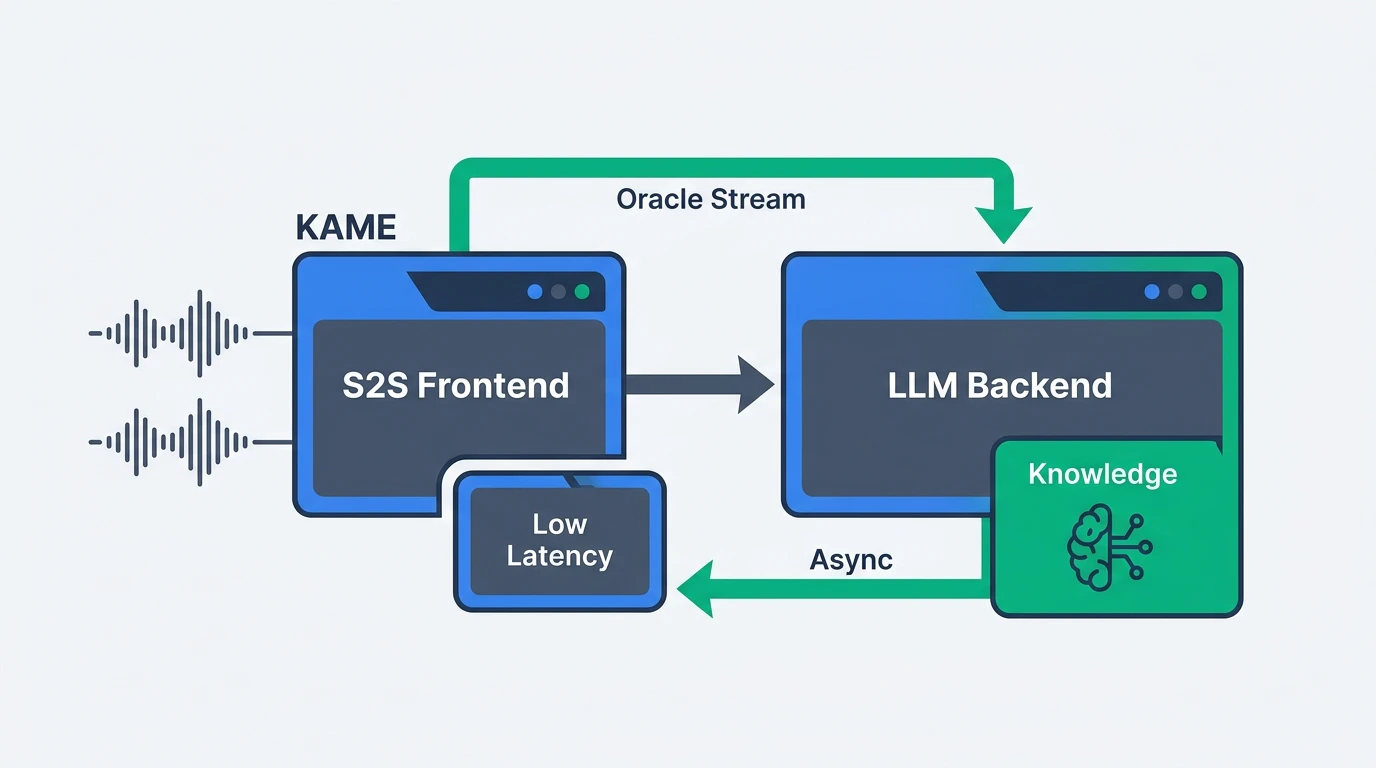
2026年5月3日、東京を拠点とするSakana AIがこの問題を解決するアーキテクチャ KAME(Knowledge-Access Model Extension)を発表しました。ICASSP 2026に採択されたこの研究は、フロントエンドS2Sモデルとバックエンドテキストを非同期に組み合わせる「タンデム設計」を採用しています。
この記事で学べること
- KAMEが解決する音声AI設計の課題
- タンデムアーキテクチャの仕組みとオラクルストリーム
- MT-Benchベースの定量的ベンチマーク結果
- Pythonサーバーのセットアップ手順
- GPT-4.1 / Claude Opus / Geminiのバックエンド切り替え
対象読者
- 音声AIアプリケーションを開発するエンジニア
- LLMを活用したリアルタイム対話システムに関心のある方
- Moshi等のS2Sモデルの限界を感じている方
TL;DR
- KAMEはMoshi系S2Sをフロントエンドに、GPT-4.1等のLLMをバックエンドに置くタンデム設計
- near-zeroレイテンシ を維持しながらMT-Benchスコアを 2.05 → 6.43 に向上(Moshi単体比)
- カスケード型Unmute(7.70点)には届かないが、レイテンシは2.1秒 vs near-zero で圧倒的優位
- バックエンドは再学習不要で切り替え可能(GPT-4.1・Claude Opus 4.1・Gemini 2.5 Flash対応)
- MIT License、GitHub公開済み
背景:音声AI会話の2つのアーキテクチャ
直接S2Sモデル
直接S2Sモデルは音声入力をそのまま音声出力に変換します。代表的なのはKyutaiのMoshiで、離散オーディオトークンを約80msサイクルで処理し、応答開始までの遅延がほぼゼロです。
課題は知識量です。モデルパラメータに収まる知識のみで応答するため、最新情報や専門知識を問われると回答が浅くなります。
カスケード型(ASR → LLM → TTS)
音声を一度テキストに変換(ASR)し、LLMで応答を生成してから再度音声に変換(TTS)するパイプラインです。GPT-4.1等のフルスペックLLMを活用できるため回答品質は高く、Unmute(gpt-4.1バックエンド)のMT-Benchスコアは 7.70 に達します。
ただし全段階を直列処理するため、中央値レイテンシが 2.1秒 程度になります。電話やリアルタイム対話では会話の自然さが損なわれます。
KAMEが目指すもの
KAMEは「think then speak(考えてから話す)」から「speak while thinking(話しながら考える)」へのパラダイムシフトを実現します。フロントエンドが即座に応答を開始しつつ、バックエンドLLMが非同期で深い知識を注入していきます。
KAMEのアーキテクチャ
タンデム設計の全体像
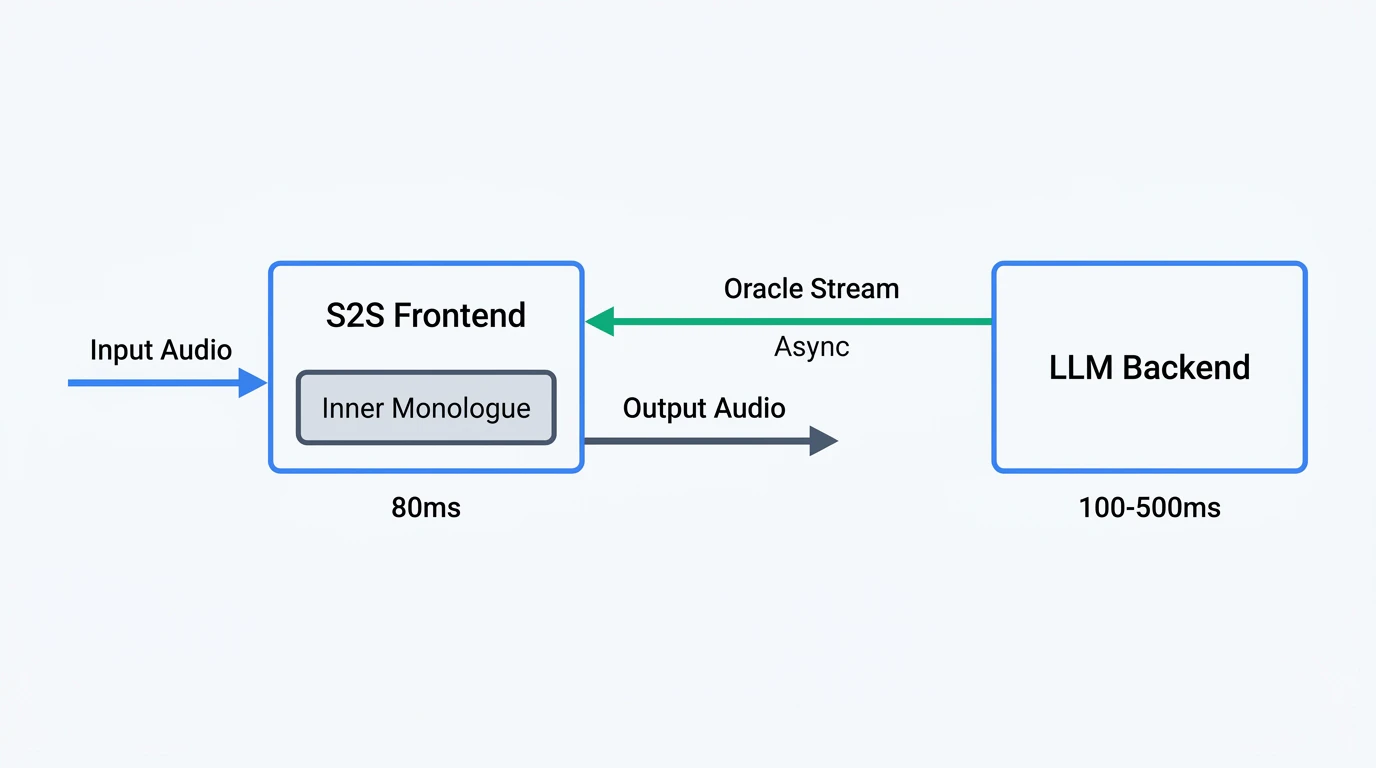
KAMEは2つのコンポーネントを非同期で動かします。
| コンポーネント | 処理周期 | 役割 |
|---|---|---|
| フロントエンドS2S(Moshi系) | ~80ms | 即時応答の生成 |
| バックエンドテキストLLM | 100〜500ms | 深い知識の非同期注入 |
フロントエンドは入力音声を受け取ると即座に応答音声の生成を開始します。同時に中間転写(interim transcription)をバックエンドLLMにストリーミング送信し、LLMが生成したより知識的な応答テキストを「オラクルストリーム」として受け取って出力に反映させます。
4ストリーム設計
Moshiオリジナルの3ストリーム設計(入力音声・内部独白・出力音声)に、KAMEは オラクルストリーム を追加しています。
入力音声ストリーム  →  フロントエンドS2S  →  出力音声ストリーム
                          ↓↑ (80ms)
                    内部独白ストリーム
                          ↓   (中間転写をバックエンドへ送信)
                    バックエンドLLM  (100-500ms)
                          ↓
                    オラクルストリーム  (LLM応答をフロントエンドへ注入)
フロントエンドのS2Sモデルはオラクルストリームを条件として受け取り、自身の内部コンテキストとLLMの知識を組み合わせて出力を生成します。
バックエンド非依存設計
KAMEのフロントエンドは gpt-4.1-nano をバックエンドとして学習されていますが、推論時に再学習不要でバックエンドを差し替えられる のが重要な設計上の特徴です。
公式で確認されている対応バックエンド:
-
gpt-4.1— 人文科学タスクで高スコア -
claude-opus-4-1— 推論タスクで高スコア gemini-2.5-flash
用途に合わせてバックエンドを選択できます。
ベンチマーク結果
評価にはMT-Benchのテキストプロンプトを音声合成した「speech-synthesized MT-Bench」を使用し、応答をLLM評価器でスコアリングしています(10点満点)。
全体比較
| システム | MT-Benchスコア(平均) | レイテンシ |
|---|---|---|
| Moshi alone | 2.05 | near-zero |
| KAME + gpt-4.1 | 6.43 | near-zero |
| KAME + claude-opus-4-1 | 6.23 | near-zero |
| Unmute(カスケード型)+ gpt-4.1 | 7.70 | 2.1秒(中央値) |
KAMEはカスケード型の7.70点には届きませんが、near-zeroレイテンシでMoshi比3倍以上のスコア を達成しています。
カテゴリ別スコア(KAME+gpt-4.1 vs Moshi)
| カテゴリ | KAME+gpt-4.1 | Moshi alone |
|---|---|---|
| 推論 | 8/10 | 1/10 |
| STEM | 9/10 | 2/10 |
| 人文科学 | 9/10 | 4/10 |
特に推論・STEMタスクでの改善が顕著です。これはLLMバックエンドの知識注入が、事実確認や論理的推論を必要とするタスクに効果的であることを示しています。
セットアップ手順
必要環境
| 要件 | 内容 |
|---|---|
| Python | 3.10以上(3.12推奨) |
| GPU | CUDA対応GPU(必須) |
| API キー | OpenAI API Key(バックエンドLLM用) |
| Google認証 | Google Cloud Speech-to-Text(ASR有効時) |
インストール
KAMEはまだPyPI未登録のため、GitHubから直接インストールします。
uv init --bare --python 3.12
uv add "kame-model @ git+https://github.com/SakanaAI/kame.git"
公式READMEでは特定コミットハッシュ(例:
@1a69ee29...)を付与した形式を推奨しています。再現性が重要な場合は GitHub で最新のコミットハッシュを確認してください。
ローカル開発(pip)の場合:
git clone https://github.com/SakanaAI/kame.git
cd kame
pip install -e .
環境変数の設定
# バックエンドLLM用(必須)
export OPENAI_API_KEY="your-api-key"

# ASR用Google Cloud認証(ASR有効時のみ)
export GOOGLE_APPLICATION_CREDENTIALS="/path/to/credentials.json"
サーバーの起動
オラクル誘導サーバー(推奨)
uvプロジェクト環境でインストールした場合:
uv run python -m kame.server_oracle \
  --hf-repo SakanaAI/kame \
  --host 0.0.0.0 \
  --port 8998 \
  --device cuda
pip(ローカル開発)環境でインストールした場合は uv run を除いて実行します。起動後、ブラウザで http://localhost:8998 にアクセスするとWebUIが表示されます。
ASRなしでのテスト(Google認証不要)
uv run python -m kame.server_oracle \
  --hf-repo SakanaAI/kame \
  --port 8998 \
  --device cuda \
  --no-enable-asr
汎用サーバー(互換性確保)
uv run python -m kame.server --help
注意点
現時点のKAMEサーバーは WebSocket接続を1セッションのみ サポートします。同時接続を試みると503エラーが返ります。本番環境での並列利用には工夫が必要です。
ASRはデフォルトで有効(Google Cloud Speech-to-Text、英語
en-US)。日本語対応の場合はASRの設定変更や別途音声認識エンジンの統合が必要です。
バックエンドLLMの切り替え
バックエンドの切り替えは推論時に行えます(再学習不要)。claude-opus-4-1をバックエンドに使う場合は、対応するAPIキーと設定を指定します。
| バックエンド | 特性 | 用途例 |
|---|---|---|
| gpt-4.1 | 人文科学・創作タスク向き | 会話・物語生成 |
| claude-opus-4-1 | 推論・論理タスク向き | 質問応答・分析 |
| gemini-2.5-flash | 高速・マルチモーダル | レイテンシ重視の応用 |
現状の制約と今後の課題
公式発表時点での制約をまとめます。
| 項目 | 現状 |
|---|---|
| 同時接続数 | 1セッションのみ |
| 言語 | 英語(en-US)が主要サポート |
| ASR依存 | Google Cloud Speech-to-Text(有料) |
| PyPI未登録 | GitHubインストールのみ |
| GPU必須 | CUDA環境が必要 |
カスケード型Unmute(MT-Bench 7.70)との差も残っており、フロントエンドS2Mモデルの知識容量やオラクルストリームの統合精度向上が今後の研究課題です。
まとめ
Sakana AIが発表したKAMEは、音声AIの「低遅延か知識品質か」という二律背反を解消する実用的なアーキテクチャです。
- タンデム設計 によりS2Sの即時性とLLMの知識を両立
- Moshi単体比でMT-Benchスコアを 2.05 → 6.43 に大幅改善
- カスケード型には及ばないが レイテンシは圧倒的に優位(near-zero vs 2.1秒)
- バックエンド非依存設計 でGPT / Claude / Geminiを自由に切り替え可能
- MIT Licenseで商用利用も可能
音声AIエージェントの応答品質とリアルタイム性を同時に求める開発者にとって、KAMEは有力な選択肢になりえます。
参考リンク
- KAME 公式ブログ(Sakana AI) — アーキテクチャ詳細・デモ
- GitHub: SakanaAI/kame — ソースコード・インストール手順
- HuggingFace: SakanaAI/kame — モデルウェイト
- arXiv論文 (2510.02327) — ICASSP 2026採択論文
- Kyutai Moshi(GitHub) — フロントエンドのベースとなるS2Sモデル