

見ていないのに褒めてくるので、仕事を取り上げました
안녕하신게라!パナソニック コネクト株式会社クラウドソリューション部の加賀です。
「さくらのAI Engine 3,000リクエスト使い切りチャレンジ」への参加記事として、夏季休暇中の個人的な自由研究を発表します。
突然ですが、GeoGuessrで強くなりたいんです。Street View(ストリートビュー)の風景だけで、どこに居るのかを当てるゲームです。好きです。けど勝てません。
そこで、風景を見て気づいたことを言語化する練習アプリを作りました。自分の観察をAIに採点させて、3,000回を使い切る算段です。
作ったものは geo-Ganbatte-Gengoka-Coach(コードMIT / データCC BY 4.0)に置いてあります。
Street ViewをAIに見せてどうこうするアプリでしょ、良くあるやつやん?
いいえ、違います。
風景を見る → 14の「スロット」に見えたものを書く → 候補国と決め手を答える → AIが採点する
学習者(人間)が言語化を頑張る場所「スロット」がこれ。

(「見えない」と「未確認」を分けたのがミソ、後半で解説。)
AIは風景を見ずに書いたテキストを採点します。
否が応でも人間が頑張らされるのでこれは強くなれるゾ。よし、採点。
AI「よく出来ています。次はもう少し細部に注目してみましょう」
……なんの成果も!得られませんでした!!
差分を見ずにLGTMされたときの気分に、よく似ています。
プロンプトに「具体的に細かくアドバイスして」と書き足しても変わりません。
悪いのはAIでもモデルでもプロンプトでもありません。おまけに、本当に勉強になったのはAIを使った部分ですらなく、学問に王道無しとはよく言ったもんです。
応答の質を決めていたのは、指示の文言ではなく、渡すデータの構造でした。
この記事は、それに気づいてAIから仕事を取り上げていった記録です。GeoGuessrの攻略記事ではありません。3行でまとめると
作ったもの  風景の観察を14スロットに言語化して、AIに採点させる練習アプリ
やったこと  プロンプトを1文字も変えず、渡すデータだけ足した。判定はコードへ寄せた
使った枠    3,000リクエストのうち588。1プレイ2リクエストに固定できたので余った
で、とてつもなく長くなった(過去最大長で読了目安50分)ので、目次を置いておきます。
| 段 | 読むところ | 何があったか |
|---|---|---|
| 動機 | 好きなのに、勝てないんです | 攻略本を読んでも勝てない。原因を分析 |
| 選定 | 無償枠の単位は、トークンではなく回数 | 数え方が、以降の設計をほとんど決めた |
| 失敗 | まず全部AIに投げてみた | 「評価できません」の隣に、謎アドバイス2件 |
| 転換 | 磨く場所を間違えていた | AIに何をさせるかではなく、何をさせないかを決める |
| 設計 | 渡すものを2つ足したら、応答が別人になった | プロンプトを1文字も変えずに、出力が変わった |
| 設計 | AIから、仕事を取り上げていく | 責務の線引き。コアロジックは渡さない |
| データ | 作り込んだデータから出てきた、私の間違い | 辞書262語。間違えてもいいじゃないか、人間だもの |
| 実測 | 1プレイ2リクエストという式 | 踏んだエラーと打ち切り。誰も知らない謎の空白40kバイト |
| 検証 | 前提が次々と崩れていく | 辞書を凍結して別の10問で測ったら、精度が1問ぶん落ちた |
| 感想 | いちばん勉強になったのは、辞書を作る作業 | 夏の宿題がわんこそば化してしまった |
| 由来 | 借りたものにも、自分の記憶にも、無い精度を足さない | 辞書262語を人手・参照・AI生成で分け、ライセンスも分けた |
| 配布 | 置いてあるものと、直し方 | リポジトリの場所と、誤りを見つけたときの直し方 |
| 結び | 結論 | 残2,412リクエストで無限そば打ちの夏 |
ここまででもう長いよ!という方は夏の宿題がわんこそば化したくだりと結論を読んでからLGTMして離脱でひとつ!ストックして暇な時に読んでくれるととても嬉しいです。
好きなのに、勝てないんです
ゲームの実力は真ん中より少し下のGold帯です。先月はMaster帯に居ましたが落ちました(涙)
攻略本が無いわけではありません。Plonk It というコミュニティ製の資料が、鬼のような詳しさでまとめてくれています。出題頻度が低そうなカザフスタン1カ国分だけでも、「ボラード」(車道脇の短い杭)の形状から撮影車の汚れの位置まで載っています。
読みました。フランスやブラジルの市外局番、インドネシアの郵便番号も覚えました。それでも勝てません。学んだ国に居ると判って、かつ覚えた情報が写っているときだけ強くなるからです。国を外せばその知識は使えず、ゲームは正解に近いほうが強いので試合にも負けてしまいます。
そもそもなぜ、資料を読んでも強くならないのでしょうか。原因を3つに分けて整理してみました。
| 失敗の型 | 中身 | 攻略本を読めば解決するか |
|---|---|---|
| 知識欠落 | 見えているが、意味を知らない | する |
| 観察漏れ | 写っているのに、見えていない | しない |
| 想起失敗 | 知っているのに、思い出せない | しない |
読むのは受動的な行為ですから、後ろの2つは残ります。私の場合はその2つでした。見えていても記憶と少し違うと反応できず、知識も消えたわけではなく引き出せていないだけ。鍛えるべきは知識の量ではなく、「見ること」と「思い出すこと」でした。
この3分類、GeoGuessrに限った話ではありません。資格の勉強でも、コードレビューでも、「参考書は読んだのに現場でそれが出てこない」は同じ形をしています。心当たりのある方、一緒に泣きましょう。
では、どう鍛えるのか。自分で見て、自分で思い出す側に回るしかありません。読むのをやめて、書くんです。
それで、こういうアプリにしました。風景が1枚出て、プレイヤーは「スロット」と定義した13個の観点に沿って、見えたものを言語化していきます。通行帯は右か左か。路面標示は何色でどんな引き方か。電柱は木製か鉄製かコンクリート製か。標識の形と配色は。文字は何が書いてあるか。撮影車が写り込んでいないか。……といった具合です。どこにも入らないものは「その他」のスロットへ記入し、合わせて14スロットになります。
書き終えたら候補の国を最大3件、確信度つきで答えて、決め手にしたスロットを選びます。そこでようやく、AIに採点させます。
入力画面で「見えない」と「未確認」を分けた理由がここです。「見えない」は判断で、「未確認」は観察漏れの候補。分からないものを「見えない」にしてしまうと、見落としが永久に検出できません。この区別が、あとでコード側の null と [] の話と繋がります。
あの画面に文字しかないのも、意図です。AIに画像は渡しません。渡すのは学習者が書いたテキストだけです。規約の事情もありますが、規約が許していても渡さなかったと思います。AIが画像を見た瞬間、「見ること」がAIの仕事になります。それでは想起の訓練になりません。せっかく作ったコーチが、代わりに問題を解いてくれる家庭教師に化けてしまうだけです。
【コラム】保存してよいのは、画像ではなくID
Google Maps Platformの規約では、Street Viewの画像そのものをキャッシュしたり保存したりはできません。一方でパノラマを指すIDは、無期限に保存してよいものとして扱われています。問題セットをIDだけで配れるのは、このおかげです。
無償枠の単位は、トークンではなく回数
採点役にさくらのAI Engineを選んだのは、ここが理由です。「基盤モデル無償プラン」を選んでおけば、無償枠を超えても勝手に従量課金へ移りません。安心に勝るもの無し。
選んだあとで、性質が2つあることに気づきました。これが以降の設計判断をほとんど決めます。1つは、無償枠がトークンではなくリクエストの本数で数えられること。もう1つは、OpenAI互換でチャットモデルを同じ実装のまま差し替えられることです。
本数で数えるので、長い文章を書かせても1回、短い判定を1つ聞いても1回です。中身の重さは関係ありません。AIに小さな判断を何十個も聞く作りにした瞬間、無償枠が溶けます。逆に「1プレイあたり何回」を固定できれば、月に何プレイできるかが先に分かります。無償枠を数えられる形にしておく。これが最初の要求になりました。
副作用が1つあります。無償枠の中ではトークン単価が効かないので、モデルを選ぶときに値段を見る意味がありません。迷ったら重いほうを選べます。
差し替えられると、比べるのが安くなります。同じ入力を複数のモデルに投げて食い違いを見られます。これがあとで、私自身の間違いを見つける道具になりました。
使えるチャットモデルは9種あって、そこから4種を比較用に選びました。消費を惜しんで絞ったわけではありません。落ちるものが落ちただけです。
【コラム】9種から4種に落ちるまで
llm-jp-3.1-8x13b-instruct4 はコンテキスト長が4,096トークンで、採点プロンプト(正解タグ+用語辞書262語+判定結果)も、選択肢が50件ずつ並ぶ正規化スキーマも収まりません。max_tokens を8,000で投げてHTTP 400、ここで脱落です。preview/Qwen3-0.6B-cpu はCPU実行で、いちばん小さいのに38〜45秒かかりました。小さいモデルが速いとは限らない、を身をもって知りました。残りはもう1種のCPU実行、画像入力向けの1種、コーディング向けの1種で、どれも採点を比べる用途には向かないので外しました。これとは別に、提供終了したモデルと、個人アカウントでは使えない「要申請」のモデルもあります。残った gpt-oss-120b、preview/Kimi-K2.6、preview/gemma-4-31B-it、preview/Qwen3.6-35B-A3B の4種で、系統とサイズの幅は確保できました。なお max_tokens はモデルごとに設定しています。一律の値にすると、上のほうと下のほうが両方落ちます。
この時点で分かっていたのは「AIに細かいことを聞きすぎると無償枠が死ぬ」だけです。設計はまだ何もありません。
まず全部AIに投げてみた
最初の版を「v1」と呼びます。制約を抱えていたはずなのに、結局ほぼ全部AIに投げました。人間は学習しません。
わざと持たせなかったものが2つあって、「正解タグ」(その地点に何が写っていたかの記録)と「用語辞書」です。学習者のメモと回答だけを渡して採点させました。
トルコの問題で、実際に私が書いたメモがこれです。
| スロット | 私が書いたこと |
|---|---|
traffic_side(通行帯) |
右側通行 |
sign(標識) |
青いポールに八角形の赤い標識に白い文字でDURと記載 |
script(文字) |
Gの上にチェックマーク、Sの下にヒゲみたいなのが付いている |
architecture vehicle pavement
|
(それぞれ記入あり) |
road_marking(路面標示) |
写っていない |
pole(電柱) |
写っていない |
| 残り6スロット | 写っていない/見ていない |
回答は「トルコ、確信度は高」。決め手は sign で、推論はひとこと「DURはトルコ一択」(DURはトルコ語で一時停止)。正解でした。
このメモだけを渡されて、私が何を見落としたかを言えるでしょうか。言えないですよね。何が写っていたかの一覧が、どこにも無いからです。私が「写っていない」と書いたスロットが本当に空だったのか、それとも私が見落としたのか、区別する材料がありません。AIも同じ立場に置かれるため、「判定できません」と答えられる欄も用意しておきました。
送信して、20秒ほど待ちました。gpt-oss-120b の応答です(記録の生データ)。
judgmentUnavailable : true      ← 判定できません
missedClues         : 2 件      ← 見落としはこの2件です
説明欄にも、はっきり書いてあります。
本地点の正解タグや用語辞書が提供されていないため、見落としや過剰申告については評価できません。
そのすぐ隣に、この2件が並んでいました。
[road_marking] 道路標示は、トルコの道路では白線が中心に連続し、側線は黄色です。
[pole] 電柱・街灯の形状は、トルコでは丸みを帯びた金属製が多く、照明塔のデザインも地域特有です。
上のメモをもう一度見てください。私が「写っていない」と書いた、その2つです。
丁寧です。勉強にもなります。ありがとう。でもそれ、写ってませんことよ?
オーストラリアの問題では、もっと分かりやすいものが出ました(記録の生データ)。
[sign] もし道路標識が視界に入っていれば、オーストラリア独自の形状や、州ごとのデザイン差が手がかりになります。
「もし視界に入っていれば」と仮定法です。写っていたかどうかを知らないことを、自分で分かって書いています。同じ応答の中に「※今回の判定では見落としや過剰申告の判断は行っていません」まで添えてあるのだから、自覚のほうは完璧なんですね。
指示は伝わっているのに欄は埋めてくる、そこがAIの面白いところです。
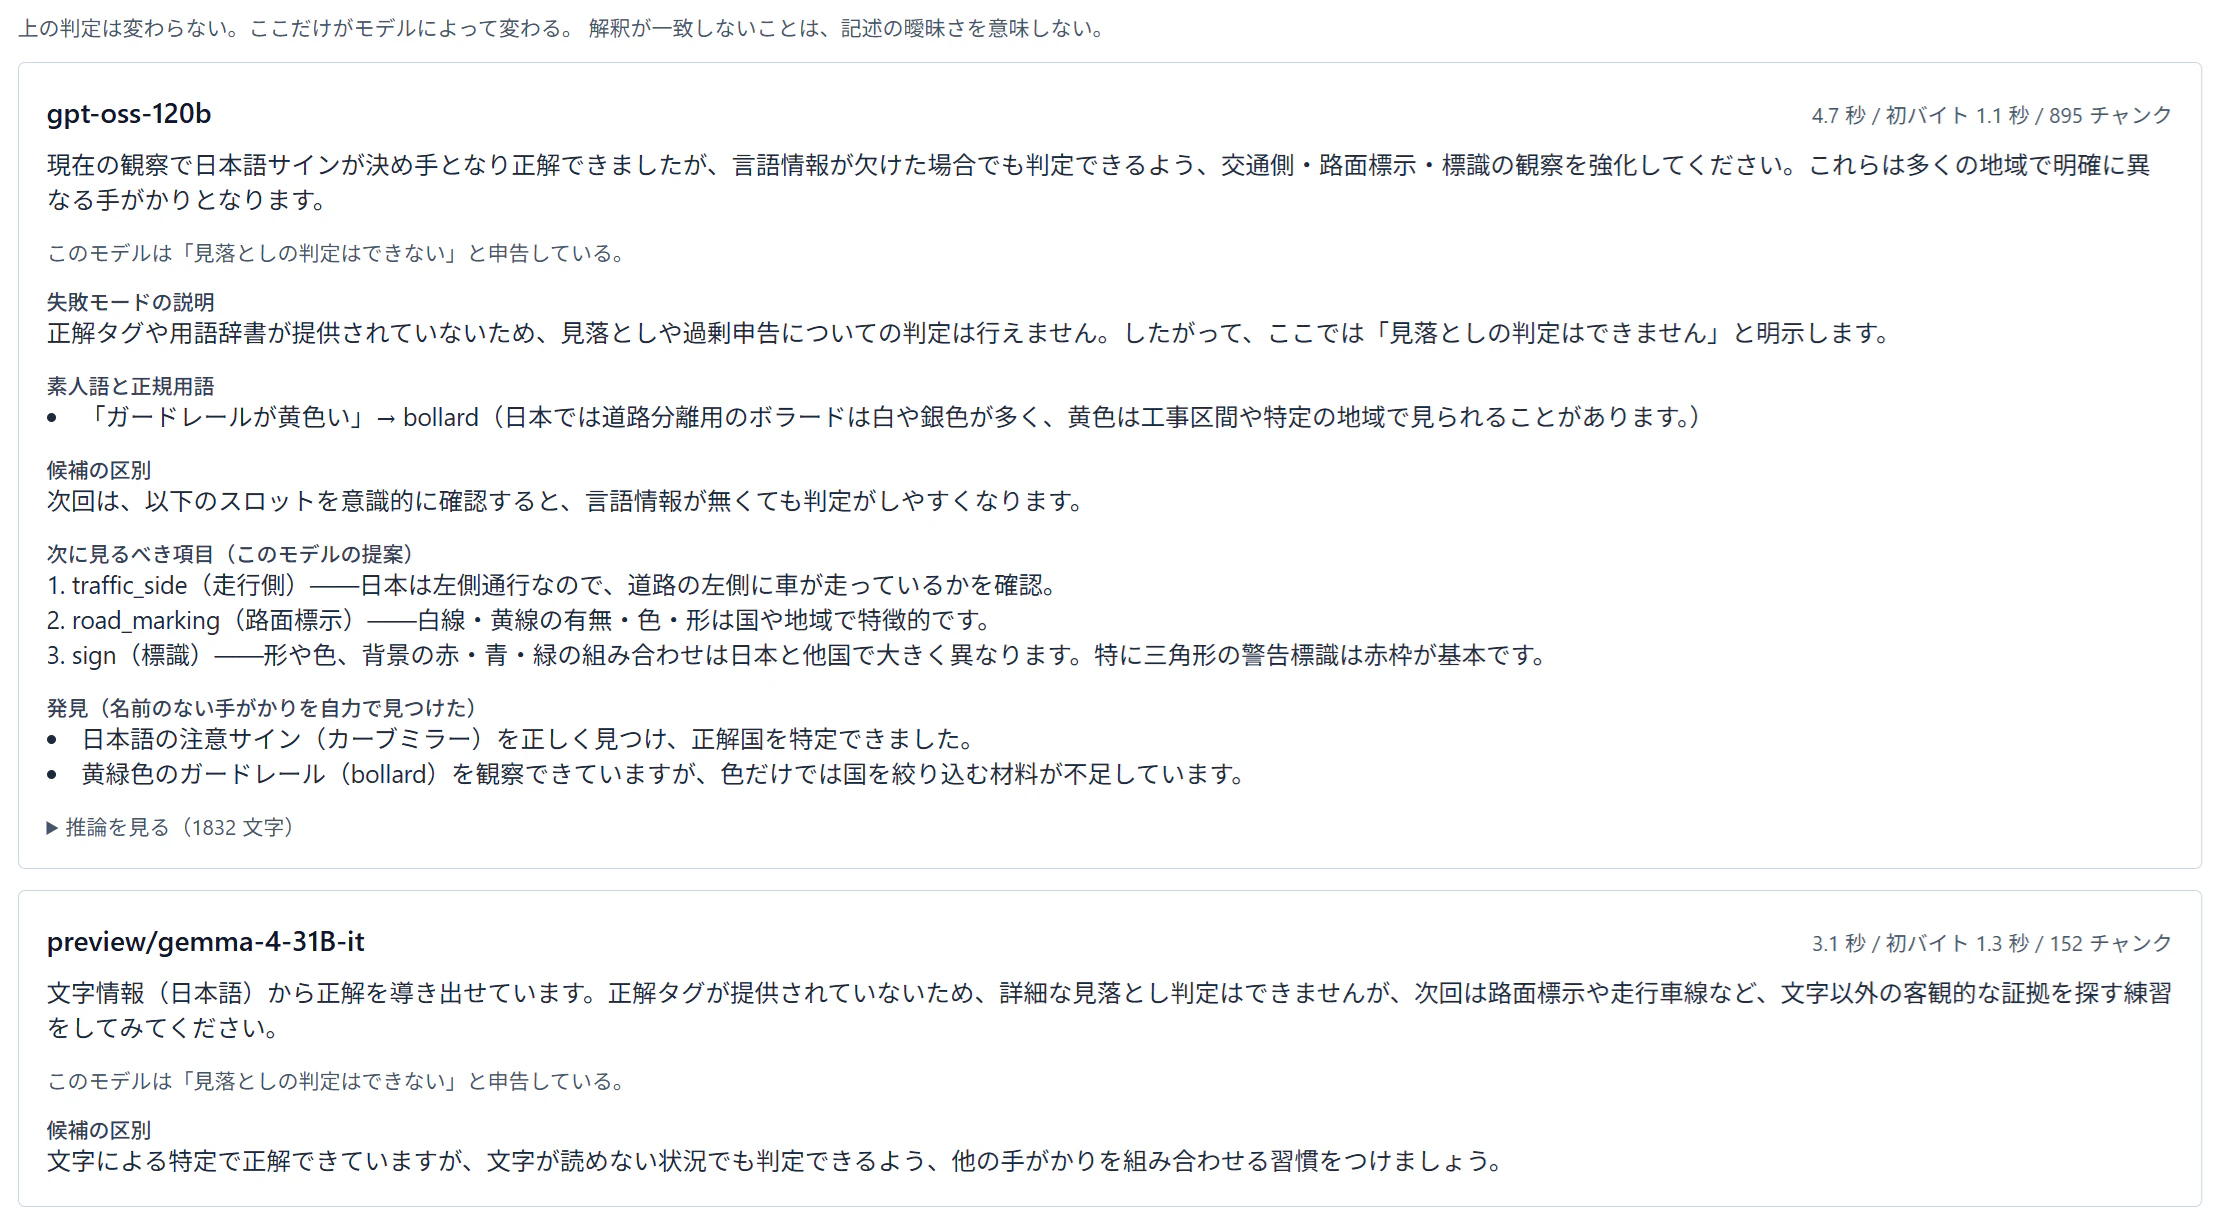
4モデルとも同じ申告をしていて、「次に見るべき項目」の見出しには括弧書きで「このモデルの提案」と付いている通り、v1では次にどこを見るかまでAIに考えさせていました。
磨く場所を間違えていた
さんざん粗を並べましたが、モデルの出来の話ではありません。gpt-oss-120b は preview/ の付かない提供で、あとで出てくる打ち切りとも別の話です。責められないのは、私が「何が写っていたか」を渡していないからです。具体的なことを言えるはずがない。それでも欄は空けられないので、正解の国の一般論で埋めてくれている。
そこで問いを立て直しました。AIに何をさせるかではなく、AIに何をさせないかを決める。
残った仕事は、コードか人間が引き取る。
無償枠の話とも、ここでつながります。AIに聞く回数が減れば、1プレイあたりの本数が固定できます。ケチる理由と、設計を良くする理由が一致しました。
やることは2つ。渡すデータを足すことと、コアロジックをAIから引き剥がすことです。
渡すものを2つ足したら、応答が別人になった
v2で足したのは「正解タグ」と「用語辞書」の2つだけです。採点プロンプトは1文字も変えていません。 項目は2つでも、採点プロンプトの入力トークンは1,505から6,122へ、4倍に膨らみました。
そのプロンプトを先に見せておきます。v1もv2もこれです。
判定はすでに済んでいます。あなたは判定をやり直しません。
与えられた判定結果を、学習者にとって意味のある説明に変えることがあなたの仕事です。

## 絶対に守ること
1. 画像を見ていないことを前提に振る舞う。風景について推測で語らない。
2. 「この地点に写っている」と断定してよいのは、入力の「正解タグ」に記載された
   手がかりだけである。
3. 「用語辞書」から得た知識は「この国では一般に」という一般的な傾向として述べる。
   当該地点の事実として断定しない。
4. 入力の判定結果(見落とし、正誤、失敗モード)を変更しない。追加も削除もしない。
5. 正解タグが与えられていない場合、見落としについて何も述べない。
   「見落としの判定はできません」と明示する。推測で補わない。
6. 学習者を励ますだけの内容を書かない。次に何を見るべきかを必ず具体的に示す。
v1で無視されたのは5番です。正解タグを渡していないのだから、この指示は「黙れ」と言っているのと同じでした。それでも一般論で欄を埋めてきます。指示の強さの問題ではありませんでした。
テンプレートは1つしか持っていません。差し込むコンテキストの有無でv1とv2を切り替えています。全文は grading-prompt.md にあります。
正解タグは、その問題に何が写っていたかを人間が書いた模範解答です。
script        キリル文字。Kの右下にヒゲが付いた字がある
road_marking  中央線が黄色の実線
other         路肩のガードレールが波模様を模した柵
bollard       (写っていない)
学習者のメモと同じ型です。突き合わせれば差分が機械的に出ます。
もう一方の用語辞書は、「その言葉が何カ国に該当するか」の対応表です。全スロットで計262語。扱う国は102カ国に絞りました。以降に出てくる「何カ国」は、すべてこの102カ国のうちの数です。左側通行は世界では約75の国と地域ですが、この辞書では24カ国になります。
| 書けた内容 | 用語ID | 該当国数 |
|---|---|---|
| 「アルファベットっぽい」 | ref_script_latin |
91 |
| 「キリル文字」 | ref_script_cyrillic |
11 |
| 「Kの右下にヒゲが付いた字がある」 | ref_lang_cyr_kazakh_letters |
1 |
どれも同じスロットに、同じ日本語で書いた文章です。粒度だけで91倍違います。風景は1枚も変わっていません。変わったのは私の書き方だけです。「ちゃんと書いた」と「絞り込める粒度で書いた」は別物で、その差が数字で出ます。「よく書けています」とは言えないけれど、「その表現では91カ国です」とは言えるわけです。
あいだをつなぐ処理を1つだけ足しました。辞書は用語IDで引きますが、学習者は用語IDで書きません。
「点が2つ付いた文字がある」 → ref_lang_umlaut
この翻訳だけがAIの仕事です。表記の揺れが無限にあるので、辞書引きでは届きません。翻訳が済んだら、あとは全部計算です。数える、掛ける、引く。
出力はこう変わりました。v1では4モデルすべてが見落としを0件にして「判定できません」でしたが、v2では4モデルすべてが1件出してきました。しかも中身が同じです。
[other] 路肩のガードレールが波模様の柵 / このデザインは……他の候補国と区別する重要な手がかりです
正解タグに私が書いた文が、そのまま助言になって返ってきました。ここで私は満足しました。後で打ちのめされるのに。
もう1つ、はっきり変わったものがあります。v1で preview/Kimi-K2.6 がこう指導してきたんです。
bollard(車道脇の短い杭・ポール)の欄に「ガードレールが黄色い」とあります。ガードレールはボラードではないため、今後は欄の使い分けに注意してください。
一般論としては正しいです。でもこの領域では正しくありません。私は自分の観察の都合でガードレールの支柱もボラードと同じ軸に入れているためです。(あとで気付いてスロットを増やすのが面倒だっただなんて言えません)
guardrail_post_serves_as_bollard ガードレールの支柱がボラードの役目を果たす
なので、 bollard に書くのは正当な観察です。鍛えたいのは観察であって、分類ではありません。
書くスロットを間違えたと叱られて直しても、GeoGuessrは上手くなりません。(キリッ)
v2では preview/Qwen3.6-35B-A3B がこう返してきました。
分類の位置違いは観察の失敗ではないのでそのまま評価します。
同じ設計意図に対して、真逆です。なおこの2つは別の問題への応答なので、同じ問題の前後比較ではなく、「スロット違いをどう扱うか」の観察として並べています。
v1がスロット違いを減点してきた理由も、これで分かりました。こちらが材料を渡していなかったんです。隣のスロットに記述があるかどうかは、正解タグがあればコードで計算できます。v1ではそれを「判定不能」で渡していたので、AIは自分の一般常識で判断するしかありません。

見出しの下に「上の判定は変わらない。ここだけがモデルによって変わる」と書いてあります。次の節で出す責務の線引きを、画面の側から言い直したものです。
「素人語と正規用語」の欄も見てください。「中央線は黄色の実線」が「黄色の実線(中央線)」に変換されています。AIに残した入口の仕事が、ここに出ています。
「ユーカリの木だらけ」への、3つの応答
オーストラリアの問題で私が書いた1行に対する応答が、3回の実測で変わっていきました。
terrain_vegetation(地形・植生) ユーカリの木だらけ
1回目は、辞書にユーカリが無い状態でした。
辞書に登録された「trees_close_to_road」は3か国(BR, ID, PH)に対応しますが、ユーカリ自体は辞書外の情報です。独自に見つけた手がかりとして評価できます。
正直で、無害です。ただ何も教えてくれません。辞書に無いものは、AIにも扱えません。
2回目は、私の連想を辞書に入れました。「道路のすぐ横に木々があるとブラジル・インドネシア・フィリピンを連想する」という実戦メモを、そのまま突っ込んで回しています。
「ユーカリの木」 → 道路のすぐ横に木々
trees_close_to_road: 一般に3カ国で確認される植生配置です。
オーストラリアの問題で、ブラジル・インドネシア・フィリピンを教えています。1回目より悪くなりました。「辞書に無い」と正直に言っていたものが、私の連想を借りて誤った断定に変わっています。
3回目は、出典から用語を作り、「絞り込みには使わない」という印を付けました。オーストラリアに多いのは事実ですが、ポルトガル・スペイン・ブラジル・南アフリカにも植林されているので、掛け合わせに入れると他の国を誤って消します。
ユーカリ(
ref_flora_eucalyptus)は AU でよく見られる樹種ですが、辞書に掲載されている以上の国でも見られることがあります。単体では絞り込みに使えませんが、観察できていること自体はプラスです。
これが欲しかった応答です。ユーカリという名前を教えていて(知識欠落をふさぐ)、オーストラリアに多いと言っていて(想起を助ける)、それでも単独では決められないと断り(誤った断定をしない)、観察できたこと自体は褒めている(鋭い観察を無視しない)。4つが同時に入っています。
2回目から3回目のあいだには、もうひとつ失敗を挟んでいます。「絞り込みには使わない」と決めた直後、この観察は応答のどこにも現れなくなりました。絞り込みの計算から外したので、AIに渡すものが無くなったんです。学習者から見れば、自分がいちばん鋭く書いた1行が、無視されたことになります。絞り込みに使えないものにも、言うべきことは残っていました。そこで「絞り込みには使わないが、説明はする」という区分を別に作って渡しました。件数は渡していません。書くと絞り込み力に見えてしまうからです。
3回とも、採点プロンプトは同一です。さきほどの6項目の下に判定結果を流し込む欄があって、変えたのはそこへ入る中身だけです。新しく作った区分も、その欄に行が1つ増えただけで、指示文のほうは触っていません。1回目の「何も教えてくれない」応答に対して、私が「もっと具体的に指摘して」と書き足していたら、たぶん2回目に近いもの、もっともらしく断定する応答が返ってきていたはずです。
応答の質を決めていたのは、指示の文言ではなく、渡すデータの構造でした。
3回分の応答は docs/v2-feedback-read.md に原文のまま入っています。
AIから、仕事を取り上げていく
もう半分は、コアロジックの引き剥がしです。線引きはこうなりました。
| 処理 | 担い手 | 理由 |
|---|---|---|
| 人間の文章 → 用語IDの対応づけ | AI | 表記の揺れが無限。辞書引きでは届かない |
| 見落とし・過剰申告の検出 | コード | 正解タグとの差分 |
| 該当数の算出、掛け合わせ、除外 | コード | 集合演算 |
| 次に見るべきスロットの算出 | コード | 縮小量を計算して並べる |
| 正解タグの下書き | コード | 観察メモを規則で振り分けるだけ |
| 正解タグの確定 | 人間 | パノラマを見ないと決まらない |
| 視認可能性の判定 | 人間 | 計算できない、見つけ難さは主観 |
| 画像認識 | やらせない | 規約と学習効果の両方の理由 |
| 判定結果 → 学習者に伝わる文章 | AI | ここが本来の仕事 |
確実に判定できるものはコード、計算できないものは人間、曖昧さの解釈だけをAIに任せ、コアロジックには手を出させません。
1行だけ、設計と実装がずれました。正解タグの行は当初「AI利用を許容」でしたが、最後までAIを1回も呼びませんでした。下書きは規則で振り分けられるのでコードに、確定はパノラマを見るしかなく画像を渡さないと決めた以上人間に取られて、AIの仕事は上下から挟まれて消えました。
「画像認識はやらせない」と「正解タグの下書きはAIに許容」を同じ表に並べていたのが、そもそも矛盾でした。手を動かすまで気づかず、正解タグは最終的に20問ぶん全件が私の手書きです。
線を引いた理由を、3つだけ。
掛け算は、コードにしか正確にできない
同じ用語が、2つの問題で正反対の働きをしました。
南アフリカの問題      sign(3)→3            traffic_side(24)→1
オーストラリアの問題  traffic_side(24)→24  season(46)→17
スロット(単独の該当国数)→掛けた後に残る国数 と読んでください。
「左側通行」は24カ国です。初心者でも一目で分かるのに、オーストラリアの問題では単独で何も絞れていません(24→24)。ところが南アフリカの問題では、3カ国まで絞れたところに掛けて1カ国に確定させています。同じ用語です。弱い記述は、組み合わせの最後の1ピースとして必要でした。
そしてこれは集合演算です。AIに聞いても数字は返ってきますが、もっともらしいだけで当てになりません。
「判定不能」と「該当なし」を型で分ける
コードが計算した判定は、こういう形でAIに渡ります。| null は手抜きではありません。
missedSlots: SlotId[] | null    // null=判定不能(計算していない)
                               // []  =計算した結果、該当なし
これを混ぜると、v1の採点は「見落としゼロ」と読める出力になります。学習アプリとしてはこれが最悪です。見落としを、見落としと気づけないんですから。スロットの「写っていない」と「見ていない」を分けたのと、同じ理由です。
最初は「判定不能フラグ」を1個持たせる案でした。却下しました。フラグは無視できますが、null は TypeScript が分岐を強制します。型で防げるものを、規律で防がない。……そしてv1でお見せしたとおり、AI側に持たせた同じ趣旨のフラグは、見事に無視されました。自分の判断が正しかったことを、こんな形で確認したくはなかったです。
見落としの検出をコードに寄せたのも、同じ理由です。ただしここは、単純に数えるだけでは足りませんでした。撮影車のアンテナが完璧な弁別子だとしても、私にはアンテナだと認識できません。路面標示が白飛びしていれば読めません。国を特定できる強さを持っていても、学習者の目に入らなければ手がかりになりません。だから正解タグ側に recognition を足して、見ればすぐ分かるものを easy、意識して探せば見えるものを hard、写っているけれどこの学習者には認識できないものを blind として、人手で記録しました。blind は見落としに数えません。既定値も easy にはしていません。既定を置くと「確認していない」が「見えるはず」に化けて、私のタグ付けの手抜きが学習者の失敗として表示されるからです。
ただし blind は私の目と経験に紐づいた値です。上級者から見れば hard かもしれず、初学者にはもっと多くが blind になります。辞書262語は誰でもそのまま使えますが、recognition だけは使う人が自分で上書きする項目になりました。
渡していなかった1項目が、嘘を生んだ
さきほど「正解タグに私が書いた文が、そのまま助言になって返ってきました」と書きました。あの引用、途中を省略していました。全文はこうです。
このデザインは旧ソビエト圏のカザフスタンで頻出し、他の候補国と区別する重要な手がかりです
この助言は誤りです。波模様の柵はカザフスタン固有ではありません。 旧ソ連圏で広く見られるものです。この助言に従うと、次に同じ柵を見た学習者はカザフスタンと答えて外します。学習ツールとしては最悪です。
原因は、渡していなかった1項目でした。「その他」のスロットは自由記述なので用語IDを割り当てておらず、渡ったのは日本語の記述だけでした。該当国のリストがありません。AIは知らないまま、少ない情報から自分で作り上げました。
ここでv1を思い出してください。4モデルが「判定できません」と答えていました。あれは、正しい態度だったんです。情報が無いときに黙るモデルは、情報が一部あるときに創作してきます。v1は黙り、v2は創作した。材料を渡して良くなるのは渡した部分だけで、渡していない部分は逆に危なくなります。全部渡すか全部渡さないかなら安全で、半分渡すのがいちばん危ない。ここは完全に見落としていました。
おまけに、責任をこちらに押し付けてきました。同じ回で、Kimi がこう助言しています。
次は、各用語の関連国一覧を確認し、候補地域と矛盾する用語を選ばないよう注意してください。
学習者は用語を選んでいません。選んだのは正規化したAI自身です。悪意はなくて、AIは自分が正規化したことを知らないんですね。プロンプトには辞書と用語ID付きのメモが並ぶだけで、そのIDを誰が付けたかは書いていないからです。
作り込んだデータから出てきた、私の間違い
線引きが決まったので、あとはデータを作る作業です。辞書の1件は、最終的にこういう形になりました。
interface Term {
  id: string
  plain: string          // 素人語の言い方
  countries: string[]    // 該当する国。件数が絞り込み力
  certainty: 'verified' | 'heuristic' | 'unverified'
  source: 'human' | 'reference' | 'ai'
  sources?: string[]     // 該当国リストの出典URL
  exhaustive?: boolean   // countries は網羅か、それとも連想か
  excludes?: string[]    // これが見えたら候補から外れる国
  gradient?: {...}       // 境界ではなく勾配のもの
  disputed: boolean      // モデル間で不一致があった
}
最初は id と countries だけでした。残りは全部、やらかしながら足しています。
| 足した項目 | 踏んだ失敗 | 決めたこと |
|---|---|---|
exhaustive |
連想を絞り込みに使い、1カ国に絞ったうえで外した | 連想では候補を切らない |
excludes |
「ある国」を全部書けないと、絞り込みに使えない | 「無い」と分かる1カ国のほうが強い |
gradient |
連続的に変わる特徴を二値にして、中間で外した | 勾配は候補を切る根拠にしない |
certainty と source
|
人間が書いたものを、検証済みと同じに扱っていた | 由来と確かさを別の項目にする |
連想を掛け合わせに入れると、連想が主張になる
ユーカリの2回目で使った、私の実戦メモです。もう一度置きます。
道路のすぐ横に木々があると、ブラジル・インドネシア・フィリピンを連想する
これは「次にどこを考えるか」の記録で、「木が道路の近くにある国はこの3つ」という主張ではありません。それを該当国として掛け合わせに入れたら、オーストラリアの問題で候補が1カ国(インドネシア)に絞れました。数字の上では大成功で、答えは大外れです。
そこで exhaustive で網羅と連想を分けて、連想は絞り込みの計算に使わず、「次にどこを考えるか」の提示にだけ使うことにしました。元々そういう記録なので、本来の用途に戻しただけです。
もう1つ。由来(source)を人手とAIで分けてあったのに、絞り込みの計算が両方を同じに扱っていました。項目を分けただけで、使い分けていませんでした。
「無い」と分かる1カ国のほうが強い
該当国リストは網羅でなければ使えません。「ユーカリがある国」を全部書けないので、ユーカリでは絞れない。ところが除外は逆で、1カ国について「そこには無い」と分かれば使えます。
ß を見た → スイスが候補から消える(スイスは ss と書く)
  → ß を使う国の全リストは要らない
無いと分かっている1カ国は、あると分かっている100カ国より強い。網羅リストを作る手間がいりません。引き算は網羅を要求しないので、連想の用語でも除外には使えます。連想のまま候補を切るわけではありません。excludes は countries とは別の欄で、「その国には無い」と1カ国ずつ確認できたものだけを書くからです。該当国のほうが連想でも、除外欄は検証済みで独立に持てます。掛け合わせのあとに引く順序にしました。
そしてフィリピンのトライシクルの形のように、地域をまたいで少しずつ変わる特徴もあります。これを二値の弁別子にすると、中間の地点で必ず外します。gradient の印を付けて、候補を切る根拠には使いません。「北から南へ、だんだんこう変わる」と言えるほうが、「こうだから南部だ」と断定するより身によく付きます。
【コラム】ドイツ語の ß が、スイスを消してくれる
ドイツ語で使う ß(エスツェット)は、スイスの標準的な正書法では使われず ss と書きます。看板に ß が出ていたら、それだけでスイスが落ちます。網羅リストが要らない。こういう1カ国を特定できる知識ほど費用対効果が高くなります。
データの話をしたいのに攻略記事になりつつある。
私が間違えた項目と、AIが間違えた項目
差し替えが安いのを、ここで使いました。同じ項目を4モデルに投げて、食い違いを探します。
モデル4つ全員が正解して、私だけが間違っていた項目がありました。ルーマニアです。キリル文字圏に分類していました。周囲の国にキリル文字が多いからここも同じだろう、と思っていたんですね。
あやうく教材に混入させるところでした。絞り込みの数字が狂って、アプリが誤った知識を教え始めます。
逆もありました。3モデルが揃って同じ間違いをした項目もあります。ガーナの通行帯です。旧英領だから左側通行だろうという一般化ですね。実際は1974年8月に右側通行へ変えています。AI間で多数決を取ったら、誤った多数派が勝ちました。ガーナテープが消えつつあるのでちゃんと学ぼうね!(自戒)
ガーナで正解した1モデルが preview/Kimi-K2.6 でした。通行帯を9カ国ぶん聞いた回の成績を並べると、こうなります。
| モデル | 誤答 | 応答時間 |
|---|---|---|
preview/Kimi-K2.6 |
0 / 9 | 54〜300秒超。504も出て、件数の欠損も起こした |
gpt-oss-120b |
3 / 9 | 22〜27秒 |
preview/Qwen3.6-35B-A3B |
4 / 9 | 17〜41秒 |
preview/gemma-4-31B-it |
4 / 9 | 5〜19秒 |
精度で完璧だった Kimi とは逆に、国の事実を作らせた回では gpt-oss-120b がオーストラリアの通行帯を外しています。オーストラリアが左側通行なのは、基本の「キ」です。
これで用途別の割り振りが決まりました。1プレイごとに走る正規化は速い gemma、長文を書かせる採点は釣り合いのいい gpt-oss-120b。事実を作る場面では、遅くていいので精度の高いものを混ぜる。
誤答4/9のモデルに毎プレイの正規化を任せるのは、一見おかしく見えます。ただ正規化は、辞書に並んだ選択肢のどれに当たるかを選ぶ作業です。国の事実を思い出す作業ではありません。事実は辞書側に書いてあって、モデルはそれを読むだけなので、ここで要るのは速さでした。上の表で測ったのは知識のほうで、正規化に必要な能力とは別物です。
仕事の割り振りは、AIとコードと人間のあいだだけの話で済みませんでした。
ただしこれも9カ国を1回ずつ聞いた記録です。モデルの順位表としては読まないでください。
票数では決まりません。一次情報と突き合わせるしかありませんでした。モデル間の一致は正しさを保証せず、信頼できる信号は「不一致」だけです。出た箇所を人手で確認する。この使い方に落ち着きました。
ただし突き合わせるには、書式を揃えておく必要がありました。自由記述にした項目は、102カ国すべてが比較不能になりました。
同一の言語が chinese / 中国語(繁体字) / 繁体字中国語 / 中国語(広東語)
選択肢を固定した項目だけが比較でき、人手確認の対象を特定できました。
いちばん痛かったのは、カザフスタンの柵です。固有だと思っていたのは、AIではなく私でした。思い込みを人手で正解タグに書き、AIが増幅して断定し、またあやうく教材になるところでした。AIが嘘をついたというより、私の思い込みに拡声器が付いた形です。
しかも人間とAIで対称ではありません。私の誤りは1件でも、その用語を使った組み合わせデータが全部汚染されます。だから由来(誰が書いたか)と確かさ(検証したか)を、別の項目として持つことにしました。
1プレイ2リクエストという式
最初の要求は、無償枠を数えられる形にすることでした。
コアロジックを全部コードに寄せた結果、AIを呼ぶ箇所が2つだけになりました。
正規化  1回(14スロットまとめて1リクエスト)
採点    1回
────────────────────
1プレイ 2リクエスト
肝は、正規化がモデル数に乗らないことです。正規化の出力は用語IDで、コードが使う事実なのでモデルによって変わりません。複数モデルで採点を見比べても、増えるのは採点の側だけです。
もし全部AIに投げていたら、見落としの検出で+1、掛け合わせで+1、絞り込み力で+1、次に見るべきスロットで+1。14スロットの正規化を1件ずつ投げたら、それだけで14回です。1プレイ20回に届きます。そしてリトライ処理を入れた瞬間に、無償枠終了のお知らせとなったことでしょう。
上限を計算してみます。1モデルで採点するなら1プレイ2回なので月1,500プレイ、1日あたり50問で約3時間です。4モデル同時に採点させると1プレイ5回になって月600プレイ、1日20問で約70分。14スロット埋めるのは、早くても1問3〜4分かかります。
無償枠が尽きる前に、人間の集中力が尽きます。制約が「無償枠」から「人間の時間」に移りました。1プレイが必ず2回だから、こうやって「月に何プレイできるか」を先に計算できます。リトライ処理を入れていたら、この計算は成り立ちません。
作っている最中の感想を1つ。トークンを数えなくていいのは、思ったより楽でした。
普段クラウドのコストを見ている感覚だと、プロンプトは短く、コンテキストは削り、max_tokens は絞るものです。ところが無償枠の中では、その努力が何も返ってきません。長いのを1回投げても短いのを1回投げても、減るのは同じ1回です。だから辞書262語は丸ごとプロンプトに入れて、max_tokens も絞らず余裕を持たせました。絞ると何が起きるかは、あとで実測が出てきます。
ただ、これは無償枠の内側だけの話でした。さくらのAI Engineには「基盤モデル無償プラン」と「従量課金プラン」があって、どちらも月3,000リクエストの無償枠を持っています。違うのは超えたあとで、無償プランはレート制御がかかるだけですが、従量課金プランは1万トークン単位の課金に入ります。単価はモデルごとに違い、出力だと私が比べた4種の中でも gpt-oss-120b の0.75円から preview/Kimi-K2.6 の3円まで4倍ひらきます(提供モデルと料金)。
「辞書を丸ごと入れる」も「max_tokens を絞らない」も「迷ったら重いほうを選ぶ」も、無償枠の内側に居たから気楽でいられただけで、外に出た瞬間まとめて請求書に化けます1。
そして内側に居ても、重いプロンプトは応答が遅くなり、遅くなればタイムアウトで転びます。財布は痛まなくても、時間で殴られます。
Google側も、既定の構成では課金経路が1つもありません。
| Google側の呼び出し | 課金 | このアプリ |
|---|---|---|
| Street View 表示(Embed) | 無料・無制限 | 使う |
| メタデータ照会 | 無料・クォータ消費なし | 使う |
| 画像取得 | 課金される | 呼ばない |
| 移動を止める表示(GeoGuessrのNoMove相当) | 月5,000まで無料 | 既定で無効 |
規約と学習効果のために画像を保存しない設計にした結果、画像取得を呼ぶ必要自体が無くなり、課金経路もついでに消えました。NoMoveで鍛えたい人は最後の行を有効にできます。ただ、ここだけ課金経路が生えるので既定では切ってあります。
このアプリはローカル実行専用です。APIエンドポイントも管理画面も認証を持っていません。公開すると第三者があなたの無償枠とAPIキーを消費できて、正解タグも書き換えられます。そもそも無償枠を共有する公開サービスは成立しません。尽きた瞬間に、全利用者へ影響します。
動かして踏んだこと
消費まわりの実測です。
| 事象 | 無償枠を消費するか | 踏んだ結果 |
|---|---|---|
| HTTP 400 | しない | パラメータを間違えて15回弾かれ、青くなったが減っていなかった |
| HTTP 504(約300秒) | する | 成功の保証なく減るので、スクリプトは意図的にリトライしない |
| 打ち切り | する | 200で返るので気づきにくい |
| RAG | 無償プランでも課金対象 | 使わない判断。辞書262語はプロンプトに全部入る |
400が消費しないのは、届いたけれど推論に入る前に弾かれたからですね。504のタイムアウトは非公開かつSLAの適用対象外なので、対処は1リクエストを小さく保つことだけです。
そして、AIに残した入口と出口も、そのまま信じるわけにはいきませんでした。以下は preview/ 付きモデルの挙動を含みます。提供段階の話です。基盤の品質とは切り分けて読んでください。
strict: true を効かせても抜けてくるものがあります。いちばん笑ったのがこれです。
"discriminationHint": "null"
JSONの null ではありません。4文字の文字列 "null" です。スキーマは文字列を要求しているので、これは通ります。バリデーションも通り、状態は「成功」になり、画面には「null」と表示されます。さきほど null と [] を型で分けた話をしましたが、型で守れるのは形までで、意味は守れません。
だから「成功」の中身をコードで監査するようにしました。辞書に無い用語を教えていないか、視認できないスロットを「次に見ろ」と言っていないか。4モデル13応答を通して、どちらも0件でした。ここもまた、AIから仕事を取り上げた1箇所です。
打ち切りにも遭いました。HTTPは200で通信も健全、なのにJSONが完成していない。
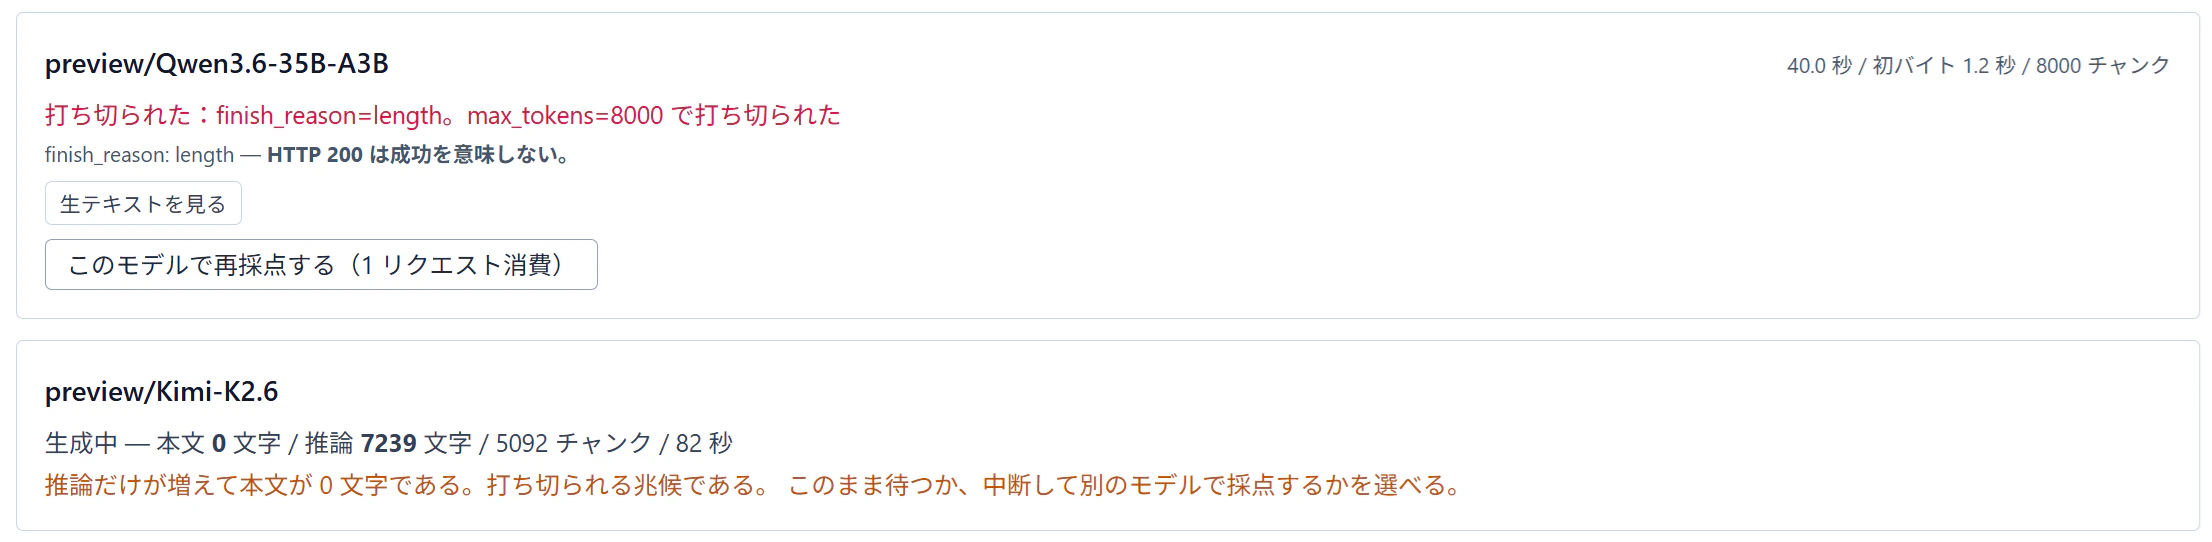
上のモデルは finish_reason=length で、max_tokens の上限に当たった素直な打ち切りです。
下のモデルのほうが厄介です。待っているあいだ、本文は0文字のまま推論の文字数だけが伸びていきます。max_tokens は推論の消費分を含むので、絞ると推論で使い切って content が空になります。これが、さきほど絞らなかった理由です。
本数で数える無償枠だからこそ、ボタンに「1 リクエスト消費」と書けて、押す前に何回減るかが分かります。
そして上限とは別に、もう1つのパターンがありました。
Kimi    本文 556字を書き終えたあと、末尾の空白 40,952字に280秒
gemma   同じ症状で 119.9秒 → 対策後は 8.6秒
対策は「末尾の空白が512字続いたら打ち切る」です。出力が長すぎたのではなく、書くのをやめたあと止まらなかったんですね。実は「JSONが閉じたら読むのをやめる」処理を先に入れてあって、発火しませんでした。JSONが閉じていないからです。前の対策は、閉じたJSONしか想定していませんでした。
なお、ここまで挙げた挙動をモデルの性質としては書けません。まったく同じ入力を2回投げたら、返ってくるものが違ったんです。3問×4モデルの12組で、完走したか打ち切られたかが一致しなかった組が4組、見落としの件数が一致しなかった組が5組ありました。別の日には、打ち切られるモデルが2つ入れ替わったこともありました。書けるのは「そういう壊れ方が実在する」までです(v1/v2の比較記録)。
前提が次々と崩れていく
都合の悪い結果も、そのまま残しておきます。
まず到達の実測です。10問について、正解タグの観察を強く縮む順に掛けていったら、1カ国まで届いたのが6問、複数カ国で止まったのが3問(17カ国/11カ国/11カ国)、掛け合わせに使える用語が0で算出不能だったのが1問でした。内訳は combo-report.md に全問分あります。
止まった3問について、最初は「辞書が足りない」と結論しました。それが誤りでした。
ai_pavement_01「アスファルト舗装」   102カ国
ai_vehicle_01 「白い横長のプレート」 101カ国
辞書が扱う国は102件ですから、アスファルトは辞書の全域に該当します。出典から埋めても縮まりません。
さらに「記述はあるのに用語が1つも付いていないスロット」を数えたら52件あって、これも埋めるべき欠落に見えました。中身を見たらこうでした。
camera  Gen4 / Gen3 / Gen4ノーカー ...
season  木の陰が北側に出ている ...
「Gen4」(下記コラム参照)に用語を作っても、国は1カ国も縮みません。数字だけ見て埋めに走っていたら、無意味な用語を52個作っていました。
【コラム】撮影車の「世代」という手がかり
GeoGuessrをやる人は、Street Viewの撮影機材を「Gen2」「Gen3」「Gen4」「SmallCam」と世代で呼び分けます。画質やつなぎ目の出方、写り込む車体の形が違うので、風景を見なくても上級者は撮影機材で絞り込みをしていたりします。ただし世代は国を直接示しません。同じ世代の車が何十カ国も回っているからです。見た目では真っ先に気づくのに、絞り込みに使おうと思うと学習量が相当必要になる、厄介な手がかりの代表格です。うん、攻略記事だね。
別の10問で測ったら、1問ぶん落ちた
さて、ここまでの数字には致命的な問題があります。最初の10問に合わせて辞書を作ったので、その10問で測れば当たり前に良い数字が出ます。
そこで公開直前に、辞書を1語も足さずに別の10問を作りました。韓国・イギリス・コロンビア・シンガポール・メキシコ・ニュージーランド・カナダ・ラトビア・チリ・ルワンダです(出題データ / 到達の実測)。辞書を触っていないことは指紋で確認しています。
$ npm run fingerprint -- --verify
用語 262 語(絞り込みに使える 180 語)
sha256: 909441b29d1483201aacffc69f1b6ddb1e8c49b8cf9335899077c0ae7de69554
一致した。辞書は記録した時点と同一である
結果です。
| 最初の10問 | 別の10問 | |
|---|---|---|
| 1カ国まで届いた | 6 | 5 |
| 複数カ国で止まった | 3 | 5 |
| 算出不能 | 1 | 0 |
落ちたのは1問です。辞書が最初の10問に過剰適合していたわけではなさそうです。ただ n=10 なので、これは傾向であって証明ではありません。
そして到達した5問のうち4問は、単独のスロットで決まっていました。
韓国              script(ハングル)  1カ国
メキシコ          pole(電柱の形)    1カ国
ニュージーランド  bollard             1カ国
ラトビア          sign(標識)        1カ国
ルワンダ          vehicle(6) × traffic_side(78) → 1カ国
「1つのスロットで決まることを期待しない」と設計して掛け算をコードに寄せておいて、掛け算で1カ国まで届いたのはルワンダだけでした。都合が悪いので正直に書いておきます。
厳密に言うと、掛け算そのものは他でも縮んでいます。イギリスは vehicle(6) に traffic_side(24) を掛けて5カ国、コロンビアは traffic_side(78) に script(91) を掛けて67カ国、カナダは3つ掛けて28カ国。ただ「縮んだ」と「決まった」は別で、1カ国まで行けたのは1問です。
最初の10問では違いました。南アフリカは sign(3) で3カ国まで絞ったあとに traffic_side(24) を掛けて1カ国。掛け算が最後の1ピースとして働いています。決め手になるかどうかは辞書の出来より、問題の引き次第でした。10問中1問だからといって、掛け算の実装が無駄だったとは思いません。とはいえ測るたびに動く数字なので、設計の根拠として持ち出せる強さでもありません。
検証ツールは「積集合に正解が含まれない」を7件報告してきました。最初の10問では1件だったものが、辞書を足していない別の10問で7件です(7件の一覧と原因の見立て)。そのうちシンガポールの問題を解いてみます。
road_marking 路肩の線が黄色い
事実です。シンガポールの路肩には黄色い線があります。そして情報量もありました。この記述に当たる road_marking_edge_yellow は、辞書で4カ国しか該当しない強い手がかりです。なのに結果はこうなりました。
残った候補: 南アフリカ、ボツワナ、レソト、エスワティニ(4カ国)
正解のシンガポール: 消えた
用語の該当国が南部アフリカ4カ国だったからです。出典が南部アフリカの話で、同一地域にまとまっているぶん手がかりとしては筋が良く、シンガポールが入る余地がありませんでした。
ここで判断が要ります。辞書を直すべきか。答えは、辞書を直さないことでした。
見立て  用語は正しく、手がかりが国を示さない
対応    その手がかりがシンガポールを示さないことが、正しい診断である
「路肩が黄色い」という観察自体は正しく、ただこの手がかりがシンガポールを指し示さなかっただけで、ツールが出したのは誤答ではなく正直な報告でした。
カザフスタンの柵と同じ症状ですが、原因は違いました。あちらは私が正解タグに思い込みを書いた話で、こちらは用語も観察も正しいまま噛み合わなかった話です。同じ症状に原因が2種類あるなら、症状を見て原因を決めてはいけません。 どちらもコードが「正解を含まない」と検出して絞り込みから自動で外れ、学習者に届くのは「その手がかりでは絞れません」だけで誤った断定は出ません。線引きしてて良かったと思えた場面です。
残した2つの仕事は、働いたのか
AIから取り上げた話ばかり書いてきたので、AIに残した正規化と採点も測っておきます。
正規化は、10問ぶんで132件を判断しました。用語IDを割り当てたのが71件、辞書に該当なしと判定したのが61件です。そのうち誤りは8件でした。
最初は、間違って付いた用語IDを正解タグから削って回りました。これで誤りは0件です。ところが同じ処理をもう一度走らせたら、消したものがそのまま戻ってきました。正規化は毎回、辞書を見て一から割り当て直すので、出力を消しても辞書が同じなら同じ答えが出ます。8件のうち辞書の書き方まで直したのは1件だけ。残りは走らせれば今も同じ誤りが出ます。
再発しなかった1件が、冒頭のトルコの問題です。私は script に「Sの下にヒゲみたいなのが付いている」と書きました。ところが辞書にはカザフ語の Қ が「Kの右下にヒゲが出ている」として入っていて、該当国は1カ国。トルコ語の ş や ç も日本語では「下にヒゲ」と呼ぶので、正規化がカザフスタンを引き当てたわけです。辞書側を「キリル文字で、Kの右下に下向きのヒゲが付いた字がある」「アルファベットで、sやcの下に小さなヒゲ(セディーユ)が付いている」と、文字体系から書く形に直したら止まりました。AIではなく、素人語の言い方が2つの用語で区別できていなかったのが原因でした。
採点では、出題をまたいだ言い回しの重複を数えました。同じ文が別の問題でも出てくるなら、その問題から何も読んでいないことになります。
gpt-oss-120b     12件 → 相異なる先頭30字 12  重複率 0%
Kimi-K2.6        13件 → 13                  0%
Qwen3.6-35B-A3B  10件 → 10                  0%
gemma-4-31B-it    3件 →  3                  0%
4モデルとも0%です。テンプレートを埋めているのではなく、渡した判定結果を読んで書き分けていました。残して正解でした。ただし gemma は13応答すべてが打ち切られていて、拾えたのは3件だけです。
満点ではありません。同じ監査で gpt-oss-120b だけ、根拠のない国の断定が1件と、正解タグに無いスロットを見落としとして挙げたものが2件出ています。監査を外せる段階ではありません。
わざと間違えてみた
アプリが判定する失敗の型は5つあって、さきほどの3分類より細かく切ってあります。ところが当ててばかりでは、そのうち1つも動きません。わざと間違えてみます。韓国なのに自信満々に日本と答え、通行帯と建物を見ないふりをした回では、こうなりました。
failureModes  confident_error + observation_miss
intersection  {"countries":["CO","JP","KR","TW"], "containsAnswer": true}
5つの型のうち、確信を持った誤答と観察漏れの2つが立ちました。ところが回答は外したのに、書いた観察のほうは正解に届いていたんです。電柱の黄黒の帯だけで4カ国。その中に韓国も日本も残っていました。
イギリスの回は、逆でした。
hit           true(低い確信度で候補に入れていた)
intersection  containsAnswer: false
当てたのに、観察は正解を落としていました。当たったかどうかと、観察が正しかったかどうかは、こんなに簡単に食い違います。ここを1つの点数にまとめていたら、どちらも見えませんでした。
限界も書いておきます。14スロットは観察空間を私の主観で切り出したものにすぎず、その外まで見ている上級者には何も返せません。対象は初級から中級までです。
いちばん勉強になったのは、辞書を作る作業
分かってました。アプリで練習する時間より、辞書と正解タグを作るのが勉強になるって。
学習アプリとしては、実に都合の悪い結論です。辞書も正解タグも、人間が入力しないと出題できません。AIを使って次から次へと問題を作ってもらおうとしたのに、結局自分で問題を作って自分で解いているのですから。
「セルフわんこそば」ここに極まれり。
冒頭で分けた3つの失敗のうち、「想起失敗」は読むだけでは直りません。辞書を作るのは、自分の記憶から手がかりを引き出して、出典と突き合わせて、食い違いを1件ずつ潰す作業です。ルーマニアの取り違えも、カザフスタンの思い込みも、この作業で判明しました。
これは学習アプリの宿命だと思っています。教材はその分野を知らない人には作れません。冒頭で「資格の勉強でもコードレビューでも同じ形」と言って一緒に泣いた構図と同じです。私の実感では、問題は解くより作るほうが頭に残ります。レビューも、受けるより指摘する側のほうが身によく付く気がします。
かくして夏季休暇の自由研究は、いつのまにか蕎麦打ちになっていました。
今のところ出題者は私だけ。自分で打ち、茹で、丼に入れ、すすっている。給仕も客も私です。 なんと滑稽な。
まだまだ食べたいのに、蓋を開けて待っていても次は来ません。残った無償枠がわんこそばに化けるかどうかは、私が何問作れるかで決まります。この作問こそが、いちばんの学習だとわからされました。
それでもアプリにできることが1つあります。誰かが打った蕎麦を、別の学習者へ給仕することです。一度この蕎麦打ち作業をやった人がいれば、次の人は客としてわんこそばを食べられます。
このアプリのWeb画面やAI採点はオマケ部分であり、262語の辞書と20問の出題データこそが本体だったのです。
借りたものにも、自分の記憶にも、無い精度を足さない
配るとなると、由来をはっきりさせないといけません。辞書262語の内訳は、私の実戦の連想を人手で書いたものが28語、公開資料を参照して人手で編集したものが172語、AIが生成して人手検証を経ていないものが62語です。混ぜていません。ファイル単位で分けてあります。そして参照した資料については、該当国リストの出典URLを項目ごとに記録しました。
確かさは別の軸です。一次情報で確認済みの verified が12語、実戦の経験則で人間が書いたが未検証の heuristic が188語、AI生成で未検証の unverified が62語。断定に使えるのは verified の12語だけです。出どころの辿れない数字は、一覧に混ぜません。
正解タグに、内訳を書く必要はありません。20問ぶん全件が人手で、AI生成は1件も入っていません。下書きを機械的に組んだスクリプトも、AIは呼んでいません。
冒頭で紹介した Plonk It は、どこを一次情報で確認すべきかの当たりを付けるために使い、データには取り込んでいません。素晴らしい資料ですが、コミュニティが積み上げたものをそのまま持ち出すわけにはいきません。
混ぜなかったのは、著作権の話だけではありません。私のメモには「なんとなくアフリカを考える」みたいな記述が入っています。同じ軸を公開資料はもっと多くの国について整理していますが、その数字で私のメモを上書きしてはいけません。本人が「なんとなく」と表現しているものを、勝手に厳密なルールへ変換しない。exhaustive と同じ話です。
ライセンスは3つに切りました。コードはMIT、データのうち人手記述の部分はCC BY 4.0、データのうちAI生成の部分は権利を主張しません。AIの出力には人間の創作的寄与が無いので、著作権が発生しないものとして扱っています(日本法での整理です)。自分が持っていない権利を、他人に許諾することはできませんから。辞書の由来を人手・参照・AI生成で記録しておいたからこそ、ライセンスもそのまま3つに割り切れました。
置いてあるものと、直し方
置いてあるのは geo-Ganbatte-Gengoka-Coach です。データ(辞書・正解タグ・検証ツール)を見るだけなら、必要なものは何もありません。アプリを動かすほうはAPIキー3本と npm install が要りますが、どちらも課金経路はゼロです。価値があるのはデータ側で、アプリはその使用例だと思ってください。手順はREADMEに、キーの権限をどこまで絞るかと課金がどこで発生するかは credentials-and-billing.md に書きました。動かす前に credentials-and-billing.md を読んでください。 検証ツールと問題セットを配る仕組みは、どちらもAIを呼ばないので消費0で動きます。
そしてこの辞書は、記事で書いてきた通り間違っています。その上、Street Viewの撮影が更新されれば、正しかった項目も合わなくなります。それでも今配る値打ちはある。間違いを見つけて直せる土台になっているからです。
直し方も置いておきます。誤りを見つけたらリポジトリのIssueかPull Requestへ投げてください。自分の辞書として持ちたい場合は、フォークして data/glossary.json を書き換えるだけで動きます。データはCC BY 4.0なので、gsolkaga, CC BY 4.0 の帰属表示を残していただければ、改変も再配布も自由です。
記事で引用した応答も、プロンプトも、全部そのまま置いてあります。一覧にまとめました。
| 見たいもの | 場所 |
|---|---|
| 採点プロンプト(v1もv2も同一) | grading-prompt.md |
| モデル選定の根拠、消費と打ち切りの実測 | design.md |
| 正解タグの下書き(AIを呼んでいない記録) | tag-drafts.md |
| 下書きを規則で振り分けた記録 | tag-apply-review.md |
| リクエスト消費の台帳(見積もりと実測の突き合わせ) | request-budget.md |
| 資格情報と課金の境界(動かす前に読むもの) | credentials-and-billing.md |
| 全呼び出しの記録(トークン数・応答時間・打ち切り) | data/usage.jsonl |
| プロンプトの組み立て | server/utils/prompts.ts |
| v1とv2の応答(生データ) | data/runs/ |
| 辞書の指紋(記録した時点との照合) | glossary-fingerprint.md |
| 到達の実測(最初の10問) | combo-report.md |
| 到達の実測(別の10問) | combo-report-append-10.md |
| 「正解を含まない」7件の一覧と原因の見立て | glossary-gaps-append-10.md |
| 別の10問の出題データ | standard-append-10/dataset.json |
| 型と設計判断のコメント | shared/types.ts |
| v1/v2の比較、到達、出力の監査 | docs/ |
打ち切られた応答の生テキストも、要約せずそのまま入れてあります。
おわりに
3,000リクエストの無償枠のうち、使ったのは588でした。データ生成も4モデルの対照実験も普通のプレイも全部含めて、です。
使い切りチャレンジなのに、2,412も余りました。もっと消費してると思っていました。

「基盤モデル無償プラン」の通り「0円」でした!
回数は使い切れませんでしたが、基盤はだいぶ触りました。まとめておきます。
| 調べたこと | 分かったこと |
|---|---|
| チャットモデル9種の可否 | コンテキスト長4,096で落ちるもの、CPU実行で38〜45秒かかるもの、提供終了、要申請。残った4種で系統とサイズの幅を確保 |
| 4モデルの事実の精度と速度 | 誤答0/9のモデルが最遅で504も出す。最速のモデルは4/9外す。逆相関だった |
| 用途別の割り振り | 正規化は速い gemma、採点は釣り合いのいい gpt-oss-120b、事実を作るなら遅くても精度の高いほう |
| 無償枠の数え方 | 400は消費しない。504と打ち切りは消費する。だからリトライしない |
| 構造化出力 |
strict: true でも4文字の文字列 "null" は通る。スキーマは形しか守らない |
| 打ち切り | 200で返るのにJSONが閉じない。本文556字のあと空白40,952字で280秒 |
| 再現性 | 同一入力を2回投げた12組のうち、完走判定が4組、見落とし件数が5組で食い違う |
| 課金経路 | RAGは無償プランでも課金対象。使わずに済むなら使わない |
無償枠が本数で数えられると分かったので、1プレイのコストを固定したくなった。そのためにはAIに小さな判断を何個も聞けないので、コアロジックを全部コードへ寄せた。残ったのは入口と出口だけです。
それで応答の質は、落ちるどころか上がりました。AIから仕事を取り上げたぶん、渡すデータを作り込んだからです。無償枠が無限なら、全部AIに投げて、冒頭の当たり障りのない総評のままで記事は終わっていたはずです。有限だと分かっていたから、AIに投げない判断ができました。そのぶん無償枠が余りました。
さくらのAI Engineで助かったのは3つです。本数で数える無償枠、OpenAI互換、そして超過しても自動で課金へ移らないこと。最後のが決定的でした。504を踏むか分からないまま300秒待つ、max_tokens を上げて投げ直す、同じ入力を2回投げて揺れを見る。どれも「失敗しても財布は痛まない」と分かっていないとやりません。減るのは無償枠だけで、翌月に戻ってきます。
つまずいた点も書いておきます。打ち切りや "null" の4文字にはズッコケました。ただし私1人の環境での観測です。基盤の性質としては読まないでください。
さて、残った2,412の使い道はすでに決まっています。
蕎麦職人と化し、黙々と問題を足すことです。
作問のときに正規化が1回、その問題を自分で解くときに回答の正規化が1回、そこから4モデルに採点させて4回。1問あたり6リクエストなので、2,412あれば400問ぶんあります。しかも無償枠は毎月3,000にリセットされるので、翌月には500問ぶんに戻ります(汗)
私が夏季休暇中に打てたわんこそばは20問(杯)でした。400問ぶんの無償枠に対して、20問。 使い切れないのは当たり前でした。蕎麦粉はいくらでもあるのに、1問を教材にするには正解タグを人手で書くしかない。先に尽きるのは蕎麦粉ではなく私の腕です。是非みなさんも、使い切れない粉の山に震えてみてください。私が打った蕎麦はCC BY 4.0で置いてあるので、良かったら召しませ。
自由研究として始めたのに、休暇のほうが先に終わりました。無償枠は毎月戻ってくるのに、蕎麦は自分で打つしかありません。ありがとうおかわり自由、つか、いつまで無料なんですか!?
どなたか蓋をしてください。まだまだ食べたいですけど。
お断り
記事内容は個人の見解であり、所属組織の立場や戦略・意見を代表するものではありません。
あくまでエンジニアとしての経験や考えを発信していますので、ご了承ください。
GeoGuessr は GeoGuessr AB の商標で、本プロジェクトは非公式です。
出題の20問はすべて自分で選んだ地点で、GeoGuessrの問題を持ち出したものではありません。GeoGuessr本体は無料でも1日1回、5つのスポットを遊べるので、興味のある方は是非チャレンジしてみてください。
-
実測から概算してみます。
data/usage.jsonlの120件の平均です。正規化(v2・75件)が入力5,256トークン・出力199トークン。採点は版で差が出て、v1(16件)が入力1,505トークン・出力8,106トークン、v2(29件)が入力6,122トークン・出力7,808トークンでした。v1は正解タグも用語辞書も渡していないので、入力が4分の1で済んでいます。完成形はv2なので、そちらに単価を当てます。1万トークンあたりgemmaが入力0.24円・出力0.96円、gpt-oss-120bが0.15円・0.75円、Kimi-K2.6が0.6円・3円。正規化をgemmaで採点をgpt-oss-120bにした場合が1プレイ0.82円、採点をKimi-K2.6にすると2.86円です。無償枠の3,000リクエスト相当(1,500プレイ)を全部従量課金で払っても、前者なら1,200円ほど、後者でも4,300円ほどです。「辞書を丸ごと入れる」が入力トークンに毎回乗るので、無償枠の内側と外側で設計の良し悪しが逆さになります。あくまで私の使い方での概算です。単価は税込・記事執筆時点のものです。 ↩