
AIエージェントにローカルAIを起動させてたらPCが落ちたので、AIに「AIを管理するソフト」を作らせた【HANARE】
作ったもの
HANARE(はなれ)は、1台のPCを「人間の住む母屋」と「AIの住む離れ」に分けて使うための、Ubuntu向けセットアップキット+小さなランタイムです。
- ローカルLLM(llama.cpp)と画像生成(ComfyUI)の状態を60秒ごとに記録して見える化
- GNOMEトップバー/専用パネル/Webダッシュボードから、起動・停止・モデル切り替え
- 起動・停止は原則 systemd のユーザーユニット経由で、勝手にプロセスを殺さない(停止操作のときだけ、管理外プロセスを安全確認つきで止める例外があります。後述)
リポジトリはこちら(MITライセンス):
https://github.com/kabedayo/hanare-os
これはブータブルなOSイメージではありません。v0.1は「Ubuntu+GNOMEの上で、AI側の常駐環境を管理する仕組み」です。その代わり、作者の実機で毎日使っています。

きっかけ:裏で何が動いているか分からない
発端は、AIエージェント(Muse=筆者が日常使いしているAIアシスタント)に自分のPCでローカルLLMや画像生成を起動させる運用を始めたことでした。
便利な反面、困ったことが起きます。エージェントが起動したプロセスは、人間のターミナルには出てきません。 何が・いつ・どれだけGPUメモリを使って動いているのか、人間側からは見えない。そのまま運用が積み重なり、ある日PCが落ちる事故が起きました。直接の引き金がVRAMの枯渇だったのかを後から切り分ける手段(ログ)すら当時は無く、正確なところは分かりませんでした。
落ちた後も問題は残ります。
- ログアウトしたのにLLMが止まっておらず、VRAMを約25GB掴んだままだった
- 「止めたはず」の対象と、実際に動いているものが一致しない
要するに、AIに作業を任せる時代になったのに、「AI側で何が動いているか」を人間が把握・管理する道具がない。なら作ろう、というのがHANAREです。名前は、母屋と同じ敷地に建つ「離れ」から取りました。実機は1台のPCにGPUを2枚挿した構成で、普段のデスクトップ表示はGTX 1060、AI側の計算はV100 32GBが担当します。この「1台の中の2つの世界」を、そのまま設計に落としました。
できること(v0.1)
See(見える化)
60秒ごとにAIサービスの状態を採取し、running / stopped / degraded / stuck-suspect の状態と、プロセスごとのVRAM/RAM使用量をJSONLのイベントログに追記し続けます。まず「見える」こと。自動で何かを殺すことはしません。
例えば stuck-suspect(固まっている疑い)は、「プロセスは存在するのにポートが応答しない」「起動から600秒以上経っている」「起動以来の平均CPU使用率が2%未満」の3条件が揃ったときのラベルです。これも表示だけで、プロセスには触りません。

Surfaces(3つの画面)
同じ状態を3つの場所から見られます。
- GNOMEトップバー:中央に「HANARE ●」のピル。ドットの色が現在の最悪状態を表します。メニューから起動・停止・再起動とモデル選択ができます
- 専用パネル(Python+GTK3):日常の操作用ウィンドウ
-
Webダッシュボード:
127.0.0.1:8790で常駐。外には出しません

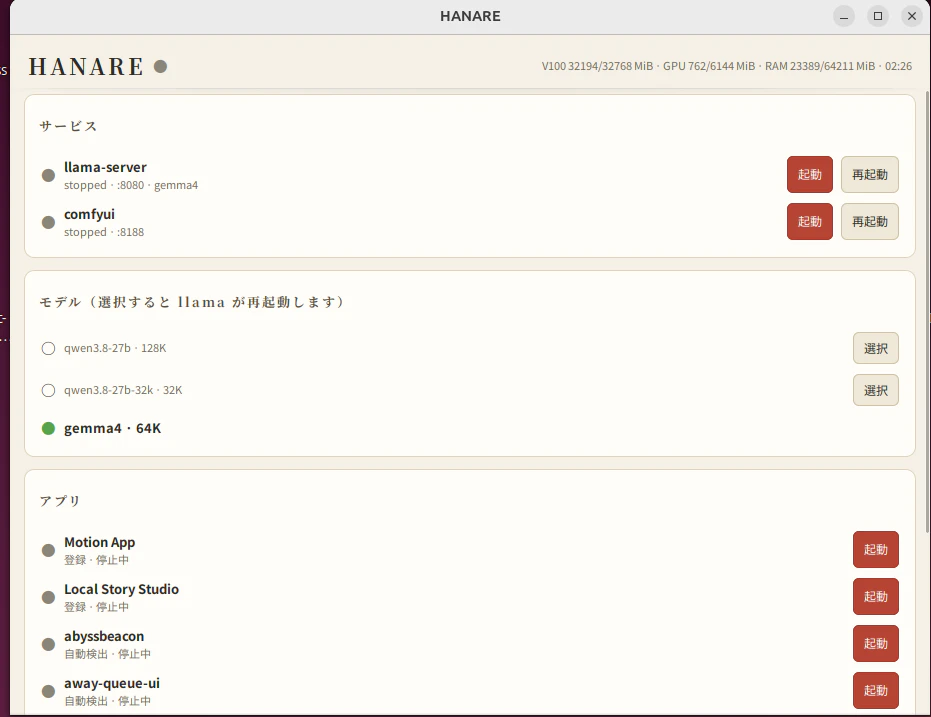
全体のつながりはこうなっています。
Manage(管理)
LLMコアと画像生成サービスを systemd ユーザーユニットとして起動・停止・再起動できます。使うLLMは models.tsv という登録簿の1行で決まり、モデルを足すのも1行追加するだけ。全UIがそれを自動で拾います。登録簿はただのTSVです(同梱サンプルの抜粋)。
name	gguf_path	mmproj_path	ctx	profile	note	draft_path
my-llm	/path/to/models/my-llm.gguf	-	32768	generic	Example entry.	-
自分のローカルAIアプリ(画像生成スタジオ等)も定義ファイルを置くだけでパネル/ダッシュボードから起動できるようになります。
で、PCは落ちなくなったの?
正直に言うと、自動で防ぐ仕組みはまだありません。変わったのは「見えるようになった」ことで、VRAMが危ない状態に自分で気づいて、先回りして止められるようになりました。自動で守る仕組みは、今後のレイヤーの仕事です。
| レイヤー | 内容 | 状態 |
|---|---|---|
| L1 | 見える化(採取・ログ・3つの画面) | ✅ 実装済み |
| L2 | 管理(ユニット操作・モデル登録簿・アプリ起動) | ✅ 実装済み |
| L3 | GPU固定・VRAMポリシーのコード化 | 🚧 一部のみ |
| L4 | ブータブルなOSイメージ | 🗺 構想 |
設計で決めたこと
操作対象は systemd 管理下だけ(だった)
「見える化」と「操作」は分けました。外から起動されたプロセスは検出はするが、停止はしない。操作ミスで関係ないものを殺す方が怖い、という判断です。
……この判断は、後述の事故で見直すことになります。
個人設定はリポジトリに入れない
モデルファイルのパス、自分のアプリ定義、サービス状態といった機械固有の情報は、全部 git-ignore されたローカルファイル側に寄せました。リポジトリにcloneした人の環境に、作者のモデルやホーム構成が混ざることはありません。同梱されるのはサンプルだけです。
安全側の制約は固定
ダッシュボードは 127.0.0.1 のみ。操作できるサービスやモデルは固定の許可リスト内だけ。便利さより先に「暴走しない形」を固定しました。
作り方:AIに設計させ、別のAIに実装させる
このプロジェクト自体、AIエージェントとの分業で作りました。
- Muse(クラウド側):設計と、タスクごとの指示書を書く
- ローカルLLM(Qwen 27B級):指示書を受けて実装する
指示書はこんな形です(実物から抜粋)。対象ファイルと、ユーザーの決定事項と、優先順位までを先に固定して渡します。
# Task: app auto-discovery for the dashboard (no hand-written files)
# User decision 2026-11-03: simplify app registration to auto-import
# only (no registration helper). Extends Task 010.
# Files: modify dashboard/dashboard.py, modify apps.d/README.md,
#        create tests/check-011.sh
#
# You are the implementer for the HANARE project (working dir: this
# repository only).

## Discovery sources (priority order; first source wins on duplicates)
1. Manual: apps.d/*.app as in Task 010 (source tag: 登録).
2. Drop folder (env HANARE_APPS_DROP_DIR, default ~/hanare-apps; ...):
   entry point detection order — run.sh, start.sh, the first start-*.sh,
   app.py, main.py. ...
うまくいかなかった例も書いておきます。トップバーの拡張では、実装が静的テストを全部通ったのに、実際のGNOMEシェルでは表示されませんでした。原因はGNOMEのUIライブラリ(St)の細かい仕様で、監督側(Muse)の差分レビューでも見逃しました。モデルの賢さの問題ではなく、「実機で確認する工程をループに入れていなかった」ことが原因で、以後のタスクでは実シェルでの確認を手順に組み込みました。
運用の形も書いておきます。実装が返ってきたら、監督側(Muse)が差分をレビューし、各タスク用に用意したチェックスクリプト(tests/check-*.sh)を実行して確認します。落ちたら、本体タスクとは別に「修正タスク」(ファイル名で言うと 011-fix1 のようなもの)として切り出して再投入する。トップバーのような実シェルでしか分からない部分は、人間(筆者)のログイン確認が工程に入ります。逆に、設計判断——例えば「自動では殺さない」というポリシーや、後述する仕様変更の決断——は人間と監督側の仕事で、実装側には渡しません。
人間の自分の仕事は、設計判断と「できたものが意図通りか」の確認に寄っていきました。
公開してから起きたこと
CIを入れたら、本物のバグが見つかった
公開後、GitHub Actions(Ubuntu 22.04/24.04)で既存のテスト一式を回すCIを入れました。初回、自分のPCでは全部通っていたテストの1つが落ちました。
原因は本体側の仕様でした。状態採取スクリプトが「nvidia-smi が無い=採取失敗」として異常終了する作りで、GPUの無い環境では「GPUが0個」という正しい結果まで失敗扱いになっていたのです。修正後は「nvidia-smi が存在しない環境は GPUなし として正常、存在するのに失敗した時だけ異常」になりました。
自分のPCで動くことと、他人のPCで動くことは別物でした。CIが無ければ表に出なかったバグです。

「止められないLLM」事件と、仕様変更
もう1件、設計判断そのものを変えた事故がありました。
ある夜、HANAREの外で直接起動した llama-server が残っていて、ユニットは停止済みなのにLLMだけが生き続け、ポートとVRAMを掴んだままになりました。ダッシュボードで止めようとしても、systemdの停止は「そのユニットが起動したプロセス」にしか効きません。結局プロセスを直接killして止めました。
「外部プロセスは停止しない」という当初の設計は、安全性としては正しい。でも利用者(自分)から見れば、これはただの「止められないバグ」でした。そこで仕様を変更しました。
- 停止操作のときに限り、専用ヘルパー
scripts/hanare-service.sh stop-externalが外部プロセスを回収する - 対象は許可リストのサービスだけ。サービスのポートで待ち受けているプロセスで、所有者が自分で、コマンドラインがそのサービスのものと一致する場合だけにSIGTERM(強制killはしない)
- ユニットが動いていないのにサービスが動いている状態は、UIに「管理外」バッジで表示する
実装はダッシュボード/パネル/トップバーの3UIすべての停止処理に組み込み、専用のテストを追加して、CIが緑になることを確認しました。「検出はするが止めない」から「止めるときだけ、安全確認つきで止める」へ。これが公開後に学んだ一番大きなことです。
制限(正直なところ)
- Ubuntu+GNOME専用です。他のディストリビューションやデスクトップ環境は未検証です
- AI側にはNVIDIA GPUと、llama-server/ComfyUIの動作環境が別途必要です(HANAREはそれらを管理する側で、モデル本体は配布しません)
- L3(GPU固定やVRAMポリシーのコード化)は一部のみ、L4(ブータブルなOSイメージ)はロードマップ上の構想です
試してくれる人を募集しています
同じように「エージェントにローカルAIを回させていて、裏側が見えなくて困っている」人がいたら、ぜひ試してみてください。導入はこのくらいです。
git clone https://github.com/kabedayo/hanare-os ~/hanare-os
cd ~/hanare-os
cp models/models.tsv.example models/models.tsv        # 自分のGGUFを登録
cp scripts/llama-env.example.sh runtime/llama-env.sh  # llama-serverの場所を指定
for s in setup/1*.sh; do bash "$s"; done              # セットアップ一式
bash scripts/hanare-model.sh use <モデル名>
systemctl --user start hanare-llama                   # ダッシュボードは 127.0.0.1:8790
自分の1台で毎日使い倒している段階のソフトですが、同じ悩みを持つ人の環境でも動いたら嬉しいです。