
OpenAI Agents SDK × Streamlit — マルチモーダル(画像+テキスト)入門
チャット画面で 画像を添付して「これは何?」と聞く 体験を、OpenAI Agents SDK と Streamlit で再現してみました。
この記事ではマルチモーダルの考え方と、画像をモデルが受け取れる形に変換してセッションに載せ、質問とまとめて回答する流れだけを扱います。
マルチモーダルとは
モダリティ(modality) は「情報の種類」です。テキスト、画像、音声、動画などがそれぞれ 1 つのモダリティです。
マルチモーダル は、そのうち 複数の種類をまとめて扱う ことを指します。
| 入力 | モダリティ |
|---|---|
| 「この画像に写っているものは?」 | テキスト |
| 添付した PNG / JPEG | 画像 |
どちらか一方だけでは足りません。画像だけ渡しても質問意図が分からず、テキストだけ渡しても画像の中身は分かりません。両方が同じ会話コンテキストに入る のがマルチモーダルのポイントです。
完成イメージ
| ステップ | 内容 |
|---|---|
| エンコード | 画像ファイル → base64 → data URI |
| セッション保存 |
input_image メッセージとして SQLiteSession に追加 |
| 質問 | テキストを Runner.run_streamed に渡す |
| 回答 | セッション内の画像をモデルが見て答える |
| UI 再描画 | 履歴から image_url を読み出して st.image
|
なぜエンコードが必要か
アップロードされた画像は、手元では バイナリ(バイト列) です。一方、Agents SDK / API に渡す会話メッセージは JSON に載せやすいテキスト中心の構造 です。
そこでよく使うのが base64 です。
画像のピクセル(バイナリ)
        ↓ base64 エンコード(送信用の包装)
data:image/png;base64,iVBORw0KGgo...
        ↓ API が受け取り、画像として復元
モデルが「絵」として認識
重要なポイント:
- モデルが base64 の 文字そのもの を読んで画像を判断しているわけではない
- base64 は API に載せるための包装
- API 側で画像に戻したあと、モデルがビジョン機能で内容を理解する
実装 — 画像を API 向け形式にしてセッションへ
Streamlit の st.chat_input で画像を受け取り、エンコードして session.add_items します。
import base64
import asyncio

prompt = st.chat_input(
    "メッセージを入力してください",
    accept_file=True,
    file_type=["jpg", "jpeg", "png"],
)

if prompt:
    for file in prompt.files:
        if file.type.startswith("image/"):
            file_bytes = file.getvalue()
            base64_bytes = base64.b64encode(file_bytes)
            base64_string = base64_bytes.decode("utf-8")
            data_uri = f"data:{file.type};base64,{base64_string}"

            asyncio.run(
                session.add_items([
                    {
                        "role": "user",
                        "content": [{
                            "type": "input_image",
                            "detail": "auto",
                            "image_url": data_uri,
                        }],
                    }
                ])
            )
| 行の意味 | 役割 |
|---|---|
file.getvalue() |
アップロード画像をバイト列で取得 |
base64.b64encode |
バイト → base64 |
.decode("utf-8") |
base64 を文字列化 |
data:{type};base64,... |
data URI 形式 |
type: "input_image" |
マルチモーダル用のメッセージ種別 |
session.add_items |
会話履歴(メモリ)に保存 |
参考: Sessions — OpenAI Agents SDK
なぜ「質問だけ」渡しても画像に答えられるのか
エージェント実行はだいたい次の形です。
stream = Runner.run_streamed(agent, message, session=session)
第 2 引数 message は今回の テキスト質問 です。それでも画像に答えられるのは、session= に すでに画像メッセージが入っている からです。
モデルから見える流れ(イメージ):
| 順番 | 内容 |
|---|---|
| 過去の user |
input_image(画像) |
| 今回の user | 「この画像は何?」などのテキスト |
画像と質問が 同じセッションコンテキスト に並ぶので、ビジョン対応モデルが両方を見て回答を生成します。
これがマルチモーダルの実装上の核です。
UI — 履歴から画像を再表示する
Streamlit は操作のたびにスクリプトを rerun します。画面に残る情報は、最終的にはセッションなど 永続化された履歴を描画した結果 です。
画像メッセージの content は文字列ではなく リスト です。
{
  "role": "user",
  "content": [
    {
      "type": "input_image",
      "detail": "auto",
      "image_url": "data:image/png;base64,..."
    }
  ]
}
履歴描画では、文字列とリスト(画像)を分けて扱います。
def render_history(messages: list[dict]) -> None:
    for message in messages:
        if "role" not in message:
            continue

        with st.chat_message(message["role"]):
            if message["role"] == "user":
                content = message["content"]
                if isinstance(content, str):
                    st.write(content)
                elif isinstance(content, list):
                    for part in content:
                        if "image_url" in part:
                            st.image(part["image_url"])
                        elif "text" in part:
                            st.write(part["text"])
| content の形 | 表示 |
|---|---|
str |
st.write でテキスト |
list + image_url
|
st.image で画像 |
list + text
|
st.write でテキスト |
st.write(part["image_url"]) だと data URI の巨大な文字列がそのまま出ることがあるので、画像表示には st.image が向いています。
実行してみる
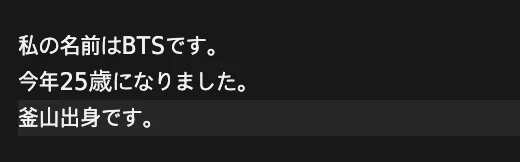
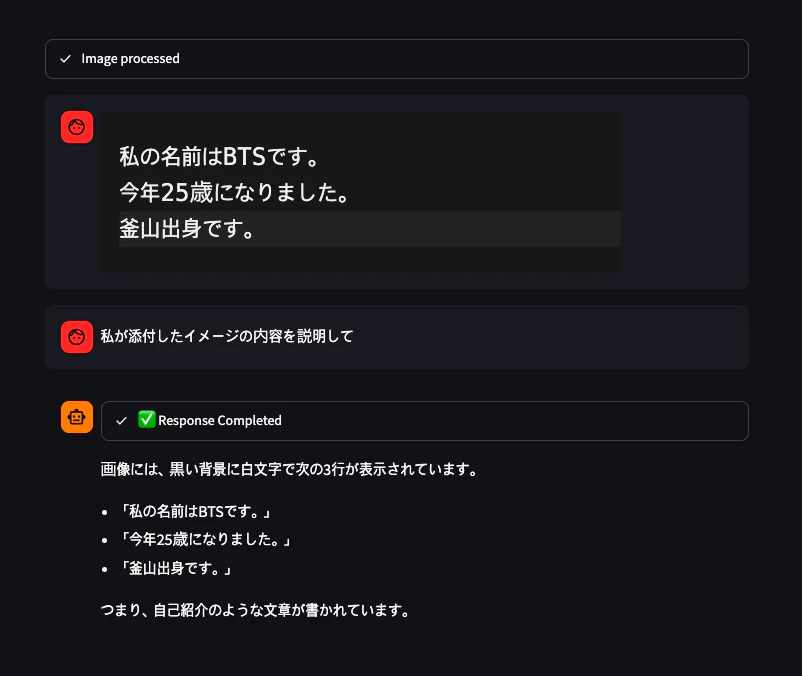
今回チャットに添付するイメージです。
チャットで上のイメージ添付後、内容について質問してみた。
まとめ
- マルチモーダル = テキストと画像など、複数の情報形態をまとめて扱うこと
-
アプリの役割 = バイト列を base64 / data URI /
input_imageに整え、セッションに載せる - base64 = 画像を JSON・メッセージに載せるための包装(文字そのものをモデルが読むわけではない)
- session = 画像と後続の質問を同じ文脈につなぐ仕組み
画像+テキストのマルチモーダルを一度通すと、「チャットアプリはテキストだけ送っている」のではなく、モデルが処理できる形に入力を組み立てている ことがはっきり見えてきます。