
AIで半導体回路設計・第二弾(検証編)
夏休みの宿題「AIで回路設計・第二弾」として、Open-Source TR-1um を使った OpenSUSI-MPW サービスでも実装できそうなロジック回路として、非同期 I2C 回路を Claude に実装させてみました。
仕様書からVerilogシミュレーションまで進めたが、配置配線でスタセルの改良が必要で敗退した白旗編、 TR-1um のスタセルを作り直すことで P&R を収束させたリベンジ編、チップレベルの配線/DRC/LVS をクリーンにしたコンプリート編に続くシリーズ第4弾です。
今回は、IRSIM導入>タイミング検証>バグフィックス>チップレベルでの最終タイミング検証をして、完成させてみます。何処までできますか。。。
See https://github.com/jun1okamura/TR-1um_Async_I2C
すべての試行錯誤は、GitHub に記録されています。ご参考まで。
IRSIM の導入
TR-1um の STDCELLには遅延情報が無いので STA での Verilog 検証が当てにならないので、IRSIMを使ったタイミング検証で代用することにします。
IRSIMは、MOSトランジスタ回路を対象にしたイベント駆動型のスイッチレベル・シミュレータです。
主な特徴
- NMOS/PMOSトランジスタを論理スイッチとして扱う
- ゲートレベルより回路構造に近く、SPICEより高速
- 単純なスイッチモデルと、抵抗・容量・RC遅延を考慮する線形モデルを選択可能
- Magicなどで抽出した.simネットリストを直接読み込める
- プロセスごとの抵抗・容量などを.prmファイルで指定
- 対話形式で入力設定、クロック実行、ノード値確認、履歴保存などが可能
- 故障シミュレーション、消費電力推定、ユーザー定義サブ回路などの機能も含む
公式マニュアルでは、各トランジスタを電圧制御スイッチとして扱うモデルと、抵抗・容量から遅延を計算するモデルが説明されています。IRSIM公式マニュアル
一言でいえば、CMOS回路の論理動作と概略的なタイミングを、トランジスタレベルで比較的高速に確認する古典的なEDAツールです。
IRSIM は、1990年代当時、MITに留学した研究所の同僚が持ち帰って社内ツールとしての活用を提案し、実用化プロジェクトを進めたことが思い出されます。前後して、EPIC 等のその後 「高速SPICE」と呼ばれるEDAツールが勃興し、日の目を見ることなく終了。まさに 1um 世代ごろから注目されたEDAツールの一種です。
IRSIM のインストール
IRSIM を MAC(M5) にインストールします。公式Githubレポからソースをダウンロードして build しましたが、コードの多くが古いC言語様式のままのため素直にコンパイル出来ず、チャッピーに助けてもらってコードを修正しています。 詳しくはこちらを参照ください。
PRMファイル
PRMファイルは、トランジスタのL/Wを抵抗にマッピングしたパラメーターファイルです。local にインストールしている ngspice を使って、Claude君にPRMファイルを作る SPICE ファイルを作成してもらいます。
script/gen_prm_characterize.py
プルアップ
SDA線は外部で抵抗プルアップされますが、これが IRSIM では上手く扱えないので、弱いPMOSをSDAをドライブしているNMOSのゲートでドライブするアクテイブプルアップに変更します。Claude 君に指示してネットを修正してもらいます。
BUFTH
ヒステリシス・バッファーも上手く扱えないことがわかり、IRSIM検証では、BUF_X1に変更するように Claude君に指示します。
IRSIM 実行
チップ全体(GIOも含む)をシミュレーションしたところ、以下のバグを発見しました。
- SDA_oe 信号の極性が逆(Claude君にINV_X1を挿入して再検証してOKを確認)
- アドレスデコード回路とビットカウンターのリセットの競争条件が発覚
Claude君の提案で、競争条件の根本対策として、3bitカウンタbit_cnt+新規1bitlast_bit_pending(bit_cnt==6を1エッジ前倒し登録)方式に改良して、比較器を経由しない安定した取り込み判定を実現しつつDFFRBを33個まで削減。
再合成
RTL根本修正(競争条件の根本対策)+ SDA_oe極性修正 を Verilogで修正して再合成>検証を繰り返します。この機会に、STDCELLとしてXOR2/XNOR2/AND3_X1/AND4_X1を追加。また電源メッシュを強化(TAP行を3から4本に増やす)。
合成結果
-
合成後に、ヒステリシスバッファーと高FOノードに各行でバッファーを挿入
-
セル数: 158個(内訳:
DFFRB×33、MUX2×24、NAND2×22、NOR2×39、NOR3×8、INV_X1×6、OR2×5、NAND3×3、OR4×2、NOR4×2、BUFTH×2、AND2_X1×9、OR3×1、DEL1×1、AND4_X1×1) -
総セル数はv7の154個から158個に増加、Verilog で動作検証
% iverilog -o sim i2c_slave_async.v stdcell_behavioral_stubs.v i2c_slave_async_tb.v && vvp sim
VCD info: dumpfile i2c_slave_async_tb.vcd opened for output.
[t=240000] OK:                                        busy asserted after START
[t=960000] OK:                             slave ACKed matching address (write)
[t=960000] OK:                                              addr_match asserted
[t=960000] OK:                                               rw indicates WRITE
[t=1680000] OK:                                            slave ACKed data byte
[t=1700000] OK:                                                  rx_data == 0xA5
[t=1760000] OK:                                          busy cleared after STOP
[t=2580000] OK:                              slave ACKed matching address (read)
[t=2580000] OK:                                                rw indicates READ
[t=3220000] OK:                                                read byte == 0x3C
[t=3362000] OK:                                    busy cleared after final STOP
[t=4142000] OK:                         unmatched address -> NACK (no slave ack)
[t=4142000] OK:                      addr_match not asserted for foreign address
[t=4202000] OK:                           busy cleared after STOP following NACK

---- RESULT ----
All checks PASSED
i2c_slave_async_tb.v:229: $finish called at 4302000 (1ps)
配置配線結果
再合成の過程で、スクリプトのバグが見つかり、対処した。その為か?前回の合成に比べてBBOXサイズを縮小することができた。
-
ネットリスト最適化(dedup_gates.py)ABC の abc -liberty が共通論理をDFFごとに個別複製していたため、v7と見た目のセル数は近いのに配線混雑度が全く違っていた。スクリプトで CSE(共通部分式除去)パスで31個の冗長ゲートを検出・除去(158→127インスタンス)。Yosysの形式等価性検証(LEC)で数学的に正しい変換であることを確認。
-
セル数: 137個(内訳:
DFFRB×33、MUX2×24、NAND2×22、NOR2×15、NOR3×8、INV_X1×6、OR2×5、NAND3×3、OR4×2、NOR4×2、BUFTH×2、AND2_X1×2、OR3×1、DEL1×1、AND4_X1×1、XOR2×1、XNOR2×1) -
トランジスタ数:1,800個(PMOS 900・NMOS 900)内部ノード数:728

配置配線を再実行(N_ROWS=4・N_GAPS=3、行幅1620.0umちょうど)。GIO⇔コア結線をroute_gio_core_v9.pyで再実装し、コア高さもv7より大幅に圧縮(988.2→936.1µm、-52.1µm)できた。
前回は、ここで schematic を作ったが、今回は NET から LVS 用の spice を直接 Claude君に作成してもらい、DRC/LVS クリーンを確認。
% klayout v9_step_9_power_pins_added.gds
Loaded TR-1um PCells.
Setting running mode => deep
Starting TR-1um LVS Comparison in strict port mode
flag_missing_ports enabled: missing/mislabeled top-level ports are treated as errors
==========================================
INFO : Congratulations! Netlists match.
==========================================
トップレベル
前回は、トップレベルを手で作ったが、これも Claude君に指示して作ってもらう。まず配置の段階で一旦確認。

接続JSON
前回は、ここでトップブロックの schematic を作ったが、前回の schematic を参考に接続関係のJSONファイルを作ってもらい、スクリプトで管理しやすくする。

む〜。人間でもこちらの方が管理しやすい。
TOPピン
生成した Layout にTOPピンをつけます。GIOのパッドの中心値を測定させて、反時計まわりにP1〜P7、VSS、P9〜P15、VDDのPINとTEXTを配置。同様に生成した schematic にもTOPピンを追加するようClaude に指示を出します。JSONファイルにも記録します。
トップ配線
JSONファイルに従って配線をしてもらいます。前回のスクリプトがあるので、あっという間です。

DRC/LVS クリーンを確認。
% klayout tr_1um_i2c_slave_async.gds
Loaded TR-1um PCells.
Setting running mode => deep
Starting TR-1um LVS Comparison in strict port mode
flag_missing_ports enabled: missing/mislabeled top-level ports are treated as errors
==========================================
INFO : Congratulations! Netlists match.
==========================================
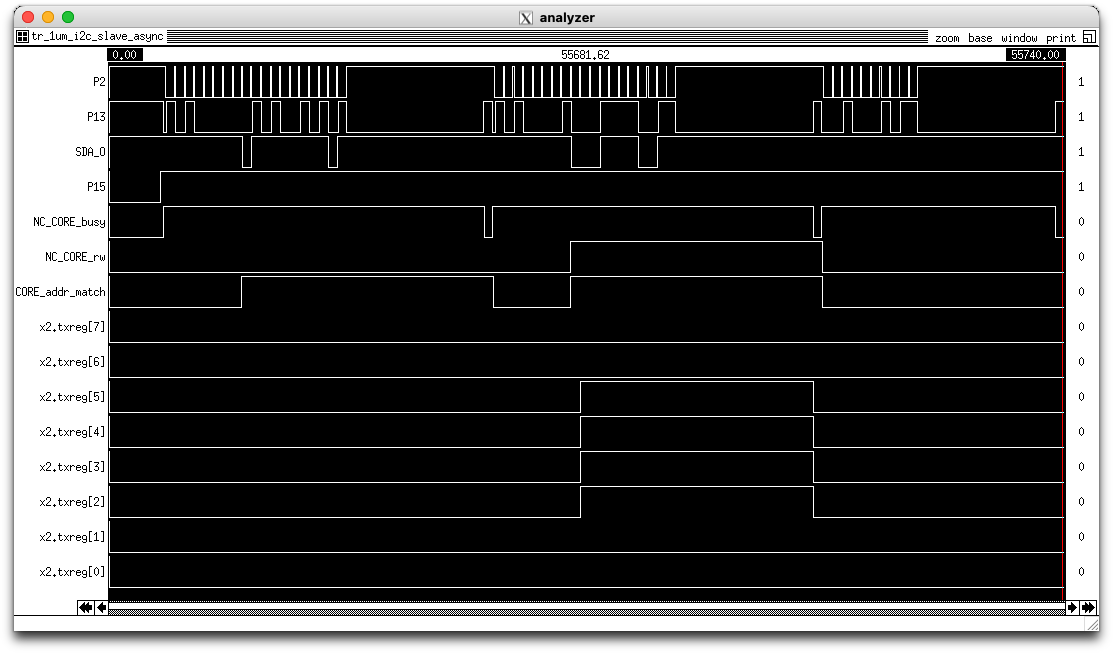
IRSIM 再検証
IRSIMでの再検証。LVSで使った .spice からIRSIM用のファイルを準備するように Claude君に指示をする。前回と同じように BUFTH を BUF_X1 に置換する。
Verilogのテストベンチと同じものをIRSIM向けに作成するように Claude に指示をする。
irsim % ./run_tb.sh
irsim TR-1um.prm tr_1um_i2c_slave_async.sim  (running irsim_tb.cmd, log: irsim_tb_run.log)
---- irsim run complete, checking irsim_tb_run.log against irsim_tb_expected.json ----
[t=3300.000] OK:                                        busy asserted after START
[t=8300.000] OK:                             slave ACKed matching address (write)
[t=8320.000] OK:                                              addr_match asserted
[t=8320.000] OK:                                               rw indicates WRITE
[t=13320.000] OK:                                            slave ACKed data byte
[t=13340.000] OK:                                                  rx_data == 0xA5
[t=22340.000] OK:                                          busy cleared after STOP
[t=27500.000] OK:                              slave ACKed matching address (read)
[t=27520.000] OK:                                                rw indicates READ
[t=31980.000] OK:                                                read byte == 0x3C  (got 0x3C)
[t=41560.000] OK:                                    busy cleared after final STOP
[t=46680.000] OK:                         unmatched address -> NACK (no slave ack)
[t=46700.000] OK:                      addr_match not asserted for foreign address
[t=55700.000] OK:                           busy cleared after STOP following NACK

---- RESULT ----
All 14 checks PASSED

まとめ
TR-1um の STDCELL にタイミング情報がないため、IRSIMによるトランジスタレベルでの動作検証環境を立ち上げて、チップレベルでのタイミング検証を行った。検証により、前回のネットに2つのバグを発見して、ネットに戻って修正し、再配置配線+タイミング検証までを、ほぼ一日で完了。その間に配置配線スクリプトのバグ等をフィックスして完成度も上げることが出来た。
I2Cの非同期スレーブは25年以上前に一度 Schematic ベースで手設計し、手置き Layout で完成させた経験があるが、Claude君との共同作業では、〜数十倍のスピードが上がる感覚。また、作業スクリプトが残るのも素晴らしい。今回GitHubと連携しながらドキュメントも残したが、これも Claude を使うことによる素晴らしい副次的な効果である。
このようなことが可能な背景として、オープンソースの Klayout の Python API が Claude のサンドボックス内で大活躍できること、Verilog や Xscheme の *.sch/sym がすべてテキストベースであり、Claude君にとって容易に編集できる点が本質的です。やはりオープンソース環境はAIの要諦です。