
deepeval+langfuseによるLLM評価環境構築
この記事について
ローカルLLMが増えて、LLMの評価というところに価値がありそうなのでローカルLLM実行から評価、ダッシュボード送信までやってみた話です。
何回も評価して評価値を平均化させたい場合に何度もクラウドモデル使うのはお金に優しくないので、評価したい時はローカルになるのかなぁと
Qwen4楽しみです
deepevalについて
https://deepeval.com/
AIエージェント系やRAGの評価全般があるっぽい
RAGASがゴールデンスタンダードだと思っていたけど、RAG方面以外にたくさんあるのかな。
https://deepeval.com/guides/guides-ai-agent-evaluation
斜め読みだけど、エージェントには
- reasoning layer: 計画とか
- action layer: tool call系
があって、それぞれを評価の対象としている的な感じかな
あとはタスクを完了できたかの全体観点。
この辺り定期的にトレースを送ることができたら、評価が積み上がっていくかな
それするにはOpenTelemetryとか、Litellmになるのかな...?
どうやらdeepeval側でもUIがあるみたいだが、セルフホストじゃないみたいなので、ダッシュボードはlangfuseに任せる
langfuseについて
(https://langfuse.com/)[https://langfuse.com/]
LLM評価用のダッシュボード
トレース結果とかが見やすい
構築
langfuseに記載されている手順がベース
https://langfuse.com/self-hosting/deployment/docker-compose
git clone https://github.com/langfuse/langfuse.git
cd langfuse
docker-compose.override.ymlとcomposeに少し編集を入れる
私の環境で使っているポートが被ってるんで...
docker-compose.ymlの編集
  langfuse-web:
    image: docker.langfuse.com/langfuse/langfuse:4
    restart: always
    depends_on: *langfuse-depends-on
    ports:
+      # 3000は使っているため変更
+      # - 3000:3000
+      - 3001:3000

...

  clickhouse:
    image: docker.io/clickhouse/clickhouse-server:25.12
    restart: always
    user: "101:101"
    environment:
      CLICKHOUSE_DB: default
      CLICKHOUSE_USER: ${CLICKHOUSE_USER:-clickhouse}
      CLICKHOUSE_PASSWORD: ${CLICKHOUSE_PASSWORD:-clickhouse} # CHANGEME
    volumes:
      - langfuse_clickhouse_data:/var/lib/clickhouse
      - langfuse_clickhouse_logs:/var/log/clickhouse-server
    ports:
      - 127.0.0.1:8123:8123
+      # 9000は使用しているため変更
+      # - 127.0.0.1:9000:9000
+      - 127.0.0.1:9015:9000
docker-compose.override.yml
services:
  langfuse-worker:
    environment:
      # ポート変更したのでその合わせ
      NEXTAUTH_URL: "http://localhost:3001"

  langfuse-web:
    environment:
      # ポート変更したのでその合わせ
      NEXTAUTH_URL: "http://localhost:3001"


  deepeval:
    build:
      context: .
      dockerfile: Dockerfile.deepeval
    container_name: deepeval-container
    environment:
      # ホスト上の11434ポート(Ollama)を参照
      - OLLAMA_HOST=http://host.docker.internal:11434
      # Langfuse公式Compose内のWebサービスを指定
      - LANGFUSE_HOST=http://langfuse-web:3000
    extra_hosts:
      - "host.docker.internal:host-gateway"
    depends_on:
      - langfuse-web
    restart: always
Dockerfile.deepeval
FROM python:3.15-slim-trixie

# uvのインストール
COPY --from=ghcr.io/astral-sh/uv:latest /uv /uvx /bin/

WORKDIR /app

# 仮想環境を /app の外 (/opt/venv) に作成し、PATH を通す
ENV VIRTUAL_ENV=/opt/venv
ENV PATH="/opt/venv/bin:$PATH"

# 依存ライブラリのインストール
RUN uv venv $VIRTUAL_ENV && \
    uv pip install deepeval langfuse

# コンテナを常時起動状態にしておく
CMD ["tail", "-f", "/dev/null"]
起動
sudo docker compose up -d
curl -Iとかで疎通確認
リバースプロキシ側
server {
    listen 9010;
    server_name _;

    client_max_body_size 50M;

    location / {
        # backend ネットワーク内の langfuse-web コンテナ (3001番ポート) へ転送
        proxy_pass http://<langfuse-webが乗ってるホストのIP>:3001;

        proxy_http_version 1.1;
        proxy_set_header Upgrade $http_upgrade;
        proxy_set_header Connection "upgrade";

        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Forwarded-Port $server_port;

        proxy_read_timeout 300s;
        proxy_connect_timeout 75s;
    }
}
langfuseにログイン
ログインして思ったけど、ブラウザからリバースプロキシのIP指定してるのにURL欄にはlocalhostって見えるのすごいな。
今までIP指定でやってたから感動

プロジェクトとか作るとAPIキー云々の話が出てくる。
多分コーディングエージェントに渡してトレースをlangfuseに送るようにできるよって話かな

テスト実行用
スクリプト
とりあえず動くことが目的なので、Geminiに作ってもらいました。
評価は自分である程度作れるgeval
import os
import requests
from deepeval.test_case import LLMTestCase, SingleTurnParams
from deepeval.metrics import GEval
from deepeval.models.base_model import DeepEvalBaseLLM
from pydantic import BaseModel

from langfuse import observe, get_client


# ---------------------------------------------------------
# 1. Ollama LLM ラッパー
# ---------------------------------------------------------
class LocalOllamaLLM(DeepEvalBaseLLM):
    def __init__(self, model_name="lfm2.5:8b"):
        self.model_name = model_name
        self.ollama_host = os.getenv("OLLAMA_HOST", "http://host.docker.internal:11434")

    def load_model(self):
        return self.model_name

    # ★ 追加: LLMの呼び出しを "generation" (生成ステップ) としてLangfuseに記録
    @observe(as_type="generation", name="ollama_generation")
    def _call_ollama(self, prompt: str, schema: BaseModel = None) -> str:
        payload = {
            "model": self.model_name,
            "prompt": prompt,
            "stream": False,
            "options": {"temperature": 0.0},
        }
        if schema:
            payload["format"] = "json"

        response = requests.post(f"{self.ollama_host}/api/generate", json=payload)
        response.raise_for_status()

        # 戻り値が自動的に Langfuse の Output になります
        return response.json().get("response", "")

    def generate(self, prompt: str, schema: BaseModel = None) -> str:
        return self._call_ollama(prompt, schema)

    async def a_generate(self, prompt: str, schema: BaseModel = None) -> str:
        return self._call_ollama(prompt, schema)

    def get_model_name(self):
        return f"Ollama ({self.model_name})"


# ---------------------------------------------------------
# 2. 評価タスク(ここで引数と戻り値を受け渡す)
# ---------------------------------------------------------
# 引数(input_prompt)と戻り値(actual_output)が自動でTraceに記録されます
@observe(name="deepeval_geval_evaluation")
def evaluate_task(input_prompt: str) -> str:
    GEN_MODEL_NAME = "gemma4:12b"
    EVAL_MODEL_NAME = "lfm2.5:8b"

    print("=== モデル設定 ===")
    print(f"・回答生成モデル : {GEN_MODEL_NAME}")
    print(f"・評価ジャッジモデル: {EVAL_MODEL_NAME}\n")

    langfuse = get_client()

    gen_llm = LocalOllamaLLM(model_name=GEN_MODEL_NAME)
    eval_llm = LocalOllamaLLM(model_name=EVAL_MODEL_NAME)

    # --- 1. 解答生成 ---
    print(f"[{GEN_MODEL_NAME}] 回答を生成中...")
    actual_output = gen_llm.generate(input_prompt)
    print(f"\n▼ 生成された回答 ({GEN_MODEL_NAME}):\n{actual_output}\n")

    test_case = LLMTestCase(input=input_prompt, actual_output=actual_output)

    # --- 2. GEval 判定設定 ---
    metric_name = "Instruction & Clarity Check"
    geval_metric = GEval(
        name=metric_name,
        criteria=(
            "1. 初心者にもわかりやすい丁寧な解説になっているか。\n"
            "2. 指示通り『箇条書きで3つ』にまとめられているか。"
        ),
        evaluation_params=[
            SingleTurnParams.INPUT,
            SingleTurnParams.ACTUAL_OUTPUT,
        ],
        threshold=0.7,
        model=eval_llm,
    )

    # --- 3. 判定実行 ---
    print(f"[{EVAL_MODEL_NAME}] GEval による判定を実行中...")
    geval_metric.measure(test_case)

    print("\n--- 判定結果 ---")
    print(f"Score   : {geval_metric.score:.2f}")
    print(f"Passed  : {geval_metric.is_successful()}")
    print(f"Reason  : {geval_metric.reason}")

    # --- 4. スコア送信 ---
    langfuse.score_current_trace(
        name=metric_name,
        value=float(geval_metric.score),
        comment=geval_metric.reason
    )

    # ★ 重要: 戻り値を設定することで、Langfuse 上の Output に反映されます
    return actual_output


# ---------------------------------------------------------
# 3. メイン実行ブロック
# ---------------------------------------------------------
def main():
    # 入力プロンプト
    prompt = "以下のプログラミング用語について、初心者向けに箇条書きで3つにまとめて解説してください。\n用語: Docker Compose"

    # 評価タスクの実行(引数として渡す)
    evaluate_task(prompt)

    # すべての処理が終わった後にまとめて送信
    get_client().flush()
    print("\n[Langfuse] トレースとスコアを正常に送信しました。")


if __name__ == "__main__":
    main()
# スクリプトをコンテナにコピー
sudo docker cp ../deepeval/run_eval_GEval.py deepeval-container:/app

# プロジェクト単位のAPIキーなどをメモして動作
# 設定から作れたはず...
sudo docker exec -it \
  -e LANGFUSE_PUBLIC_KEY="pk-lf-xxxxxxxxxxx" \
  -e LANGFUSE_SECRET_KEY="sk-lf-xxxxxxxxxxx" \
  -e LANGFUSE_HOST="http://langfuse-web:3000" \
  deepeval-container uv run python run_eval_GEval.py
確認
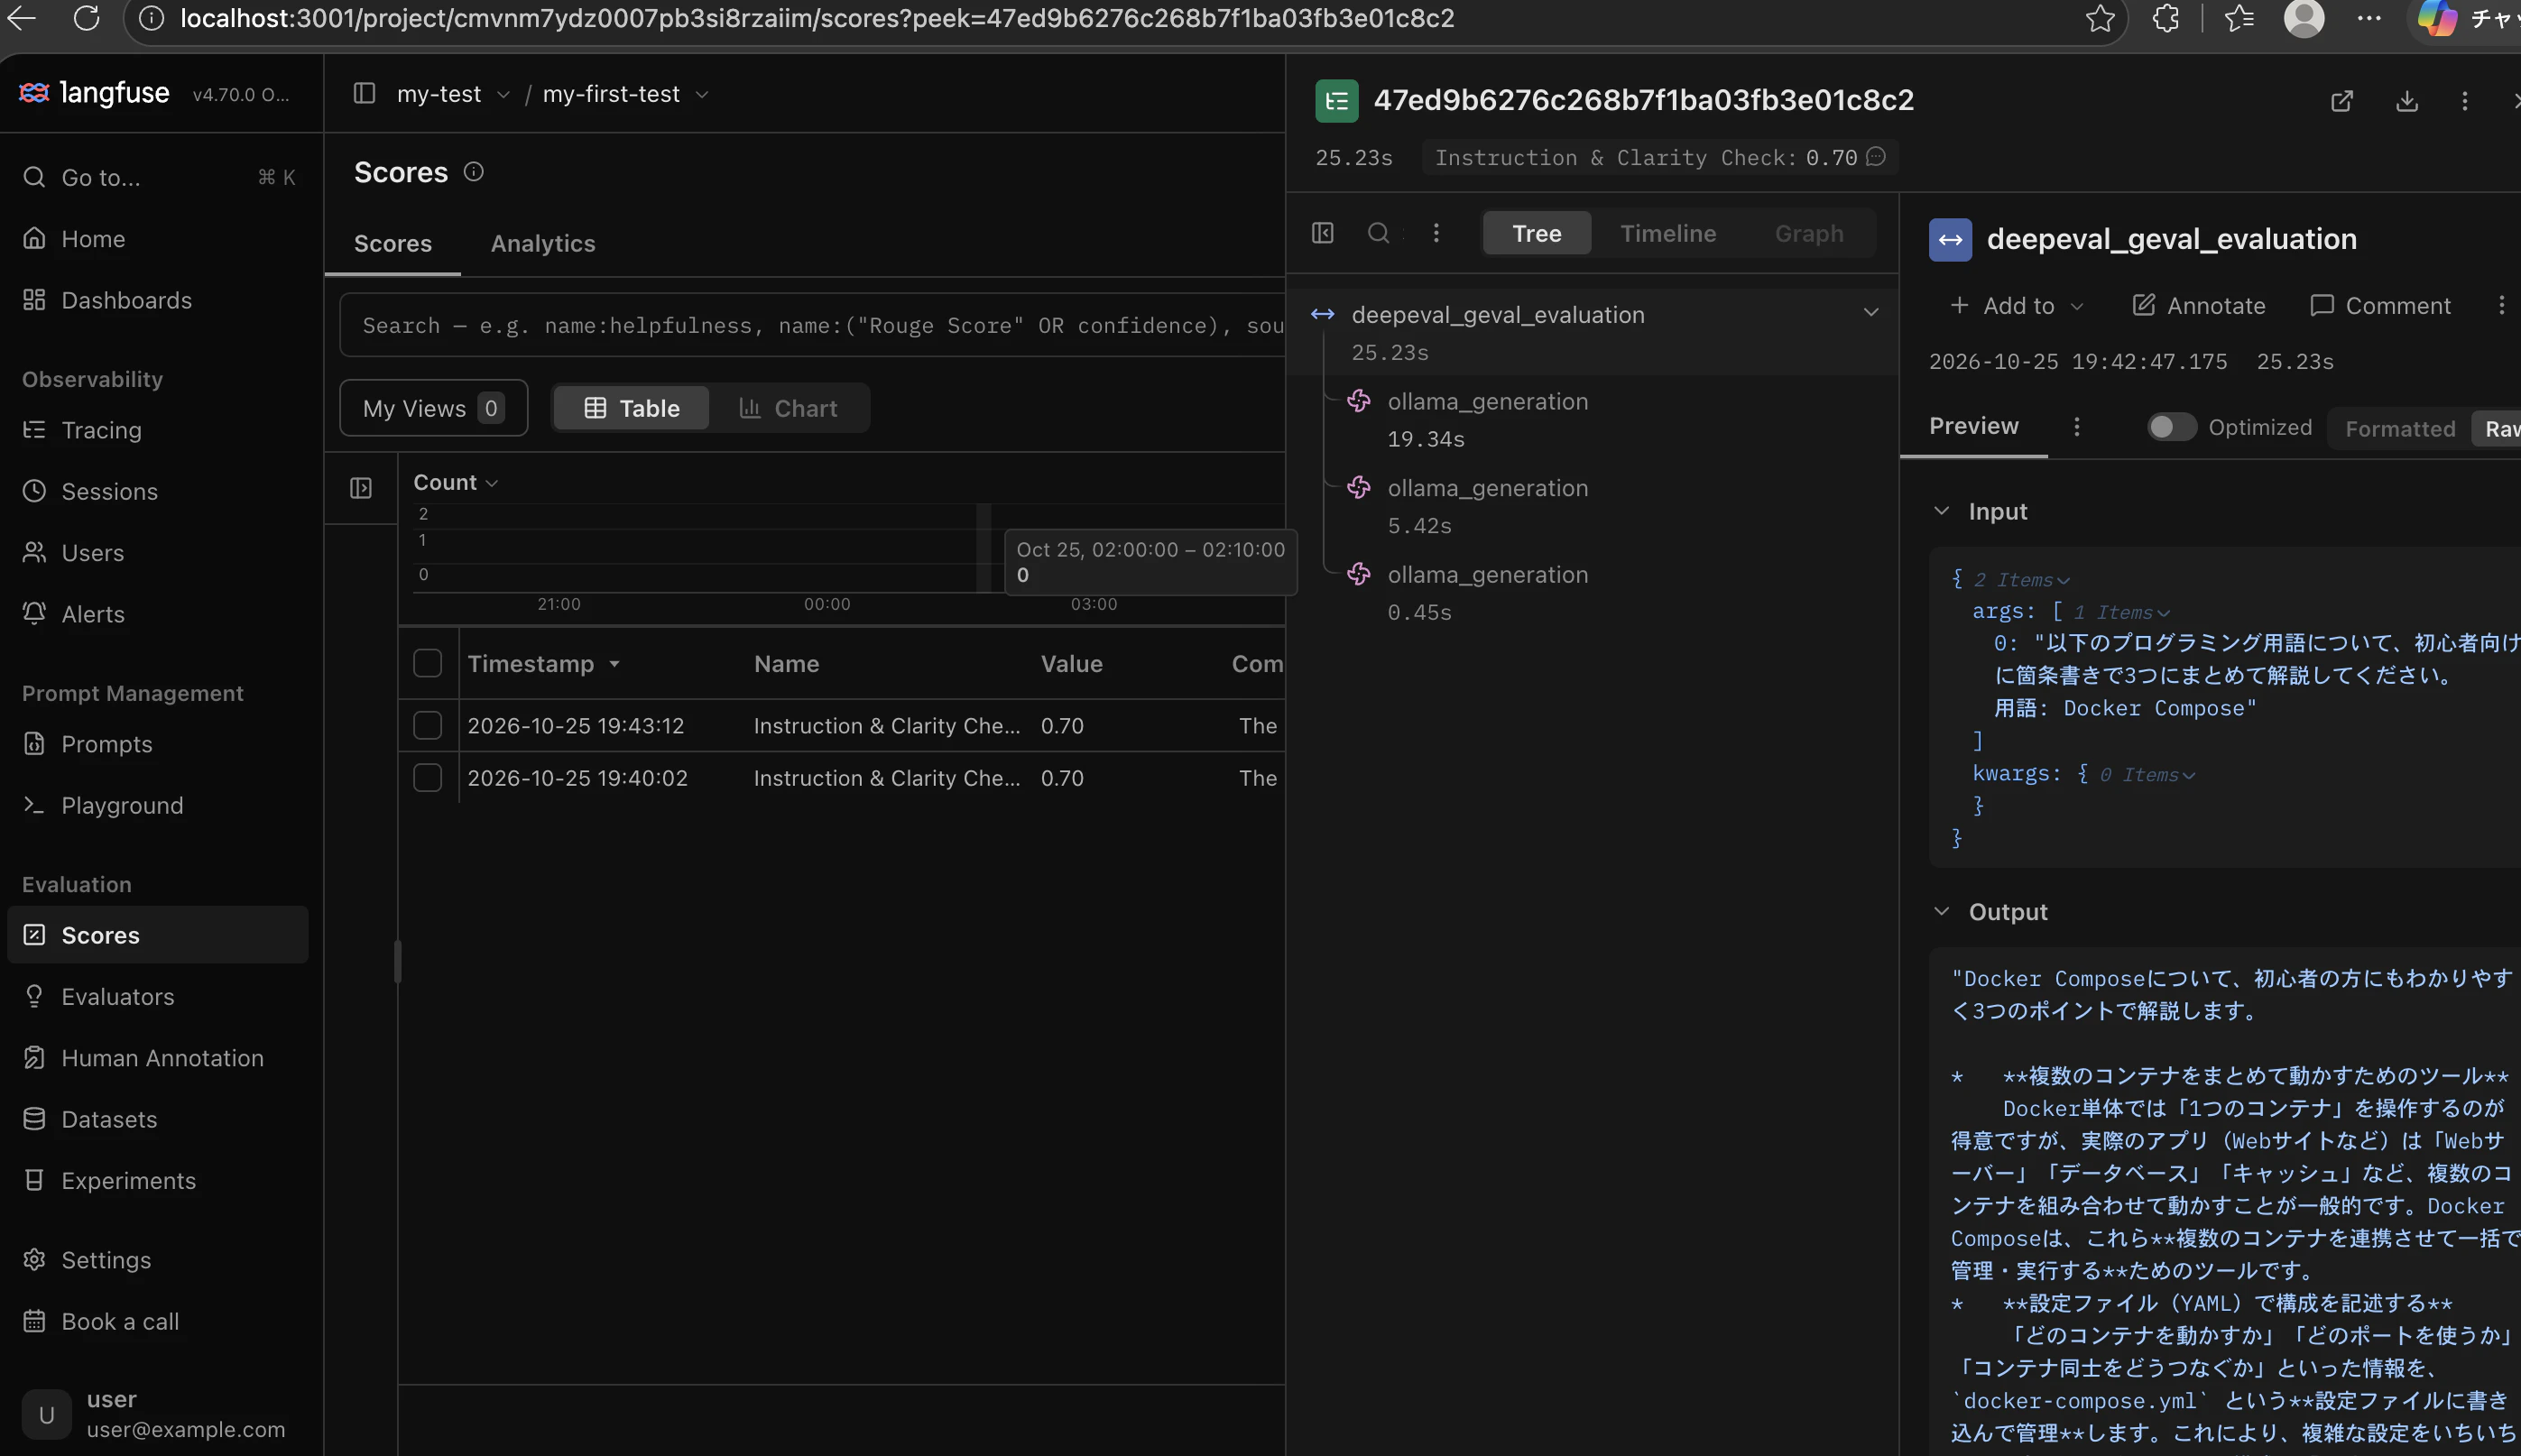
Evaluationのscoresに入っていた
最後に
これでdeepeval -> langfuseの評価からダッシュボード送信まで確認できた。
正直deepevalでどこまでの評価基準があるのか、langfuseはどこまで対応なのか掴めていないので、これから確認してみる。