
既存テストから取り出した178件の期待値に、6つの実装が全部通りました。その直後、独立した正解データで静的解析の再現率を測ると、約49%。AIエージェントと進めていた多言語への書き換えで、比べる基準を取り違えていたことが見えてきました。今回の公開採点基準
満点の隣に、半分しか拾えていない数字が並んでいる。これは、さすがに立ち止まります。
題材は、自作の静的コード索引CLI「omitnix」です。コードを走査し、ファイルの情報や、どの表を読み書きするかを記録します。「読めなかったファイルを、読めなかったと書き残す。」という方針で作っています。
前回は、読めないファイルを結果から消さない設計と、ツールの公開について書きました。今回は、その報告の中身がどこまで正しいかを測った続きです。
前回の記事:「解析できなかった」を「何も無い」に見せない。静的コード索引 omitnix を出しました
最初は「Pythonと同じなら大丈夫」と考えていた
出発点は、実行速度と配布のしやすさでした。Pythonで作ったCLIを、Rust、Go、TypeScript、C#、Javaでも作り、コマンド全体で比べようとしました。
ここで基準にしたのが、Python版の出力です。同じ入力を渡して、表や未解決の報告が一致するかを見る。移行するときに出力が変わらないかを確認するには、自然な検査です。
でも、Python版が正しいことは、別途確かめていませんでした。
Pythonがある表を取りこぼす。それを他言語でも再現すると、互換の検査には通ります。逆に、他言語だけがその表を拾えた場合は、不一致になります。その違いが改善なのか誤検出なのか、Pythonとの比較だけでは判定できません。
元の実装の癖まで丁寧に写して、同じ結果へ寄せていました。何を正解にしているかを、先に疑うべきでした。
Pythonも、採点される側に戻した
そこで、正解データを別に用意することにしました。Pythonも他の5実装と同じ参加者として扱います。
使った材料は2種類です。
- 既存テストに手で書かれている期待値を、テストの構文から取り出す。
- 架空の表を埋め込んだ合成コードを作り、入力の作り方から期待する表を決める。
前者は、既存のテストが何を約束しているかの確認です。後者は、そのテストが聞いていなかった書き方も含めた、独立した検査になります。
ただし、どちらも無条件に完全な正解ではありません。既存テストには、現在の制限をそのまま期待値にしたものがあります。合成データも、作った側が読み書きの意味を間違える可能性はあるので、入力と期待値をレビューします。
公開の合成データは126ケース、186ファイル。必須集合と参考集合を分け、ホスト言語に埋め込まれたSQL、定数や引数を経由する表名、呼び出しの段数などを含めました。
公開基準の構成は次のようになっています。
rewrite/truth/
├── from-tests/       # 既存テストから抽出した期待値と入力
├── synthetic/        # 合成コードと独立した期待値
└── tools/
    └── score.py      # 共通の採点器
採点基準とレビューの記録は、公開リポジトリのtruthディレクトリにあります。
クラウドへ渡したのは、公開データで完結する部分
この作業では、クラウドのBotに公開基準のレビューと採点器の改善を依頼しました。私的なコードを送らずに済む、合成データと公開fixtureだけの範囲です。
成果を受け取った後は、変更ファイルを照合し、レビューと手元の検査を行いました。既定CIの成功とは別に、CIに含まれない採点器の回帰検査73件もWindowsで確認しています。
「委託先が完了した」「手元で検査した」「公開mainへ入った」は、それぞれ別の状態です。公開基準はmainへ取り込み、6実装の採点はローカルのサブエージェントへ分担しました。
ここで取り込んだのは、採点の基準と道具です。5言語の製品版を一斉に公開したわけではありません。今回の製品ソースは変更していません。
満点だったのは、何の検査だったのか
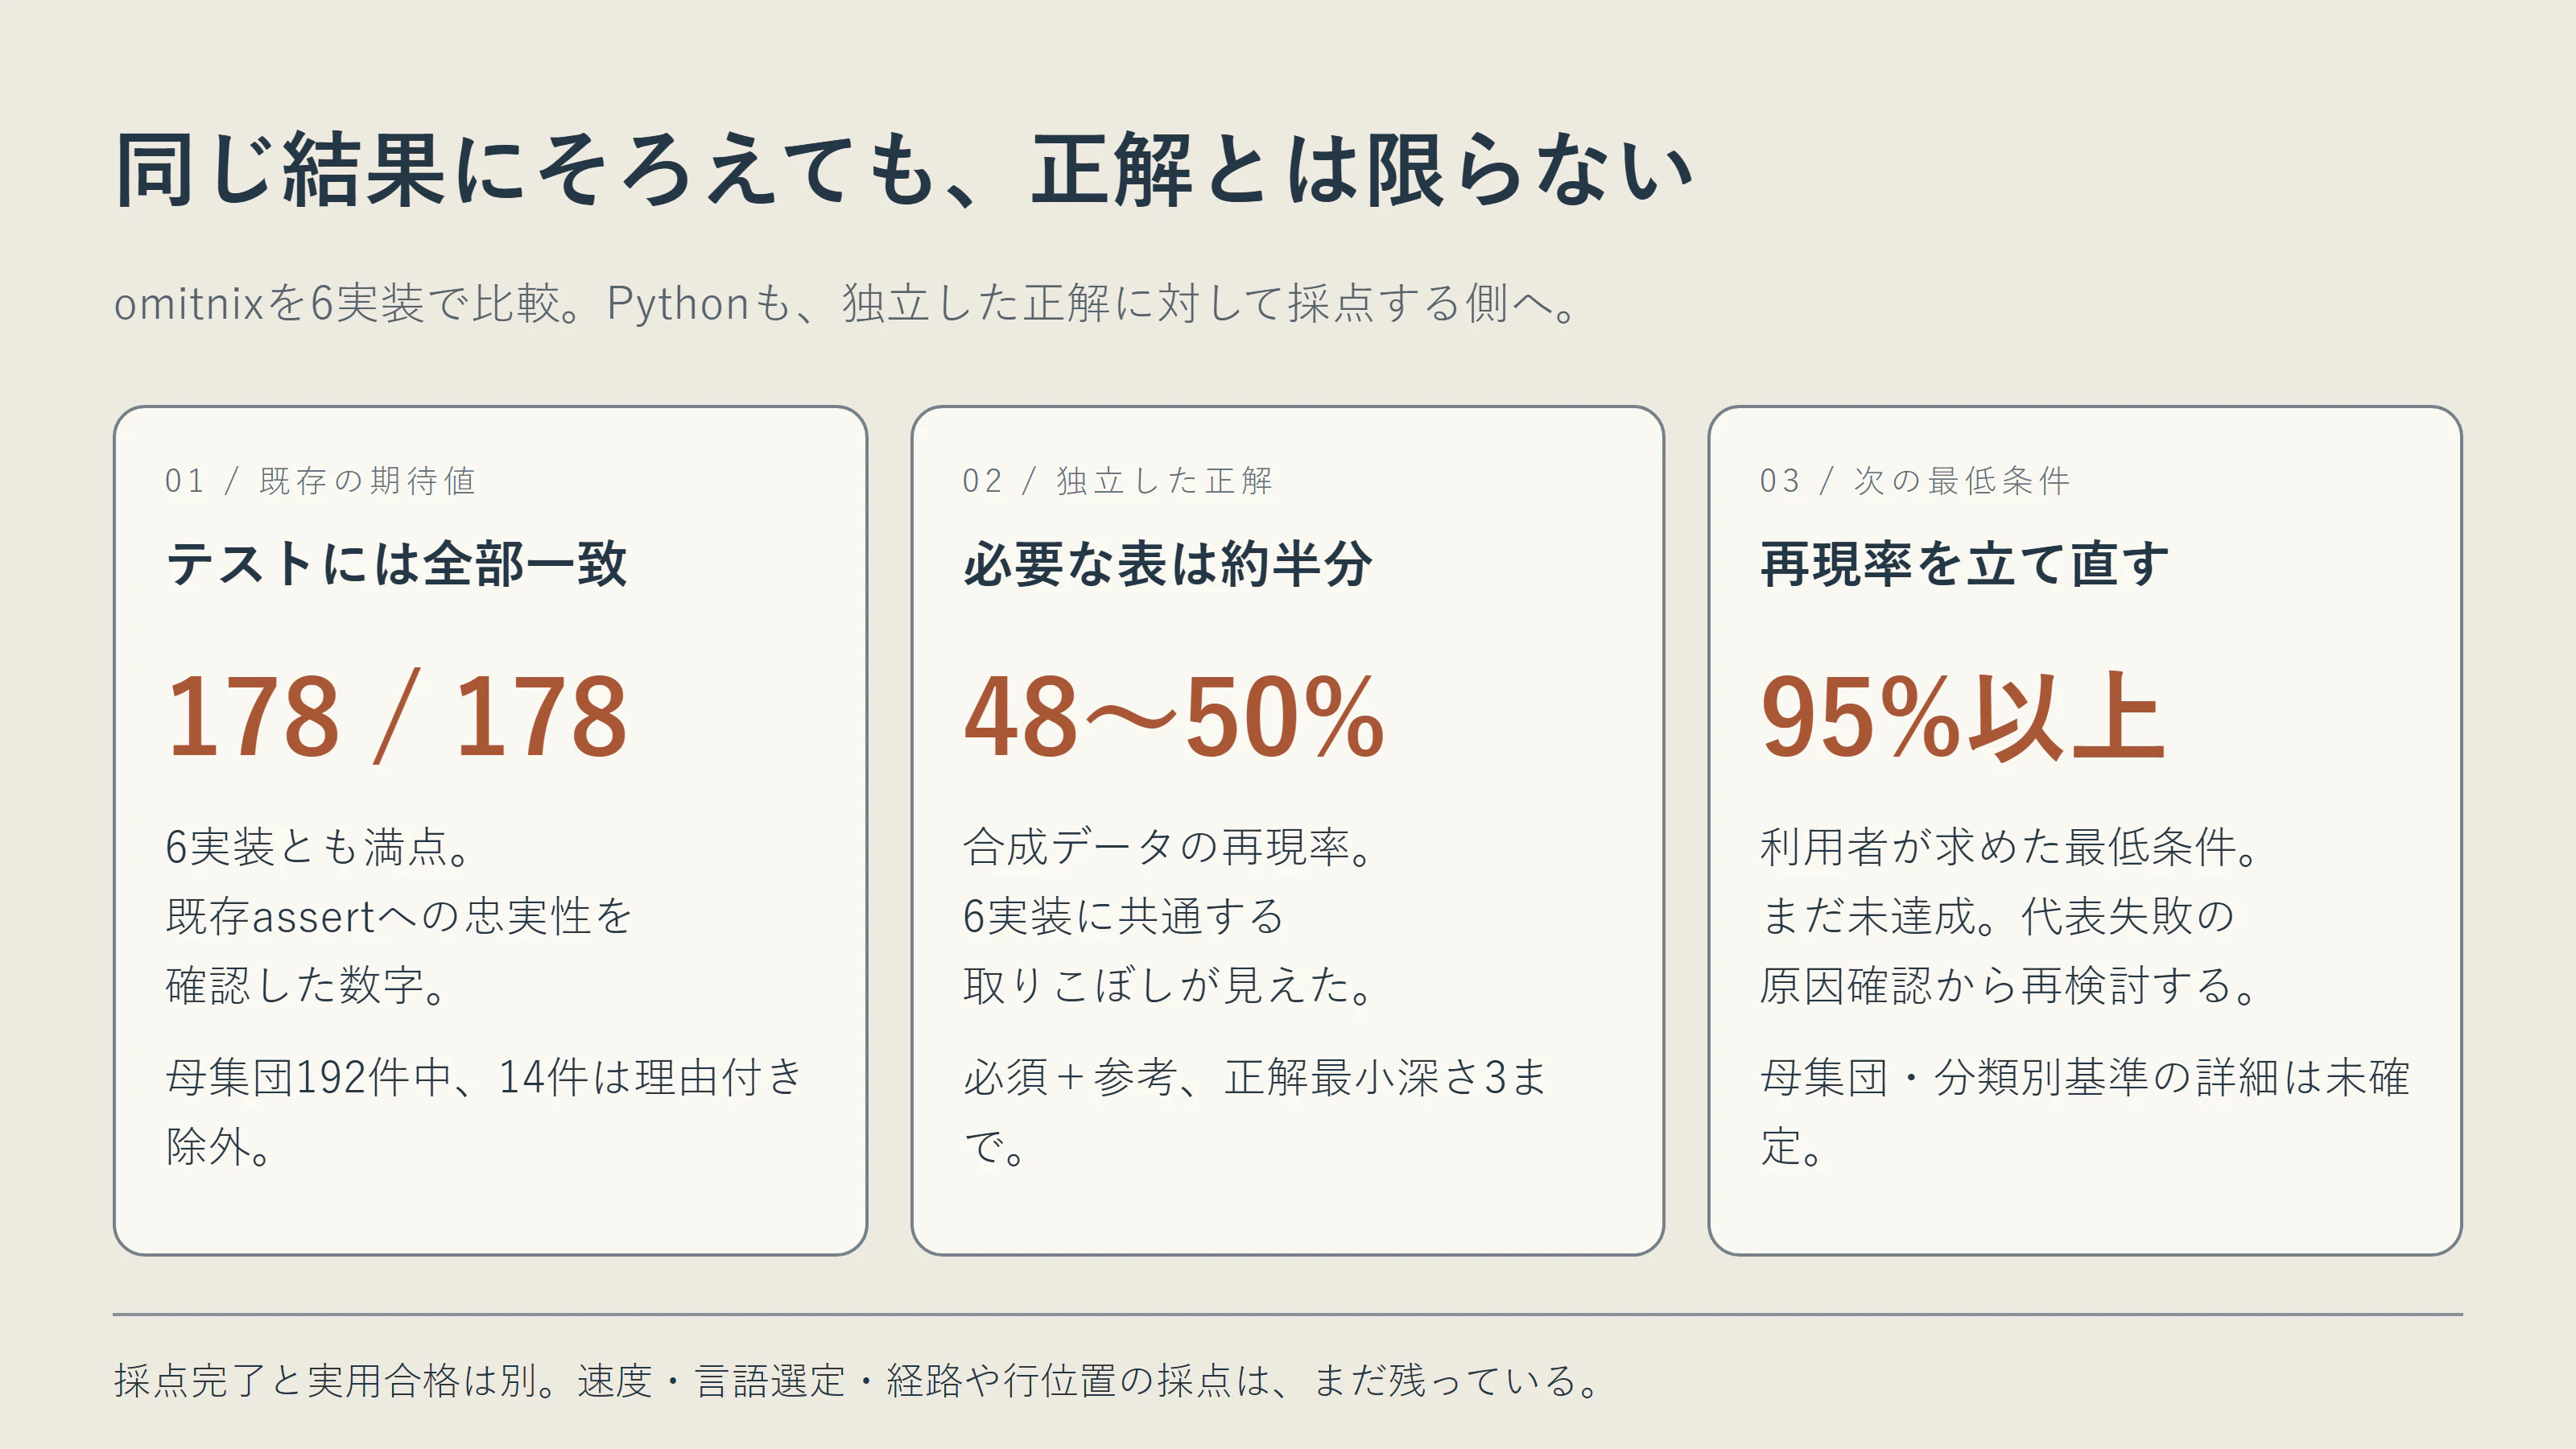
既存テストから取り出した期待値は192件。そのうち、CLIの出力を介して今回の採点器で適用できたのが178件でした。残り14件は、スキーマのsnapshotが必要な8件と、ファイル範囲の条件が必要な6件です。
6実装は、すべて178/178件に一致しました。
この数字は、既存テストの期待値を保てているという結果です。すべての表を正しく拾えるという意味ではありません。読み取った採点母集団と、除外した理由を隠さずに出す必要がありました。
たとえるなら、同じ答案にそろえた6人が、答え合わせで同じ点を取っている状態です。その答案自体が正しいかを見る検査を、別に持たないといけません。
正解に対して測ると、6実装とも約半分だった
合成データでは、ファイルごとの読み・書き・表の組が、期待どおりに出たかを測りました。下表は必須集合と参考集合を合わせ、正解側の最小深さ3までを対象にしています。
再現率は「期待する表をどれだけ拾えたか」。適合率は「出した表のうち、どれだけ正しかったか」です。
| 実装 | 発見した組/期待する組 | 再現率 | 適合率 |
|---|---|---|---|
| Python | 118/242 | 48.76% | 97.52% |
| Rust | 118/242 | 48.76% | 97.52% |
| Go | 119/242 | 49.17% | 97.54% |
| TypeScript | 117/242 | 48.35% | 97.50% |
| C# | 117/242 | 48.35% | 97.50% |
| Java | 121/242 | 50.00% | 97.58% |
242はファイル数ではなく、期待する表の組数です。186ファイルすべてが対象として記録されていても、そのファイルの中にある表を拾えているとは限りません。
各実装は2回ずつ採点し、結果JSONはそれぞれバイト単位で一致しました。既存の実行物を使ったため、現在の原本ソースとの完全な対応を、再ビルドで証明した測定ではありません。
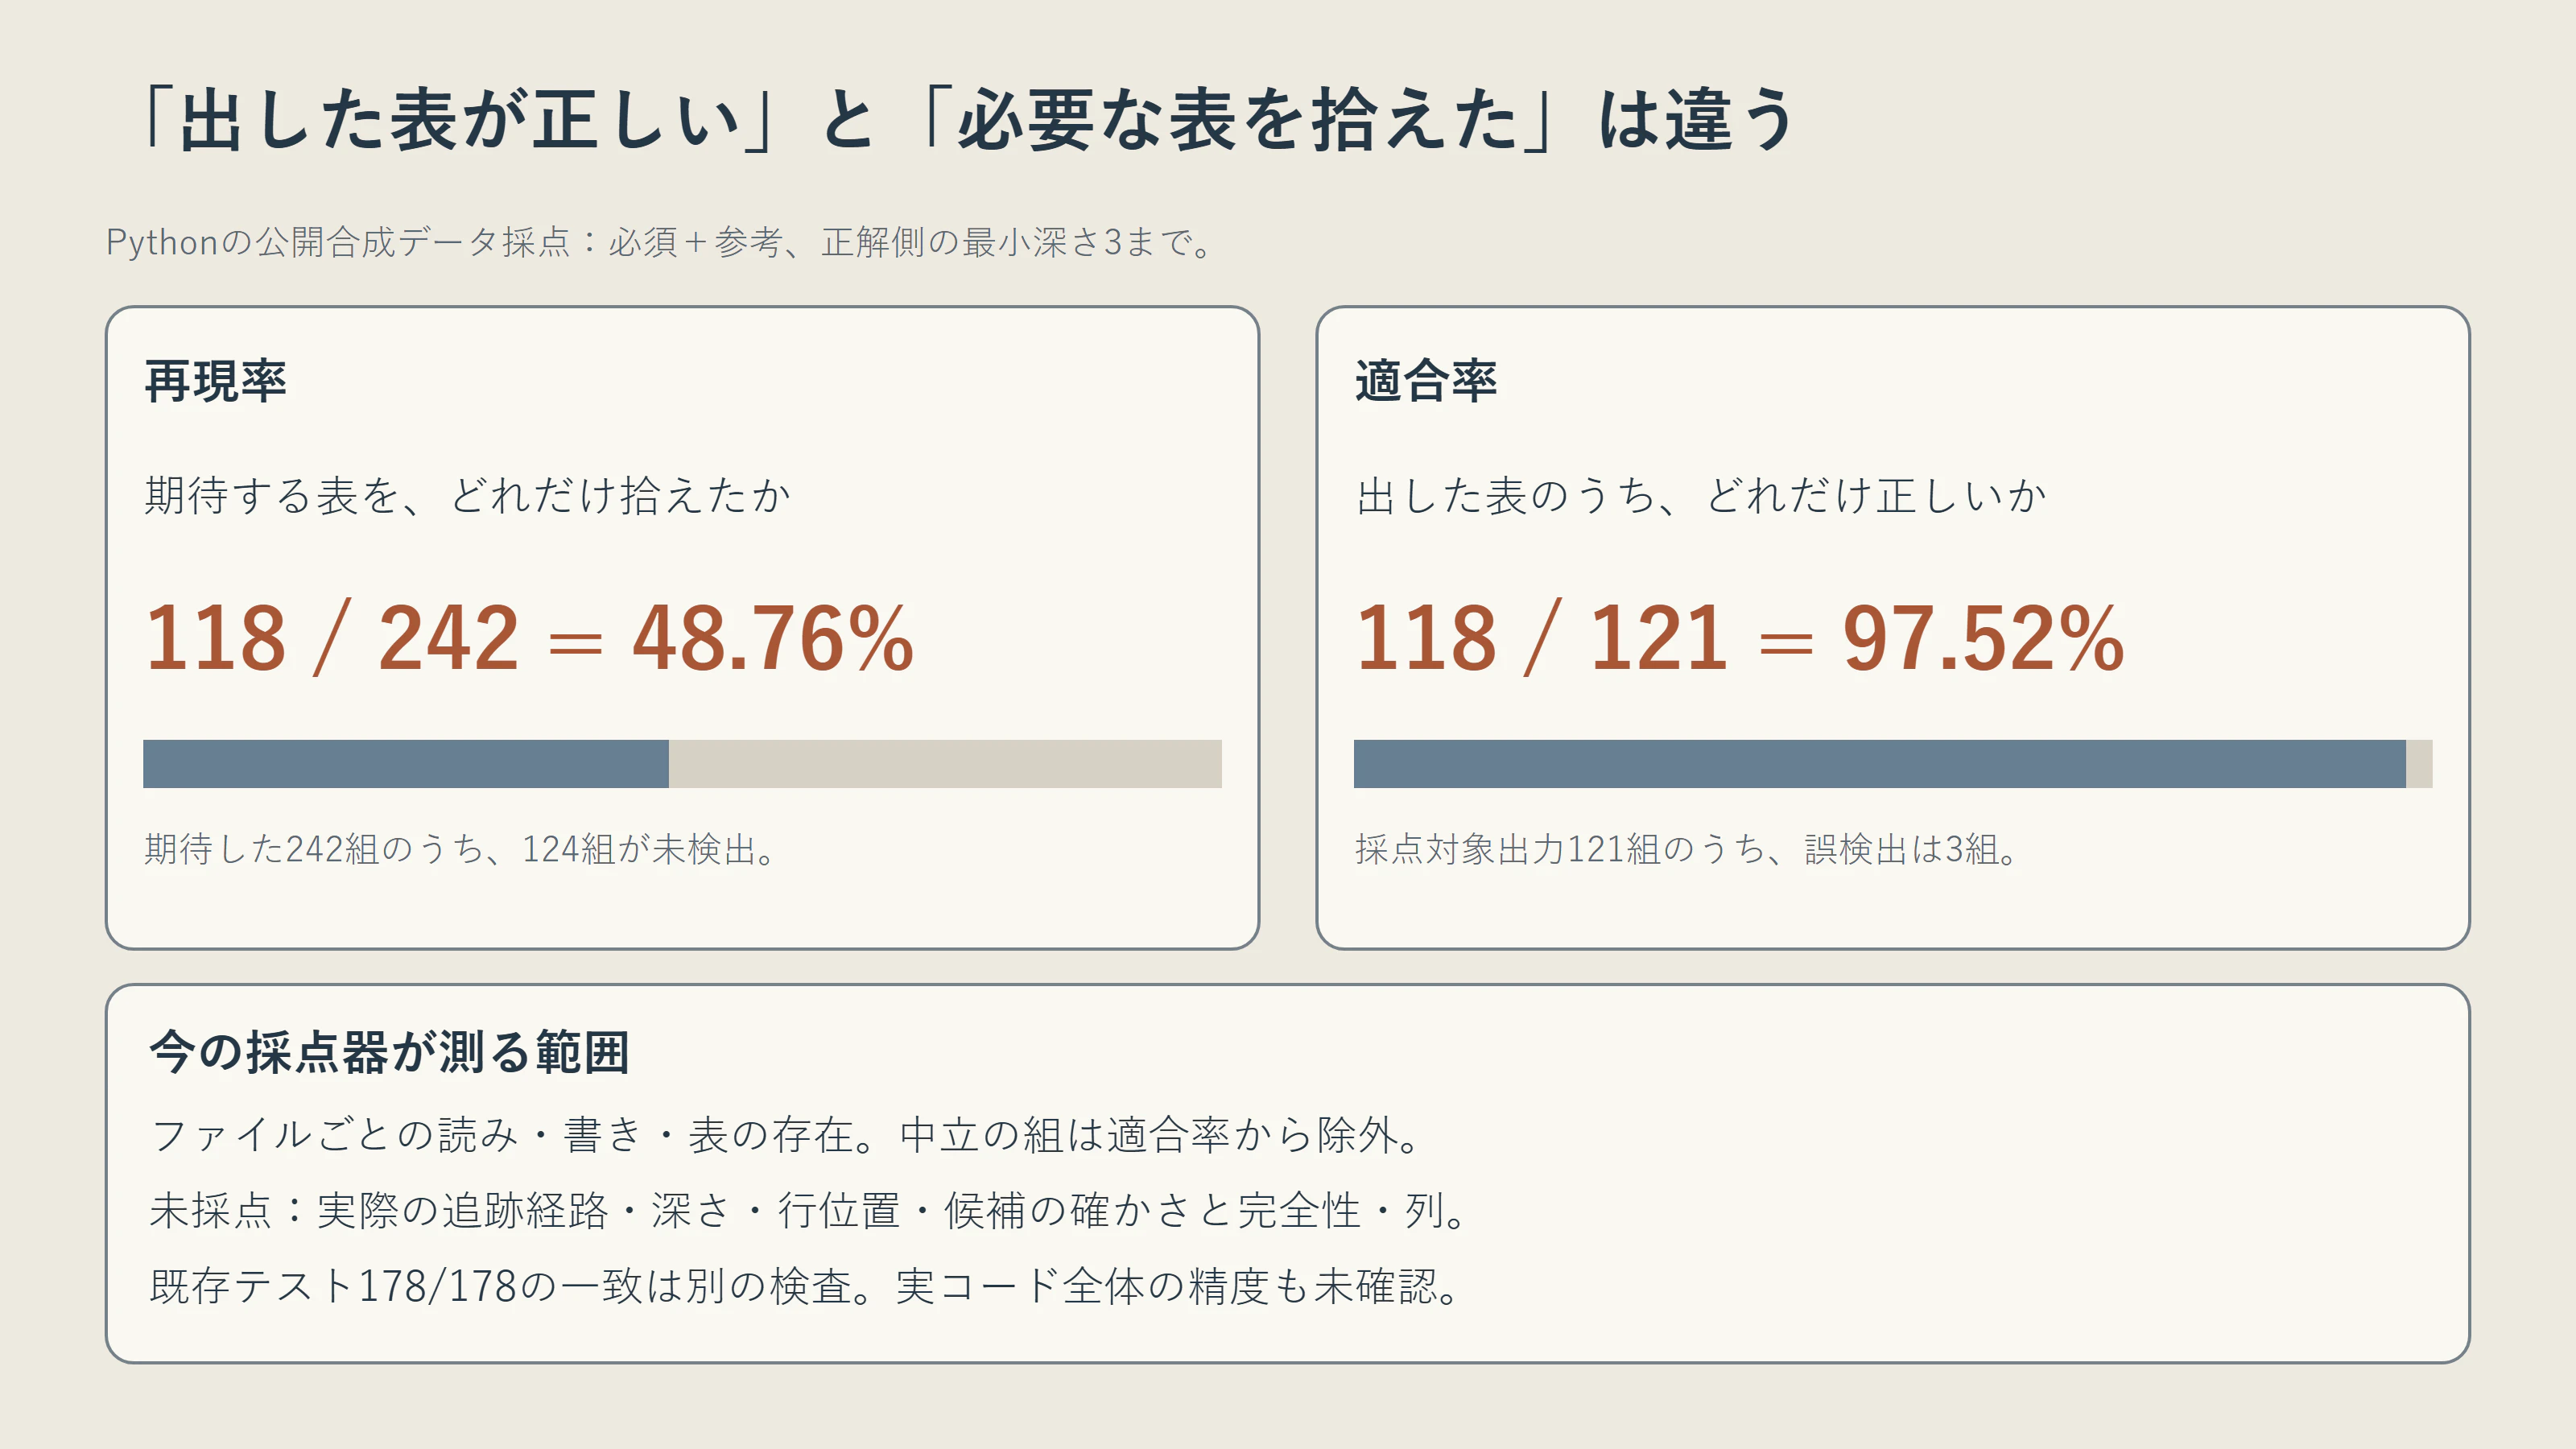
この結果では、出した表は多くが正しい一方、期待する表を大量に落としています。表の影響調査に使うなら、一覧に出なかった表を安心して無関係と扱えない状態です。
Javaの発見数が今回最多でも、最少との差は4組。どの言語にするかを、この僅差で決める段階ではありませんでした。
取りこぼしは、同じところへ集まっていた
Pythonの分類別結果を見ると、通常のSELECTは23/23。書き込み系は23/27でした。
一方、DDLは5/43、定数や引数などを経由する表名を含むdynamic_table分類は0/28、エスケープを含む文字列は0/4。正解側の深さ2・3に分類された表は、6実装とも0/25でした。
これは、失敗が出た場所の整理です。DDLの何が読めないのか、定数の読み取りか呼び出しの追跡か、そもそも期待値や採点器に誤りがないか。修正原因までは、まだ確定していません。
それでも、「あと少し互換を詰める」だけで済む差ではないことは分かりました。
同じ実装を忠実に写せたことと、使いたい場面の答えが十分そろうことは、別に確認する必要があります。
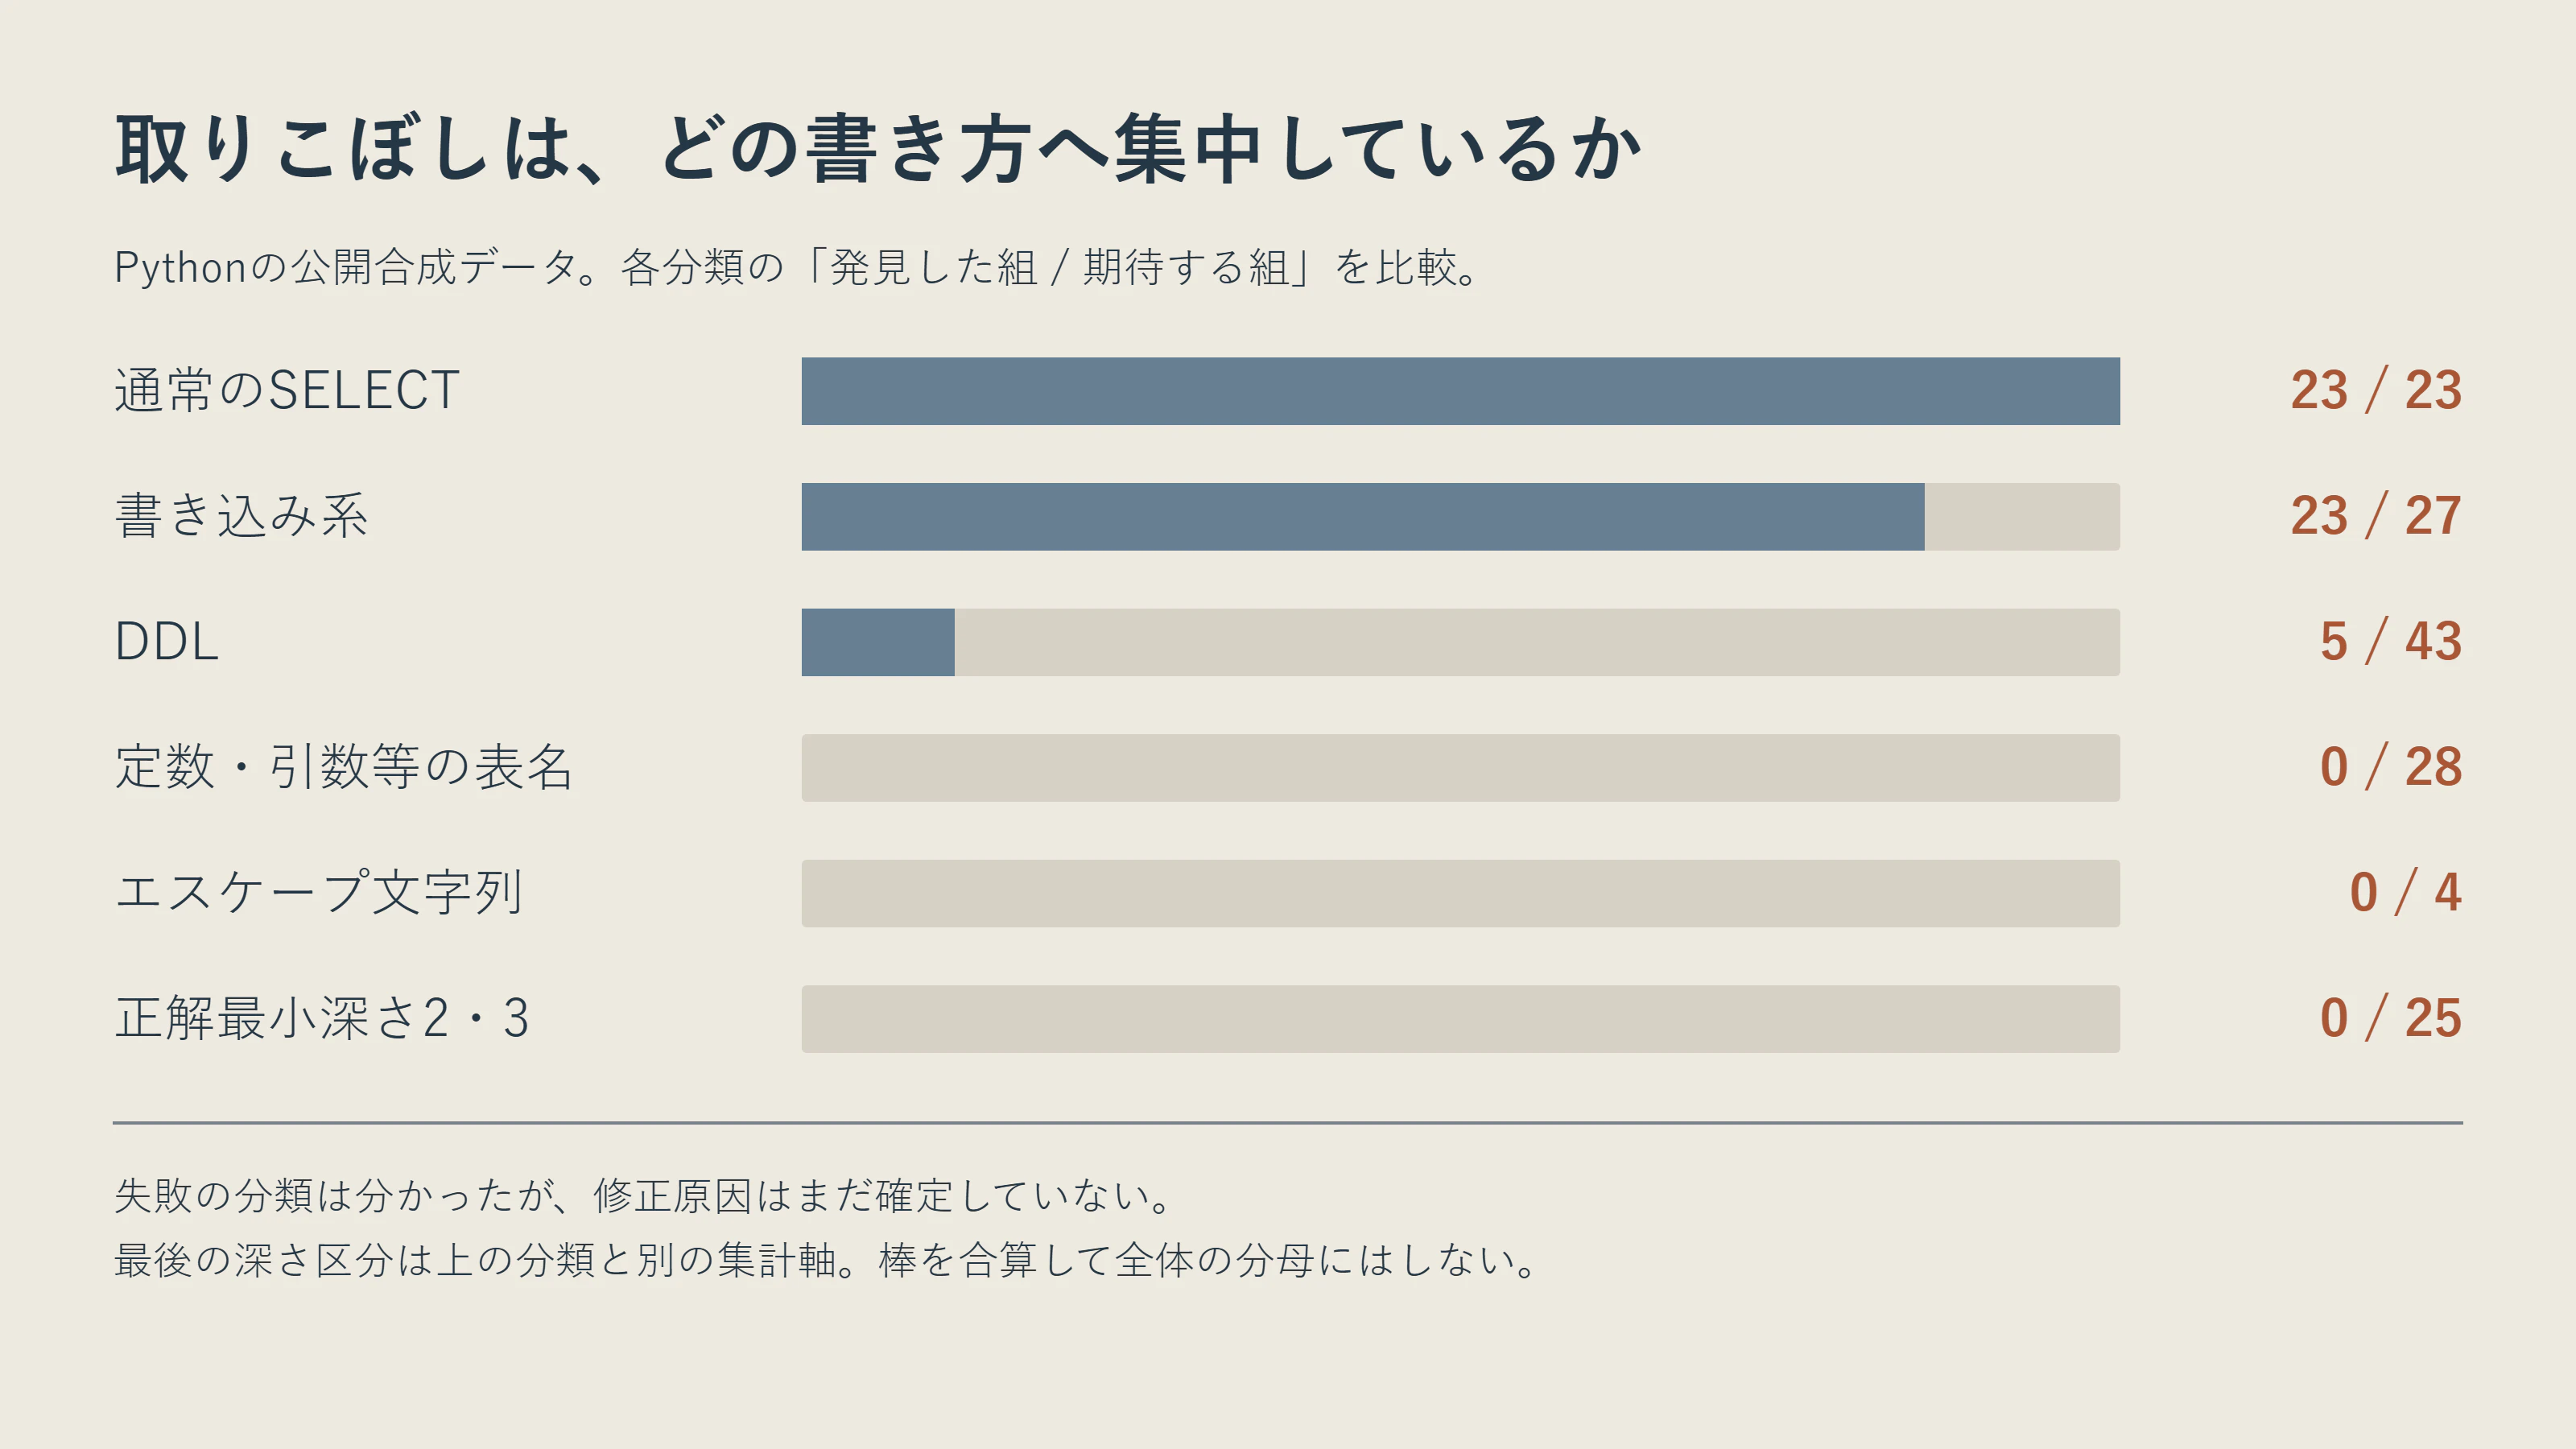
今回の合成データでは、通常のSELECTより、DDLや値の追跡で大きな不足が出ています。入力の難しさを反映した分類別の結果であり、すべての実コードで同じ割合になるという意味ではありません。
合成データでも95%は欲しい
結果を俯瞰するHTML報告書を作って見直したところ、出てきた感想は単純でした。「合成データに関しては95%以上取れないと、そもそも実用に耐えられないのでは」。
対応すると決めた書き方を、答えが分かる入力で測っています。ここで半分ほどしか拾えないなら、速度が上がっても影響調査の不安は解消しません。再現率95%以上を、最低条件として置くことにしました。
ただ、どの集合を必須にするか、分類別にも基準を置くか、適合率や確定不能入力の開示をどう評価するかは、次に詰める部分です。「分類別95%も決定した」「Pythonから直す方針が決まった」という状態ではありません。
参考集合を除いた必須集合には、期待する組が232あります。この分母を固定するなら、95%以上に必要なのは221組。Pythonは114組なので、あと107組必要です。
95%はここで置いた利用上の目標です。現在の必須集合とPythonの成績の記録は、手元検証の公開記録にあります。
数字を良くするために、表らしいものを全部並べる方法も困ります。再現率と適合率、分からないものを分からないと報告できるかを、一緒に見たいです。
速度の測定は残して、ここで一区切りにした
速度はまだ測っていません。ほかのAI処理やアプリを止め、同じ入力を使い、順番を入れ替えて繰り返し測る手順は用意しています。今回の並列採点の経過時間を、そのまま速度の順位にはしません。
精度についても、今の採点器が測るのは主に表の存在です。追跡経路やソース行、実際の深さ、候補の確かさや完全性、列の抽出はまだ採点していません。合成データの成績を、実コード全体の成績へそのまま広げることもできません。
残ったのは、代表的な取りこぼしをソースと期待値へ戻って調べることです。製品実装、正解データ、採点器のどこを直すべきかを確認してから、改善の方針を考え直します。
そこで今回は、結果と未確認の範囲、95%という最低条件、次の調査手順を引き継ぎに残しました。改善完了の記事ではありません。基準を見直したことで、まだ実用に足りないと分かった時点の記録です。
omitnixを試すときにも、この限界は知っておいてほしい
- 発見したファイル数と、解析済み・未解決・読めない・担当なしの数が合うか確認したいとき。
- 読めなかった箇所を理由付きで残し、参照0件を未使用と断定したくないとき。
- アダプタを追加しながら、静的なコードの索引を試したいとき。
ファイルの扱いを数えて報告する仕組みはありますが、今回の結果から表の抽出には大きな不足があります。影響調査の唯一の根拠としては使わず、ソースの確認と合わせてください。READMEでもearly developmentとしている段階です。
READMEの初回実行手順は次の2コマンドです。対象リポジトリで実行すると索引ファイルを書き出します。
pip install "omitnix[all]"
omitnix
Starをいただけると開発の励みになります。入力例を一般化した不具合の報告やIssueも歓迎です。
おわりに
178件満点を見たときより、49%を見た後のほうが、次に確かめる場所は具体的になりました。
次は、拾えていない表をひとつずつ見ます。言語を選ぶ前に、答えのある入力で、必要な答えがそろうところまで。
📎 図解版・関連リンクをまとめたページがあります:
https://ishizakahiroshi.com/articles/2026/2026-10-04_omitnix-truth-scoring/
※ ヘッダー画像は AI(画像生成)で作成しています。
※ 本文の挿絵も AI(画像生成)で作成しています。
書いた人: ishizakahiroshi
群馬の北部で、保護猫2匹と暮らす、在宅エンジニア(何でも屋)
https://ishizakahiroshi.com/
https://github.com/ishizakahiroshi
X(業務委託・各種相談はこちら):
https://x.com/ishizakahiroshi
バックエンド・インフラ・AI連携まわりで、業務委託のご相談を受け付けています。フルリモートです。スポットや週2〜3時間からでも歓迎で、いろんな案件に携われたらうれしいです。こんな相談、歓迎です。